Co to jest metoda osi głównych?
Metoda osi głównych (ang. principal axis factoring, PAF; także metoda czynników głównych, principal factor method) to metoda ekstrakcji w eksploracyjnej analizie czynnikowej, która szuka czynników wyjaśniających tylko wariancję wspólną pozycji. Zamiast jedynek na przekątną macierzy korelacji wstawia oszacowania wspólności (h²), a następnie poprawia je iteracyjnie, aż przestaną się zmieniać. Obok metody największej wiarygodności to jedna z dwóch najpopularniejszych metod ekstrakcji czynników wspólnych, a sam wybór metody ekstrakcji należy do kluczowych decyzji w EFA (Fabrigar i in., 1999; Watkins, 2018).
Nazwa pochodzi od geometrii: czynniki są kolejnymi osiami, wzdłuż których „rozciąga się” wariancja wspólna pozycji. Od metody głównych składowych różni ją wyłącznie zawartość przekątnej – ale ta różnica decyduje o tym, czy analizujesz konstrukt, czy całą wariancję łącznie z błędem pomiaru.
Jak działa metoda osi głównych krok po kroku?
- Wspólności początkowe. Dla każdej pozycji oblicz kwadrat korelacji wielokrotnej z pozostałymi pozycjami (SMC, squared multiple correlation) – to R² z regresji pozycji na wszystkie inne. SMC jest dolnym oszacowaniem wspólności.
- Macierz zredukowana. Zastąp jedynki na przekątnej macierzy korelacji wspólnościami.
- Ekstrakcja. Wyznacz wartości i wektory własne macierzy zredukowanej. Ładunki k czynników to wektory własne pomnożone przez pierwiastki z odpowiadających im wartości własnych.
- Nowe wspólności. Policz h² jako sumę kwadratów ładunków w wierszu i wstaw je na przekątną.
- Iteracja. Powtarzaj kroki 3–4, aż największa zmiana wspólności spadnie poniżej progu (np. .001).
Liczbę czynników k trzeba ustalić przed ekstrakcją, np. analizą równoległą. Algorytm sam jej nie wybiera, a wynik zależy od tej decyzji. Jeśli zażądasz za dużo czynników, wspólności mogą rosnąć ponad 1 – to przypadek Heywooda, sygnał nadmiernej ekstrakcji albo zbyt małej próby.
Przykład: iteracje dla skali wsparcia społecznego
Dwustu pięćdziesięciu dorosłych wypełniło 8 pozycji skali spostrzeganego wsparcia: cztery o wsparciu rodziny (rod1–rod4) i cztery o wsparciu przyjaciół (prz1–prz4); odpowiedzi 1–7, dane symulowane z modelu dwuczynnikowego. Analiza równoległa wskazała 2 czynniki: dwie pierwsze wartości własne macierzy korelacji (2.82 i 1.54) przekroczyły 95. percentyl wartości z danych losowych (1.37 i 1.24), a trzecia (0.93) – już nie. Tabela pokazuje, jak zmieniały się wspólności od wartości startowych do rozwiązania końcowego.
| Pozycja | Początkowa (SMC) | Po 1. iteracji | Końcowa (16 iteracji) | Ładunek po rotacji oblimin |
|---|---|---|---|---|
| rod1 | .47 | .59 | .78 | .89 |
| rod2 | .38 | .46 | .46 | .63 |
| rod3 | .26 | .29 | .27 | .51 |
| rod4 | .22 | .26 | .24 | .49 |
| prz1 | .37 | .48 | .55 | .73 |
| prz2 | .33 | .44 | .52 | .74 |
| prz3 | .31 | .38 | .38 | .57 |
| prz4 | .11 | .14 | .13 | .37 |
Procedura zbiegła się po 16 iteracjach. SMC okazały się zaniżone przede wszystkim dla najsilniejszych pozycji: wspólność rod1 wzrosła z .47 do .78, a prz1 z .37 do .55. Pozycje słabe (prz4, rod4) prawie się nie zmieniły. Wartości własne macierzy zredukowanej po ekstrakcji wyniosły 2.31 i 1.02 dla dwóch zatrzymanych czynników, a trzecia – tylko 0.19. Po rotacji oblimin każda pozycja ładuje swój czynnik (.37–.89), ładunki krzyżowe nie przekraczają .12, a czynniki korelują na poziomie .34.
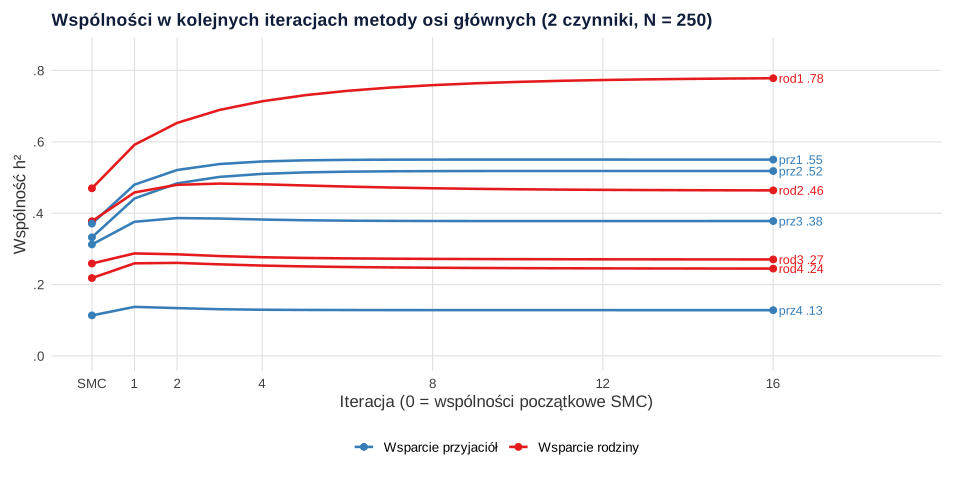
Ręczna implementacja daje te same wspólności co psych::fa(fm = "pa") z dokładnością do drugiego miejsca po przecinku. Pakiet ma nieco inną regułę zatrzymania, dlatego trzecie miejsce może się różnić (np. .778 i .775 dla rod1).
Osie główne czy największa wiarygodność?
W przykładzie obie metody dały prawie te same wspólności (różnice do .03). Metoda ML ma przewagę formalną: daje test χ² i wskaźniki dopasowania (tutaj χ²(13) = 14.04, p = .371, RMSEA = .017), ale zakłada wielowymiarowy rozkład normalny. PAF niczego o rozkładzie nie zakłada i rzadziej kończy się niewłaściwym rozwiązaniem.
| Sytuacja | Lepszy wybór | Uzasadnienie |
|---|---|---|
| Mało pozycji na czynnik, ryzyko nadmiernej ekstrakcji | PAF | Lepsze odtwarzanie struktury w symulacjach (de Winter i Dodou, 2012) |
| Nierówne ładunki w obrębie czynnika, ryzyko zbyt małej liczby czynników | ML | Lepsze odtwarzanie w tych warunkach (de Winter i Dodou, 2012) |
| Słaby, ale ważny czynnik w danych z błędem modelu | PAF / OLS | ML częściej „gubi” słaby czynnik (Briggs i MacCallum, 2003) |
| Potrzebny test dopasowania i porównanie modeli | ML | Daje χ², RMSEA i kryteria informacyjne |
| Wyraźne odstępstwa od normalności, skale porządkowe | PAF (lub analiza na korelacjach polichorycznych) | Brak założenia o rozkładzie |
Jeśli obie metody dają podobny obraz, wybór nie ma dużego znaczenia. Jeśli się różnią, potraktuj to jako informację o niestabilności rozwiązania, a nie okazję do wybrania „ładniejszego” wyniku.
Metoda osi głównych w R i SPSS
W R wystarczy funkcja fa() z pakietu psych z argumentem fm = "pa"; argument max.iter pozwala zwiększyć limit iteracji. W SPSS wybierz w oknie ekstrakcji „Principal axis factoring” albo użyj składni:
Zwróć uwagę na tabelę wspólności: SPSS pokazuje w niej kolumnę wartości początkowych (SMC) i kolumnę po ekstrakcji – do raportu bierzesz tę drugą. W tabeli wyjaśnionej wariancji sumy kwadratów ładunków po ekstrakcji są mniejsze niż „początkowe wartości własne”, bo te drugie pochodzą z pełnej macierzy korelacji. To normalne i wynika z odrzucenia wariancji swoistej, a nie z błędu analizy. Liczba iteracji potrzebnych do zbieżności (tu 16) nie ma znaczenia merytorycznego, ale osiągnięcie limitu bez zbieżności – ma.
Jak opisać metodę osi głównych w pracy (APA)
Podaj metodę ekstrakcji, macierz wejściową, sposób ustalenia liczby czynników, rotację, zakres ładunków i korelację czynników. Wspólności zamieść w tabeli ładunków (kolumna h²), zgodnie z wzorem tabeli analizy czynnikowej w APA.
Pełną procedurę, wraz z oceną rzetelności podskal i późniejszą CFA, opisujemy w poradnikach Analiza czynnikowa EFA i CFA oraz Jak zbudować i zwalidować skalę psychometryczną.
Przykład w R
Kod generuje dane, wykonuje metodę osi głównych „ręcznie” (SMC, macierz zredukowana, wartości własne, iteracje), porównuje wynik z psych::fa(), pokazuje rozwiązanie po rotacji oblimin i zestawia wspólności z metodą największej wiarygodności. Liczby w tabelach, tekście i na rysunku pochodzą z tego kodu.
Metoda osi głównych krok po kroku
R
# R171 – Metoda osi głównych (principal axis factoring, PAF) krok po kroku
# Dane symulowane: 8 pozycji skali spostrzeganego wsparcia społecznego –
# 4 pozycje „wsparcie rodziny”, 4 pozycje „wsparcie przyjaciół”; N = 250, odpowiedzi 1–7
suppressPackageStartupMessages({library(MASS); library(psych); library(GPArotation)})
set.seed(171)
L <- matrix(0, 8, 2)
L[1:4, 1] <- c(.80, .75, .65, .45)
L[5:8, 2] <- c(.75, .70, .60, .35)
Phi <- matrix(c(1, .35, .35, 1), 2)
Sigma <- L %*% Phi %*% t(L); diag(Sigma) <- 1
z <- mvrnorm(250, rep(0, 8), Sigma)
dane <- as.data.frame(apply(z, 2, function(x) as.integer(cut(x, c(-Inf, -1.8, -1.1, -0.4, 0.4, 1.1, 1.8, Inf)))))
names(dane) <- c(paste0("rod", 1:4), paste0("prz", 1:4))
R <- cor(dane)

# Liczba czynników: analiza równoległa (95. percentyl wartości własnych z 500 zbiorów losowych danych)
set.seed(1710)
prog <- apply(replicate(500, eigen(cor(matrix(rnorm(250 * 8), 250, 8)))$values), 1, quantile, .95)
round(rbind(dane = eigen(R)$values, losowe_95 = prog)[, 1:4], 3)
sum(cumprod(eigen(R)$values > prog))

# Krok 1: początkowe wspólności = kwadrat korelacji wielokrotnej (SMC)
h2 <- 1 - 1 / diag(solve(R))
slad <- list(h2)
# Kroki 2–4: zredukowana macierz -> wartości i wektory własne -> nowe wspólności; powtarzaj
for (i in 1:100) {
  Rz <- R; diag(Rz) <- h2
  e <- eigen(Rz)
  Lam <- e$vectors[, 1:2] %*% diag(sqrt(e$values[1:2]))
  h2_nowe <- setNames(rowSums(Lam^2), colnames(R))
  slad[[i + 1]] <- h2_nowe
  if (max(abs(h2_nowe - h2)) < .001) break
  h2 <- h2_nowe
}
iteracje <- i
iteracje
tab <- data.frame(SMC = slad[[1]], iteracja_1 = slad[[2]], koncowe = slad[[length(slad)]])
round(tab, 3)

# To samo w pakiecie psych (bez rotacji, te same kryteria zbieżności)
paf0 <- fa(dane, nfactors = 2, fm = "pa", rotate = "none", min.err = .001)
round(cbind(reczne = rowSums(Lam^2), psych = paf0$communality), 3)
round(paf0$values[1:3], 3)          # wartości własne zredukowanej macierzy po ekstrakcji

# Rozwiązanie po rotacji oblimin (do interpretacji)
paf <- fa(dane, nfactors = 2, fm = "pa", rotate = "oblimin")
print(paf$loadings, cutoff = 0, digits = 2)
round(paf$Phi, 2)

# Porównanie z metodą największej wiarygodności
ml <- fa(dane, nfactors = 2, fm = "ml", rotate = "oblimin")
round(cbind(PAF = paf$communality, ML = ml$communality), 2)
round(c(chi2 = ml$STATISTIC, df = ml$dof, p = ml$PVAL, RMSEA = ml$RMSEA[1]), 3)
Wynik w R
           [,1]  [,2]  [,3]  [,4]
dane      2.822 1.541 0.927 0.744
losowe_95 1.368 1.235 1.143 1.072
[1] 2
[1] 16
       SMC iteracja_1 koncowe
rod1 0.470      0.592   0.778
rod2 0.377      0.458   0.464
rod3 0.259      0.287   0.270
rod4 0.218      0.259   0.245
prz1 0.371      0.480   0.550
prz2 0.332      0.441   0.518
prz3 0.312      0.376   0.378
prz4 0.114      0.137   0.128
     reczne psych
rod1  0.778 0.775
rod2  0.464 0.465
rod3  0.270 0.271
rod4  0.245 0.245
prz1  0.550 0.550
prz2  0.518 0.518
prz3  0.378 0.378
prz4  0.128 0.128
[1] 2.306 1.024 0.185

Loadings:
     PA1   PA2
rod1  0.89 -0.04
rod2  0.63  0.12
rod3  0.51  0.03
rod4  0.49  0.02
prz1  0.04  0.73
prz2 -0.07  0.74
prz3  0.10  0.57
prz4 -0.03  0.37

                PA1  PA2
SS loadings    1.72 1.56
Proportion Var 0.21 0.19
Cumulative Var 0.21 0.41
     PA1  PA2
PA1 1.00 0.34
PA2 0.34 1.00
      PAF   ML
rod1 0.78 0.79
rod2 0.46 0.45
rod3 0.27 0.30
rod4 0.25 0.23
prz1 0.55 0.55
prz2 0.52 0.49
prz3 0.38 0.39
prz4 0.13 0.13
       chi2          df           p RMSEA.RMSEA
     14.042      13.000       0.371       0.017
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; ekstrakcję porównawczą i rotację wykonano pakietami psych i GPArotation, dane wygenerowano pakietem MASS, rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie wspólności początkowych z końcowymi – w tabeli raportuj wspólności po ekstrakcji; SMC to tylko punkt startowy.
- Ignorowanie ostrzeżeń o braku zbieżności – jeśli program przerwał iteracje po limicie (np. 25 w SPSS), wynik nie jest rozwiązaniem; zwiększ limit albo sprawdź liczbę czynników.
- Wspólność większa od 1 – to rozwiązanie niewłaściwe; zmniejsz liczbę czynników lub przyjrzyj się pozycjom prawie identycznym.
- Kryterium Kaisera na wartościach własnych macierzy zredukowanej – próg 1 nie ma tu uzasadnienia, zob. metoda Kaisera.
- Opisywanie PAF jako „PCA z rotacją” – to różne modele; PAF nie tworzy ważonych sum pozycji, tylko szacuje czynniki wspólne.
- Pozostawienie pozycji o bardzo niskiej wspólności bez komentarza – prz4 (h² = .13) dzieli z czynnikiem tylko 13% wariancji; sprawdź jej treść, a decyzję o usunięciu uzasadnij merytorycznie.
Najczęstsze pytania
Czym różni się metoda osi głównych od głównych składowych?
Tylko przekątną analizowanej macierzy, ale z dużymi skutkami. Główne składowe analizują macierz z jedynkami, więc obejmują całą wariancję pozycji łącznie z błędem. Osie główne wstawiają na przekątną wspólności, więc czynniki wyjaśniają tylko wariancję wspólną, a ładunki nie są sztucznie zawyżone.
Co oznacza, że metoda osi głównych nie osiągnęła zbieżności?
Że w dozwolonej liczbie iteracji wspólności wciąż się zmieniały, więc wynik nie jest stabilnym rozwiązaniem. Zwiększ limit iteracji, a jeśli to nie pomaga, sprawdź liczbę czynników i pozycje bardzo silnie skorelowane. Często przyczyną jest zbyt wiele czynników lub zbyt mała próba.
Czy metoda osi głównych wymaga rozkładu normalnego?
Nie. PAF nie zakłada żadnego rozkładu, dlatego bywa zalecana przy skalach Likerta i danych skośnych. Ceną jest brak testu dopasowania modelu, który daje metoda największej wiarygodności.
Co to są wspólności początkowe w metodzie osi głównych?
To wartości startowe wstawiane na przekątną macierzy korelacji, zwykle kwadraty korelacji wielokrotnej (SMC) każdej pozycji z pozostałymi. Są dolnym oszacowaniem wspólności, dlatego w kolejnych iteracjach zwykle rosną, najbardziej dla najsilniejszych pozycji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Briggs, N. E., & MacCallum, R. C. (2003). Recovery of weak common factors by maximum likelihood and ordinary least squares estimation. Multivariate Behavioral Research, 38(1), 25–56. https://doi.org/10.1207/s15327906mbr3801_2 ● Otwarty dostęp
- de Winter, J. C. F., & Dodou, D. (2012). Factor recovery by principal axis factoring and maximum likelihood factor analysis as a function of factor pattern and sample size. Journal of Applied Statistics, 39(4), 695–710. https://doi.org/10.1080/02664763.2011.610445
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219–246. https://doi.org/10.1177/0095798418771807 ● Otwarty dostęp
Cytowania BibTeX
@article{briggs2003recovery, author={Briggs, Nancy E. and MacCallum, Robert C.}, title={{Recovery of weak common factors by maximum likelihood and ordinary least squares estimation}}, journal={Multivariate Behavioral Research}, year={2003}, volume={38}, number={1}, pages={25--56}, doi={10.1207/s15327906mbr3801_2}}@article{dewinter2012factor, author={de Winter, Joost C. F. and Dodou, Dimitra}, title={{Factor recovery by principal axis factoring and maximum likelihood factor analysis as a function of factor pattern and sample size}}, journal={Journal of Applied Statistics}, year={2012}, volume={39}, number={4}, pages={695--710}, doi={10.1080/02664763.2011.610445}}@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{watkins2018exploratory, author={Watkins, Marley W.}, title={{Exploratory factor analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2018}, volume={44}, number={3}, pages={219--246}, doi={10.1177/0095798418771807}}