Co to jest metoda Kaisera?
Metoda Kaisera (kryterium Kaisera, kryterium Kaisera–Guttmana, ang. Kaiser criterion, eigenvalue-greater-than-one rule, w skrócie K1) to reguła wyboru liczby czynników lub składowych: zachowujesz tyle wymiarów, ile wartości własnych macierzy korelacji jest większych od 1. Stosuje się ją w analizie głównych składowych i – bardzo często, choć z mniejszym uzasadnieniem – w eksploracyjnej analizie czynnikowej (EFA). W SPSS jest to domyślne ustawienie okna ekstrakcji, dlatego trafia do wielu prac dyplomowych bez żadnej decyzji badacza.
Reguła ma prostą intuicję. Po standaryzacji każda pozycja wnosi do analizy jedną jednostkę wariancji, a suma wartości własnych równa się liczbie pozycji. Składowa z wartością własną poniżej 1 wyjaśnia więc mniej niż pojedyncza pozycja – „nie opłaca się” jej zatrzymywać.
Skąd się wzięła reguła „większe od 1”?
Podstawą jest twierdzenie Guttmana (1954): liczba wartości własnych pełnej macierzy korelacji (z jedynkami na przekątnej), które są większe lub równe 1, jest dolnym ograniczeniem liczby czynników wspólnych w populacji. Guttman pokazał przy tym dwa lepsze ograniczenia. Kaiser (1960) spopularyzował tę wartość jako praktyczną regułę zatrzymywania czynników w czasach, gdy obliczenia wykonywały pierwsze komputery, a analiza musiała być w pełni automatyczna.
Z tego rodowodu wynikają dwa ograniczenia, które łatwo przeoczyć:
- Twierdzenie dotyczy macierzy populacyjnej. W próbie wartości własne rozrzucają się wokół wartości populacyjnych: pierwsze są zawyżone, ostatnie zaniżone. Składowa szumu łatwo przekracza próg 1.
- Dotyczy macierzy z jedynkami na przekątnej, czyli rozwiązania metodą głównych składowych. W macierzy zredukowanej, z wspólnościami na przekątnej (jak w metodzie osi głównych), wartości własne są mniejsze i próg 1 traci uzasadnienie.
Fabrigar i in. (1999) pokazali, że każda decyzja w EFA – także wybór liczby czynników – wpływa na wynik, a w przeglądzie artykułów psychologicznych badacze rutynowo podejmowali te decyzje w wątpliwy sposób. Hayton i in. (2004) wskazują analizę równoległą jako jedną z najtrafniejszych metod ustalania liczby czynników.
Przykład: skala dobrostanu z 18 pozycji
Studentki i studenci (N = 220) wypełnili 18-pozycyjną skalę dobrostanu z trzema podskalami po 6 pozycji: dobrostan emocjonalny, relacje z innymi i poczucie sensu (odpowiedzi 1–5; dane symulowane z modelu trzyczynnikowego, więc znamy prawidłową odpowiedź: 3 czynniki). Wartości własne macierzy korelacji wyniosły:
| Składowa | Wartość własna λ | % wariancji | Próg analizy równoległej (95. percentyl) | K1: λ > 1? |
|---|---|---|---|---|
| 1 | 3.13 | 17.4 | 1.64 | tak |
| 2 | 2.01 | 11.2 | 1.50 | tak |
| 3 | 1.87 | 10.4 | 1.41 | tak |
| 4 | 1.15 | 6.4 | 1.33 | tak |
| 5 | 1.09 | 6.1 | 1.26 | tak |
| 6 | 0.97 | 5.4 | 1.20 | nie |
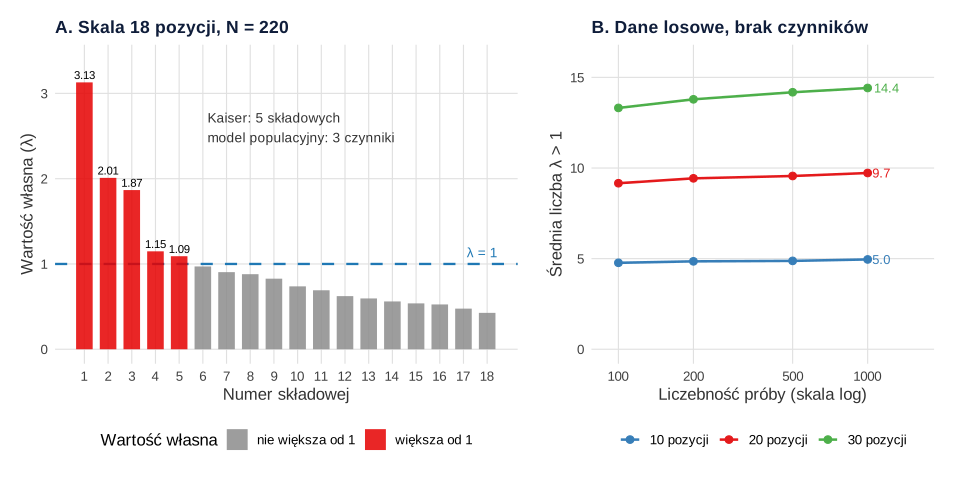
Suma wszystkich 18 wartości własnych wynosi 18, więc procent wariancji to λ / 18 × 100. Kryterium Kaisera wskazuje 5 czynników, które razem wyjaśniają 51.4% wariancji całkowitej. Czwarta i piąta wartość własna (1.15 i 1.09) przekraczają 1 tylko nieznacznie – takiej różnicy nie da się odróżnić od losowego wahania. Analiza równoległa porównuje każdą wartość własną z 95. percentylem wartości uzyskanych z 500 zbiorów losowych danych tej samej wielkości (18 pozycji, 220 osób). Czwarta wartość własna (1.15) nie przekracza progu 1.33, więc analiza równoległa wskazuje 3 czynniki – tyle, ile było w modelu, z którego wygenerowano dane.
Dlaczego kryterium Kaisera tak często się myli?
Panel B rysunku 1 pokazuje sedno problemu. W danych bez żadnej struktury (wszystkie korelacje w populacji równe zero) kryterium Kaisera „znajduje” średnio 4.8–5.0 czynników przy 10 pozycjach, 9.2–9.7 przy 20 i 13.3–14.4 przy 30. Liczba ta prawie nie zależy od liczebności próby: przy rosnącym N wartości własne skupiają się wokół 1, ale mniej więcej połowa z nich nadal leży nieco powyżej progu. Reguła reaguje więc na liczbę pozycji, a nie na strukturę danych.
- Nadmierna ekstrakcja – przy długich skalach (20–40 pozycji) i umiarkowanych ładunkach kryterium dokłada czynniki zbudowane z dwóch–trzech pozycji o podobnym brzmieniu albo z czystego szumu.
- Zbyt mała ekstrakcja – przy krótkich, skorelowanych podskalach wartość własna słabszego czynnika może spaść poniżej 1. Braeken i van Assen (2017) pokazali, że empiryczna wersja kryterium Kaisera, uwzględniająca rozkład wartości własnych w próbie, radzi sobie wtedy wyraźnie lepiej niż klasyczna reguła.
- Arbitralność progu – wartość 1.01 „liczy się”, a 0.99 – nie, choć obie niosą tę samą informację.
Kryterium Kaisera jest jedną z trzech klasycznych reguł opartych na wartościach własnych, obok metody Cattella (wykresu osypiska) i kryterium procenta wyjaśnianej wariancji. Żadna z nich nie powinna decydować samodzielnie. Ostateczna liczba czynników musi też dać się zinterpretować: każdy czynnik powinien mieć co najmniej trzy pozycje z wyraźnym ładunkiem czynnikowym i sensowną treść.
Kiedy kryterium Kaisera może się przydać?
Jako górna granica przeszukiwania. Jeśli K1 wskazuje 5 czynników, a analiza równoległa 3, porównaj rozwiązania 3-, 4- i 5-czynnikowe pod względem interpretowalności, ładunków i rzetelności podskal. Liczba z K1 jest też informacją, której mogą oczekiwać recenzenci przyzwyczajeni do SPSS – podaj ją, ale nie opieraj na niej decyzji. Przy macierzy zredukowanej (wspólności na przekątnej) nie stosuj progu 1 wcale: w przykładzie wartości własne tej macierzy wyniosły 2.41, 1.22, 1.12 i 0.36, więc próg 1 przypadkowo wskazał 3 czynniki, ale nie ma ku temu teoretycznych podstaw.
Jak opisać decyzję w pracy (APA)
Podaj wszystkie zastosowane kryteria i wyjaśnij, które było rozstrzygające. Recenzent powinien móc odtworzyć decyzję: liczba pozycji, N, macierz (korelacji Pearsona czy polichorycznych), wartości własne i wynik analizy równoległej.
Tabelę ładunków przygotujesz według wzoru tabeli analizy czynnikowej w APA. Cały proces – od decyzji o liczbie czynników po CFA na nowej próbie – opisujemy w poradniku Analiza czynnikowa EFA i CFA.
Przykład w R
Kod generuje dane z przykładu, liczy wartości własne, stosuje kryterium Kaisera, porównuje je z analizą równoległą liczoną „ręcznie”, pokazuje wartości własne macierzy zredukowanej i powtarza symulację z rysunku 1B. Liczby w tabeli, tekście i na rysunku pochodzą z tego kodu.
Kryterium Kaisera a analiza równoległa
R
# R169 – Metoda Kaisera (kryterium wartości własnej > 1)
# Dane symulowane: 18 pozycji skali dobrostanu studentów, 3 podskale po 6 pozycji
# (dobrostan emocjonalny, relacje z innymi, poczucie sensu), N = 220, odpowiedzi 1–5
library(MASS)
set.seed(1)
L <- matrix(0, 18, 3)
L[1:6, 1]   <- c(.70, .65, .60, .55, .50, .45)
L[7:12, 2]  <- c(.70, .60, .55, .50, .45, .40)
L[13:18, 3] <- c(.65, .60, .55, .50, .45, .40)
Phi <- matrix(.30, 3, 3); diag(Phi) <- 1
Sigma <- L %*% Phi %*% t(L); diag(Sigma) <- 1
z <- mvrnorm(220, rep(0, 18), Sigma)
dane <- as.data.frame(apply(z, 2, function(x) as.integer(cut(x, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)))))
names(dane) <- paste0("dob", 1:18)

R <- cor(dane)
ev <- eigen(R)$values
round(ev, 3)
sum(ev > 1)                          # liczba składowych wg kryterium Kaisera
sum(ev)                              # suma wartości własnych = liczba pozycji
round(100 * ev[1:6] / ncol(dane), 1) # % wariancji całkowitej
round(100 * sum(ev[ev > 1]) / ncol(dane), 1)

# Dla porównania: analiza równoległa (95. percentyl wartości własnych z danych losowych)
set.seed(1690)
losowe <- replicate(500, eigen(cor(matrix(rnorm(220 * 18), 220, 18)))$values)
prog_pa <- apply(losowe, 1, quantile, .95)
round(prog_pa[1:6], 3)
sum(cumprod(ev > prog_pa))           # liczba czynników wg analizy równoległej

# Kaiser na zredukowanej macierzy korelacji (wspólności SMC na przekątnej) – częsty błąd
smc <- 1 - 1 / diag(solve(R))
Rred <- R; diag(Rred) <- smc
round(eigen(Rred)$values[1:5], 3)
sum(eigen(Rred)$values > 1)

# Losowy szum: ile wartości własnych > 1 przy braku jakichkolwiek czynników?
set.seed(16900)
sym <- expand.grid(p = c(10, 20, 30), n = c(100, 200, 500, 1000))
sym$k1 <- mapply(function(p, n) mean(replicate(200, sum(eigen(cor(matrix(rnorm(n * p), n, p)))$values > 1))),
                 sym$p, sym$n)
sym
Wynik w R
 [1] 3.129 2.009 1.866 1.148 1.091 0.971 0.904 0.880 0.828 0.737 0.692 0.623
[13] 0.596 0.561 0.538 0.525 0.476 0.427
[1] 5
[1] 18
[1] 17.4 11.2 10.4  6.4  6.1  5.4
[1] 51.4
[1] 1.643 1.502 1.412 1.331 1.260 1.202
[1] 3
[1] 2.407 1.225 1.119 0.358 0.276
[1] 3
    p    n     k1
1  10  100  4.770
2  20  100  9.160
3  30  100 13.315
4  10  200  4.850
5  20  200  9.430
6  30  200 13.790
7  10  500  4.875
8  20  500  9.560
9  30  500 14.180
10 10 1000  4.955
11 20 1000  9.725
12 30 1000 14.415
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje eigen() i cor() z pakietów bazowych); dane wygenerowano pakietem MASS, rysunek przygotowano w ggplot2 i patchwork. W gotowej analizie analizę równoległą policzysz też funkcją psych::fa.parallel().
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Zostawienie domyślnego ustawienia programu – w SPSS kryterium Kaisera działa automatycznie; jeśli liczby czynników nie ustalisz świadomie, program zrobi to za Ciebie.
- Traktowanie 1.05 jak dowodu na czynnik – wartości własne bliskie 1 są w próbie niestabilne; sprawdź je analizą równoległą.
- Stosowanie progu 1 do macierzy zredukowanej – reguła ma uzasadnienie tylko dla macierzy korelacji z jedynkami na przekątnej.
- Zatrzymywanie czynników z jedną lub dwiema pozycjami – taki czynnik zwykle odzwierciedla podobne sformułowanie pozycji, a nie odrębny konstrukt.
- Podawanie tylko liczby czynników – bez wartości własnych i opisu kryteriów czytelnik nie oceni, czy decyzja była uzasadniona.
- Usuwanie pozycji, aby „wyszła” zakładana liczba czynników – zmieniasz wtedy zakres konstruktu; decyzje o pozycjach opieraj na treści i ładunkach, nie na regule K1.
Najczęstsze pytania
Na czym polega kryterium Kaisera w analizie czynnikowej?
Liczysz wartości własne macierzy korelacji pozycji i zatrzymujesz tyle czynników, ile z nich jest większych od 1. Uzasadnienie: po standaryzacji każda pozycja ma wariancję 1, więc czynnik z wartością własną poniżej 1 wyjaśnia mniej niż jedna pozycja. W SPSS jest to domyślne ustawienie ekstrakcji.
Dlaczego kryterium Kaisera wskazuje za dużo czynników?
Bo w próbie wartości własne rozrzucają się wokół 1 nawet wtedy, gdy struktury nie ma. W symulacji z 20 pozycjami bez żadnych korelacji w populacji reguła wskazywała średnio 9–10 czynników, niezależnie od liczebności próby. Im więcej pozycji, tym więcej przypadkowych wartości własnych nieco powyżej 1.
Czy w pracy dyplomowej można użyć tylko kryterium Kaisera?
Lepiej nie. Recenzenci i przewodniki metodologiczne oczekują analizy równoległej, a K1 traktują jako kryterium pomocnicze. Podaj wartości własne, wynik analizy równoległej i krótko uzasadnij przyjętą liczbę czynników treścią pozycji.
Czy kryterium Kaisera stosuje się do wartości własnych po ekstrakcji?
Nie. Próg 1 ma uzasadnienie tylko dla macierzy korelacji z jedynkami na przekątnej (rozwiązanie metodą głównych składowych). Wartości własne macierzy zredukowanej, z wspólnościami na przekątnej, są mniejsze, więc ten sam próg traci sens.
Czym jest empiryczne kryterium Kaisera?
To odmiana reguły zaproponowana przez Braekena i van Assena (2017), w której próg dla kolejnych wartości własnych zależy od liczby pozycji i liczebności próby, a nie wynosi zawsze 1. W ich symulacjach działała tak dobrze jak analiza równoległa, a przy krótkich, skorelowanych skalach – lepiej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Braeken, J., & van Assen, M. A. L. M. (2017). An empirical Kaiser criterion. Psychological Methods, 22(3), 450–466. https://doi.org/10.1037/met0000074 ● Otwarty dostęp
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Guttman, L. (1954). Some necessary conditions for common-factor analysis. Psychometrika, 19(2), 149–161. https://doi.org/10.1007/bf02289162
- Hayton, J. C., Allen, D. G., & Scarpello, V. (2004). Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis. Organizational Research Methods, 7(2), 191–205. https://doi.org/10.1177/1094428104263675 ● Otwarty dostęp: pełny tekst
- Kaiser, H. F. (1960). The application of electronic computers to factor analysis. Educational and Psychological Measurement, 20(1), 141–151. https://doi.org/10.1177/001316446002000116
Cytowania BibTeX
@article{braeken2017empirical, author={Braeken, Johan and van Assen, Marcel A. L. M.}, title={{An empirical Kaiser criterion}}, journal={Psychological Methods}, year={2017}, volume={22}, number={3}, pages={450--466}, doi={10.1037/met0000074}}@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{guttman1954some, author={Guttman, Louis}, title={{Some necessary conditions for common-factor analysis}}, journal={Psychometrika}, year={1954}, volume={19}, number={2}, pages={149--161}, doi={10.1007/bf02289162}}@article{hayton2004factor, author={Hayton, James C. and Allen, David G. and Scarpello, Vida}, title={{Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={2}, pages={191--205}, doi={10.1177/1094428104263675}}@article{kaiser1960application, author={Kaiser, Henry F.}, title={{The application of electronic computers to factor analysis}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={141--151}, doi={10.1177/001316446002000116}}