Co to jest KMO i test sferyczności Bartletta?
Miara Kaisera–Meyera–Olkina (KMO) i test sferyczności Bartletta to dwa wskaźniki, które przed eksploracyjną analizą czynnikową (EFA) albo analizą głównych składowych odpowiadają na pytanie, czy w macierzy korelacji jest w ogóle czego szukać. Odpowiadają na nie z dwóch stron:
- KMO (ang. Kaiser–Meyer–Olkin measure of sampling adequacy, MSA) ocenia, czy korelacje między zmiennymi wynikają ze wspólnych czynników, czy raczej ze związków par zmiennych. Przyjmuje wartości od 0 do 1; wyższa wartość jest lepsza.
- Test Bartletta sprawdza hipotezę zerową, że macierz korelacji w populacji jest macierzą jednostkową, czyli że wszystkie korelacje wynoszą zero. Istotny wynik oznacza tylko tyle, że jakieś korelacje istnieją.
Miarę adekwatności doboru wprowadził Kaiser (1970), a obecnie stosowaną postać podali Kaiser i Rice (1974). Test sferyczności wywodzi się z pracy Bartletta (1950) o testach istotności w analizie czynnikowej. Oba wskaźniki należą do klasycznych reguł decyzyjnych, czy macierz nadaje się do analizy czynnikowej (Dziuban i Shirkey, 1974). Sam test – jego wzór, założenia i wrażliwość na liczebność – szczegółowo opisuje hasło test sferyczności Bartletta. Tu skupiamy się na tym, jak oba wskaźniki czytać razem i co mówi KMO.
Jak liczy się KMO
KMO porównuje zwykłe korelacje z korelacjami cząstkowymi, czyli korelacjami dwóch zmiennych po usunięciu wpływu wszystkich pozostałych:
Sumy obejmują wszystkie pary różnych zmiennych, rij to korelacja, a qij – korelacja cząstkowa. Logika jest prosta. Jeśli zmienne łączą wspólne czynniki, to po kontroli pozostałych zmiennych pary niewiele już ze sobą wiąże. Korelacje cząstkowe są wtedy małe, a KMO bliskie 1. Jeśli korelacje cząstkowe są podobnej wielkości co zwykłe, zmienne łączą raczej pojedyncze, specyficzne związki, a KMO spada w okolice .50.
Ten sam wzór liczony tylko dla par, w których występuje dana zmienna, daje MSA dla pojedynczej pozycji. Wartość ogólną najczęściej opisuje się etykietami zaproponowanymi przez Kaisera:
| KMO | Etykieta (ang.) | Polski odpowiednik |
|---|---|---|
| ≥ .90 | marvelous | znakomita |
| .80–.89 | meritorious | bardzo dobra |
| .70–.79 | middling | przeciętna |
| .60–.69 | mediocre | mierna |
| .50–.59 | miserable | słaba |
| < .50 | unacceptable | nie do przyjęcia |
To umowne etykiety, a nie granice istotności. W praktyce KMO poniżej .60 jest sygnałem, żeby przyjrzeć się zestawowi zmiennych, a pozycje z MSA poniżej .50 to pierwsi kandydaci do usunięcia.
Co obniża KMO
- Pozycje niezwiązane z resztą. Ich korelacje są bliskie zera, więc nie wnoszą wspólnej wariancji. To najczęstsza przyczyna niskiego MSA pojedynczej pozycji.
- Pary niemal identycznych pozycji. Dwa twierdzenia o tej samej treści korelują silnie także po kontroli pozostałych zmiennych. Wysoka korelacja cząstkowa trafia do mianownika i obniża KMO, choć same pozycje są „dobre”.
- Zbyt mało pozycji na czynnik. Gdy czynnik ma dwie pozycje, ich związek wygląda jak związek pary, a nie przejaw wspólnego czynnika.
- Mieszanie pozycji z różnych narzędzi. Zmienne demograficzne czy pojedyncze pytania ankietowe dołączone do pozycji skal rzadko mają wspólne czynniki z resztą.
Przykład: kwestionariusz z jedną zbędną pozycją
Kwestionariusz ma 10 pozycji (odpowiedzi 1–5), wypełniło go 250 osób studiujących (dane symulowane). Cztery pozycje dotyczą stresu akademickiego, cztery – wsparcia rówieśniczego, pozycja „sen” jest słabo związana ze stresem, a pozycja „dojazd” (czas dojazdu na uczelnię) nie łączy się z niczym.
- KMO całości. Suma kwadratów korelacji wynosi 3.044, a suma kwadratów korelacji cząstkowych – 0.909, więc KMO = 3.044 / (3.044 + 0.909) = .77, czyli wartość przeciętna.
- Test Bartletta. χ²(45) = 551.8, p < .001. Macierz nie jest jednostkowa – ale tego można się było spodziewać.
- MSA dla pozycji. Dziewięć pozycji ma MSA od .72 do .82, a pozycja „dojazd” – .31 (rysunek 1).
- Decyzja. Po usunięciu pozycji „dojazd” KMO wynosi .78, a najniższe MSA – .72.
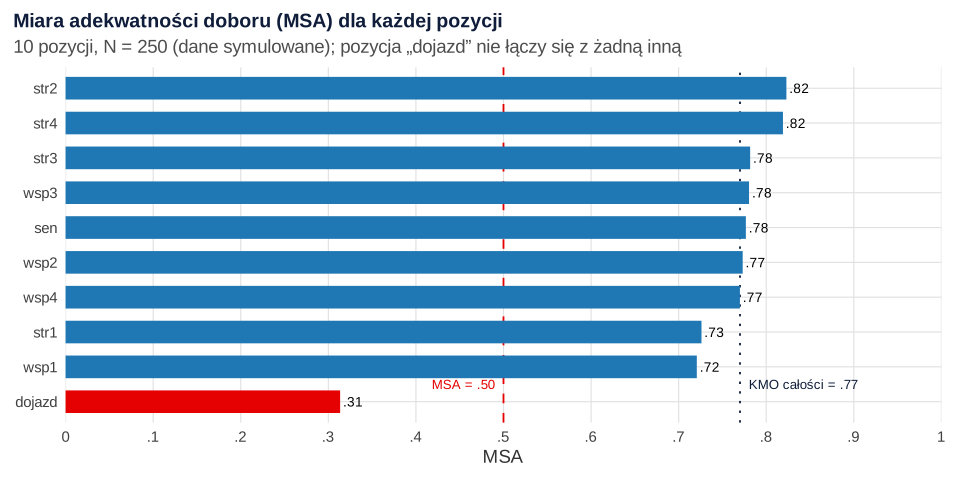
Przykład pokazuje dwie rzeczy. Po pierwsze, ogólne KMO potrafi ukryć złą pozycję: z „dojazdem” i bez niego wartość jest prawie taka sama (.77 i .78), a dopiero MSA pozycji ujawnia problem. Po drugie, dobre MSA nie oznacza, że pozycja jest dobrym wskaźnikiem czynnika. Pozycja „sen” ma MSA .78, a jej zasoby zmienności wspólnej w rozwiązaniu dwuczynnikowym wynoszą tylko .08. MSA mówi, czy pozycja „pasuje” do wzoru korelacji, a h² – ile jej wariancji wyjaśniają czynniki.
Pułapka: istotny test Bartletta przy słabych korelacjach
Test Bartletta ma bardzo dużą moc w typowych próbach, więc prawie zawsze wychodzi istotny. W drugiej symulacji 600 osób odpowiadało na 10 zmiennych, które korelują ze sobą średnio na poziomie r = .07. Test Bartletta dał χ²(45) = 162.62, p < .001, choć tak słabe korelacje nie dają podstaw do sensownej struktury czynnikowej. KMO wyniosło w tym przypadku .64, czyli wartość mierną. Im większa próba, tym słabsze korelacje wystarczą do istotnego wyniku, więc w dużych badaniach internetowych test praktycznie zawsze odrzuca hipotezę zerową. Istotny test Bartletta jest warunkiem koniecznym, ale bardzo słabym. Więcej mówi KMO, a jeszcze więcej – sama macierz korelacji i wielkość korelacji między pozycjami.
Miejsce KMO i Bartletta w analizie czynnikowej
Oba wskaźniki to tylko pierwszy filtr. Watkins (2018) w przewodniku po dobrych praktykach EFA podkreśla, że każda decyzja w analizie powinna wynikać z dowodów, a przeglądy publikacji wciąż wykazują niepełne raporty. Typowa kolejność wygląda tak:
- macierz korelacji (czy pozycje korelują na poziomie co najmniej .30 z kilkoma innymi);
- KMO i MSA pozycji, test Bartletta;
- liczba czynników: analiza równoległa, metoda Cattella i teoria;
- ekstrakcja (np. metoda osi głównych) i rotacja;
- interpretacja ładunków i zasobów zmienności wspólnej.
Cały proces – z wyborem między EFA i CFA – opisuje wpis Analiza czynnikowa EFA i CFA.
Jak opisać KMO i test Bartletta w pracy (APA)
Wystarczy jedno zdanie z wartością KMO, wynikiem testu Bartletta (χ², df, p) oraz informacją o pozycjach z niskim MSA i o tym, co z nimi zrobiono. KMO zapisuj bez zera wiodącego, bo jest ograniczone do przedziału 0–1.
Wyniki samej analizy czynnikowej zestaw w tabeli według wzoru tabeli analizy czynnikowej w APA.
Przykład w R
Kod liczy KMO „ręcznie” i funkcją KMO() z pakietu psych, wypisuje MSA dla pozycji, wykonuje test sferyczności Bartletta, powtarza ocenę po usunięciu najsłabszej pozycji, porównuje MSA z zasobami zmienności wspólnej i pokazuje pułapkę testu Bartletta przy słabych korelacjach. Liczby w tekście pochodzą z tego kodu.
KMO, MSA pozycji i test Bartletta
R
# R165 – KMO i test sferyczności Bartletta przed EFA (dane symulowane)
# Kwestionariusz 10 pozycji (1–5), N = 250: 4 pozycje stresu akademickiego, 4 pozycje wsparcia rówieśniczego,
# pozycja 9 (sen) słabo związana ze stresem, pozycja 10 (dojazd na uczelnię) niezwiązana z niczym.
suppressPackageStartupMessages({library(psych); library(GPArotation)})
set.seed(165)
N <- 250
stres <- rnorm(N); wsparcie <- -0.3 * stres + rnorm(N, 0, sqrt(1 - 0.09))
poz <- function(f, l) findInterval(l * f + rnorm(N, 0, sqrt(1 - l^2)), c(-1.5, -0.5, 0.5, 1.5)) + 1
X <- data.frame(str1 = poz(stres, .75), str2 = poz(stres, .70), str3 = poz(stres, .72), str4 = poz(stres, .66),
                wsp1 = poz(wsparcie, .74), wsp2 = poz(wsparcie, .70), wsp3 = poz(wsparcie, .68), wsp4 = poz(wsparcie, .71),
                sen = poz(stres, .22), dojazd = poz(rnorm(N), .70))
k <- KMO(X)
# KMO „ręcznie”: suma kwadratów korelacji vs suma kwadratów korelacji cząstkowych (poza przekątną)
R <- cor(X); Q <- -cov2cor(solve(R)); poza <- upper.tri(R)
round(c(suma_r2 = sum(R[poza]^2), suma_q2 = sum(Q[poza]^2), KMO = sum(R[poza]^2) / (sum(R[poza]^2) + sum(Q[poza]^2))), 3)
round(k$MSA, 3)
round(sort(k$MSAi), 3)
b <- cortest.bartlett(cor(X), n = N)
print(c(chi2 = round(b$chisq, 2), df = b$df)); signif(b$p.value, 3)

# Po usunięciu pozycji o najniższym MSA
X2 <- X[, setdiff(names(X), "dojazd")]
k2 <- KMO(X2); round(k2$MSA, 3); round(range(k2$MSAi), 3)
# MSA nie zastępuje zasobów zmienności wspólnej: pozycja „sen” ma dobre MSA, ale niską h²
efa <- fa(X2, nfactors = 2, fm = "minres", rotate = "oblimin")
round(efa$communality, 2)

# Pułapka: test Bartletta przy słabych korelacjach i dużej próbie
set.seed(1650)
R_slaba <- matrix(0.08, 10, 10); diag(R_slaba) <- 1
Y <- MASS::mvrnorm(600, rep(0, 10), R_slaba)
b2 <- cortest.bartlett(cor(Y), n = 600)
print(c(srednie_r = round(mean(cor(Y)[upper.tri(diag(10))]), 3), chi2 = round(b2$chisq, 2), df = b2$df, KMO = round(KMO(Y)$MSA, 3)))
signif(b2$p.value, 3)
Wynik w R
suma_r2 suma_q2     KMO
  3.044   0.909   0.770
[1] 0.77
dojazd   wsp1   str1   wsp4   wsp2    sen   wsp3   str3   str4   str2
 0.313  0.721  0.726  0.770  0.773  0.777  0.780  0.782  0.819  0.823
 chi2    df
551.8  45.0
[1] 2.05e-88
[1] 0.777
[1] 0.721 0.822
str1 str2 str3 str4 wsp1 wsp2 wsp3 wsp4  sen
0.60 0.40 0.52 0.49 0.40 0.38 0.39 0.52 0.08
srednie_r      chi2        df       KMO
    0.072   162.620    45.000     0.638
[1] 3.23e-15
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; KMO, test Bartletta i EFA policzono w pakiecie psych (rotacja oblimin z pakietu GPArotation), dane w drugiej części wygenerowano funkcją mvrnorm() z pakietu MASS, a rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Istotny test Bartletta jako dowód, że „można robić analizę czynnikową”. W przykładzie test był istotny przy średniej korelacji .07.
- Raportowanie tylko ogólnego KMO. Sprawdzaj MSA każdej pozycji – ogólna wartość .77 ukryła pozycję z MSA .31.
- Utożsamianie MSA z jakością pozycji. Pozycja może mieć dobre MSA i bardzo niskie zasoby zmienności wspólnej, jak „sen” (h² = .08).
- Traktowanie etykiet Kaisera jak sztywnych progów. KMO = .69 i .71 nie różnią się jakościowo, choć mają różne etykiety.
- Usuwanie pozycji wyłącznie dla podniesienia KMO. Każdą decyzję uzasadnij także treścią pozycji i teorią, inaczej zawęzisz zakres konstruktu.
- Zapis z zerem wiodącym lub przecinkiem. W stylu APA: KMO = .77, a nie 0,77.
Najczęstsze pytania
Jaka wartość KMO jest dobra?
Najczęściej przyjmuje się, że KMO co najmniej .80 to wartość bardzo dobra, .70–.79 przeciętna, .60–.69 mierna, a poniżej .50 nie do przyjęcia. To umowne etykiety Kaisera, a nie granice istotności. Oprócz ogólnego KMO sprawdź MSA każdej pozycji – pozycje poniżej .50 to kandydaci do usunięcia.
Co oznacza istotny test sferyczności Bartletta?
Oznacza tylko, że macierz korelacji różni się od jednostkowej, czyli że przynajmniej część zmiennych jest ze sobą skorelowana. Przy typowych liczebnościach test jest istotny nawet przy bardzo słabych korelacjach. W przykładzie na tej stronie był istotny przy średniej korelacji .07, dlatego sam nie uzasadnia analizy czynnikowej.
Czym różni się KMO od MSA?
KMO to ogólna miara dla całej macierzy korelacji, a MSA to ten sam wskaźnik policzony osobno dla każdej zmiennej. Wartości MSA znajdziesz na przekątnej macierzy antyobrazowej w SPSS albo w elemencie MSAi funkcji KMO() z pakietu psych w R.
Jak policzyć KMO i test Bartletta w R?
W pakiecie psych użyj KMO(dane) – zwraca ogólne KMO (MSA) i wartości dla pozycji (MSAi). Test Bartletta wykonasz funkcją cortest.bartlett(cor(dane), n = nrow(dane)), która podaje χ², stopnie swobody i wartość p.
Co zrobić, gdy KMO jest za niskie?
Sprawdź MSA pozycji i macierz korelacji: pozycje, które z niczym nie korelują, obniżają KMO i zwykle nie pasują do mierzonego konstruktu. Usuń je, jeśli uzasadnia to także ich treść. Gdy niskie KMO dotyczy całego zestawu, rozważ, czy zmienne w ogóle mierzą wspólne konstrukty, i czy próba nie jest za mała.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bartlett, M. S. (1950). Tests of significance in factor analysis. British Journal of Statistical Psychology, 3(2), 77–85. https://doi.org/10.1111/j.2044-8317.1950.tb00285.x
- Dziuban, C. D., & Shirkey, E. C. (1974). When is a correlation matrix appropriate for factor analysis? Some decision rules. Psychological Bulletin, 81(6), 358–361. https://doi.org/10.1037/h0036316
- Kaiser, H. F. (1970). A second generation little jiffy. Psychometrika, 35(4), 401–415. https://doi.org/10.1007/bf02291817
- Kaiser, H. F., & Rice, J. (1974). Little Jiffy, Mark IV. Educational and Psychological Measurement, 34(1), 111–117. https://doi.org/10.1177/001316447403400115
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219–246. https://doi.org/10.1177/0095798418771807 ● Otwarty dostęp
Cytowania BibTeX
@article{bartlett1950tests, author={Bartlett, M. S.}, title={{Tests of significance in factor analysis}}, journal={British Journal of Statistical Psychology}, year={1950}, volume={3}, number={2}, pages={77--85}, doi={10.1111/j.2044-8317.1950.tb00285.x}}@article{dziuban1974when, author={Dziuban, Charles D. and Shirkey, Edwin C.}, title={{When is a correlation matrix appropriate for factor analysis? Some decision rules}}, journal={Psychological Bulletin}, year={1974}, volume={81}, number={6}, pages={358--361}, doi={10.1037/h0036316}}@article{kaiser1970second, author={Kaiser, Henry F.}, title={{A second generation little jiffy}}, journal={Psychometrika}, year={1970}, volume={35}, number={4}, pages={401--415}, doi={10.1007/bf02291817}}@article{kaiser1974little, author={Kaiser, Henry F. and Rice, John}, title={{Little Jiffy, Mark IV}}, journal={Educational and Psychological Measurement}, year={1974}, volume={34}, number={1}, pages={111--117}, doi={10.1177/001316447403400115}}@article{watkins2018exploratory, author={Watkins, Marley W.}, title={{Exploratory factor analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2018}, volume={44}, number={3}, pages={219--246}, doi={10.1177/0095798418771807}}