Czym jest alfa Cronbacha i co naprawdę mierzy?
Alfa Cronbacha (α, ang. Cronbach’s alpha, coefficient alpha) to najczęściej raportowany wskaźnik rzetelności skali kwestionariuszowej. Szacuje, jaka część wariancji wyniku sumarycznego (albo średniej z pozycji) to wariancja wyniku prawdziwego, a jaka – błąd pomiaru. Liczy się ją z jednego pomiaru, na podstawie tego, jak pozycje skali współzmieniają się ze sobą, dlatego należy do miar spójności wewnętrznej.
We wzorze k to liczba pozycji, si² – wariancja pozycji i, a sX² – wariancja wyniku sumarycznego. Gdy pozycje mocno ze sobą korelują, wariancja sumy jest dużo większa niż suma wariancji pozycji i alfa rośnie. Cronbach (1951) pokazał, że współczynnik KR-20 dla pozycji zero-jedynkowych jest szczególnym przypadkiem alfy, a sama alfa jest średnią ze wszystkich możliwych współczynników rzetelności połówkowej. Już wtedy radził, by test składający się z wyraźnie odrębnych części dzielić na podtesty przed użyciem wzoru.
Trzy rzeczy, o których łatwo zapomnieć:
- Alfa opisuje wyniki w konkretnej próbie, a nie „skalę w ogóle”. Ten sam kwestionariusz w innej grupie może mieć inną alfę, bo zmienia się zróżnicowanie badanych.
- Alfa nie jest miarą jednowymiarowości. Sijtsma (2009) podkreśla, że jej wartość nie mówi nic o wewnętrznej strukturze testu, a Cortina (1993) pokazał na hipotetycznych testach, że na wartość alfy wpływają zarówno długość testu, jak i liczba wymiarów – długa skala może mieć wysoką alfę mimo kilku słabo powiązanych wymiarów.
- Alfa rośnie z liczbą pozycji. Przy tej samej średniej korelacji między pozycjami skala 20-pozycyjna ma wyższą alfę niż 6-pozycyjna. Tę zależność szczegółowo pokazujemy w haśle o spójności wewnętrznej.
Rzetelność to też nie trafność: skala może bardzo rzetelnie mierzyć coś innego, niż zamierzałeś. Wysoka alfa jest warunkiem koniecznym, ale nie wystarczającym dobrej skali.
Założenia alfy: kiedy alfa równa się rzetelności
Alfa jest dobrym oszacowaniem rzetelności tylko wtedy, gdy dane spełniają model pomiaru, z którego ją wyprowadzono. W języku konfirmacyjnej analizy czynnikowej chodzi o cztery warunki.
| Założenie | Co oznacza | Skutek naruszenia | Jak sprawdzić |
|---|---|---|---|
| Jednowymiarowość | wszystkie pozycje mierzą jedną zmienną ukrytą | alfa zwykle zaniża rzetelność wyniku ogólnego i maskuje strukturę | EFA, CFA, analiza równoległa |
| Tau-równoważność | każda pozycja ma ten sam (niestandaryzowany) ładunek | alfa zaniża rzetelność; przy umiarkowanym zróżnicowaniu ładunków – niewiele | porównanie modelu tau-równoważnego i kongenerycznego w CFA |
| Nieskorelowane błędy | pozycje łączy tylko mierzona cecha, a nie np. podobne sformułowanie | alfa może zawyżać rzetelność | treść pozycji, korelacje reszt w CFA, indeksy modyfikacji |
| Skala ciągła | pozycje traktujemy jak zmienne ilościowe | przy 2–3 kategoriach i skośnych rozkładach oszacowanie jest mniej dokładne | rozkłady odpowiedzi, efekt sufitu i podłogi |
Model kongeneryczny pozwala, by każda pozycja miała własny ładunek, czyli inaczej silny związek z mierzoną cechą. W praktyce tak jest prawie zawsze. McNeish (2018) zauważa, że nierealistyczne założenia alfy zwykle prowadzą do zaniżenia rzetelności, i pokazuje alternatywy, przede wszystkim omegę całkowitą. Raykov (1997) wykazał, że rzetelność oszacowana z modelu strukturalnego dla miar kongenerycznych nie ma tej ogólnej skłonności do zaniżania, którą ma alfa. Z kolei przy skorelowanych błędach rozbieżność między alfą a rzeczywistą rzetelnością może być duża i warto ją wykrywać modelowaniem strukturalnym (Raykov, 2001).
Jeśli pozycje mają tylko kilka kategorii odpowiedzi, czasem liczy się alfę z korelacji polichorycznych („alfa porządkowa”). Pamiętaj jednak, że opisuje ona rzetelność zmiennych ukrytych stojących za odpowiedziami, a nie wyniku, który faktycznie policzysz z pozycji, więc nie zastępuje zwykłej alfy w opisie skali.
Przykład: skala lęku egzaminacyjnego (8 pozycji)
W przykładzie (dane symulowane) 240 studentów wypełniło 8-pozycyjną skalę lęku przed egzaminem z odpowiedziami od 1 do 5 („zdecydowanie się nie zgadzam” – „zdecydowanie się zgadzam”). Skala jest wymyślona na potrzeby poradnika. Pozycja 4 („Przed egzaminem jestem spokojny/spokojna”) jest sformułowana odwrotnie, a pozycja 8 („Wolę egzaminy ustne niż pisemne”) dotyczy raczej preferencji niż lęku – w prawdziwej skali taka pozycja mogłaby trafić do wersji roboczej i wypaść po pilotażu. Plik do pobrania: alfa-cronbacha-dane-przyklad.csv (240 wierszy, kolumny id i lek1–lek8, pozycja 4 nieprzekodowana).
Krok 1. Przygotowanie danych
Zanim policzysz alfę, przekoduj pozycje odwrócone (na skali 1–5: 6 − odpowiedź) i sprawdź braki danych. W przykładzie pominięcie tego kroku obniża alfę z .82 do .60. Szczegóły rekodowania i objawy zapomnianej pozycji odwróconej omawiamy w osobnych hasłach, a przygotowanie arkusza – w poradniku jak przygotować bazę danych do analizy.
Krok 2. Opis pozycji i korelacje między nimi
Średnie pozycji wynoszą od 2.98 do 3.24, a odchylenia standardowe – od 1.13 do 1.20. Skrajne odpowiedzi wybierało od 7.9% do 15.4% osób, więc nie ma efektu sufitu ani podłogi. Ciekawsza jest macierz korelacji: siedem pierwszych pozycji koreluje ze sobą od .32 do .57, a pozycja 8 z pozostałymi tylko od .04 do .15. Średnia korelacja między pozycjami wynosi .35, a bez pozycji 8 – .44. Clark i Watson (1995) zalecają, by przy budowie skali dążyć do jednowymiarowości, a nie do maksymalnej spójności, czyli by niemal wszystkie korelacje między pozycjami były umiarkowane. Pozycja 8 wyraźnie od tego odstaje.
Krok 3. Alfa z przedziałem ufności
Alfa dla 8 pozycji wynosi .82, 95% CI [.78, .85] (przedział Feldta), a alfa standaryzowana (liczona z korelacji zamiast kowariancji) – również .82. Przedział ufności pokazuje, że przy 240 osobach rzetelność w populacji może wynosić zarówno .78, jak i .85, dlatego podawaj go razem z alfą. Jak zapisać ten wynik w pracy i w tabeli, pokazujemy w osobnym wpisie wzór raportowania alfy Cronbacha.
Analiza pozycji: korelacja pozycja–reszta
Analiza pozycji odpowiada na pytanie, czy każda pozycja „ciągnie w tę samą stronę” co reszta skali. Podstawowym wskaźnikiem jest skorygowana korelacja pozycja–reszta (ang. corrected item–total correlation): korelacja odpowiedzi na daną pozycję z sumą pozostałych pozycji. Korelacja z sumą wszystkich pozycji byłaby zawyżona, bo pozycja korelowałaby sama ze sobą.
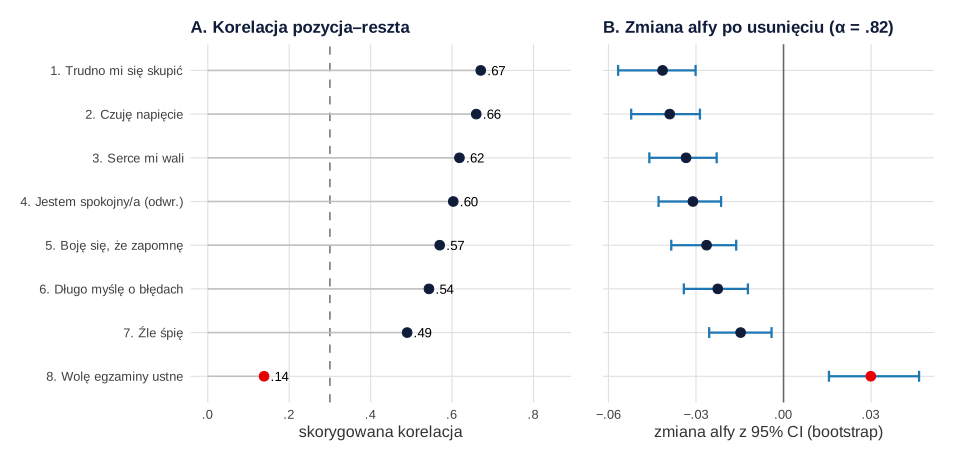
W przykładzie korelacje pozycja–reszta wynoszą od .49 do .67 dla pozycji 1–7 i .14 dla pozycji 8. Często spotykany próg .30 to reguła praktyczna, a nie kryterium z teorii pomiaru. Tavakol i Dennick (2011) zalecają poprawić albo usunąć pozycje, których korelacja z wynikiem skali jest bardzo niska, bliska zera. Pozycja odwrócona (4) ma po przekodowaniu korelację .60, czyli zachowuje się jak pozostałe – to znak, że rekodowanie zadziałało.
Korelacja pozycja–reszta to nie to samo co ładunek czynnikowy, ale oba wskaźniki zwykle układają pozycje w podobnej kolejności. W modelu CFA (niżej) ładunki standaryzowane wyniosły od .55 do .77 dla pozycji 1–7 i .15 dla pozycji 8.
„Alfa po usunięciu pozycji” – jak z niej korzystać i kiedy zawodzi
Programy podają też kolumnę alpha if item deleted: jaka byłaby alfa, gdyby daną pozycję pominąć. W przykładzie usunięcie którejkolwiek z pozycji 1–7 obniżyłoby alfę (do wartości od .77 do .80), a usunięcie pozycji 8 podniosłoby ją z .82 do .85. Alfa siedmiu pozycji wynosi .85, 95% CI [.81, .87].
Ta kolumna kusi, żeby „poprawiać” skalę, aż alfa przestanie rosnąć. Zanim cokolwiek usuniesz, sprawdź cztery rzeczy.
- Czy wzrost jest większy niż losowe wahania? Rysunek 1B pokazuje przedziały bootstrapowe zmiany alfy. Dla pozycji 8 cały przedział leży powyżej zera, [.016, .046], a wzrost pojawił się we wszystkich 2000 próbach bootstrapowych. Dla pozycji 7 przedział jest w całości ujemny, a wzrost wystąpił tylko w 0.15% prób.
- Czy decyzja nie opiera się na małej próbie? Wylosowaliśmy z tych samych danych 2000 „pilotaży” po 40 osób. Alfa wahała się w nich od .69 do .88 (95% środkowych wyników), a w 15.6% pilotaży któraś z dobrych pozycji 1–7 pozornie „psuła” skalę, bo jej usunięcie podnosiło alfę. Na 40 osobach łatwo więc usunąć dobrą pozycję. O planowaniu pilotażu piszemy w haśle o badaniu pilotażowym.
- Co mówi treść pozycji? Pozycja 8 mierzy preferencję formy egzaminu, a nie lęk – jest więc merytoryczny powód, by ją pominąć. Usunięcie pozycji, która dobrze reprezentuje jakiś aspekt konstruktu, może podnieść alfę, ale zawęzić to, co skala mierzy. Wtedy rzetelność rośnie kosztem trafności treściowej.
- Czy to Twoja skala? W gotowym, opublikowanym narzędziu nie usuwaj pozycji tylko dlatego, że w Twojej próbie podnosi to alfę – stracisz porównywalność z normami i innymi badaniami. Jeśli już to robisz, zgłoś to wyraźnie i podaj wyniki dla obu wersji. Inaczej jest przy budowie nowej skali – tam analiza pozycji jest jednym z etapów, które opisujemy w poradniku jak zbudować i zwalidować skalę psychometryczną.
Nawet przy uzasadnionej decyzji opisz ją w pracy: którą pozycję usunąłeś, dlaczego i jaka była alfa przed zmianą i po niej.
Sprawdzenie tau-równoważności i omega McDonalda
Założenie tau-równoważności możesz sprawdzić bezpośrednio. Dopasowujesz dwa jednoczynnikowe modele CFA: kongeneryczny, w którym każda pozycja ma własny ładunek, i tau-równoważny, w którym wszystkie ładunki są równe. Potem porównujesz je testem różnicy chi-kwadrat.
| Model | χ²(df) | p | CFI | RMSEA | SRMR |
|---|---|---|---|---|---|
| Kongeneryczny (ładunki swobodne) | 21.20 (20) | .386 | .998 | .016 | .029 |
| Tau-równoważny (ładunki równe) | 85.40 (27) | < .001 | .893 | .095 | .182 |
Model kongeneryczny pasuje bardzo dobrze (CFI = .998, RMSEA = .016), a narzucenie równych ładunków wyraźnie pogarsza dopasowanie: Δχ²(7) = 64.20, p < .001. Założenie alfy jest więc naruszone – głównie przez pozycję 8, której ładunek standaryzowany wynosi .15 przy .55–.77 dla pozostałych.
Gdy model kongeneryczny pasuje lepiej, naturalną alternatywą jest omega McDonalda (ωt, omega całkowita), czyli rzetelność obliczona z ładunków i wariancji błędów tego modelu. Dunn i in. (2014) proponują ją jako praktyczne rozwiązanie problemów z alfą i pokazują, jak podać ją z przedziałem ufności. W przykładzie ω = .83, 95% CI [.79, .86] (bootstrap, 1000 prób), wobec α = .82. Po usunięciu pozycji 8 omega wynosi .85, a alfa – również .85.
Wniosek jest typowy: test odrzucił tau-równoważność, a mimo to alfa i omega różnią się o .01. Przy kilkuset osobach test chi-kwadrat wykrywa nawet niewielkie różnice ładunków, a zaniżenie alfy staje się praktycznie ważne dopiero przy dużym zróżnicowaniu ładunków. Nie oznacza to, że omega jest zbędna. Pokazuje ona rzetelność zgodną z modelem, który do danych pasuje. Flora (2020) przypomina jednak, że omeg jest kilka (m.in. całkowita, hierarchiczna, porządkowa), a wybór zależy od modelu CFA dla danego konstruktu. Revelle i Condon (2019) porządkują miary od najsłabszych do najlepszych i jako zalecane wskazują omegę hierarchiczną i całkowitą. Przejście od eksploracji struktury do modelu CFA opisujemy we wpisie analiza czynnikowa EFA i CFA.
Kiedy alfa zaniża, a kiedy zawyża rzetelność? Symulacja
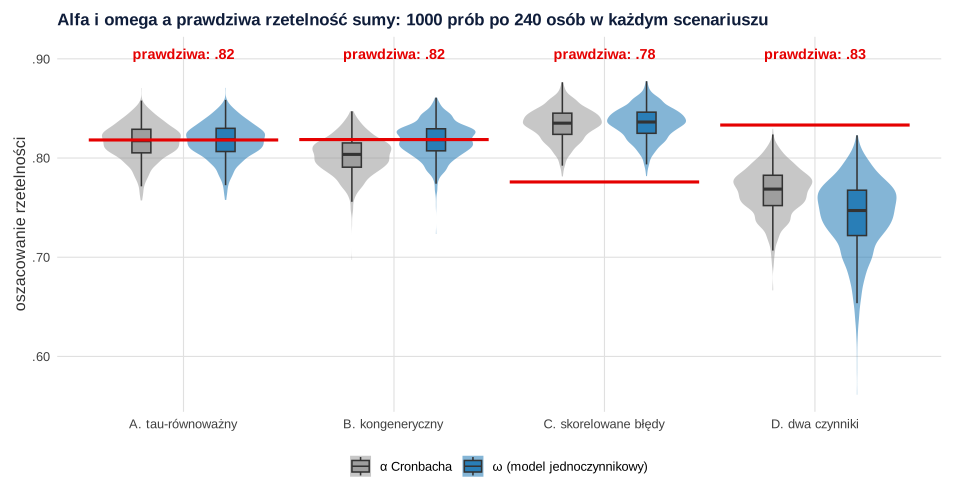
Żeby zobaczyć, jak duże są te odchylenia, zasymulowaliśmy cztery sytuacje. W każdej 1000 razy losowaliśmy próbę 240 osób odpowiadających na 8 pozycji i liczyłem alfę oraz omegę z modelu jednoczynnikowego. Prawdziwą rzetelność wyniku sumarycznego znamy z założeń symulacji.
- A. Model tau-równoważny – wszystkie ładunki .60.
- B. Model kongeneryczny – ładunki od .25 do .85.
- C. Skorelowane błędy – ładunki .60, ale trzy pary pozycji mają dodatkowo wspólne źródło wariancji (korelacja błędów .40), np. podobne sformułowania.
- D. Dwa czynniki – po 4 pozycje na każdy czynnik, ładunki .70, korelacja czynników .30.
| Scenariusz | Prawdziwa rzetelność | Średnia α | Średnia ω | Obciążenie α |
|---|---|---|---|---|
| A. tau-równoważny | .818 | .816 | .817 | −.002 |
| B. kongeneryczny | .819 | .802 | .818 | −.016 |
| C. skorelowane błędy | .776 | .834 | .835 | +.058 |
| D. dwa czynniki | .833 | .766 | .742 | −.067 |
Co z tego wynika?
- Zróżnicowane ładunki (B) obniżają alfę, ale nawet przy ładunkach od .25 do .85 tylko o .016. Omega z poprawnego modelu trafia w prawdziwą wartość.
- Skorelowane błędy (C) działają w przeciwną stronę: alfa zawyża rzetelność o .058. Omega z modelu, który tych korelacji nie uwzględnia, myli się tak samo. Dlatego podobnie brzmiące pozycje, np. „Czuję napięcie” i „Jestem spięty”, sztucznie poprawiają oba wskaźniki.
- Dwa wymiary (D) nie przeszkodziły alfie osiągnąć średnio .77 – wartości, którą wielu autorów uznałoby za akceptowalną. Alfa nie wskazała, że skala mierzy dwie różne rzeczy, a omega z błędnego modelu jednoczynnikowego wypadła jeszcze niżej. Dobry model pomiarowy jest ważniejszy niż wybór współczynnika.
Praktyczna rada: najpierw sprawdź strukturę skali (CFA albo przynajmniej EFA), a dopiero potem licz rzetelność dla każdego wymiaru osobno. Gdy skala ma kilka podskal, policz alfę lub omegę dla każdej z nich – tak zalecają również Tavakol i Dennick (2011).
Jaka wartość alfy jest dobra?
W pracach dyplomowych krąży reguła „alfa powyżej .70 jest akceptowalna, powyżej .80 dobra, powyżej .90 bardzo dobra”. Tavakol i Dennick (2011) zauważają, że w literaturze podaje się różne wartości akceptowalne, od .70 do .95. Traktuj te progi jako orientację, a przy ocenie weź pod uwagę cztery okoliczności.
- Do czego służy wynik. Do porównań średnich między grupami w badaniu naukowym wystarcza niższa rzetelność niż do decyzji o pojedynczej osobie, np. kwalifikacji do terapii.
- Długość skali. Skala z 3–4 pozycji rzadko osiąga .80, nawet jeśli pozycje są dobre. Wtedy podaj też średnią korelację między pozycjami.
- Przedział ufności. W przykładzie alfa .82 z 240 osób ma przedział [.78, .85], a w losowych podpróbach po 40 osób ta sama skala dawała alfy od .69 do .88 (95% środkowych wyników). Wartość z małej próby to słaba informacja.
- Zbyt wysoka alfa. Wartość powyżej .95 często oznacza, że pozycje powtarzają to samo innymi słowami. Skala jest wtedy dłuższa, niż trzeba, a jej zakres treściowy – wąski.
Pamiętaj też, że niska rzetelność osłabia korelacje z innymi zmiennymi, więc może sprawić, że prawdziwego związku nie wykryjesz. Spójność wewnętrzna nie jest jedyną formą rzetelności – przy cechach, które mają być stałe w czasie, przydaje się też rzetelność test–retest.
Alfa krok po kroku: lista kontrolna
- Przekoduj pozycje odwrócone i sprawdź, czy w żadnej pozycji nie zostały kody braków (np. 99).
- Sprawdź rozkłady odpowiedzi i macierz korelacji między pozycjami. Szukaj korelacji ujemnych i bliskich zera.
- Sprawdź strukturę: ile wymiarów ma skala w Twojej próbie? Rzetelność licz osobno dla każdej podskali.
- Policz alfę z 95% CI, średnią korelację między pozycjami i korelacje pozycja–reszta.
- Gdy skala jest Twoja albo zaadaptowana – dopasuj model CFA i policz omegę. W gotowym narzędziu podaj omegę obok alfy, jeśli wymaga tego promotor albo czasopismo.
- Decyzje o usunięciu pozycji opieraj na treści, wielkości próby i przedziałach ufności, a nie na samej kolumnie „alfa po usunięciu”.
- Policz wynik skali (średnią albo sumę) dopiero dla ostatecznego zestawu pozycji i opisz wszystkie decyzje.
W JASP i jamovi policzysz alfę i omegę bez pisania kodu (zob. hasła JASP i jamovi), a w R – funkcjami z pakietów psych, lavaan i semTools, jak w sekcji poniżej. Gotową tabelę rzetelności w stylu APA znajdziesz w haśle tabela rzetelności w APA. Jeśli w Twojej pracy skala zachowuje się nietypowo i nie wiesz, jak to opisać, możemy sprawdzić analizę i wyjaśnić wyniki w ramach analiz statystycznych dla studentów.
Alfa Cronbacha w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Pobierz plik alfa-cronbacha-dane-przyklad.csv i zapisz go w katalogu roboczym R. Każdy przepis wczytuje dane samodzielnie. Przepis 3 (bootstrap omegi) trwa około minuty, a symulacja w przepisie 4 – kilka minut.
1. Alfa Cronbacha i analiza pozycji
R
library(psych)   # alpha(): alfa Cronbacha, korelacje pozycja–reszta, alfa po usunięciu pozycji

dane <- read.csv("alfa-cronbacha-dane-przyklad.csv")
poz <- dane[, paste0("lek", 1:8)]

# Krok 1. Pozycja 4 jest sformułowana odwrotnie – przekoduj ją przed liczeniem alfy (skala 1–5: 6 − x)
poz$lek4 <- 6 - poz$lek4

# Krok 2. Opis pozycji i korelacje między pozycjami
round(t(sapply(poz, function(x) c(M = mean(x), SD = sd(x), proc_1 = 100 * mean(x == 1), proc_5 = 100 * mean(x == 5)))), 2)
R <- cor(poz)
round(R, 2)
round(c(srednia_r = mean(R[lower.tri(R)]), min_r = min(R[lower.tri(R)]), max_r = max(R[lower.tri(R)]),
        srednia_r_bez_8 = mean(R[-8, -8][lower.tri(R[-8, -8])])), 2)

# Krok 3. Alfa Cronbacha z 95% przedziałem ufności (metoda Feldta)
a <- alpha(poz, check.keys = FALSE)
round(unlist(a$total[c("raw_alpha", "std.alpha", "average_r")]), 3)
round(unlist(a$feldt$lower.ci), 3); round(unlist(a$feldt$upper.ci), 3)

# Krok 4. Analiza pozycji: skorygowana korelacja pozycja–reszta (r.drop) i alfa po usunięciu pozycji
round(data.frame(r_poz_reszta = a$item.stats$r.drop, alfa_po_usunieciu = a$alpha.drop$raw_alpha,
                 zmiana_alfy = a$alpha.drop$raw_alpha - a$total$raw_alpha, row.names = names(poz)), 3)

# Dla porównania: alfa, gdyby zapomnieć o przekodowaniu pozycji 4
round(alpha(dane[, paste0("lek", 1:8)], check.keys = FALSE, warnings = FALSE)$total$raw_alpha, 3)
Wynik w R
        M   SD proc_1 proc_5
lek1 3.11 1.18   8.33  14.58
lek2 3.04 1.14   9.58  10.42
lek3 3.06 1.17  10.42  10.83
lek4 3.13 1.15   7.92  14.17
lek5 3.12 1.18  11.25  12.92
lek6 3.24 1.17   7.92  15.42
lek7 2.98 1.20  12.50  11.67
lek8 3.01 1.13  10.83   9.17
     lek1 lek2 lek3 lek4 lek5 lek6 lek7 lek8
lek1 1.00 0.54 0.57 0.49 0.48 0.48 0.42 0.06
lek2 0.54 1.00 0.49 0.45 0.49 0.49 0.44 0.11
lek3 0.57 0.49 1.00 0.47 0.44 0.42 0.32 0.14
lek4 0.49 0.45 0.47 1.00 0.48 0.34 0.40 0.15
lek5 0.48 0.49 0.44 0.48 1.00 0.37 0.33 0.04
lek6 0.48 0.49 0.42 0.34 0.37 1.00 0.32 0.12
lek7 0.42 0.44 0.32 0.40 0.33 0.32 1.00 0.08
lek8 0.06 0.11 0.14 0.15 0.04 0.12 0.08 1.00
      srednia_r           min_r           max_r srednia_r_bez_8
           0.35            0.04            0.57            0.44
raw_alpha std.alpha average_r
    0.816     0.815     0.355
raw_alpha
    0.778
raw_alpha
    0.849
     r_poz_reszta alfa_po_usunieciu zmiana_alfy
lek1        0.670             0.774      -0.041
lek2        0.659             0.777      -0.039
lek3        0.618             0.782      -0.033
lek4        0.603             0.785      -0.031
lek5        0.570             0.789      -0.026
lek6        0.543             0.793      -0.023
lek7        0.490             0.801      -0.015
lek8        0.138             0.846       0.030
[1] 0.602
2. Czy usunięcie pozycji naprawdę podnosi alfę? Bootstrap i małe próby
R
library(psych)   # alpha()
library(boot)    # boot(), boot.ci(): bootstrap

dane <- read.csv("alfa-cronbacha-dane-przyklad.csv")
poz <- dane[, paste0("lek", 1:8)]
poz$lek4 <- 6 - poz$lek4

# Zmiana alfy po usunięciu każdej pozycji, policzona w 2000 próbach bootstrapowych
alfa_raw <- function(x) { k <- ncol(x); S <- cov(x); k / (k - 1) * (1 - sum(diag(S)) / sum(S)) }
zmiany <- function(d, i) {
  x <- d[i, ]
  a <- alfa_raw(x)
  sapply(seq_len(ncol(x)), function(j) alfa_raw(x[, -j]) - a)
}
set.seed(123)
b <- boot(poz, zmiany, R = 2000)
wynik <- t(sapply(1:8, function(j) {
  ci <- boot.ci(b, index = j, type = "perc")$percent[4:5]
  c(zmiana = b$t0[j], CI_dolna = ci[1], CI_gorna = ci[2], proc_prob_wzrost = 100 * mean(b$t[, j] > 0))
}))
rownames(wynik) <- names(poz)
round(wynik, 3)

# Pozycja 8: alfa siedmiu pozycji i jej przedział ufności
a7 <- alpha(poz[, -8], check.keys = FALSE)
round(c(alfa_7 = a7$total$raw_alpha, CI_dolna = a7$feldt$lower.ci[[1]], CI_gorna = a7$feldt$upper.ci[[1]]), 3)

# Mała próba (np. pilotaż): 2000 losowych podprób po 40 osób z tych samych danych.
# Jak często któraś z „dobrych” pozycji 1–7 wydaje się podnosić alfę po usunięciu?
set.seed(321)
pilot <- t(replicate(2000, {
  x <- poz[sample(nrow(poz), 40), ]
  z <- zmiany(x, seq_len(nrow(x)))
  c(alfa = alfa_raw(x), dobra_podnosi = any(z[1:7] > 0), lek8_podnosi = z[8] > 0)
}))
round(c(alfa_min = min(pilot[, "alfa"]), alfa_Q025 = unname(quantile(pilot[, "alfa"], .025)),
        alfa_Q975 = unname(quantile(pilot[, "alfa"], .975)), alfa_max = max(pilot[, "alfa"]),
        proc_dobra_podnosi = 100 * mean(pilot[, "dobra_podnosi"]), proc_lek8_podnosi = 100 * mean(pilot[, "lek8_podnosi"])), 3)
Wynik w R
     zmiana CI_dolna CI_gorna proc_prob_wzrost
lek1 -0.041   -0.057   -0.030             0.00
lek2 -0.039   -0.052   -0.029             0.00
lek3 -0.033   -0.046   -0.023             0.00
lek4 -0.031   -0.043   -0.021             0.00
lek5 -0.026   -0.038   -0.016             0.00
lek6 -0.023   -0.034   -0.012             0.00
lek7 -0.015   -0.025   -0.004             0.15
lek8  0.030    0.016    0.046           100.00
  alfa_7 CI_dolna CI_gorna
   0.846    0.814    0.874
          alfa_min          alfa_Q025          alfa_Q975           alfa_max
             0.585              0.694              0.879              0.915
proc_dobra_podnosi  proc_lek8_podnosi
            15.600             97.350
3. Tau-równoważność w CFA i omega McDonalda
R
library(lavaan)    # cfa(): model jednoczynnikowy
library(semTools)  # compRelSEM(): omega z modelu CFA
library(boot)      # boot(): przedział bootstrapowy dla omegi

dane <- read.csv("alfa-cronbacha-dane-przyklad.csv")
poz <- dane[, paste0("lek", 1:8)]
poz$lek4 <- 6 - poz$lek4

# Model kongeneryczny: każda pozycja ma własny ładunek
m_kong <- 'lek =~ lek1 + lek2 + lek3 + lek4 + lek5 + lek6 + lek7 + lek8'
# Model tau-równoważny: ten sam (niestandaryzowany) ładunek dla wszystkich pozycji – założenie alfy
m_tau <- 'lek =~ a*lek1 + a*lek2 + a*lek3 + a*lek4 + a*lek5 + a*lek6 + a*lek7 + a*lek8'
f_kong <- cfa(m_kong, data = poz, std.lv = TRUE)
f_tau  <- cfa(m_tau,  data = poz, std.lv = TRUE)

# Ładunki standaryzowane w modelu kongenerycznym
setNames(round(standardizedSolution(f_kong)$est.std[1:8], 2), names(poz))
# Dopasowanie obu modeli i test różnicy chi-kwadrat: czy wolno przyjąć równe ładunki?
round(rbind(kongeneryczny = fitMeasures(f_kong, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")),
            tau_rownowazny = fitMeasures(f_tau, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr"))), 3)
lavTestLRT(f_tau, f_kong)

# Omega całkowita (McDonald) z modelu kongenerycznego – dla 8 i dla 7 pozycji (bez pozycji 8)
f_kong7 <- cfa('lek =~ lek1 + lek2 + lek3 + lek4 + lek5 + lek6 + lek7', data = poz, std.lv = TRUE)
round(c(omega_8 = as.numeric(compRelSEM(f_kong)[[1]]), omega_7 = as.numeric(compRelSEM(f_kong7)[[1]])), 3)

# 95% przedział bootstrapowy (percentylowy) dla omegi z 8 pozycji, 1000 prób
omega_b <- function(d, i) as.numeric(compRelSEM(cfa(m_kong, data = d[i, ], std.lv = TRUE))[[1]])
set.seed(456)
b <- boot(poz, omega_b, R = 1000)
round(boot.ci(b, type = "perc")$percent[4:5], 3)
Wynik w R
lek1 lek2 lek3 lek4 lek5 lek6 lek7 lek8
0.77 0.73 0.69 0.66 0.65 0.61 0.55 0.15
                chisq df pvalue   cfi rmsea  srmr
kongeneryczny  21.199 20  0.386 0.998 0.016 0.029
tau_rownowazny 85.397 27  0.000 0.893 0.095 0.182

Chi-Squared Difference Test

       Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f_kong 20 5505.3 5561.0 21.199
f_tau  27 5555.5 5586.8 85.397     64.199 0.18452       7  2.179e-11 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
omega_8 omega_7
  0.826   0.848
[1] 0.788 0.857
4. Symulacja: alfa i omega przy naruszeniu założeń
R
library(MASS)     # mvrnorm(): losowanie danych z zadanej macierzy kowariancji
library(lavaan)   # cfa(): model jednoczynnikowy do omegi

# Cztery scenariusze, 8 pozycji, 240 osób, 1000 powtórzeń (dane symulowane, ciągłe, wariancja pozycji = 1)
scenariusz <- function(lam1, lam2 = rep(0, 8), phi = 0, kor_bledow = list()) {
  L <- cbind(lam1, lam2); Phi <- matrix(c(1, phi, phi, 1), 2)
  wspolna <- L %*% Phi %*% t(L)
  Theta <- diag(1 - diag(wspolna))
  for (p in kor_bledow) Theta[p[1], p[2]] <- Theta[p[2], p[1]] <- p[3] * sqrt(Theta[p[1], p[1]] * Theta[p[2], p[2]])
  S <- wspolna + Theta
  list(S = S, rzetelnosc = sum(wspolna) / sum(S))   # prawdziwa rzetelność sumy = wariancja wspólna / wariancja całkowita
}
scen <- list(
  "A. tau-równoważny"     = scenariusz(rep(.6, 8)),
  "B. kongeneryczny"      = scenariusz(c(.85, .80, .75, .70, .55, .45, .35, .25)),
  "C. skorelowane błędy"  = scenariusz(rep(.6, 8), kor_bledow = list(c(1, 2, .4), c(3, 4, .4), c(5, 6, .4))),
  "D. dwa czynniki"       = scenariusz(c(rep(.7, 4), rep(0, 4)), c(rep(0, 4), rep(.7, 4)), phi = .3))

alfa_raw <- function(x) { k <- ncol(x); S <- cov(x); k / (k - 1) * (1 - sum(diag(S)) / sum(S)) }
model1 <- paste("f =~", paste0("x", 1:8, collapse = " + "))
omega1 <- function(x) {
  f <- cfa(model1, data = as.data.frame(x), std.lv = TRUE)
  l <- lavInspect(f, "est")$lambda; th <- diag(lavInspect(f, "est")$theta)
  sum(l)^2 / (sum(l)^2 + sum(th))      # omega z modelu jednoczynnikowego bez korelacji błędów
}
set.seed(789)
sym <- do.call(rbind, lapply(names(scen), function(s) {
  wyn <- t(replicate(1000, {
    x <- mvrnorm(240, rep(0, 8), scen[[s]]$S); colnames(x) <- paste0("x", 1:8)
    c(alfa = alfa_raw(x), omega = omega1(x))
  }))
  data.frame(scenariusz = s, rzetelnosc = scen[[s]]$rzetelnosc, wyn)
}))
podsum <- do.call(rbind, lapply(split(sym, sym$scenariusz), function(d)
  c(rzetelnosc = d$rzetelnosc[1], alfa_M = mean(d$alfa), omega_M = mean(d$omega),
    obciazenie_alfy = mean(d$alfa) - d$rzetelnosc[1], obciazenie_omegi = mean(d$omega) - d$rzetelnosc[1])))
round(podsum, 3)
Wynik w R
                     rzetelnosc alfa_M omega_M obciazenie_alfy obciazenie_omegi
A. tau-równoważny         0.818  0.816   0.817          -0.002           -0.001
B. kongeneryczny          0.819  0.802   0.818          -0.016           -0.001
C. skorelowane błędy      0.776  0.834   0.835           0.058            0.059
D. dwa czynniki           0.833  0.766   0.742          -0.067           -0.091
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling [R package]. https://CRAN.R-project.org/package=semTools
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy alfie Cronbacha
- Alfa dla całego kwestionariusza zamiast dla podskal. Wysoka alfa wielowymiarowego kwestionariusza nie dowodzi, że mierzy on jedną cechę, a wynik ogólny może nie mieć sensu.
- Nieprzekodowane pozycje odwrócone. Objaw: ujemne korelacje pozycja–reszta i alfa niższa niż oczekiwana. W przykładzie alfa spadła z .82 do .60.
- „Wysoka alfa, więc skala jest jednowymiarowa”. Alfa nie mówi nic o strukturze (Sijtsma, 2009) – w symulacji skala o dwóch wymiarach miała średnio alfę .77.
- Usuwanie pozycji do skutku. Zwłaszcza w małej próbie kolumna „alfa po usunięciu” myli: w 15.6% pilotaży po 40 osób sugerowała usunięcie dobrej pozycji.
- Alfa bez przedziału ufności albo przepisana z podręcznika testu zamiast policzonej w Twojej próbie.
- Omega jako lekarstwo na wszystko. Omega z niedopasowanego modelu (np. jednoczynnikowego dla skali dwuwymiarowej) myli się tak samo jak alfa albo bardziej.
- Interpretowanie progu .70 jak granicy między „dobrą” a „złą” skalą. Przy krótkich skalach i badaniach grupowych niższa alfa może być do przyjęcia, jeśli ją uczciwie opiszesz.
Jak w praktyce zapisać każdą z tych sytuacji – od podskal, przez niską alfę, po skalę adaptowaną – pokazujemy we wpisie wzór raportowania alfy Cronbacha. Szerszy kontekst adaptacji narzędzi znajdziesz w poradniku adaptacja kulturowa kwestionariusza.
Najczęstsze pytania
Co oznacza alfa Cronbacha równa .80?
Oznacza, że według tego oszacowania około 80% wariancji wyniku skali w Twojej próbie to wariancja wyniku prawdziwego, a około 20% – błąd pomiaru. To dobra wartość do badań grupowych, ale dotyczy tylko tej próby i jest wiarygodna przy spełnionych założeniach (jedna cecha, podobne ładunki, nieskorelowane błędy). Podaj ją z 95% przedziałem ufności.
Czy usunąć pozycję, jeśli alfa po jej usunięciu wzrośnie?
Nie automatycznie. Sprawdź, czy wzrost jest większy niż losowe wahania (np. przedział bootstrapowy), czy próba nie jest mała i czy treść pozycji rzeczywiście nie pasuje do konstruktu. W gotowym, opublikowanym kwestionariuszu zwykle zostaw wszystkie pozycje, a ewentualną zmianę zgłoś i pokaż wyniki dla obu wersji.
Co to jest tau-równoważność w alfie Cronbacha?
To założenie, że wszystkie pozycje są równie silnie związane z mierzoną cechą, czyli mają ten sam niestandaryzowany ładunek czynnikowy. Sprawdzisz je, porównując w CFA model z ładunkami równymi i swobodnymi. Gdy ładunki się różnią (model kongeneryczny), alfa zaniża rzetelność, zwykle nieznacznie – wtedy podaj też omegę McDonalda.
Dlaczego alfa Cronbacha wyszła ujemna albo bardzo niska?
Najczęstsza przyczyna to nieprzekodowane pozycje odwrócone – widać je po ujemnych korelacjach pozycja–reszta. Inne przyczyny to bardzo mała liczba pozycji, pozycje mierzące różne rzeczy, kody braków danych (np. 99) potraktowane jak odpowiedzi albo bardzo jednorodna próba. Ujemna alfa zawsze oznacza błąd w danych albo w modelu pomiaru, a nie „ujemną rzetelność”.
Czy alfa Cronbacha może być za wysoka?
Tak. Wartości powyżej około .95 często oznaczają, że pozycje powtarzają tę samą treść innymi słowami albo mają wspólne źródło błędu, np. bardzo podobne sformułowania. Skala jest wtedy dłuższa, niż trzeba, mierzy wąski fragment konstruktu, a sama alfa może zawyżać rzetelność.
Powiązane hasła
Przeczytaj też
Wynik wygląda podejrzanie
Tabela objaw × przyczyna × test, plik CSV z usterkami, kod R z wynikami przed naprawą i po niej oraz lista kontrolna na 10 minut.
Czytaj →PoradnikWzór raportowania alfy Cronbacha
Gotowe zdania i tabela APA: podskale, niska alfa, pozycje odwrócone, skala adaptowana, porównanie z podręcznikiem – z plikiem .docx.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Skala w Twojej pracy ma niską alfę albo dziwną strukturę?
Sprawdzimy rzetelność i strukturę skali, policzymy alfę i omegę i wyjaśnimy wyniki tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Clark, L. A., & Watson, D. (1995). Constructing validity: Basic issues in objective scale development. Psychological Assessment, 7(3), 309–319. https://doi.org/10.1037/1040-3590.7.3.309
- Cortina, J. M. (1993). What is coefficient alpha? An examination of theory and applications. Journal of Applied Psychology, 78(1), 98–104. https://doi.org/10.1037/0021-9010.78.1.98
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/bf02310555 ● Otwarty dostęp
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Raykov, T. (1997). Estimation of composite reliability for congeneric measures. Applied Psychological Measurement, 21(2), 173–184. https://doi.org/10.1177/01466216970212006
- Raykov, T. (2001). Bias of coefficient α for fixed congeneric measures with correlated errors. Applied Psychological Measurement, 25(1), 69–76. https://doi.org/10.1177/01466216010251005
- Revelle, W., & Condon, D. M. (2019). Reliability from α to ω: A tutorial. Psychological Assessment, 31(12), 1395–1411. https://doi.org/10.1037/pas0000754 ● Otwarty dostęp
- Sijtsma, K. (2009). On the use, the misuse, and the very limited usefulness of Cronbach's alpha. Psychometrika, 74(1), 107–120. https://doi.org/10.1007/s11336-008-9101-0 ● Otwarty dostęp
- Tavakol, M., & Dennick, R. (2011). Making sense of Cronbach's alpha. International Journal of Medical Education, 2, 53–55. https://doi.org/10.5116/ijme.4dfb.8dfd ● Otwarty dostęp
Cytowania BibTeX
@article{clark1995constructing, author={Clark, Lee Anna and Watson, David}, title={{Constructing validity: Basic issues in objective scale development}}, journal={Psychological Assessment}, year={1995}, volume={7}, number={3}, pages={309--319}, doi={10.1037/1040-3590.7.3.309}}@article{cortina1993what, author={Cortina, Jose M.}, title={{What is coefficient alpha? An examination of theory and applications}}, journal={Journal of Applied Psychology}, year={1993}, volume={78}, number={1}, pages={98--104}, doi={10.1037/0021-9010.78.1.98}}@article{cronbach1951coefficient, author={Cronbach, Lee J.}, title={{Coefficient alpha and the internal structure of tests}}, journal={Psychometrika}, year={1951}, volume={16}, number={3}, pages={297--334}, doi={10.1007/bf02310555}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{raykov1997estimation, author={Raykov, Tenko}, title={{Estimation of composite reliability for congeneric measures}}, journal={Applied Psychological Measurement}, year={1997}, volume={21}, number={2}, pages={173--184}, doi={10.1177/01466216970212006}}@article{raykov2001bias, author={Raykov, Tenko}, title={{Bias of coefficient α for fixed congeneric measures with correlated errors}}, journal={Applied Psychological Measurement}, year={2001}, volume={25}, number={1}, pages={69--76}, doi={10.1177/01466216010251005}}@article{revelle2019reliability, author={Revelle, William and Condon, David M.}, title={{Reliability from α to ω: A tutorial}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1395--1411}, doi={10.1037/pas0000754}}@article{sijtsma2009use, author={Sijtsma, Klaas}, title={{On the use, the misuse, and the very limited usefulness of Cronbach's alpha}}, journal={Psychometrika}, year={2009}, volume={74}, number={1}, pages={107--120}, doi={10.1007/s11336-008-9101-0}}@article{tavakol2011making, author={Tavakol, Mohsen and Dennick, Reg}, title={{Making sense of Cronbach's alpha}}, journal={International Journal of Medical Education}, year={2011}, volume={2}, pages={53--55}, doi={10.5116/ijme.4dfb.8dfd}}