EFA i CFA odpowiadają na dwa różne pytania
Analiza czynnikowa zakłada, że odpowiedzi na wiele pozycji kwestionariusza wynikają z kilku nieobserwowalnych cech – zmiennych latentnych. Siłę związku pozycji z czynnikiem opisuje ładunek czynnikowy. Na tym podobieństwa się kończą, bo dwie odmiany tej metody stawiają inne pytania:
- Eksploracyjna analiza czynnikowa (EFA) pyta: ile wymiarów kryje się w tych pozycjach i które pozycje do nich należą? Każda pozycja może ładować każdy czynnik, a strukturę odczytujesz z danych.
- Konfirmacyjna analiza czynnikowa (CFA) pyta: czy dane są zgodne z modelem, który zapisałem z góry? Liczbę czynników i przypisanie pozycji określasz przed analizą, a ładunki „poza swoim czynnikiem” zwykle ustalasz na zero.
Z tej różnicy wynika praktyczna zasada: EFA służy do odkrywania struktury, a CFA do jej sprawdzenia. Jeśli adaptujesz skalę o dobrze udokumentowanej strukturze, zacznij od CFA. Jeśli tworzysz nowe narzędzie albo struktura znanej skali jest niepewna (np. kolejne badania wskazują dwa, trzy albo cztery czynniki), zacznij od EFA, a CFA wykonaj na nowych danych. Fabrigar i in. (1999) pokazali, że każda decyzja w EFA – metoda ekstrakcji, liczba czynników, rotacja – zmienia wynik, a badacze często wybierają rozwiązania wątpliwe. Ten wpis prowadzi przez te decyzje na jednym przykładzie, od surowych odpowiedzi do opisu w stylu APA.
EFA, CFA czy PCA – porównanie
Trzecią metodą, z którą myli się analizę czynnikową, jest analiza głównych składowych (PCA). To technika redukcji danych: składowe są ważonymi sumami pozycji i wyjaśniają całą wariancję, łącznie z błędem pomiaru. Analiza czynnikowa modeluje tylko wariancję wspólną. Widaman (1993) pokazał, że przy czynnikach skorelowanych PCA zawyża ładunki i zaniża korelacje między wymiarami, a różnica maleje dopiero przy wielu pozycjach na czynnik. Jeśli chcesz wnioskować o konstruktach, wybieraj analizę czynnikową, a PCA zostaw do redukcji danych.
| Cecha | EFA | CFA | PCA |
|---|---|---|---|
| Cel | odkryć liczbę i treść wymiarów | sprawdzić model określony z góry | zredukować wiele zmiennych do kilku indeksów |
| Co modeluje | wariancję wspólną | wariancję wspólną | całą wariancję (z błędem) |
| Ładunki krzyżowe | wszystkie szacowane | zwykle ustalone na zero | wszystkie obecne |
| Liczba czynników | decyzja na podstawie danych | założona w modelu | decyzja na podstawie danych |
| Ocena dopasowania | ograniczona (RMSEA, reszty) | test χ², CFI, TLI, RMSEA, SRMR | brak modelu do oceny |
| Typowe pakiety R | psych, GPArotation | lavaan | stats::prcomp, psych::principal |
Przykład: kwestionariusz prokrastynacji akademickiej
Pracujemy na danych symulowanych. 600 studentów odpowiedziało na 12 pozycji kwestionariusza prokrastynacji akademickiej na skali od 1 („zdecydowanie się nie zgadzam”) do 5 („zdecydowanie się zgadzam”). Autorzy narzędzia zakładają trzy wymiary: odkładanie zadań na ostatnią chwilę (pozycje od1–od4), rozpraszanie się podczas nauki (ro1–ro4) i brak planowania (pl1–pl4). W danych ukryliśmy jedną trudność: pozycja ro4 („Gdy mam się uczyć, zaczynam robić coś innego”) w populacji wiąże się nie tylko z rozpraszaniem, ale też z odkładaniem.
Próbę losowo podzieliliśmy na dwie połowy po 300 osób. Na próbie A wykonujemy EFA, na próbie B – CFA. Dzięki temu CFA nie sprawdza modelu na tych samych danych, z których go wyprowadzono. Plik do pobrania: analiza-czynnikowa-efa-cfa-dane.csv (600 wierszy, 12 kolumn, 14 KB). Wszystkie liczby w tekście pochodzą z kodu w sekcji Przykład w R.
Zanim uruchomisz EFA: próba, korelacje i adekwatność danych
Liczebność. Popularne reguły „10 osób na pozycję” czy „co najmniej 200 osób” mają słabe podstawy. MacCallum i in. (1999) pokazali, że potrzebna próba zależy przede wszystkim od wspólności pozycji i od tego, ile pozycji przypada na czynnik. Gdy wspólności są wysokie, a każdy czynnik ma kilka dobrych wskaźników, wystarczy mniejsza próba; przy niskich wspólnościach nawet kilkaset osób może nie wystarczyć. W przykładzie każdy czynnik ma cztery pozycje, a wspólności w EFA wyniosły od .38 do .66, czyli umiarkowanie. Próba 300 osób jest w takich warunkach rozsądna.
Rodzaj korelacji. Odpowiedzi na skali 1–5 to dane porządkowe. Dla takich pozycji lepiej liczyć korelacje polichoryczne niż korelacje Pearsona, zwłaszcza gdy rozkłady są skośne albo kategorii jest niewiele. W przykładzie całą EFA wykonujemy na macierzy polichorycznej.
Adekwatność macierzy. Miara Kaisera–Meyera–Olkina (KMO) i test sferyczności Bartletta sprawdzają, czy korelacje są na tyle silne i wspólne, by szukać w nich czynników. W próbie A KMO = .85, a miary dla poszczególnych pozycji mieściły się w przedziale .79–.90. Test Bartletta był istotny, χ²(66) = 1249.47, p < .001. Pamiętaj, że przy kilkuset osobach test Bartletta jest istotny niemal zawsze, więc sam w sobie niewiele mówi. Ważniejsze jest KMO i przegląd macierzy korelacji – pozycja, która z niczym nie koreluje, nie wejdzie do żadnego czynnika.
Ile czynników? Analiza równoległa, Kaiser, osypisko i MAP
To najważniejsza decyzja w EFA. Zbyt mało czynników skleja różne wymiary, zbyt wiele dzieli jeden wymiar na sztuczne fragmenty. Dlatego porównaj kilka kryteriów i rozwiązania sąsiednie.
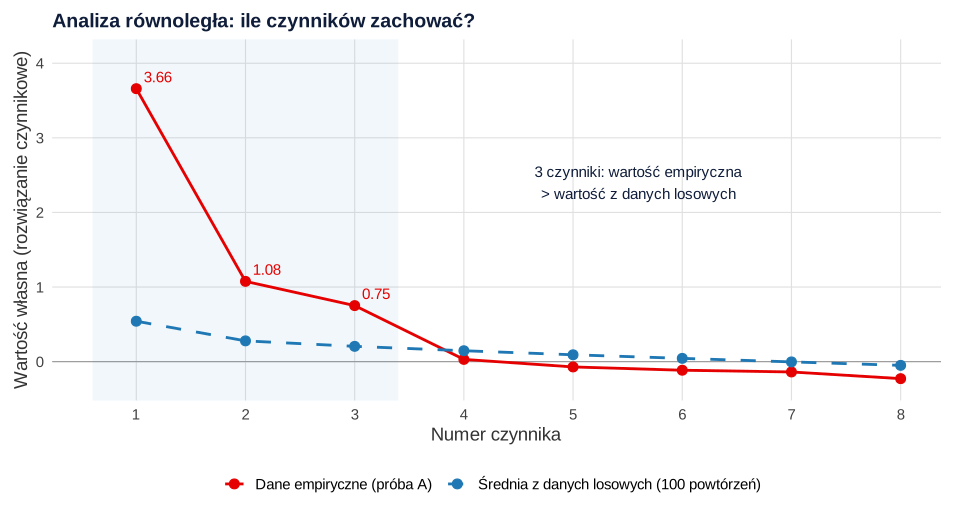
- Analiza równoległa (Horn, 1965) porównuje wartości własne z danych z wartościami własnymi z danych losowych o tej samej liczbie osób i zmiennych. Zachowujesz tyle czynników, ile wartości empirycznych przewyższa wartości losowe. Hayton i in. (2004) zaliczają tę metodę do najtrafniejszych, a zarazem najrzadziej stosowanych. Lim i Jahng (2019) potwierdzili w symulacji, że klasyczna analiza równoległa zwykle działa najlepiej spośród jej wariantów, ale jej trafność spada przy niskich ładunkach i silnie skorelowanych czynnikach. Wynik traktuj więc jako przybliżony i sprawdź też rozwiązanie z jednym czynnikiem mniej i więcej.
- Kryterium Kaisera (wartości własne powyżej 1 w macierzy korelacji) jest domyślne w wielu programach, ale ma słabą opinię, bo zwykle wskazuje zbyt wiele czynników przy dużej liczbie pozycji. Nie opieraj na nim decyzji.
- Wykres osypiska (metoda Cattella) każe szukać „łokcia”, po którym wartości własne opadają łagodnie. Jest subiektywny, ale dobrze uzupełnia analizę równoległą.
- Test MAP Velicera wybiera liczbę czynników, przy której średnia kwadratów korelacji cząstkowych po usunięciu czynników jest najmniejsza.
- Kryterium procentu wyjaśnianej wariancji ma charakter pomocniczy – nie ma uniwersalnego progu.
W przykładzie wszystkie kryteria wskazały trzy czynniki. W analizie równoległej trzy pierwsze wartości własne rozwiązania czynnikowego (3.659, 1.076 i 0.751) przewyższały średnie z danych losowych (0.542, 0.279 i 0.205), a czwarta – już nie (0.030 wobec 0.146). Trzy wartości własne macierzy korelacji przekraczały 1 (4.30, 1.88 i 1.42; czwarta 0.73), a test MAP osiągnął minimum przy trzech czynnikach (.0345 wobec .0406 przy dwóch i .0513 przy czterech). Rysunek 1 pokazuje wynik analizy równoległej.
Zgodność kryteriów to dobry znak, ale nie zwalnia z oceny treści. Dla porównania sprawdziliśmy rozwiązanie dwuczynnikowe. Pozycje odkładania i rozpraszania połączyły się w jeden czynnik, przy czym ładunki pozycji ro1–ro3 spadły do .45–.52. To typowy objaw zbyt małej liczby czynników: dwa różne wymiary zostają sklejone, a część pozycji traci wyraźne miejsce. Trzy czynniki dają strukturę czytelną i zgodną z teorią.
Metoda ekstrakcji i rotacja: oblimin czy varimax?
Ekstrakcja. W EFA najczęściej używa się metody największej wiarygodności (ML), metody osi głównych (PAF) albo metody minimalnych reszt (minres, domyślnej w pakiecie psych). ML pozwala ocenić dopasowanie, ale przy danych porządkowych i słabych pozycjach częściej daje problemy z oszacowaniem, np. przypadek Heywooda. Minres i PAF są odporniejsze. W przykładzie użyliśmy minres na korelacjach polichorycznych.
Rotacja. Rozwiązanie bez rotacji jest trudne do interpretacji, bo pierwszy czynnik „zbiera” jak najwięcej wariancji. Rotacja obraca osie tak, by każda pozycja ładowała przede wszystkim jeden czynnik. Rotacje ortogonalne, z varimax na czele, zakładają, że czynniki są nieskorelowane. Rotacje ukośne (oblimin, promax, geomin) pozwalają czynnikom korelować. W psychologii wymiary jednej cechy niemal zawsze są ze sobą powiązane. Sass i Schmitt (2010) pokazali, że wybór kryterium rotacji może wyraźnie zmienić zarówno ładunki, jak i korelacje czynników. Schmitt (2011) zwraca uwagę, że badacze wciąż sięgają po przestarzałe rozwiązania. Rozsądny punkt wyjścia to rotacja ukośna: jeśli czynniki okażą się nieskorelowane, da ona wynik bardzo zbliżony do ortogonalnej.
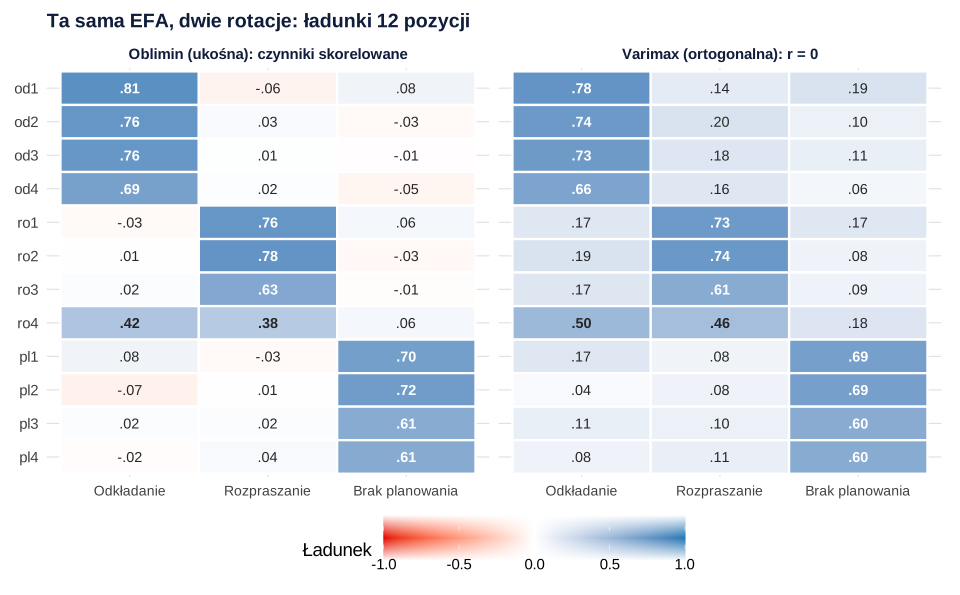
Rysunek 2 pokazuje różnicę na naszych danych. Po rotacji oblimin czynniki korelowały ze sobą: odkładanie z rozpraszaniem r = .48, odkładanie z brakiem planowania r = .33, a rozpraszanie z brakiem planowania r = .30. Varimax wymusza korelacje równe zeru, więc wspólna wariancja czynników „rozlewa się” na ładunki drugorzędne. Pomijając ro4, największy ładunek drugorzędny wyniósł .20 po varimax i tylko .08 po oblimin. Rotacja ortogonalna przy skorelowanych wymiarach daje więc strukturę mniej prostą, a nie bardziej przejrzystą.
Jak czytać wynik EFA: ładunki, wspólności i pozycje problematyczne
Po rotacji ukośnej program podaje dwie macierze. Macierz wzoru (pattern) zawiera ładunki – unikalny wkład czynnika w pozycję przy kontroli pozostałych czynników. Macierz struktury zawiera korelacje pozycji z czynnikami. Do przypisywania pozycji używaj macierzy wzoru, a w raporcie podaj, którą pokazujesz.
W przykładzie ładunki główne (poza pozycją ro4) wyniosły od .61 do .81, a 11 z 12 pozycji ładowało wyraźnie jeden czynnik. Wspólności (h²) mieściły się w przedziale .38–.66, a trzy czynniki wyjaśniały łącznie 51.3% wariancji pozycji. Wyjątkiem była pozycja ro4: ładunek .42 na czynniku odkładania i .38 na czynniku rozpraszania. Co z nią zrobić?
- Przeczytaj jej treść. „Gdy mam się uczyć, zaczynam robić coś innego” opisuje jednocześnie rozproszenie i odkładanie. Ładunek krzyżowy ma więc sens merytoryczny – to nie przypadek próby.
- Rozważ skutki. Pozycja słabo różnicuje wymiary i zawyża ich korelację. Jeśli chcesz otrzymać czyste podskale, możesz ją przeredagować w kolejnej wersji narzędzia albo usunąć. Jeśli pozycja należy do opublikowanej skali, której nie wolno zmieniać, zostaw ją i opisz problem.
- Nie usuwaj pozycji mechanicznie. Progi .30 czy .40 to konwencje, a nie reguły. Każdą decyzję o usunięciu pozycji uzasadnij treścią i zapisz w raporcie. Usunięcie zmienia zakres treściowy pomiaru, czyli trafność teoretyczną narzędzia.
Watkins (2018) prowadzi przez wszystkie decyzje EFA na przykładzie i podkreśla, że raport musi pozwolić czytelnikowi je odtworzyć. Dlatego zapisuj kolejne kroki w skrypcie, a nie klikaj ich w programie bez śladu. Gotowy układ tabeli wyników znajdziesz w haśle tabela analizy czynnikowej w APA.
Jak przejść od EFA do CFA
Przejście od EFA do CFA polega na zamianie wyniku eksploracji w model, który można odrzucić. Trzy zasady:
- Nowe dane. CFA na tej samej próbie, na której wykonano EFA, prawie na pewno „potwierdzi” strukturę, bo model dopasowano do jej przypadkowych cech. Użyj niezależnej próby: podziel dane losowo (jak tutaj) albo zbierz nowe. Jeśli próba jest za mała na podział, wykonaj EFA, a CFA potraktuj jako zadanie dla kolejnego badania.
- Model zapisany przed analizą. Każdą pozycję przypisz do czynnika według EFA i teorii, ładunki krzyżowe ustal na zero, czynnikom pozwól korelować. To model znacznie bardziej rygorystyczny niż EFA, w której wszystkie ładunki krzyżowe są szacowane. Dlatego dopasowanie CFA bywa gorsze, nawet gdy EFA wyglądała dobrze.
- Estymator dopasowany do danych. Pozycje na skali 1–5 to dane porządkowe. Flora i Curran (2004) pokazali w symulacji, że odporna ważona metoda najmniejszych kwadratów na korelacjach polichorycznych dobrze sprawdza się w różnych warunkach, a pełny WLS – tylko w bardzo dużych próbach. W lavaan odpowiada temu estymator WLSMV z argumentem
ordered. Alternatywą przy pięciu kategoriach i w miarę symetrycznych rozkładach jest MLR.
Przygotowaliśmy trzy modele, które porównamy na próbie B: model trójczynnikowy z EFA (ro4 tylko na rozpraszaniu, zgodnie z założeniem autorów), ten sam model z ładunkiem krzyżowym ro4 na odkładaniu oraz model konkurencyjny z dwoma czynnikami, w którym odkładanie i rozpraszanie tworzą jeden wymiar. Porównanie z modelem konkurencyjnym to dobra praktyka – Jackson i in. (2009) zauważyli, że w opublikowanych CFA często proponuje się kilka modeli a priori.
CFA na próbie B: dopasowanie, porównanie modeli i ładunki
| Model | χ² | df | p | CFI | TLI | RMSEA [90% CI] | SRMR |
|---|---|---|---|---|---|---|---|
| Trzy czynniki (model z EFA) | 72.68 | 51 | .025 | .972 | .963 | .042 [.009, .064] | .047 |
| Trzy czynniki + ładunek ro4 na odkładaniu | 45.08 | 50 | .671 | 1.000 | 1.003 | .000 [.000, .042] | .036 |
| Dwa czynniki (odkładanie + rozpraszanie) | 210.53 | 53 | < .001 | .798 | .748 | .109 [.093, .126] | .086 |
Ocena dopasowania. Hu i Bentler (1999) zaproponowali na podstawie symulacji wartości odcięcia bliskie .95 dla CFI i TLI, .06 dla RMSEA i .08 dla SRMR. Marsh i in. (2004) przestrzegają jednak przed traktowaniem tych liczb jak „złotych reguł”: w symulacjach Hu i Bentlera wiele modeli błędnych miało dopasowanie akceptowalne nawet według tych kryteriów. Co więcej, progi wyznaczono dla estymacji ML na danych ciągłych, a nie dla WLSMV. Traktuj je jako orientację i zawsze szukaj miejsc niedopasowania.
Model trójczynnikowy z EFA spełnia orientacyjne progi (CFI = .972, RMSEA = .042, SRMR = .047), ale test χ² jest istotny, χ²(51) = 72.68, p = .025. Model dwuczynnikowy dopasowuje się wyraźnie gorzej: skorygowany test różnicy χ² wyniósł Δχ²(2) = 56.44, p < .001. Trzy wymiary są więc potrzebne.
Gdzie leży niedopasowanie? Największy indeks modyfikacji w modelu trójczynnikowym dotyczył ładunku ro4 na czynniku odkładania (MI = 23.06; oczekiwana standaryzowana wartość .38). To ta sama pozycja, która w EFA na niezależnej próbie A miała ładunek krzyżowy. Zgodność obu prób to ważny argument: zmiana nie jest dopasowaniem do szumu jednej próby. Po dodaniu tego ładunku dopasowanie znacząco się poprawiło, Δχ²(1) = 16.30, p < .001, a ro4 ładowała rozpraszanie (.48) i odkładanie (.30).
Czy wolno dodać ten ładunek? Tylko z jawnym uzasadnieniem. Zmiana jest tu uprawniona, bo wynika z treści pozycji i powtarza się w dwóch niezależnych próbach. Model po modyfikacji jest już jednak częściowo eksploracyjny – opisz go jako taki i sprawdź na nowych danych. Kolejne modyfikacje dodawane tylko dlatego, że poprawiają dopasowanie, prowadzą do modelu dopasowanego do jednej próby.
Ładunki i korelacje. W modelu trójczynnikowym standaryzowane ładunki wyniosły od .57 do .77. Korelacje czynników: odkładanie–rozpraszanie .50, 95% CI [.39, .62], odkładanie–brak planowania .38 [.24, .51], rozpraszanie–brak planowania .24 [.10, .38]. Zwróć uwagę na ro4: w tym modelu miała najwyższy ładunek na rozpraszaniu (.73), bo „pożyczała” wariancję od odkładania. Wysoki ładunek w CFA nie dowodzi, że pozycja mierzy tylko jeden wymiar – dlatego warto patrzeć na indeksy modyfikacji i reszty.
Rzetelność i trafność zbieżna. Z ładunków modelu policzyliśmy omegę: .79 dla odkładania, .77 dla rozpraszania i .72 dla braku planowania. Średnia wariancja wyodrębniona (AVE) wyniosła odpowiednio .49, .46 i .39, czyli poniżej często stosowanego progu .50. To typowy obraz krótkich podskal o umiarkowanych ładunkach: rzetelność sumy pozycji jest akceptowalna, choć pojedyncze pozycje zawierają sporo wariancji swoistej. Jak raportować omegę obok alfy, opisujemy we wpisie o alfie Cronbacha i rzetelności skali.
WLSMV a MLR. Dla porównania ten sam model oszacowaliśmy MLR, traktując odpowiedzi jak dane ciągłe: CFI = .976, RMSEA = .035, SRMR = .044, ładunki .56–.72. Ocena modelu była podobna, ale ładunki – niższe niż w WLSMV (.57–.77), bo WLSMV opisuje związki z ciągłymi zmiennymi ukrytymi „pod” odpowiedziami porządkowymi. Wybierz estymator przed analizą i podaj go w raporcie – wyników obu nie mieszaj w jednej tabeli.
Jak opisać EFA i CFA w artykule (APA)
Raport EFA powinien pozwolić czytelnikowi odtworzyć każdą decyzję: rodzaj korelacji, metodę ekstrakcji, kryteria liczby czynników, rotację, tabelę ładunków ze wspólnościami i korelacje czynników. Raport CFA – model, estymator, wskaźniki dopasowania z przedziałem dla RMSEA, porównanie modeli, modyfikacje z uzasadnieniem i ładunki standaryzowane. Układ tabeli dopasowania pokazuje hasło tabela dopasowania modelu CFA w APA.
Jeśli Twoja skala ma porównywać grupy (np. kobiety i mężczyzn albo wersje językowe), kolejnym krokiem jest inwariancja pomiaru – procedurę opisujemy we wpisie inwariancja pomiaru krok po kroku. Całą ścieżkę tworzenia narzędzia, od pozycji do walidacji, omawia poradnik jak zbudować i zwalidować skalę psychometryczną, a model pomiarowy jako część pełnego modelu strukturalnego – wpis CB-SEM w R z pakietem lavaan.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Możesz pominąć przepis 0 i od razu pobrać plik analiza-czynnikowa-efa-cfa-dane.csv – zapisz go w katalogu roboczym R. Przepisy 1 i 2 dzielą próbę tym samym ziarnem losowania, więc można je uruchamiać niezależnie. Analiza równoległa na korelacjach polichorycznych trwa kilkadziesiąt sekund.
0. Symulacja danych
R
# Analiza czynnikowa EFA i CFA – przepis 0: symulacja danych (plik analiza-czynnikowa-efa-cfa-dane.csv)
# Dane symulowane: 600 studentów wypełniło 12-pozycyjny kwestionariusz prokrastynacji akademickiej (skala 1–5).
# Model populacyjny: trzy skorelowane czynniki – Odkładanie (od1–od4), Rozpraszanie (ro1–ro4),
# Brak planowania (pl1–pl4); pozycja ro4 ładuje też czynnik Odkładanie (ładunek krzyżowy).
library(MASS)   # mvrnorm()
set.seed(2016)
N <- 600
L <- matrix(0, 12, 3, dimnames = list(c(paste0("od", 1:4), paste0("ro", 1:4), paste0("pl", 1:4)),
                                      c("Odkladanie", "Rozpraszanie", "Planowanie")))
L[1:4, 1]   <- c(.78, .72, .70, .62)
L[5:8, 2]   <- c(.74, .70, .66, .45)
L[8, 1]     <- .35                      # ro4: ładunek krzyżowy
L[9:12, 3]  <- c(.72, .68, .64, .58)
Phi <- matrix(c(1, .50, .40,
                .50, 1, .30,
                .40, .30, 1), 3)
Sigma <- L %*% Phi %*% t(L); diag(Sigma) <- 1
ciagle <- mvrnorm(N, rep(0, 12), Sigma)
progi <- c(-Inf, -1.3, -0.4, 0.5, 1.4, Inf)          # odpowiedzi 1–5
dane <- as.data.frame(apply(ciagle, 2, function(x) as.integer(cut(x, progi))))
colnames(dane) <- rownames(L)
write.csv(dane, "analiza-czynnikowa-efa-cfa-dane.csv", row.names = FALSE)

table(unlist(dane))   # rozkład odpowiedzi 1–5 we wszystkich pozycjach
Wynik w R
   1    2    3    4    5
 703 1824 2491 1586  596
1. EFA: adekwatność danych, liczba czynników i rotacje
R
# Analiza czynnikowa EFA i CFA – przepis 1: eksploracyjna analiza czynnikowa (EFA) na próbie A
suppressPackageStartupMessages({library(psych); library(GPArotation)})
dane <- read.csv("analiza-czynnikowa-efa-cfa-dane.csv")   # 600 osób, pozycje od1–pl4 (1–5)

# Losowy podział na dwie połowy: EFA na próbie A, CFA na niezależnej próbie B
set.seed(13)
idx <- sample(nrow(dane)); A <- dane[idx[1:300], ]; B <- dane[idx[301:600], ]
cat("Próba A:", nrow(A), " Próba B:", nrow(B), "\n")
round(sapply(A, function(x) c(M = mean(x), SD = sd(x))), 2)

# Czy macierz nadaje się do analizy czynnikowej?
R_A <- polychoric(A)$rho                # 5 kategorii – korelacje polichoryczne
KMO(R_A)$MSA |> round(2)
range(KMO(R_A)$MSAi) |> round(2)
cortest.bartlett(R_A, n = nrow(A))

# Liczba czynników: analiza równoległa, kryterium Kaisera, MAP Velicera
options(mc.cores = 1)   # obliczenia sekwencyjne – powtarzalny wynik analizy równoległej
set.seed(7)
pa <- fa.parallel(A, cor = "poly", fm = "minres", fa = "fa", n.iter = 100, plot = FALSE)
round(cbind(empiryczne = pa$fa.values[1:6], losowe = pa$fa.sim[1:6]), 3)
cat("Analiza równoległa sugeruje czynników:", pa$nfact, "\n")
ev_pca <- eigen(R_A)$values
cat("Wartości własne macierzy korelacji (PCA):", round(ev_pca[1:5], 2), "\n")
cat("Kryterium Kaisera (> 1):", sum(ev_pca > 1), "\n")
v <- vss(R_A, n = 5, fm = "minres", n.obs = nrow(A), plot = FALSE)
cat("MAP Velicera – minimum przy liczbie czynników:", which.min(v$map), "\n")
round(v$map, 4)

# EFA: 3 czynniki, minres, rotacja ukośna (oblimin) i dla porównania ortogonalna (varimax)
efa_obl <- fa(R_A, nfactors = 3, n.obs = nrow(A), fm = "minres", rotate = "oblimin")
efa_var <- fa(R_A, nfactors = 3, n.obs = nrow(A), fm = "minres", rotate = "varimax")
print(efa_obl$loadings, cutoff = 0, digits = 2)
cat("Korelacje czynników (oblimin):\n"); print(round(efa_obl$Phi, 2))
cat("Wspólności h2:\n"); print(round(efa_obl$communality, 2))
cat("Wyjaśniona wariancja (łącznie):", round(sum(efa_obl$Vaccounted["Proportion Var", ]), 3), "\n")
print(efa_var$loadings, cutoff = 0, digits = 2)
# Porównanie rotacji: największy ładunek drugorzędny (bez pozycji ro4)
drugi <- function(Lm) max(apply(abs(unclass(Lm))[rownames(Lm) != "ro4", ], 1, function(x) sort(x, TRUE)[2]))
round(c(oblimin = drugi(efa_obl$loadings), varimax = drugi(efa_var$loadings)), 2)
# Dla porównania: rozwiązanie 2-czynnikowe
efa2 <- fa(R_A, nfactors = 2, n.obs = nrow(A), fm = "minres", rotate = "oblimin")
print(efa2$loadings, cutoff = 0, digits = 2)
Wynik w R
Próba A: 300  Próba B: 300
    od1  od2 od3  od4  ro1  ro2  ro3  ro4  pl1  pl2  pl3  pl4
M  2.87 2.86 3.0 2.84 3.00 2.93 2.98 2.93 2.91 2.95 3.04 3.01
SD 1.13 1.10 1.1 1.11 1.11 1.15 1.11 1.17 1.08 1.10 1.05 1.08
[1] 0.85
[1] 0.79 0.90
$chisq
[1] 1249.47

$p.value
[1] 5.570766e-218

$df
[1] 66

Parallel analysis suggests that the number of factors =  3  and the number of components =  NA
Warning messages:
1: In fac(r = r, nfactors = nfactors, n.obs = n.obs, rotate = rotate,  :
  An ultra-Heywood case was detected.  Examine the results carefully
2: In fac(r = r, nfactors = nfactors, n.obs = n.obs, rotate = rotate,  :
  An ultra-Heywood case was detected.  Examine the results carefully
     empiryczne losowe
[1,]      3.659  0.542
[2,]      1.076  0.279
[3,]      0.751  0.205
[4,]      0.030  0.146
[5,]     -0.071  0.092
[6,]     -0.115  0.044
Analiza równoległa sugeruje czynników: 3
Wartości własne macierzy korelacji (PCA): 4.3 1.88 1.42 0.73 0.6
Kryterium Kaisera (> 1): 3
MAP Velicera – minimum przy liczbie czynników: 3
[1] 0.0472 0.0406 0.0345 0.0513 0.0721

Loadings:
    MR2   MR3   MR1
od1  0.81 -0.06  0.08
od2  0.76  0.03 -0.03
od3  0.76  0.01 -0.01
od4  0.69  0.02 -0.05
ro1 -0.03  0.76  0.06
ro2  0.01  0.78 -0.03
ro3  0.02  0.63 -0.01
ro4  0.42  0.38  0.06
pl1  0.08 -0.03  0.70
pl2 -0.07  0.01  0.72
pl3  0.02  0.02  0.61
pl4 -0.02  0.04  0.61

                MR2  MR3  MR1
SS loadings    2.48 1.74 1.76
Proportion Var 0.21 0.14 0.15
Cumulative Var 0.21 0.35 0.50
Korelacje czynników (oblimin):
     MR2  MR3  MR1
MR2 1.00 0.48 0.33
MR3 0.48 1.00 0.30
MR1 0.33 0.30 1.00
Wspólności h2:
 od1  od2  od3  od4  ro1  ro2  ro3  ro4  pl1  pl2  pl3  pl4
0.66 0.59 0.58 0.47 0.59 0.60 0.41 0.50 0.51 0.49 0.38 0.39
Wyjaśniona wariancja (łącznie): 0.513

Loadings:
    MR1  MR2  MR3
od1 0.78 0.19 0.14
od2 0.74 0.10 0.20
od3 0.73 0.11 0.18
od4 0.66 0.06 0.16
ro1 0.17 0.17 0.73
ro2 0.19 0.08 0.74
ro3 0.17 0.09 0.61
ro4 0.50 0.18 0.46
pl1 0.17 0.69 0.08
pl2 0.04 0.69 0.08
pl3 0.11 0.60 0.10
pl4 0.08 0.60 0.11

                MR1  MR2  MR3
SS loadings    2.51 1.82 1.82
Proportion Var 0.21 0.15 0.15
Cumulative Var 0.21 0.36 0.51
oblimin varimax
   0.08    0.20

Loadings:
    MR2   MR1
od1  0.71  0.04
od2  0.75 -0.06
od3  0.72 -0.04
od4  0.67 -0.08
ro1  0.48  0.14
ro2  0.52  0.07
ro3  0.45  0.07
ro4  0.68  0.08
pl1  0.06  0.68
pl2 -0.06  0.72
pl3  0.03  0.60
pl4  0.01  0.62

                MR2  MR1
SS loadings    3.21 1.77
Proportion Var 0.27 0.15
Cumulative Var 0.27 0.42
2. CFA w lavaan: trzy modele, porównanie i rzetelność
R
# Analiza czynnikowa EFA i CFA – przepis 2: konfirmacyjna analiza czynnikowa (CFA) na niezależnej próbie B
suppressPackageStartupMessages(library(lavaan))
dane <- read.csv("analiza-czynnikowa-efa-cfa-dane.csv")
set.seed(13)
idx <- sample(nrow(dane)); B <- dane[idx[301:600], ]      # ten sam podział co w przepisie 1
pozycje <- names(B)

m3 <- '
  Odkladanie   =~ od1 + od2 + od3 + od4
  Rozpraszanie =~ ro1 + ro2 + ro3 + ro4
  Planowanie   =~ pl1 + pl2 + pl3 + pl4
'
m3_krzyz <- paste(m3, "  Odkladanie =~ ro4\n")
m2 <- '
  Prokrastynacja =~ od1 + od2 + od3 + od4 + ro1 + ro2 + ro3 + ro4
  Planowanie     =~ pl1 + pl2 + pl3 + pl4
'
dopas <- function(f) round(fitMeasures(f, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
                                            "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")), 3)
f3  <- cfa(m3,       data = B, ordered = pozycje, estimator = "WLSMV")
f3k <- cfa(m3_krzyz, data = B, ordered = pozycje, estimator = "WLSMV")
f2  <- cfa(m2,       data = B, ordered = pozycje, estimator = "WLSMV")
rbind(trzy_czynniki = dopas(f3), trzy_z_ro4_krzyz = dopas(f3k), dwa_czynniki = dopas(f2))

# Porównanie modeli zagnieżdżonych (skorygowany test różnicy chi-kwadrat dla WLSMV)
lavTestLRT(f3, f2)
lavTestLRT(f3k, f3)

# Ładunki standaryzowane i korelacje czynników w modelu 3-czynnikowym
s <- standardizedSolution(f3)
lad <- s[s$op == "=~", c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
lad[, 3:5] <- round(lad[, 3:5], 2); lad
kor <- s[s$op == "~~" & s$lhs != s$rhs & s$lhs %in% c("Odkladanie", "Rozpraszanie", "Planowanie"),
         c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
kor[, 3:5] <- round(kor[, 3:5], 2); kor

# Model z ładunkiem krzyżowym ro4: oba ładunki
s2 <- standardizedSolution(f3k); round(s2[s2$rhs == "ro4" & s2$op == "=~", c("est.std", "pvalue")], 3)

# Największe indeksy modyfikacji modelu 3-czynnikowego
mi <- modindices(f3, sort. = TRUE); mi[1:3, c("lhs", "op", "rhs", "mi", "sepc.all")]

# Rzetelność omega i AVE z ładunków standaryzowanych (skala zmiennych ukrytych odpowiedzi)
l_std <- s[s$op == "=~", ]
rz <- t(sapply(split(l_std$est.std, l_std$lhs), function(l)
  c(omega = sum(l)^2 / (sum(l)^2 + sum(1 - l^2)), AVE = mean(l^2))))
round(rz, 2)

# Dla porównania: estymacja MLR na tych samych danych traktowanych jako ciągłe
f3_mlr <- cfa(m3, data = B, estimator = "MLR")
round(fitMeasures(f3_mlr, c("chisq.scaled", "df", "cfi.robust", "tli.robust", "rmsea.robust", "srmr")), 3)
sm <- standardizedSolution(f3_mlr); round(range(sm$est.std[sm$op == "=~"]), 2)
round(range(lad$est.std), 2)
Wynik w R
                 chisq.scaled df.scaled pvalue.scaled cfi.robust tli.robust
trzy_czynniki          72.680        51         0.025      0.972      0.963
trzy_z_ro4_krzyz       45.075        50         0.671      1.000      1.003
dwa_czynniki          210.534        53         0.000      0.798      0.748
                 rmsea.robust rmsea.ci.lower.robust rmsea.ci.upper.robust  srmr
trzy_czynniki           0.042                 0.009                 0.064 0.047
trzy_z_ro4_krzyz        0.000                 0.000                 0.042 0.036
dwa_czynniki            0.109                 0.093                 0.126 0.086

Scaled and Shifted Chi-Squared Difference Test (method = “satorra.2000”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

   Df AIC BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f3 51          51.569
f2 53         182.393     56.439 0.46336       2   5.55e-13 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Scaled and Shifted Chi-Squared Difference Test (method = “satorra.2000”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

    Df AIC BIC  Chisq Chisq diff  RMSEA Df diff Pr(>Chisq)
f3k 50         28.456
f3  51         51.569     16.296 0.2715       1  5.419e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            lhs rhs est.std ci.lower ci.upper
1    Odkladanie od1    0.77     0.68     0.85
2    Odkladanie od2    0.70     0.60     0.79
3    Odkladanie od3    0.69     0.61     0.78
4    Odkladanie od4    0.65     0.55     0.74
5  Rozpraszanie ro1    0.72     0.63     0.82
6  Rozpraszanie ro2    0.59     0.49     0.70
7  Rozpraszanie ro3    0.64     0.53     0.74
8  Rozpraszanie ro4    0.73     0.65     0.82
9    Planowanie pl1    0.67     0.56     0.78
10   Planowanie pl2    0.65     0.54     0.76
11   Planowanie pl3    0.63     0.51     0.75
12   Planowanie pl4    0.57     0.45     0.68
            lhs          rhs est.std ci.lower ci.upper
76   Odkladanie Rozpraszanie    0.50     0.39     0.62
77   Odkladanie   Planowanie    0.38     0.24     0.51
78 Rozpraszanie   Planowanie    0.24     0.10     0.38
   est.std pvalue
8    0.481      0
13   0.300      0
           lhs op rhs     mi sepc.all
109 Odkladanie =~ ro4 23.058    0.376
168        ro1 ~~ ro2 10.460    0.400
136        od1 ~~ ro4 10.347    0.439
             omega  AVE
Odkladanie    0.79 0.49
Planowanie    0.72 0.39
Rozpraszanie  0.77 0.46
chisq.scaled           df   cfi.robust   tli.robust rmsea.robust         srmr
      69.897       51.000        0.976        0.969        0.035        0.044
[1] 0.56 0.72
[1] 0.57 0.77
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie czynnikowej
- PCA nazwana analizą czynnikową. Domyślne ustawienia części programów to analiza głównych składowych z rotacją varimax. Jeśli pytasz o konstrukty, wybierz analizę czynnikową i napisz, którą metodę ekstrakcji zastosowano.
- Liczba czynników tylko według kryterium Kaisera. Podaj analizę równoległą i co najmniej jedno kryterium dodatkowe oraz sprawdź rozwiązania sąsiednie.
- Varimax „bo tak się robi”. Gdy wymiary jednej cechy są skorelowane, rotacja ortogonalna rozmywa strukturę. Zacznij od rotacji ukośnej i podaj korelacje czynników.
- EFA i CFA na tych samych danych. Taka CFA niczego nie potwierdza. Podziel próbę albo zbierz nowe dane.
- Usuwanie pozycji wyłącznie według progu ładunku. Każda decyzja wymaga uzasadnienia treściowego i zmienia zakres pomiaru.
- Dopisywanie kowariancji błędów i ładunków krzyżowych aż do „dobrego dopasowania”. Modyfikacja musi mieć sens merytoryczny, a model po zmianach trzeba sprawdzić na nowych danych.
- Progi CFI i RMSEA jako test zaliczony–niezaliczony. Raportuj χ², kilka wskaźników z przedziałem dla RMSEA i wskaż miejsca niedopasowania (Marsh i in., 2004).
- Pozycje porządkowe analizowane jak ciągłe bez komentarza. Przy skali 1–5 rozważ korelacje polichoryczne i WLSMV, a wybór estymatora uzasadnij.
- Brak tabeli ładunków. Bez pełnej macierzy wzoru, wspólności i korelacji czynników recenzent nie oceni struktury.
Analizę czynnikową często poprzedza przygotowanie wersji językowej narzędzia – kroki opisujemy w poradniku adaptacja kulturowa kwestionariusza. Jeśli przygotowujesz artykuł walidacyjny i chcesz, żeby ktoś zaplanował i wykonał EFA oraz CFA albo sprawdził Twoje analizy przed recenzją, zajrzyj do oferty analiz statystycznych dla badaczy.
Najczęstsze pytania
Czy można zrobić EFA i CFA na tej samej próbie?
Technicznie tak, ale taka CFA niczego nie potwierdza, bo sprawdza model wyprowadzony z tych samych danych. Podziel próbę losowo na dwie części (EFA na jednej, CFA na drugiej) albo zbierz nowe dane. Jeśli próba jest za mała na podział, zaraportuj EFA i zaplanuj CFA w kolejnym badaniu.
Kiedy od razu CFA, a kiedy najpierw EFA?
CFA wybierz, gdy struktura narzędzia jest dobrze udokumentowana, np. adaptujesz skalę z kilkoma replikowanymi badaniami walidacyjnymi. EFA jest potrzebna, gdy tworzysz nowe narzędzie albo wcześniejsze badania wskazują różną liczbę czynników. Wynik EFA zawsze sprawdź później w CFA na nowych danych.
Rotacja oblimin czy varimax w analizie czynnikowej?
Jeśli wymiary mogą być ze sobą powiązane – a w psychologii prawie zawsze są – wybierz rotację ukośną, np. oblimin, i podaj korelacje czynników. Varimax wymusza czynniki nieskorelowane, przez co wspólna wariancja przenosi się na ładunki drugorzędne. Gdy czynniki naprawdę nie korelują, obie rotacje dają niemal ten sam wynik.
Jak ustalić liczbę czynników w eksploracyjnej analizie czynnikowej?
Podstawą jest analiza równoległa: zachowaj tyle czynników, ile wartości własnych z danych przewyższa wartości z danych losowych. Uzupełnij ją testem MAP lub wykresem osypiska, porównaj rozwiązania z jednym czynnikiem mniej i więcej, a ostatecznie wybierz to, które jest interpretowalne merytorycznie. Samo kryterium Kaisera (wartości własne powyżej 1) zwykle zawyża liczbę czynników.
Jaki estymator w CFA dla pozycji na skali Likerta?
Dla pozycji porządkowych zalecany jest WLSMV na korelacjach polichorycznych (w lavaan argument ordered). Przy pięciu lub więcej kategoriach i w miarę symetrycznych rozkładach rozsądną alternatywą jest odporna metoda największej wiarygodności (MLR). Estymator wybierz przed analizą i podaj go w raporcie, bo wpływa na ładunki i wskaźniki dopasowania.
Powiązane hasła
Przeczytaj też
Konfirmacyjna analiza czynnikowa (CFA) w jamovi
Okno Confirmatory Factor Analysis na skali z dwoma czynnikami: kowariancja reszt z uzasadnieniem, ładunki standaryzowane, χ² i wskaźniki dopasowania, indeksy modyfikacji, omega z modelu – z kodem jmv.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Walidujesz kwestionariusz do artykułu?
Zaplanujemy i wykonamy EFA oraz CFA na Twoich danych, dobierzemy estymator do skali odpowiedzi i wyjaśnimy decyzje tak, by obroniły się w recenzji.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466 ● Otwarty dostęp: pełny tekst
- Hayton, J. C., Allen, D. G., & Scarpello, V. (2004). Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis. Organizational Research Methods, 7(2), 191–205. https://doi.org/10.1177/1094428104263675 ● Otwarty dostęp: pełny tekst
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Jackson, D. L., Gillaspy, J. A., & Purc-Stephenson, R. (2009). Reporting practices in confirmatory factor analysis: An overview and some recommendations. Psychological Methods, 14(1), 6–23. https://doi.org/10.1037/a0014694
- Lim, S., & Jahng, S. (2019). Determining the number of factors using parallel analysis and its recent variants. Psychological Methods, 24(4), 452–467. https://doi.org/10.1037/met0000230
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84–99. https://doi.org/10.1037/1082-989x.4.1.84
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- Sass, D. A., & Schmitt, T. A. (2010). A comparative investigation of rotation criteria within exploratory factor analysis. Multivariate Behavioral Research, 45(1), 73–103. https://doi.org/10.1080/00273170903504810
- Schmitt, T. A. (2011). Current methodological considerations in exploratory and confirmatory factor analysis. Journal of Psychoeducational Assessment, 29(4), 304–321. https://doi.org/10.1177/0734282911406653
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219–246. https://doi.org/10.1177/0095798418771807 ● Otwarty dostęp
- Widaman, K. F. (1993). Common factor analysis versus principal component analysis: Differential bias in representing model parameters? Multivariate Behavioral Research, 28(3), 263–311. https://doi.org/10.1207/s15327906mbr2803_1
Cytowania BibTeX
@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{flora2004empirical, author={Flora, David B. and Curran, Patrick J.}, title={{An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data}}, journal={Psychological Methods}, year={2004}, volume={9}, number={4}, pages={466--491}, doi={10.1037/1082-989x.9.4.466}}@article{hayton2004factor, author={Hayton, James C. and Allen, David G. and Scarpello, Vida}, title={{Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={2}, pages={191--205}, doi={10.1177/1094428104263675}}@article{horn1965rationale, author={Horn, John L.}, title={{A rationale and test for the number of factors in factor analysis}}, journal={Psychometrika}, year={1965}, volume={30}, number={2}, pages={179--185}, doi={10.1007/bf02289447}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{jackson2009reporting, author={Jackson, Dennis L. and Gillaspy, J. Arthur and Purc-Stephenson, Rebecca}, title={{Reporting practices in confirmatory factor analysis: An overview and some recommendations}}, journal={Psychological Methods}, year={2009}, volume={14}, number={1}, pages={6--23}, doi={10.1037/a0014694}}@article{lim2019determining, author={Lim, Sangdon and Jahng, Seungmin}, title={{Determining the number of factors using parallel analysis and its recent variants}}, journal={Psychological Methods}, year={2019}, volume={24}, number={4}, pages={452--467}, doi={10.1037/met0000230}}@article{maccallum1999sample, author={MacCallum, Robert C. and Widaman, Keith F. and Zhang, Shaobo and Hong, Sehee}, title={{Sample size in factor analysis}}, journal={Psychological Methods}, year={1999}, volume={4}, number={1}, pages={84--99}, doi={10.1037/1082-989x.4.1.84}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{sass2010comparative, author={Sass, Daniel A. and Schmitt, Thomas A.}, title={{A comparative investigation of rotation criteria within exploratory factor analysis}}, journal={Multivariate Behavioral Research}, year={2010}, volume={45}, number={1}, pages={73--103}, doi={10.1080/00273170903504810}}@article{schmitt2011current, author={Schmitt, Thomas A.}, title={{Current methodological considerations in exploratory and confirmatory factor analysis}}, journal={Journal of Psychoeducational Assessment}, year={2011}, volume={29}, number={4}, pages={304--321}, doi={10.1177/0734282911406653}}@article{watkins2018exploratory, author={Watkins, Marley W.}, title={{Exploratory factor analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2018}, volume={44}, number={3}, pages={219--246}, doi={10.1177/0095798418771807}}@article{widaman1993common, author={Widaman, Keith F.}, title={{Common factor analysis versus principal component analysis: Differential bias in representing model parameters?}}, journal={Multivariate Behavioral Research}, year={1993}, volume={28}, number={3}, pages={263--311}, doi={10.1207/s15327906mbr2803_1}}