Co musi zawierać opis rzetelności skali
Ten wpis to zbiór gotowych zapisów. Teorię – czym jest alfa, jakie ma założenia i kiedy zawodzi – omawiamy we wpisie alfa Cronbacha: jak ocenić rzetelność skali. Tu zakładamy, że alfę już policzyłeś, i pokazujemy, jak ją zapisać w siedmiu typowych sytuacjach: od jednej skali, przez podskale i niską alfę, po skalę zaadaptowaną i porównanie z podręcznikiem testu.
Niezależnie od sytuacji dobry opis spójności wewnętrznej zawiera sześć elementów:
- nazwę współczynnika – alfa Cronbacha, omega McDonalda, KR-20;
- wartość policzoną w Twojej próbie, a nie przepisaną z artykułu o skali;
- 95% przedział ufności – Kelley i Pornprasertmanit (2016) przypominają, że samo oszacowanie punktowe nie mówi nic o niepewności, a przedział tak;
- liczbę pozycji i liczebność próby, z której liczono współczynnik (gdy były braki danych – liczbę osób z kompletem odpowiedzi);
- informację o pozycjach odwróconych i usuniętych;
- wartość dla każdej podskali osobno, gdy narzędzie ma kilka wymiarów.
Flake i in. (2017) przejrzeli reprezentatywną próbę artykułów z Journal of Personality and Social Psychology i stwierdzili, że przy skalach istniejących i tworzonych przez autorów brakowało dowodów trafności, a alfa była często jedynym raportowanym wskaźnikiem psychometrycznym. Dlatego obok alfy warto choć jednym zdaniem odnieść się do trafności – np. struktury czynnikowej albo związków z innymi zmiennymi. Co powinno się znaleźć w każdej części artykułu, w tym w opisie metody, zbierają standardy JARS (Appelbaum i in., 2018; American Psychological Association, b.d.).
Gdzie to napisać? W pracy dyplomowej rzetelność opisuje się zwykle w rozdziale metodologicznym, w podrozdziale o narzędziach. Tam podaj wartości z oryginalnej publikacji i z Twojej próby. Gdy skal jest kilka, zestaw je w tabeli i odwołaj się do niej w tekście. Ogólny układ rozdziału pokazujemy w poradniku rozdział metodologiczny pracy magisterskiej.
Przykłady poniżej opierają się na jednym zbiorze danych (dane symulowane): 212 osób wypełniło Kwestionariusz Stylów Radzenia Sobie (KSR). To narzędzie wymyślone na potrzeby poradnika – ma 16 pozycji ze skalą odpowiedzi 1–5 i trzy podskale: zadaniową (6 pozycji), emocjonalną (6 pozycji, w tym dwie odwrócone) i unikową (4 pozycje). Wartości „z podręcznika” też są przykładowe. Dane: wzor-raportowania-alfa-dane-przyklad.csv.
Sytuacja 1: jedna skala w rozdziale metodologicznym
Najprostszy przypadek: używasz gotowej, jednowymiarowej skali. Opisz ją (autor, liczba pozycji, skala odpowiedzi, sposób liczenia wyniku), podaj rzetelność z publikacji źródłowej i rzetelność w Twojej próbie.
Kilka uwag do zapisu. α piszesz bez zera wiodącego (współczynnik nie przekracza 1), z kropką dziesiętną i dwoma miejscami po kropce. Słowo oceny („dobra”, „zadowalająca”) dodaj tylko wtedy, gdy wiesz, na jakim kryterium je opierasz. Przedział ufności to w R wynik funkcji psych::alpha() (metoda Feldta), a w kodzie na dole strony znajdziesz też wersję bootstrapową. Jeśli program nie podaje przedziału, napisz o tym wprost, zamiast go pomijać bez słowa.
Sytuacja 2: kwestionariusz z podskalami – tabela i opis
Gdy narzędzie ma kilka podskal, rzetelność podajesz osobno dla każdej z nich. Alfa dla wszystkich 16 pozycji naraz nie ma sensu, jeśli wynik ogólny nie jest interpretowany. Przy trzech lub więcej skalach najczytelniejsza jest tabela – dodatkowe warianty znajdziesz w haśle tabela rzetelności w APA.
Tabela 1
Statystyki opisowe i rzetelność podskal Kwestionariusza Stylów Radzenia Sobie (N = 212)
| Podskala | k | M | SD | α [95% CI] | ω | Średnie r |
|---|---|---|---|---|---|---|
| Zadaniowy | 6 | 2.91 | 0.85 | .86 [.83, .89] | .86 | .51 |
| Emocjonalny | 6 | 3.05 | 0.70 | .75 [.70, .80] | .76 | .34 |
| Unikowy | 4 | 3.01 | 0.67 | .52 [.41, .62] | .54 | .22 |
Uwaga. k – liczba pozycji; M i SD – średnia i odchylenie standardowe wyniku podskali (średnia odpowiedzi, skala 1–5); α – alfa Cronbacha z 95% przedziałem ufności (metoda Feldta); ω – omega całkowita McDonalda z jednoczynnikowego modelu CFA; średnie r – średnia korelacja między pozycjami. Pozycje e2 i e5 przekodowano przed analizą.
Plik wzor-tabeli-rzetelnosci-apa.docx (15 KB) zawiera tę tabelę w formacie Word z czcionką Times New Roman, poziomymi liniami APA i notą – wystarczy podmienić wartości. Kolumnę ω dodaj, jeśli liczyłeś omegę (zob. sytuacja 5). Kolumnę ze średnią korelacją między pozycjami warto zostawić, gdy któraś podskala jest krótka: przy 4 pozycjach nawet przyzwoite korelacje dają niską alfę.
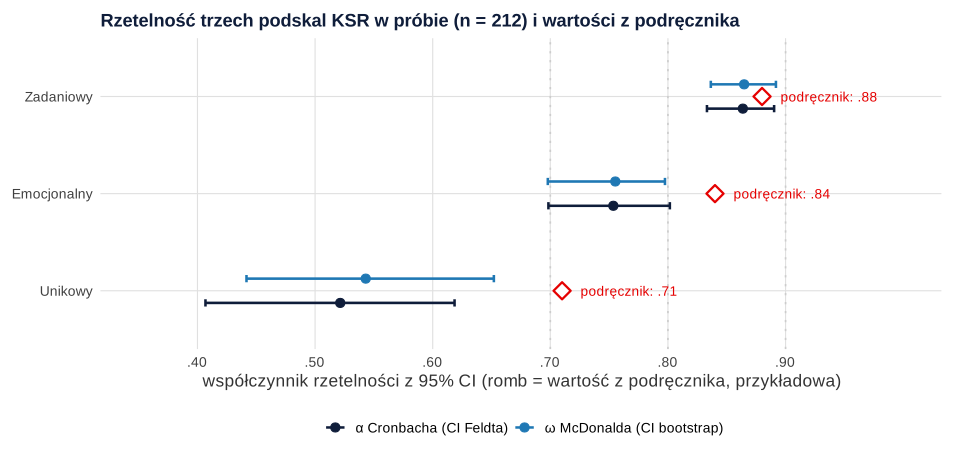
Rysunek 1 przyda się raczej na prezentacji albo obronie niż w samej pracy, ale dobrze pokazuje, co zobaczy czytelnik tabeli: alfa i omega niemal się pokrywają, przedział dla krótkiej podskali unikowej jest wyraźnie szerszy, a w dwóch podskalach wartość z podręcznika leży poza przedziałem z Twojej próby. Do tego ostatniego wrócimy w sytuacji 6.
Sytuacja 3: niska alfa – jak ją uczciwie opisać
Niska alfa to nie powód, żeby ukrywać wynik albo przemilczeć podskalę. Najpierw sprawdź, czy nie wynika z błędu w danych: nieprzekodowanej pozycji odwróconej, kodu braku danych (np. 99) albo pomylonych kolumn. Jeśli dane są w porządku, opisz wynik i wyjaśnij, co może za nim stać. W przykładzie podskala unikowa ma 4 pozycje, korelacje między nimi wynoszą od .09 do .37 (średnio .22), a korelacje pozycja–reszta – od .20 do .42.
Programy podpowiadają, że usunięcie pozycji u4 podniosłoby alfę z .52 do .55. W gotowym narzędziu zwykle tego nie robisz: zysk jest niewielki, a skrócona podskala nie jest już tym samym narzędziem co w podręczniku. Wystarczy wspomnieć o tym w ograniczeniach.
Czego nie pisać: „alfa wyniosła .52, co oznacza, że skala jest nierzetelna i nie nadaje się do badań”. Taki zapis przekreśla własne wyniki i jest nieprecyzyjny – rzetelność jest cechą wyników w danej próbie. Nie pisz też „alfa była zadowalająca”, gdy jej wartość tego nie uzasadnia. Jeśli niska rzetelność dotyczy zmiennej z hipotezy, która się nie potwierdziła, wspomnij o tym przy omawianiu wyników – więcej w poradniku hipoteza się nie potwierdziła – co dalej.
Sytuacja 4: pozycje odwrócone
Zapis o pozycjach odwróconych zajmuje jedno zdanie, a oszczędza recenzentowi pytań. Podaj numery pozycji i sposób rekodowania. W przykładzie przed przekodowaniem pozycje e2 i e5 miały ujemne korelacje pozycja–reszta (−.48 i −.40), a alfa podskali emocjonalnej była ujemna (−.16). Po przekodowaniu korelacje wyniosły .52 i .44, a alfa .75.
Jeśli pozycje odwrócone mimo przekodowania słabo korelują z resztą skali, to też warto zgłosić. Suárez-Álvarez i in. (2018) pokazali, że łączenie pozycji prostych i odwróconych może obniżać rzetelność i zagrażać jednowymiarowości. Weijters i in. (2013) wskazują trzy źródła takiego zniekształcenia: potakiwanie, nieuważne odpowiadanie i efekt potwierdzania. Takie wyjaśnienie zmieści się w jednym zdaniu ograniczeń.
Sytuacja 5: skala zaadaptowana albo własne tłumaczenie
Gdy sam tłumaczysz skalę albo korzystasz z wersji bez opublikowanych danych psychometrycznych, alfa nie wystarczy. Pokaż, że struktura narzędzia w Twojej próbie jest zgodna z oryginałem. Zwykle robi się to w konfirmacyjnej analizie czynnikowej. Rzetelność możesz wtedy podać jako omegę McDonalda, obliczoną z tego samego modelu. Dunn i in. (2014) proponują ją jako praktyczną alternatywę dla alfy, a Hayes i Coutts (2020) pokazują, jak ją policzyć m.in. w R, AMOS i SPSS (makro OMEGA). Jak przeprowadzić całą adaptację, opisujemy w poradniku adaptacja kulturowa kwestionariusza.
W przykładzie trójczynnikowy model CFA (estymator WLSMV, pozycje porządkowe) dobrze pasował do danych: χ²(101) = 118.31, p = .115, CFI = .988, TLI = .985, RMSEA = .029, 90% CI [.000, .048], SRMR = .057. Ładunki standaryzowane wynosiły od .66 do .82 (zadaniowy), od .54 do .69 (emocjonalny) i od .27 do .64 (unikowy).
Przedziały dla omegi pochodzą z bootstrapu (500 prób), dla alfy – z metody Feldta. Napisz, którą metodę zastosowałeś. Omegę we wzorze podano z modelu jednoczynnikowego liczonego osobno dla każdej podskali, a to też warto zaznaczyć jednym słowem. Więcej o odmianach omegi znajdziesz w haśle omega McDonalda. Jak opisać dopasowanie modelu w tabeli, pokazujemy w haśle tabela dopasowania modelu w APA.
Sytuacja 6: porównanie z wartościami z podręcznika testu
Często piszemy: „rzetelność w badaniu była zbliżona do podanej przez autorów”. Lepiej to sprawdzić, niż ocenić na oko. Feldt i in. (1987) podają teorię próbkowania dla alfy, która pozwala m.in. testować równość współczynników z niezależnych prób. Dla dwóch prób statystyka W = (1 − αpróba) / (1 − αpodręcznik) ma w przybliżeniu rozkład F z (n1 − 1, n2 − 1) stopniami swobody.
| Podskala | α w próbie | α w podręczniku | W | p |
|---|---|---|---|---|
| Zadaniowy | .86 | .88 | 1.14 | .227 |
| Emocjonalny | .75 | .84 | 1.54 | < .001 |
| Unikowy | .52 | .71 | 1.65 | < .001 |
Ostatnie zdanie zmień tak, by pasowało do Twojej próby. Różnicę w rzetelności może wyjaśnić węższy zakres wyników (np. sami studenci zamiast populacji ogólnej), inna wersja językowa albo inna forma badania (online zamiast papierowej). Podręcznikowa alfa z dużej, zróżnicowanej próby normalizacyjnej jest punktem odniesienia, a nie normą, którą Twoja próba musi spełnić.
Sytuacja 7: usunięcie pozycji z analizy
Czasem jest merytoryczny powód, żeby pominąć pozycję: wadliwe tłumaczenie, pytanie niezrozumiałe dla badanej grupy albo błąd w ankiecie online. Opisz wtedy, kiedy i dlaczego podjęto decyzję, i podaj wartości dla obu wersji. Czytelnik musi móc ocenić, czy usunięcie nie było „dopasowywaniem” skali do wyników.
Ten wzór zakłada, że powód był znany przed analizą hipotez. Jeśli pozycję usunąłeś dopiero po zobaczeniu wyników, napisz to wprost i oznacz analizę jako eksploracyjną. Decyzja podjęta po fakcie i przemilczana zbliża się do p-hackingu. Dlatego warto zapisać zasady w planie analizy przed zebraniem danych, jak pokazujemy we wpisie plan analizy statystycznej i prerejestracja.
Wersja angielska i pozycje zero-jedynkowe
Gdy piszesz artykuł albo streszczenie po angielsku, zachowaj ten sam układ: nazwa współczynnika, wartość w Twojej próbie, przedział ufności i porównanie z publikacją źródłową. W angielskim tekście też obowiązuje kropka dziesiętna i brak zera wiodącego przed α.
Jeśli pozycje są zero-jedynkowe (np. test wiedzy z odpowiedziami poprawna/błędna), alfa Cronbacha jest liczbowo równa współczynnikowi KR-20. W opisie możesz użyć dowolnej z tych nazw, ale tylko jednej i konsekwentnie, np. „rzetelność testu wiedzy oszacowano współczynnikiem KR-20 (równoważnym alfie Cronbacha dla pozycji dwuwartościowych)”. Przy testach wiedzy dodaj też wskaźniki łatwości pozycji – przykład opisu znajdziesz w poradniku ankieta wiedzy – analiza krok po kroku.
Źle → dobrze: najczęstsze sformułowania
| Źle | Dobrze | Dlaczego |
|---|---|---|
| „Skala jest rzetelna (α = .86).” | „W niniejszym badaniu rzetelność podskali była dobra: α = .86, 95% CI [.83, .89].” | rzetelność dotyczy wyników w próbie, a nie narzędzia raz na zawsze |
| „α = 0,86” | „α = .86” | zapis APA: kropka dziesiętna, bez zera wiodącego |
| „Alfa Cronbacha dla całego kwestionariusza była wysoka.” | alfa dla każdej podskali osobno, w tabeli | alfa całości nie mówi nic o rzetelności podskal |
| „Rzetelność potwierdzili autorzy (α = .88).” | wartość z publikacji i wartość w Twojej próbie | wartość z podręcznika nie zastępuje własnej |
| „Usunięto pozycję 4, aby poprawić rzetelność.” | powód merytoryczny, moment decyzji i wartości przed oraz po | czytelnik musi ocenić, czy decyzja nie była dopasowana do wyników |
| „Wysoka alfa potwierdza jednowymiarowość skali.” | „Strukturę jednoczynnikową potwierdzono w CFA (…); rzetelność α = …” | alfa nie jest miarą wymiarowości |
| „Alfa = .52, skala nierzetelna, wyniki pominięto.” | wynik z CI, średnia korelacja między pozycjami, ostrożna interpretacja i ograniczenia | przemilczenie wyników to też błąd raportowania |
Ogólne zasady zapisu liczb i statystyk w APA zebraliśmy we wpisach jak opisać wyniki w stylu APA i tabele APA – wzory i przykłady, zgodnie z 7. wydaniem podręcznika APA (American Psychological Association, 2020).
Lista kontrolna przed oddaniem rozdziału
- Każda podskala ma własny współczynnik, policzony w Twojej próbie.
- Przy każdym współczynniku jest 95% CI i informacja o metodzie (Feldt, bootstrap).
- Pozycje odwrócone są wymienione z numerami, a w opisie jest wzór rekodowania.
- Pozycje usunięte – z powodem, momentem decyzji i wartościami przed i po.
- Wartości z publikacji źródłowej są podane obok Twoich; jeśli wyraźnie się różnią, porównanie jest skomentowane.
- Niskiej rzetelności nie ukryłeś – jest opisana w metodzie i w ograniczeniach.
- Przy własnym tłumaczeniu lub nowej skali jest sprawdzenie struktury (CFA) i omega.
- Zapis jest zgodny z APA: α = .86, nie „0,86”; „95% CI [.83, .89]”.
Jeśli wolisz, żeby ktoś sprawdził rozdział z opisem narzędzi i obliczenia rzetelności, zajrzyj do oferty analiz statystycznych dla studentów – liczymy alfę, omegę i CFA i omawiamy wyniki tak, abyś mógł je samodzielnie przedstawić. Zanim zaczniesz pisać, przejrzyj też najczęstsze poprawki promotora do rozdziału wyników.
Wzory raportowania – obliczenia w R
Kod odtwarza wszystkie liczby z tabel, wzorów zdań i rysunku. Pobierz plik wzor-raportowania-alfa-dane-przyklad.csv i zapisz go w katalogu roboczym R. Każdy przepis wczytuje dane samodzielnie i przekodowuje pozycje e2 i e5.
1. Tabela rzetelności, niska alfa i pozycje odwrócone
R
library(psych)     # alpha()
library(lavaan)    # cfa()
library(semTools)  # compRelSEM(): omega

dane <- read.csv("wzor-raportowania-alfa-dane-przyklad.csv")
dane[, c("e2", "e5")] <- 6 - dane[, c("e2", "e5")]   # przekodowanie pozycji odwróconych (skala 1–5)
podskale <- list(Zadaniowy = paste0("z", 1:6), Emocjonalny = paste0("e", 1:6), Unikowy = paste0("u", 1:4))

wiersz <- function(nazwa, poz) {
  x <- dane[, poz]; wynik <- rowMeans(x)
  a <- alpha(x, check.keys = FALSE)
  R <- cor(x)
  f <- cfa(paste(nazwa, "=~", paste(poz, collapse = " + ")), data = x, std.lv = TRUE)
  c(k = length(poz), M = mean(wynik), SD = sd(wynik), alfa = a$total$raw_alpha,
    CI_dolna = a$feldt$lower.ci[[1]], CI_gorna = a$feldt$upper.ci[[1]],
    omega = as.numeric(compRelSEM(f)[[1]]), sr_r = mean(R[lower.tri(R)]),
    r_pr_min = min(a$item.stats$r.drop), r_pr_max = max(a$item.stats$r.drop))
}
tabela <- t(sapply(names(podskale), function(s) wiersz(s, podskale[[s]])))
round(tabela, 2)
round(tabela[, c("alfa", "CI_dolna", "CI_gorna", "omega")], 3)

# Podskala unikowa: korelacje między pozycjami i analiza pozycji (niska alfa)
round(cor(dane[, podskale$Unikowy]), 2)
a_u <- alpha(dane[, podskale$Unikowy], check.keys = FALSE)
round(data.frame(r_poz_reszta = a_u$item.stats$r.drop, alfa_po_usunieciu = a_u$alpha.drop$raw_alpha,
                 row.names = podskale$Unikowy), 3)

# Pozycje odwrócone: skorygowana korelacja pozycja–reszta przed i po przekodowaniu
surowe <- read.csv("wzor-raportowania-alfa-dane-przyklad.csv")
round(rbind(przed = alpha(surowe[, podskale$Emocjonalny], check.keys = FALSE, warnings = FALSE)$item.stats$r.drop,
            po    = alpha(dane[, podskale$Emocjonalny], check.keys = FALSE)$item.stats$r.drop), 2)
round(c(alfa_przed = alpha(surowe[, podskale$Emocjonalny], check.keys = FALSE, warnings = FALSE)$total$raw_alpha,
        alfa_po = alpha(dane[, podskale$Emocjonalny], check.keys = FALSE)$total$raw_alpha), 3)
Wynik w R
            k    M   SD alfa CI_dolna CI_gorna omega sr_r r_pr_min r_pr_max
Zadaniowy   6 2.91 0.85 0.86     0.83     0.89  0.86 0.51     0.59     0.72
Emocjonalny 6 3.05 0.70 0.75     0.70     0.80  0.76 0.34     0.44     0.56
Unikowy     4 3.01 0.67 0.52     0.41     0.62  0.54 0.22     0.20     0.42
             alfa CI_dolna CI_gorna omega
Zadaniowy   0.864    0.833    0.890 0.865
Emocjonalny 0.754    0.698    0.802 0.755
Unikowy     0.521    0.407    0.619 0.543
     u1   u2   u3   u4
u1 1.00 0.37 0.25 0.23
u2 0.37 1.00 0.25 0.09
u3 0.25 0.25 1.00 0.11
u4 0.23 0.09 0.11 1.00
   r_poz_reszta alfa_po_usunieciu
u1        0.425             0.344
u2        0.345             0.420
u3        0.289             0.468
u4        0.198             0.550
      [,1]  [,2] [,3] [,4]  [,5] [,6]
przed 0.29 -0.48 0.19 0.20 -0.40 0.12
po    0.53  0.52 0.56 0.46  0.44 0.45
alfa_przed    alfa_po
    -0.158      0.754
2. Porównanie alfy z wartością z podręcznika (test Feldta)
R
# Porównanie alfy z własnej próby (n = 212) z alfą z podręcznika testu – test Feldta dla prób niezależnych:
# W = (1 − α_próba) / (1 − α_podręcznik) ma w przybliżeniu rozkład F(n_próba − 1, n_podręcznik − 1).
# Wartości „z podręcznika” są wymyślone na potrzeby przykładu (KSR jest narzędziem fikcyjnym).
feldt <- function(a1, n1, a2, n2) {
  W <- (1 - a1) / (1 - a2)
  p <- 2 * min(pf(W, n1 - 1, n2 - 1), 1 - pf(W, n1 - 1, n2 - 1))
  c(alfa_proba = a1, alfa_podrecznik = a2, W = W, p = p)
}
library(psych)
dane <- read.csv("wzor-raportowania-alfa-dane-przyklad.csv")
dane[, c("e2", "e5")] <- 6 - dane[, c("e2", "e5")]
podskale <- list(Zadaniowy = paste0("z", 1:6), Emocjonalny = paste0("e", 1:6), Unikowy = paste0("u", 1:4))
alfa_proba <- sapply(podskale, function(p) alpha(dane[, p], check.keys = FALSE)$total$raw_alpha)
podrecznik <- c(Zadaniowy = 0.88, Emocjonalny = 0.84, Unikowy = 0.71)      # przykładowe wartości z próby normalizacyjnej
n_podrecznik <- 850
wyn <- t(sapply(names(alfa_proba), function(s) feldt(alfa_proba[[s]], nrow(dane), podrecznik[[s]], n_podrecznik)))
data.frame(round(wyn[, 1:3], 3), p = signif(wyn[, "p"], 3))
Wynik w R
            alfa_proba alfa_podrecznik     W        p
Zadaniowy        0.864            0.88 1.136 2.27e-01
Emocjonalny      0.754            0.84 1.540 3.21e-05
Unikowy          0.521            0.71 1.650 1.24e-06
3. CFA dla skali adaptowanej
R
library(lavaan)   # cfa(): trójczynnikowy model pomiarowy jako uzupełnienie alfy w skali adaptowanej

dane <- read.csv("wzor-raportowania-alfa-dane-przyklad.csv")
dane[, c("e2", "e5")] <- 6 - dane[, c("e2", "e5")]
model <- '
  Zadaniowy   =~ z1 + z2 + z3 + z4 + z5 + z6
  Emocjonalny =~ e1 + e2 + e3 + e4 + e5 + e6
  Unikowy     =~ u1 + u2 + u3 + u4
'
f <- cfa(model, data = dane, std.lv = TRUE, estimator = "WLSMV", ordered = TRUE)   # pozycje porządkowe 1–5
round(fitMeasures(f, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.scaled", "tli.scaled", "rmsea.scaled",
                       "rmsea.ci.lower.scaled", "rmsea.ci.upper.scaled", "srmr")), 3)
std <- standardizedSolution(f)
lad <- std[std$op == "=~", ]
aggregate(est.std ~ lhs, data = lad, FUN = function(x) round(range(x), 2))
round(std[std$op == "~~" & std$lhs != std$rhs, "est.std"], 2)   # korelacje czynników: Z–E, Z–U, E–U
Wynik w R
         chisq.scaled             df.scaled         pvalue.scaled
              118.312               101.000                 0.115
           cfi.scaled            tli.scaled          rmsea.scaled
                0.988                 0.985                 0.029
rmsea.ci.lower.scaled rmsea.ci.upper.scaled                  srmr
                0.000                 0.048                 0.057
          lhs est.std.1 est.std.2
1 Emocjonalny      0.54      0.69
2     Unikowy      0.27      0.64
3   Zadaniowy      0.66      0.82
[1] -0.34  0.01  0.38
4. Alfa i omega z przedziałami ufności (dane do rysunku 1)
R
library(psych)     # alpha(): alfa z przedziałem Feldta
library(lavaan)    # cfa()
library(semTools)  # compRelSEM(): omega
library(boot)      # boot(), boot.ci(): przedział bootstrapowy dla omegi

dane <- read.csv("wzor-raportowania-alfa-dane-przyklad.csv")
dane[, c("e2", "e5")] <- 6 - dane[, c("e2", "e5")]
podskale <- list(Zadaniowy = paste0("z", 1:6), Emocjonalny = paste0("e", 1:6), Unikowy = paste0("u", 1:4))
omega_f <- function(x, nazwa) as.numeric(compRelSEM(cfa(paste(nazwa, "=~", paste(names(x), collapse = " + ")), data = x, std.lv = TRUE))[[1]])
set.seed(2108)
wyn <- do.call(rbind, lapply(names(podskale), function(s) {
  x <- dane[, podskale[[s]]]
  a <- alpha(x, check.keys = FALSE)
  b <- boot(x, function(d, i) omega_f(d[i, ], s), R = 500)
  ci_o <- boot.ci(b, type = "perc")$percent[4:5]
  rbind(data.frame(podskala = s, miara = "α Cronbacha (CI Feldta)", est = a$total$raw_alpha, lo = a$feldt$lower.ci[[1]], hi = a$feldt$upper.ci[[1]]),
        data.frame(podskala = s, miara = "ω McDonalda (CI bootstrap)", est = b$t0, lo = ci_o[1], hi = ci_o[2]))
}))
print(cbind(wyn[, 1:2], round(wyn[, 3:5], 3)))
Wynik w R
     podskala                      miara   est    lo    hi
1   Zadaniowy    α Cronbacha (CI Feldta) 0.864 0.833 0.890
2   Zadaniowy ω McDonalda (CI bootstrap) 0.865 0.836 0.892
3 Emocjonalny    α Cronbacha (CI Feldta) 0.754 0.698 0.802
4 Emocjonalny ω McDonalda (CI bootstrap) 0.755 0.698 0.797
5     Unikowy    α Cronbacha (CI Feldta) 0.521 0.407 0.619
6     Unikowy ω McDonalda (CI bootstrap) 0.543 0.442 0.652
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2, a plik Word – w pakietach officer i flextable. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling [R package]. https://CRAN.R-project.org/package=semTools
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents [R package]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting [R package]. https://doi.org/10.32614/CRAN.package.flextable
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Gdzie w pracy magisterskiej opisać alfę Cronbacha?
Zwykle w rozdziale metodologicznym, w opisie narzędzi: przy każdej skali podaj alfę z publikacji źródłowej i alfę policzoną w Twojej próbie. Gdy skal jest kilka, zestaw je w tabeli (liczba pozycji, M, SD, α z 95% CI) i odwołaj się do niej w tekście. Niektórzy promotorzy wolą tabelę rzetelności na początku rozdziału wyników – ważne, żeby znalazła się w pracy raz, w jednym miejscu.
Jak zapisać alfę Cronbacha w stylu APA?
Grecką literą α, bez zera wiodącego i z kropką dziesiętną, zwykle z dwoma miejscami po kropce: α = .86. Dodaj 95% przedział ufności w nawiasach kwadratowych: α = .86, 95% CI [.83, .89]. W tabeli podaj liczbę pozycji, a w nocie – metodę wyznaczenia przedziału i informację o przekodowanych pozycjach.
Co napisać, gdy alfa Cronbacha jest niższa niż .70?
Podaj wartość z przedziałem ufności, liczbę pozycji i średnią korelację między pozycjami, a następnie wyjaśnij możliwe przyczyny, np. krótką podskalę albo jednorodną próbę. W ograniczeniach napisz, że niska rzetelność osłabia związki z innymi zmiennymi, więc wyniki tej skali należy interpretować ostrożnie. Nie pomijaj skali i nie usuwaj pozycji bez merytorycznego powodu.
Jak porównać alfę z mojej próby z alfą z podręcznika testu?
Możesz użyć testu Feldta dla prób niezależnych: statystyka W = (1 − α w Twojej próbie) / (1 − α w podręczniku) ma w przybliżeniu rozkład F z (n1 − 1, n2 − 1) stopniami swobody. Potrzebujesz obu alf i obu liczebności. Wynik nieistotny pozwala napisać, że rzetelność była zbliżona do podanej przez autorów; istotny – że była niższa, z próbą wyjaśnienia dlaczego.
Czy trzeba podawać omegę McDonalda obok alfy Cronbacha?
Nie zawsze, ale warto, gdy sam tłumaczysz lub tworzysz skalę albo sprawdzasz jej strukturę w CFA – omega wynika wtedy z tego samego modelu. Przy gotowej skali z dobrze udokumentowaną strukturą zwykle wystarcza alfa z przedziałem ufności, chyba że promotor albo czasopismo wymaga omegi. Gdy podajesz obie, napisz, z jakiego modelu liczona jest omega.
Powiązane hasła
Przeczytaj też
Alfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikAdaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →Nie wiesz, jak opisać rzetelność skal w swojej pracy?
Policzymy alfę, omegę i CFA dla Twoich narzędzi i wyjaśnimy wyniki, tak abyś mógł (mogła) samodzielnie opisać je w rozdziale metodologicznym i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). APA Style Journal Article Reporting Standards (APA Style JARS). APA Style. Pobrano 15 października 2026 z https://apastyle.apa.org/jars ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Feldt, L. S., Woodruff, D. J., & Salih, F. A. (1987). Statistical inference for coefficient alpha. Applied Psychological Measurement, 11(1), 93–103. https://doi.org/10.1177/014662168701100107 ● Otwarty dostęp: pełny tekst
- Flake, J. K., Pek, J., & Hehman, E. (2017). Construct validation in social and personality research: Current practice and recommendations. Social Psychological and Personality Science, 8(4), 370–378. https://doi.org/10.1177/1948550617693063
- Hayes, A. F., & Coutts, J. J. (2020). Use omega rather than Cronbach’s alpha for estimating reliability. But…. Communication Methods and Measures, 14(1), 1–24. https://doi.org/10.1080/19312458.2020.1718629
- Kelley, K., & Pornprasertmanit, S. (2016). Confidence intervals for population reliability coefficients: Evaluation of methods, recommendations, and software for composite measures. Psychological Methods, 21(1), 69–92. https://doi.org/10.1037/a0040086
- Suárez-Álvarez, J., Pedrosa, I., Lozano, L. M., García-Cueto, E., Cuesta, M., & Muñiz, J. (2018). Using reversed items in Likert scales: A questionable practice. Psicothema, 2(30), 149–158. https://doi.org/10.7334/psicothema2018.33 ● Otwarty dostęp
- Weijters, B., Baumgartner, H., & Schillewaert, N. (2013). Reversed item bias: An integrative model. Psychological Methods, 18(3), 320–334. https://doi.org/10.1037/a0032121 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apandjars, author={{American Psychological Association}}, title={{APA Style Journal Article Reporting Standards (APA Style JARS)}}, howpublished={APA Style}, publisher={American Psychological Association}, url={https://apastyle.apa.org/jars}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{feldt1987statistical, author={Feldt, Leonard S. and Woodruff, David J. and Salih, Fathi A.}, title={{Statistical inference for coefficient alpha}}, journal={Applied Psychological Measurement}, year={1987}, volume={11}, number={1}, pages={93--103}, doi={10.1177/014662168701100107}}@article{flake2017construct, author={Flake, Jessica K. and Pek, Jolynn and Hehman, Eric}, title={{Construct validation in social and personality research: Current practice and recommendations}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={370--378}, doi={10.1177/1948550617693063}}@article{hayes2020use, author={Hayes, Andrew F. and Coutts, Jacob J.}, title={{Use omega rather than Cronbach’s alpha for estimating reliability. But…}}, journal={Communication Methods and Measures}, year={2020}, volume={14}, number={1}, pages={1--24}, doi={10.1080/19312458.2020.1718629}}@article{kelley2016confidence, author={Kelley, Ken and Pornprasertmanit, Sunthud}, title={{Confidence intervals for population reliability coefficients: Evaluation of methods, recommendations, and software for composite measures}}, journal={Psychological Methods}, year={2016}, volume={21}, number={1}, pages={69--92}, doi={10.1037/a0040086}}@article{suarezalvarez2018using, author={Suárez-Álvarez, Javier and Pedrosa, Ignacio and Lozano, Luis M. and García-Cueto, Eduardo and Cuesta, Marcelino and Muñiz, José}, title={{Using reversed items in Likert scales: A questionable practice}}, journal={Psicothema}, year={2018}, volume={2}, number={30}, pages={149--158}, doi={10.7334/psicothema2018.33}}@article{weijters2013reversed, author={Weijters, Bert and Baumgartner, Hans and Schillewaert, Niels}, title={{Reversed item bias: An integrative model}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={320--334}, doi={10.1037/a0032121}}