Styl APA i standardy JARS: dwa różne dokumenty
Gdy recenzent pisze „proszę dostosować raport do wytycznych APA”, może mieć na myśli dwie różne rzeczy. Pierwsza to styl APA opisany w 7. wydaniu podręcznika publikacyjnego (American Psychological Association, 2020): forma cytowań, bibliografii, nagłówków, tabel oraz zapisu liczb i statystyk. Druga to standardy raportowania JARS (Journal Article Reporting Standards), które określają treść: jakie informacje o metodzie i wynikach muszą się znaleźć w artykule, aby czytelnik mógł ocenić badanie i je powtórzyć.
Ten poradnik dotyczy przede wszystkim drugiej części, czyli JARS-Quant – standardów dla badań ilościowych. Opracował je zespół APA, który zaktualizował wcześniejsze standardy, wprowadził rozróżnienie hipotez, analiz i wniosków na pierwszorzędowe, drugorzędowe i eksploracyjne oraz dodał moduły m.in. dla badań obserwacyjnych, podłużnych, replikacji, badań N-of-1, modelowania równań strukturalnych i analiz bayesowskich (Appelbaum i in., 2018). Równolegle powstały standardy dla badań jakościowych i mieszanych, JARS-Qual i JARS-Mixed (Levitt i in., 2018). Oficjalna strona APA Style zbiera wszystkie zestawy, w tym JARS-REC dotyczące rasy, etniczności i kultury (American Psychological Association, b.d.).
Korzenie tych standardów sięgają raportu, w którym Wilkinson i zespół APA do spraw wnioskowania statystycznego (Task Force on Statistical Inference) w 1999 roku sformułowali wytyczne stosowania i raportowania metod statystycznych w czasopismach psychologicznych. JARS zamieniają te zalecenia w listę kontrolną. Nie są regulaminem konkretnego czasopisma, ale wiele redakcji odsyła do nich w instrukcjach dla autorów, a recenzenci metodologiczni używają ich jak listy pytań.
Poniżej omawiamy, co JARS-Quant wymagają w sekcjach Metoda i Wyniki, i pokazujemy to na jednym przykładzie: eksperymencie z losowym przydziałem, w którym część osób nie wypełniła drugiego pomiaru. Liczby pochodzą z kodu R na tej stronie (dane symulowane). Lista kontrolna do pobrania jest na końcu poradnika.
Jak zbudowane są JARS-Quant: tabele i moduły
Podstawą jest Tabela 1 – informacje, które powinien zawierać każdy raport z nowo zebranych danych, niezależnie od schematu badania. Do niej dokłada się kolejne tabele i moduły zależnie od tego, czy warunki były manipulowane, czy obserwowane (American Psychological Association, 2024):
| Schemat badania | Co stosujesz oprócz Tabeli 1 |
|---|---|
| Eksperyment z losowym przydziałem | Tabela 2 i moduł A |
| Manipulacja bez losowego przydziału | Tabela 2 i moduł B |
| Badanie kliniczne z losowym przydziałem | Tabela 2 oraz moduły A i C |
| Badanie kliniczne bez losowego przydziału | Tabela 2 oraz moduły B i C |
| Badanie nieeksperymentalne (obserwacyjne, epidemiologiczne, porównania grup) | Tabela 3 |
| Badanie podłużne | Tabela 4 |
| Badania N-of-1 | Tabela 5 |
| Replikacje | Tabela 6 |
Analizy złożone, takie jak modelowanie równań strukturalnych, mają osobne wymagania (Tabela 7), a dla analiz bayesowskich istnieje osobny zestaw zaleceń; praktyczne wskazówki, jak zaplanować i opisać analizę bayesowską, podają też van Doorn i in. (2021). Jeśli Twój schemat nie mieści się w żadnej kategorii, podaj jego przyjętą nazwę. W badaniach klinicznych równolegle obowiązują wytyczne czasopism medycznych, np. CONSORT – piszemy o tym w poradniku statystyka w publikacji medycznej.
Sekcja Metoda: co raportować
Poniżej omówienie elementów Tabeli 1 dla sekcji Metoda. To streszczenie po polsku, a nie przekład – przed wysłaniem artykułu sprawdź pełną tabelę na stronie APA Style.
Uczestnicy i sposób doboru
Podaj kryteria włączenia i wykluczenia (także ograniczenia demograficzne) oraz najważniejsze cechy uczestników: demograficzne i te, które mają znaczenie dla tematu badania. W opisie doboru JARS-Quant wymagają informacji, które w polskich pracach często giną: jaki odsetek zaproszonych osób faktycznie wziął udział, czy zachodziła samoselekcja, gdzie i kiedy zbierano dane, jakie było wynagrodzenie lub inne gratyfikacje oraz jaka komisja etyczna wydała zgodę (American Psychological Association, 2024). Szczegółowe wzory opisu próby znajdziesz we wpisie jak opisać charakterystykę próby.
Liczebność, moc i precyzja
Raport powinien zawierać planowaną liczebność, liczebność uzyskaną (jeśli jest inna) i sposób ustalenia liczebności – analizę mocy albo planowanie precyzji oszacowań – a także informację o analizach pośrednich i regułach zatrzymania zbierania danych. Lakens (2022) opisuje sześć uczciwych sposobów uzasadnienia liczebności, od badania całej populacji, przez ograniczenia zasobów, po analizę mocy a priori i planowanie dokładności. Gdy liczebność wynikała z dostępnych zasobów, napisz to wprost i dodaj analizę wrażliwości: jaki efekt badanie mogło wykryć z rozsądną mocą. Nie licz mocy post hoc z uzyskanej wielkości efektu – niczego nie dodaje do wartości p. Więcej o planowaniu w poradniku dobór liczebności próby.
Pomiar i psychometria
Opisz wszystkie zmienne główne i drugorzędowe oraz kowarianty, w tym miary zebrane, ale nieuwzględnione w raporcie. To jeden z najważniejszych zapisów całych standardów. Simmons i in. (2011) pokazali, że nieujawniona swoboda w wyborze zmiennych, warunków i reguł analizy radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Dla każdego narzędzia podaj jego właściwości oraz rzetelność wyników w Twojej próbie: spójność wewnętrzną dla skal, zgodność sędziów dla ocen, rzetelność test–retest w badaniach podłużnych. Jeśli przytaczasz rzetelność z podręcznika testu, opisz też próbę, na której ją policzono. Przy skalach podawaj obok alfy Cronbacha także omegę McDonalda – zob. spójność wewnętrzna.
Schemat, warunki i zaślepienie
Napisz, czy warunki były manipulowane, czy obserwowane, i nazwij schemat. W eksperymencie opisz randomizację (sposób generowania przydziału, ukrycie listy przydziału) oraz zaślepienie: czy uczestnicy, prowadzący i oceniający wyniki wiedzieli, kto jest w jakiej grupie, i czy sprawdzano skuteczność zaślepienia.
Diagnostyka danych
Ta część dotyczy decyzji podejmowanych po zebraniu danych, ale zaplanowanych przed analizą: kryteriów wykluczania osób (np. niezaliczone pytanie kontrolne), postępowania z brakami danych i metody imputacji, definicji i sposobu traktowania obserwacji odstających, analizy rozkładów i ewentualnych transformacji.
Strategia analityczna
Opisz analizy osobno dla hipotez głównych, drugorzędowych i eksploracyjnych oraz sposób ochrony przed kumulacją błędu I rodzaju przy wielu testach (zob. problem wielokrotnych porównań). Jeśli badanie było prerejestrowane, podaj rejestr i numer, a odstępstwa od planu opisz w tekście – wzory zdań są w poradniku plan analizy statystycznej i prerejestracja. Jak napisać sam podrozdział o analizie statystycznej, pokazujemy we wpisie opis metod statystycznych w pracy badawczej.
Sekcja Wyniki: co raportować
Przepływ uczestników i rekrutacja
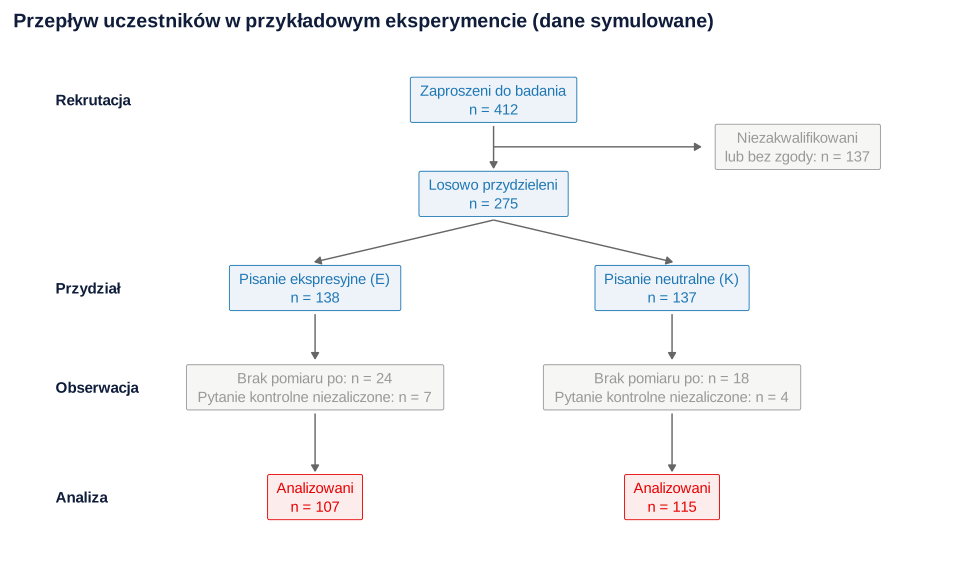
Podaj liczbę osób w każdej grupie na każdym etapie badania, najlepiej na schemacie przepływu (APA udostępnia wzór schematu dla JARS-Quant), oraz daty rekrutacji i kolejnych pomiarów. Rysunek 1 pokazuje schemat dla naszego przykładu. Z 412 zaproszonych osób 137 nie spełniło kryteriów lub nie wyraziło zgody, a 275 losowo przydzielono do pisania ekspresyjnego o zbliżającym się egzaminie (E, n = 138) albo pisania neutralnego (K, n = 137). Pomiaru po interwencji nie wypełniły 24 osoby z grupy E i 18 z grupy K, a 7 i 4 osoby wykluczono za niezaliczone pytanie kontrolne. Analizowano dane 107 osób z grupy E i 115 z grupy K.
Braki danych
JARS-Quant wymagają trzech informacji: odsetka braków, argumentów dotyczących ich przyczyn (mechanizm MCAR, MAR lub MNAR) i metody postępowania. W przykładzie brakowało pomiaru po interwencji u 15.3% osób (17.4% w grupie E i 13.1% w grupie K). Osoby bez drugiego pomiaru nie różniły się istotnie lękiem przed interwencją od pozostałych (M = 3.16 wobec 3.33, t(55.6) = −1.40, p = .168). To jednak tylko częściowy argument: zgodność w jednej zmiennej nie dowodzi, że braki są losowe, i nie wyklucza mechanizmu MNAR. Dlatego warto dodać analizę wrażliwości, np. imputację wielokrotną – zob. braki danych i imputacja wielokrotna w R.
Statystyki opisowe
Dla każdej zmiennej głównej i drugorzędowej podaj liczebność, średnie i odchylenia standardowe – w całej próbie i w każdej podgrupie. W praktyce najwygodniej zrobić to w tabeli, jak w haśle tabela statystyk opisowych w APA; wzory innych tabel zebraliśmy w poradniku tabele APA – wzory i przykłady.
Statystyka inferencyjna
To serce sekcji Wyniki. JARS-Quant wymagają wyników wszystkich przeprowadzonych testów z dokładną wartością p (jeśli stosujesz testowanie istotności), zestawu statystyk wystarczającego do odtworzenia testu (np. stopnie swobody), oszacowań wielkości efektu z przedziałami ufności dla każdego testu, gdy to możliwe, oraz wyraźnego rozdzielenia hipotez głównych, drugorzędowych i eksploracyjnych (American Psychological Association, 2024). Cumming (2014) uzasadnia, dlaczego to wielkość efektu z przedziałem ufności, a nie samo przekroczenie progu istotności, powinna być podstawą interpretacji. O tym, jak interpretować miary efektu, piszemy w poradniku wielkość efektu – interpretacja.
Analizy złożone i oprogramowanie
Przy modelach równań strukturalnych, modelach wielopoziomowych, analizie czynnikowej i innych analizach wielowymiarowych podaj szczegóły estymowanych modeli, macierz kowariancji lub korelacji, nazwę programu i pakietu (JARS-Quant podają przykłady: procedura SAS albo konkretny pakiet R) oraz problemy estymacji, np. brak zbieżności, i sposób ich rozwiązania. Macierz korelacji w materiałach dodatkowych pozwala innym odtworzyć model – a jeśli możesz udostępnić dane i kod, zrób to (zob. pakiet replikacyjny).
Inne analizy i założenia
Opisz także pozostałe analizy, w tym skorygowane o kowarianty, z zaznaczeniem, które były zaplanowane, a które nie. Na końcu wskaż problemy z założeniami lub rozkładami, które mogą wpływać na trafność wniosków. Nie trzeba opisywać każdego wykresu reszt; trzeba napisać, czy coś budzi zastrzeżenia i co z tym zrobiono.
Przykład: metoda i wyniki według JARS-Quant
Poniższe fragmenty opisują przykładowy eksperyment. Hipoteza główna: pisanie ekspresyjne o egzaminie obniża lęk przed egzaminem w porównaniu z pisaniem neutralnym. Analiza główna to test t Welcha na wyniku po interwencji z g Hedgesa; analiza drugorzędowa – ANCOVA z lękiem wyjściowym jako kowariantem. Test Welcha przyjęliśmy jako domyślny, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach, a przy równych traci niewiele (Delacre i in., 2017).
Zwróć uwagę na trzy szczegóły. Po pierwsze, grupy różniły się przypadkowo lękiem wyjściowym (M = 3.24 w grupie E i 3.43 w grupie K), dlatego skorygowana różnica (−0.31) jest mniejsza niż surowa (−0.40). Obie analizy zostały zaplanowane, więc raportujemy obie, a o tym, która jest główna, zdecydowano przed analizą. Po drugie, cząstkowe η² = .07 i g = −0.62 to różne miary – nie porównuj ich bezpośrednio i zawsze nazywaj miarę, którą podajesz (zob. eta kwadrat). Po trzecie, opis zawiera informację o brakach danych i wykluczeniach w tym samym akapicie co wynik – recenzent nie musi ich szukać.
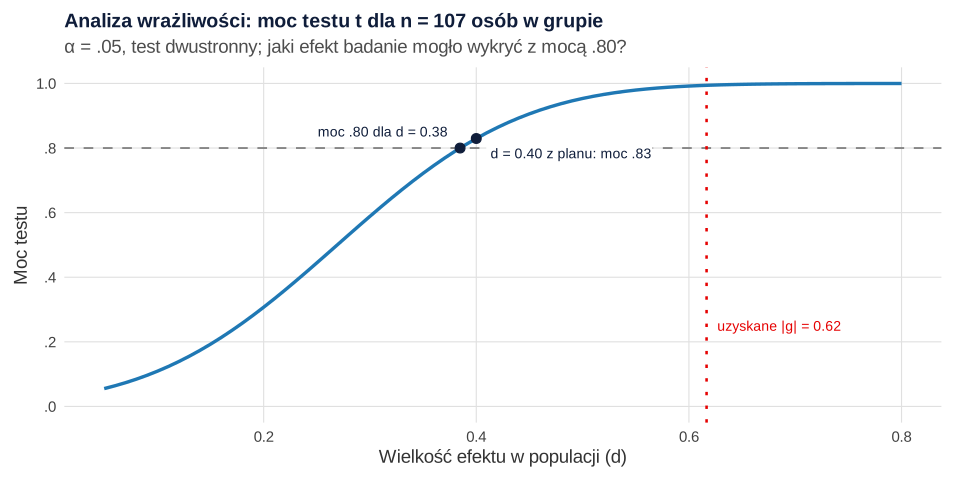
Analiza wrażliwości (rysunek 2) odpowiada na pytanie, jaki efekt to badanie mogło wykryć. Przy 107 osobach w mniejszej grupie test t ma moc .80 dla efektu d = 0.38, a dla efektu z planu (d = 0.40) moc wynosiła .83. Taki zapis jest bardziej informacyjny niż „moc obserwowana”, bo nie zależy od uzyskanego wyniku.
Zapis liczb i statystyk
Forma zapisu wyników należy już do stylu APA, a nie do JARS. Zasady zapisu liczb i statystyk zawiera rozdział 6 podręcznika publikacyjnego (American Psychological Association, 2020). Najważniejsze z nich:
- symbole statystyk kursywą (M, SD, t, F, p, r), litery greckie bez kursywy (α, η², χ²);
- dokładne p z dwoma lub trzema miejscami po przecinku, a dla bardzo małych wartości „p < .001”; nigdy „p = .000”;
- bez zera przed przecinkiem dla wartości, które nie mogą przekroczyć 1 (p, r, α, η²), z zerem dla pozostałych (d = 0.40, M = 0.87);
- przedziały ufności w nawiasach kwadratowych z poziomem: 95% CI [−0.57, −0.23];
- stopnie swobody w nawiasie po symbolu testu: t(206.95), F(1, 219).
W artykułach anglojęzycznych separator dziesiętny to kropka. W polskich czasopismach i pracach dyplomowych bywa wymagany przecinek – sprawdź instrukcję dla autorów i stosuj jeden zapis konsekwentnie. Na metodolog.pl używamy kropki. Więcej przykładów zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przed wysłaniem sprawdź, czy wartości p zgadzają się ze statystyką testu i stopniami swobody. Nuijten i in. (2016) przeanalizowali ponad 250 tysięcy wartości p z ośmiu czasopism psychologicznych: połowa artykułów stosujących testowanie istotności zawierała co najmniej jedną niespójną wartość p, a co ósmy – niespójność, która mogła zmienić wniosek. Najprostsza ochrona to wklejanie liczb do tekstu bezpośrednio z wyniku skryptu, a nie przepisywanie ich ręcznie.
Dyskusja: czego wymagają standardy
JARS-Quant obejmują także dyskusję, choć ta część rzadziej bywa przedmiotem uwag recenzentów metodologicznych. Wymagają one wyraźnej informacji, które hipotezy – główne i drugorzędowe – zostały poparte, a które nie, oraz omówienia znaczenia analiz eksploracyjnych z zastrzeżeniem, że ryzyko błędu nie było w nich kontrolowane. Interpretacja ma uwzględniać źródła obciążeń i zagrożenia trafności, niedokładność pomiaru, łączną liczbę testów i ich wzajemne zachodzenie oraz adekwatność liczebności. Na końcu omawiasz możliwość uogólnienia wyników i ich konsekwencje dla dalszych badań i praktyki.
W naszym przykładzie oznacza to m.in. zastrzeżenie, że lęk mierzono samoopisem tuż po interwencji, więc nie wiadomo, jak długo efekt się utrzymuje, oraz że część osób nie wypełniła drugiego pomiaru, a zgodność lęku wyjściowego nie wyklucza braków zależnych od nieobserwowanych przyczyn.
Lista kontrolna JARS-Quant do pobrania
Plik do pobrania: wytyczne-apa-lista-kontrolna-jars-quant.xlsx – 21 elementów dla sekcji Metoda, Wyniki i Dyskusja z angielską nazwą elementu, omówieniem po polsku i kolumnami „Gdzie w manuskrypcie” i „Status” (8 KB). To skrót do pracy własnej; przy wysyłaniu artykułu sprawdź też tabele i moduły dla swojego schematu.
| Sekcja | Sprawdź, czy raport zawiera |
|---|---|
| Metoda – uczestnicy | kryteria włączenia i wykluczenia, cechy próby, odsetek uczestnictwa, samoselekcję, miejsce i daty, wynagrodzenie, zgodę etyczną |
| Metoda – liczebność | planowaną i uzyskaną liczebność, uzasadnienie (moc lub precyzja), analizy pośrednie i reguły zatrzymania |
| Metoda – pomiar | wszystkie miary i kowarianty, także nieraportowane; rzetelność w badanej próbie |
| Metoda – schemat | typ schematu, randomizację, zaślepienie |
| Metoda – analiza | reguły wykluczeń, braki, obserwacje odstające, transformacje; analizy dla hipotez głównych, drugorzędowych i eksploracyjnych; korekty |
| Wyniki – przepływ | liczebności na każdym etapie i w każdej grupie, schemat przepływu, daty rekrutacji |
| Wyniki – braki | odsetek braków, argumenty dotyczące mechanizmu, zastosowaną metodę |
| Wyniki – testy | statystyki opisowe w podgrupach, dokładne p, df, wielkości efektu z CI, podział na hipotezy główne i pozostałe |
| Wyniki – analizy złożone | szczegóły modelu, macierz korelacji, program i pakiet, problemy estymacji |
| Wyniki – pozostałe | analizy nieplanowane oznaczone jako takie, problemy z założeniami |
Jeśli przygotowujesz artykuł i chcesz, żeby ktoś sprawdził sekcje Metoda i Wyniki pod kątem JARS-Quant albo pomógł odpowiedzieć na uwagi recenzenta, zajrzyj do oferty analiz statystycznych dla badaczy. Typowe zarzuty dotyczące statystyki i sposoby odpowiedzi na nie omawiamy w poradniku zarzuty recenzentów do statystyki.
Przykład w R
Kod symuluje dane eksperymentu i odtwarza wszystkie liczby z sekcji o wynikach, przykładowych opisów i rysunków. Lista kontrolna do pobrania powstaje z osobnego skryptu p24-lista-kontrolna.R (pakiet writexl).
Przepływ uczestników, braki danych, rzetelność, analiza główna, drugorzędowa i wrażliwości
R
# P24 – przykład raportu według JARS-Quant: przepływ uczestników, braki danych, rzetelność,
# analiza główna (test t Welcha + g Hedgesa), analiza drugorzędowa (ANCOVA) i analiza wrażliwości liczebności.
# Uruchom z katalogu strony (strony/P24):  Rscript kod/p24-raport-jars.R > kod/p24-raport-jars-wynik.txt
# Dane symulowane: eksperyment z losowym przydziałem – pisanie ekspresyjne o egzaminie (E) a pisanie neutralne (K);
# zmienna zależna: lęk przed egzaminem po interwencji (8 pozycji, odpowiedzi 1–5), kowariant: lęk przed interwencją.
suppressPackageStartupMessages({ library(psych); library(effectsize) })
set.seed(2408)
fp <- function(p) if (p < .001) "p < .001" else paste0("p = ", sub("^0", "", sprintf("%.3f", p)))   # zapis p jak w APA

# --- 1. Przepływ uczestników
zaproszeni <- 412
spelnia <- rbinom(zaproszeni, 1, 0.62) == 1            # spełnia kryteria i wyraża zgodę
n_rand <- sum(spelnia)
d <- data.frame(id = seq_len(n_rand), grupa = factor(sample(rep(c("E", "K"), length.out = n_rand)), levels = c("E", "K")))
d$lek_przed <- pmin(pmax(rnorm(n_rand, 3.30, 0.70), 1), 5)
ukonczyl <- rbinom(n_rand, 1, ifelse(d$grupa == "E", 0.84, 0.88)) == 1   # wypełnił pomiar po interwencji
uwaga_ok <- rbinom(n_rand, 1, 0.96) == 1                                  # zaliczył pytanie kontrolne
# 8 pozycji lęku po interwencji: wspólny czynnik + błąd; w grupie E średnio niższy lęk
prawdziwy <- 0.65 * (d$lek_przed - 3.3) - 0.30 * (d$grupa == "E") + rnorm(n_rand, 0, 0.55)
poz <- sapply(1:8, function(j) pmin(pmax(round(3.2 + 0.9 * prawdziwy + rnorm(n_rand, 0, 0.75)), 1), 5))
colnames(poz) <- paste0("lek", 1:8)
poz[!ukonczyl, ] <- NA
d <- cbind(d, poz)
d$lek_po <- rowMeans(poz)
d$analiza <- ukonczyl & uwaga_ok

przeplyw <- data.frame(
  etap = c("zaproszeni", "niezakwalifikowani lub bez zgody", "losowo przydzieleni", "przydzieleni do E", "przydzieleni do K",
           "E: brak pomiaru po", "K: brak pomiaru po", "E: wykluczeni (pytanie kontrolne)", "K: wykluczeni (pytanie kontrolne)",
           "E: analizowani", "K: analizowani"),
  n = c(zaproszeni, zaproszeni - n_rand, n_rand, sum(d$grupa == "E"), sum(d$grupa == "K"),
        sum(d$grupa == "E" & !ukonczyl), sum(d$grupa == "K" & !ukonczyl),
        sum(d$grupa == "E" & ukonczyl & !uwaga_ok), sum(d$grupa == "K" & ukonczyl & !uwaga_ok),
        sum(d$grupa == "E" & d$analiza), sum(d$grupa == "K" & d$analiza)))
print(przeplyw, row.names = FALSE)
saveRDS(przeplyw, "kod/p24-przeplyw.rds")

# --- 2. Braki danych: odsetek i porównanie lęku wyjściowego osób z pomiarem i bez
cat("\nOdsetek braków pomiaru po interwencji (%):\n")
print(round(100 * tapply(!ukonczyl, d$grupa, mean), 1))
cat(sprintf("Ogółem: %.1f%%\n", 100 * mean(!ukonczyl)))
bp <- t.test(lek_przed ~ ukonczyl, data = d)
cat(sprintf("Lęk przed: bez pomiaru po M = %.2f, z pomiarem M = %.2f, t(%.1f) = %.2f, %s\n",
            bp$estimate[1], bp$estimate[2], bp$parameter, bp$statistic, fp(bp$p.value)))

# --- 3. Próba analizowana: statystyki opisowe i rzetelność skali lęku po interwencji
a <- d[d$analiza, ]
cat("\nStatystyki opisowe (próba analizowana):\n")
print(round(do.call(rbind, lapply(split(a, a$grupa), function(x)
  c(n = nrow(x), M_przed = mean(x$lek_przed), SD_przed = sd(x$lek_przed), M_po = mean(x$lek_po), SD_po = sd(x$lek_po)))), 2))
alfa <- psych::alpha(a[, paste0("lek", 1:8)])$total$raw_alpha
om <- suppressWarnings(suppressMessages(psych::omega(a[, paste0("lek", 1:8)], nfactors = 1, plot = FALSE)))$omega.tot
cat(sprintf("Rzetelność skali lęku po: alfa Cronbacha = %.2f, omega = %.2f\n", alfa, om))

# --- 4. Analiza główna: test t Welcha i g Hedgesa z 95% CI
w <- t.test(lek_po ~ grupa, data = a)
g <- hedges_g(lek_po ~ grupa, data = a, pooled_sd = TRUE)
cat(sprintf("\nWelch: roznica E - K = %.2f, 95%% CI [%.2f, %.2f], t(%.2f) = %.2f, %s\n",
            -diff(w$estimate), w$conf.int[1], w$conf.int[2], w$parameter, w$statistic, fp(w$p.value)))
cat(sprintf("g Hedgesa = %.2f, 95%% CI [%.2f, %.2f]\n", g$Hedges_g, g$CI_low, g$CI_high))

# --- 5. Analiza drugorzędowa: ANCOVA z lękiem przed interwencją
anc <- lm(lek_po ~ grupa + lek_przed, data = a)
print(round(cbind(coef(summary(anc)), confint(anc)), 3))
ss <- car::Anova(anc, type = 2)
cat(sprintf("F(1, %d) = %.2f, eta2 czastkowe = %.3f\n", anc$df.residual, ss["grupa", "F value"],
            ss["grupa", "Sum Sq"] / (ss["grupa", "Sum Sq"] + ss["Residuals", "Sum Sq"])))

# --- 6. Liczebność: plan a priori i analiza wrażliwości dla osiągniętej próby
cat(sprintf("\nPlan a priori: d = 0.40, moc .80 -> n na grupę = %d\n", ceiling(power.t.test(delta = 0.40, power = .80)$n)))
n_min <- min(table(a$grupa))
cat(sprintf("Wrażliwość: n = %d na grupę, moc .80 -> najmniejsze wykrywalne d = %.2f\n", n_min,
            power.t.test(n = n_min, power = .80)$delta))
cat(sprintf("Moc dla d = 0.40 przy n = %d na grupę: %.2f\n", n_min, power.t.test(n = n_min, delta = 0.40)$power))
saveRDS(list(n_min = n_min, g = g$Hedges_g), "kod/p24-wrazliwosc.rds")
Wynik w R
                              etap   n
                        zaproszeni 412
  niezakwalifikowani lub bez zgody 137
               losowo przydzieleni 275
                 przydzieleni do E 138
                 przydzieleni do K 137
                E: brak pomiaru po  24
                K: brak pomiaru po  18
 E: wykluczeni (pytanie kontrolne)   7
 K: wykluczeni (pytanie kontrolne)   4
                    E: analizowani 107
                    K: analizowani 115

Odsetek braków pomiaru po interwencji (%):
   E    K
17.4 13.1
Ogółem: 15.3%
Lęk przed: bez pomiaru po M = 3.16, z pomiarem M = 3.33, t(55.6) = -1.40, p = .168

Statystyki opisowe (próba analizowana):
    n M_przed SD_przed M_po SD_po
E 107    3.24     0.68 2.87  0.71
K 115    3.43     0.65 3.27  0.59
Rzetelność skali lęku po: alfa Cronbacha = 0.83, omega = 0.83

Welch: roznica E - K = -0.40, 95% CI [-0.57, -0.23], t(206.95) = -4.58, p < .001
g Hedgesa = -0.62, 95% CI [-0.88, -0.35]
            Estimate Std. Error t value Pr(>|t|) 2.5 % 97.5 %
(Intercept)    1.205      0.188   6.404        0 0.834  1.576
grupaK         0.305      0.075   4.075        0 0.158  0.453
lek_przed      0.514      0.056   9.218        0 0.404  0.623
F(1, 219) = 16.60, eta2 czastkowe = 0.070

Plan a priori: d = 0.40, moc .80 -> n na grupę = 100
Wrażliwość: n = 107 na grupę, moc .80 -> najmniejsze wykrywalne d = 0.38
Moc dla d = 0.40 przy n = 107 na grupę: 0.83
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- writexl (wersja 1.5.4): Ooms, J. (2025). writexl: Export data frames to Excel 'xlsx' format [R package]. https://doi.org/10.32614/CRAN.package.writexl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Czego najczęściej brakuje w raportach
- Liczebność bez uzasadnienia. „Zbadano 222 osoby” nie mówi, czy to dużo, czy mało. Podaj plan albo analizę wrażliwości.
- Cicha utrata uczestników. Różnica między liczbą osób w metodzie a liczbą stopni swobody w wynikach to pierwsza rzecz, którą zauważy recenzent.
- Rzetelność przepisana z podręcznika testu. JARS-Quant wymagają rzetelności wyników w badanej próbie.
- Brak informacji o miarach niewykorzystanych. Jeśli zebrano dziesięć skal, a opisano trzy, napisz o pozostałych.
- Samo p bez wielkości efektu i przedziału ufności. Każdy test powinien mieć oszacowanie efektu z CI.
- Analizy eksploracyjne przedstawione jak konfirmacyjne. Oddziel je nagłówkiem lub akapitem i nie nazywaj ich potwierdzeniem hipotez.
- Brak nazwy programu i wersji pakietów przy analizach złożonych – a często także przy prostych.
- Niespójne wartości p, przepisane ręcznie z wydruku.
Najczęstsze pytania
Czym różnią się standardy JARS od stylu APA?
Styl APA (podręcznik publikacyjny, 7. wydanie) określa formę tekstu: cytowania, bibliografię, nagłówki, tabele i zapis statystyk. Standardy JARS określają treść raportu, czyli informacje o metodzie, wynikach i dyskusji, które musi zawierać artykuł, aby można było ocenić i powtórzyć badanie. Badania ilościowe opisują standardy JARS-Quant, jakościowe – JARS-Qual.
Którą tabelę JARS-Quant zastosować do mojego badania?
Tabela 1 dotyczy każdego raportu z nowo zebranych danych. Do eksperymentu z losowym przydziałem dodaj Tabelę 2 i moduł A, do manipulacji bez losowania – Tabelę 2 i moduł B, do badań klinicznych także moduł C. Badania nieeksperymentalne opisuje Tabela 3, podłużne – Tabela 4, N-of-1 – Tabela 5, a replikacje – Tabela 6.
Jak opisać braki danych w artykule według APA?
Podaj odsetek braków (najlepiej w każdej grupie i dla każdej zmiennej), argumenty dotyczące ich mechanizmu (MCAR, MAR lub MNAR) oraz metodę postępowania, np. analizę przypadków kompletnych albo imputację wielokrotną. Porównanie osób z brakami i bez nich jest pomocne, ale nie dowodzi, że braki są losowe – warto dodać analizę wrażliwości.
Czy trzeba podawać rzetelność skali w swojej próbie, jeśli jest w podręczniku testu?
Tak. JARS-Quant zalecają podawanie rzetelności wyników uzyskanych w badanej próbie, bo rzetelność jest cechą wyników w konkretnej grupie, a nie samego narzędzia. Wartości z podręcznika możesz przytoczyć dodatkowo, opisując próbę, na której je policzono.
Co to jest schemat przepływu uczestników i kiedy go dodać?
To rysunek pokazujący, ile osób zaproszono, ile zakwalifikowano, przydzielono do grup, utracono i włączono do analizy na każdym etapie badania. JARS-Quant zalecają go zawsze, gdy to możliwe, a w eksperymentach i badaniach podłużnych jest praktycznie niezbędny. Liczby ze schematu muszą zgadzać się z liczebnościami i stopniami swobody w wynikach.
Powiązane hasła
Przeczytaj też
Jak opisać eksperyment ankietowy
Co napisać w metodzie i wynikach eksperymentu online: bodziec, losowanie, sprawdzenie manipulacji, schemat przepływu, efekt z CI i gotowe zdania APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikOpis metod statystycznych w pracy
Jak napisać podrozdział „Analiza statystyczna”: program, przygotowanie danych, założenia, testy dla hipotez, poziom istotności, korekty i gotowe wzory zdań.
Czytaj →Przygotowujesz artykuł do czasopisma stosującego standardy APA?
Sprawdzimy sekcje Metoda i Wyniki pod kątem JARS-Quant, uzupełnimy analizy i przygotujemy tabele, a także pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (2024). JARS–Quant Table 1: Information recommended for inclusion in manuscripts that report new data collections regardless of research design. APA Style. https://apastyle.apa.org/jars/quant-table-1.pdf ● Otwarty dostęp
- American Psychological Association. (b.d.). APA Style Journal Article Reporting Standards (APA Style JARS). APA Style. Pobrano 15 października 2026 z https://apastyle.apa.org/jars ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Levitt, H. M., Bamberg, M., Creswell, J. W., Frost, D. M., Josselson, R., & Suárez-Orozco, C. (2018). Journal article reporting standards for qualitative primary, qualitative meta-analytic, and mixed methods research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 26–46. https://doi.org/10.1037/amp0000151 ● Otwarty dostęp
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- van Doorn, J., van den Bergh, D., Böhm, U., Dablander, F., Derks, K., Draws, T., Etz, A., Evans, N. J., Gronau, Q. F., Haaf, J. M., Hinne, M., Kucharský, Š., Ly, A., Marsman, M., Matzke, D., Komarlu Narendra Gupta, A. R., Sarafoglou, A., Stefan, A., Voelkel, J. G., & Wagenmakers, E.-J. (2021). The JASP guidelines for conducting and reporting a Bayesian analysis. Psychonomic Bulletin & Review, 28(3), 813–826. https://doi.org/10.3758/s13423-020-01798-5 ● Otwarty dostęp
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apa2024jarsquant, author={{American Psychological Association}}, title={{JARS–Quant Table 1: Information recommended for inclusion in manuscripts that report new data collections regardless of research design}}, howpublished={APA Style}, year={2024}, url={https://apastyle.apa.org/jars/quant-table-1.pdf}}@misc{apandjars, author={{American Psychological Association}}, title={{APA Style Journal Article Reporting Standards (APA Style JARS)}}, howpublished={APA Style}, publisher={American Psychological Association}, url={https://apastyle.apa.org/jars}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{levitt2018journal, author={Levitt, Heidi M. and Bamberg, Michael and Creswell, John W. and Frost, David M. and Josselson, Ruthellen and Suárez-Orozco, Carola}, title={{Journal article reporting standards for qualitative primary, qualitative meta-analytic, and mixed methods research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={26--46}, doi={10.1037/amp0000151}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{vandoorn2021jasp, author={van Doorn, Johnny and van den Bergh, Don and Böhm, Udo and Dablander, Fabian and Derks, Koen and Draws, Tim and Etz, Alexander and Evans, Nathan J. and Gronau, Quentin F. and Haaf, Julia M. and Hinne, Max and Kucharský, Šimon and Ly, Alexander and Marsman, Maarten and Matzke, Dora and Komarlu Narendra Gupta, Akash R. and Sarafoglou, Alexandra and Stefan, Angelika and Voelkel, Jan G. and Wagenmakers, Eric-Jan}, title={{The JASP guidelines for conducting and reporting a Bayesian analysis}}, journal={Psychonomic Bulletin \& Review}, year={2021}, volume={28}, number={3}, pages={813--826}, doi={10.3758/s13423-020-01798-5}}@article{wilkinson1999statistical, author={Wilkinson, Leland and {Task Force on Statistical Inference}}, title={{Statistical methods in psychology journals: Guidelines and explanations}}, journal={American Psychologist}, year={1999}, volume={54}, number={8}, pages={594--604}, doi={10.1037/0003-066x.54.8.594}}