Po co plan analizy, skoro i tak wszystko policzysz?
Każde badanie zostawia badaczowi dziesiątki decyzji: którą miarę uznać za główną, kogo wykluczyć, co zrobić z wartościami odstającymi, czy dodać kowariantę, kiedy przestać zbierać dane. Każda z tych decyzji z osobna jest do obrony. Kłopot zaczyna się wtedy, gdy zapada po obejrzeniu danych – łatwo wtedy, często bez złej woli, wybrać wariant, który daje ładniejszy wynik. Simmons i in. (2011) pokazali w symulacjach i dwóch eksperymentach, że nieujawniona elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Wicherts i in. (2016) zebrali 34 takie stopnie swobody badacza – od niejasnej hipotezy po wybór kryteriów wnioskowania – w listę kontrolną, której można użyć także do oceny prerejestracji.
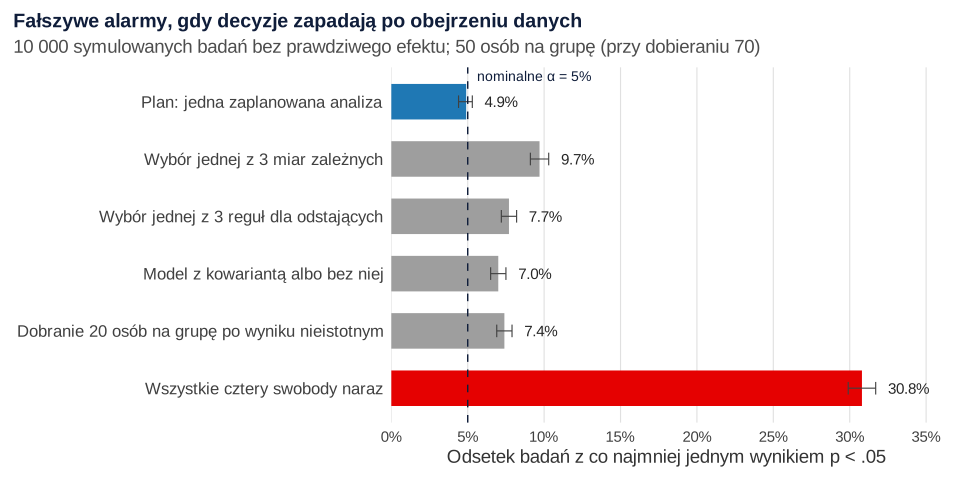
Rysunek 1 pokazuje skalę zjawiska na naszej symulacji. W każdym z 10 000 badań prawdziwego efektu nie było, więc każdy istotny wynik był błędem I rodzaju. Jedna zaplanowana analiza dała 4.9% fałszywych alarmów, czyli tyle, ile obiecuje poziom istotności α = .05. Wybór jednej z trzech miar zależnych podniósł ten odsetek do 9.7%, a cztery swobody stosowane naraz – do 30.8%.
Plan analizy statystycznej (ang. statistical analysis plan, SAP) zamyka te ścieżki, zanim pojawią się dane. Wagenmakers i in. (2012) proponują prosty podział: tylko analizy zapisane z góry zasługują na miano konfirmacyjnych i tylko dla nich zwykłe testy statystyczne zachowują swoją interpretację; pozostałe są eksploracyjne i tak trzeba je opisać. Nosek i in. (2018) ujmują to jako odróżnienie testowania przewidywań od dopasowywania wyjaśnień do znanych już wyników. Ta druga praktyka, przedstawiana jako hipoteza postawiona z góry, to HARKing, a wybieranie wariantu analizy dającego istotność – p-hacking. Plan nie zakazuje eksploracji ani zmian. Wymaga tylko, by czytelnik wiedział, które decyzje zapadły przed danymi, a które po nich.
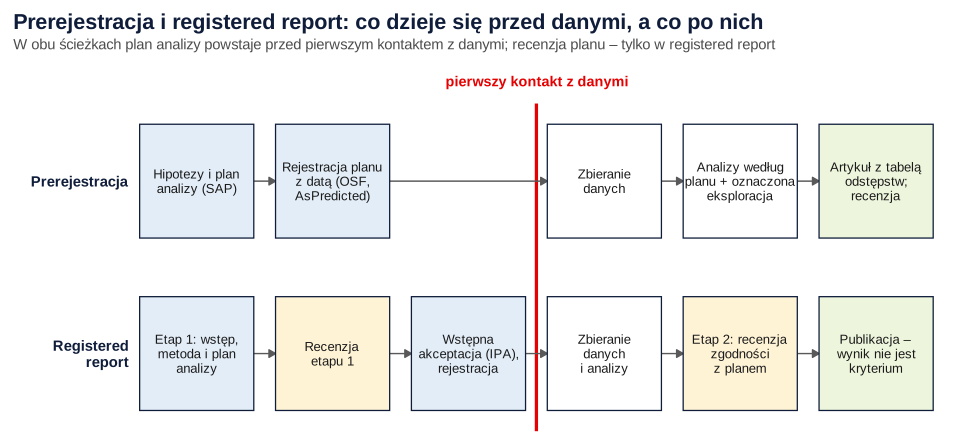
Plan analizy, prerejestracja i registered report – czym się różnią
Te trzy pojęcia często się myli, bo dotyczą tego samego dokumentu na różnych etapach jego życia.
| Pojęcie | Co to jest | Kto go ocenia przed badaniem | Co daje |
|---|---|---|---|
| Plan analizy statystycznej (SAP) | Szczegółowy opis hipotez, zmiennych, liczebności i analiz, napisany przed danymi | Zespół, czasem komisja etyczna lub grantodawca | Porządkuje decyzje; bywa częścią protokołu badania |
| Prerejestracja | Opatrzona datą, niezmienialna wersja planu złożona w publicznym rejestrze (np. OSF, AsPredicted) | Nikt – rejestr tylko utrwala plan | Dowód, które decyzje zapadły przed danymi |
| Registered report | Format artykułu, w którym recenzja wstępu, metody i planu analizy odbywa się przed zebraniem danych | Recenzenci i redakcja czasopisma | Decyzja o publikacji nie zależy od wyniku |
W badaniach klinicznych plan analizy ma długą tradycję. Gamble i in. (2017) uzgodnili w procedurze delfickiej – z udziałem statystyków, autorów wytycznych CONSORT i SPIRIT, redaktorów czasopism i regulatorów – minimalny zestaw 55 elementów, które powinien zawierać SAP badania klinicznego. W psychologii i naukach społecznych plan bywa krótszy, ale logika jest ta sama. Jeśli przygotowujesz artykuł do czasopisma medycznego, zobacz też wpis o statystyce w publikacji medycznej.
Dwanaście elementów planu analizy statystycznej
Tabela łączy elementy planu ze stopniami swobody z listy Wichertsa i in. (2016) – w nawiasach podajemy ich kody (T – hipotezy, D – projekt, C – zbieranie danych, A – analiza, R – raportowanie). Każdy element ilustrujemy jednym przykładem: fikcyjnym eksperymentem online, w którym sprawdzamy, czy 10-minutowe ćwiczenie samowspółczucia obniża lęk przed oceną w porównaniu z ćwiczeniem kontrolnym.
| Element planu | Co zapisać | Przykład |
|---|---|---|
| 1. Hipotezy (T2) | Kierunek efektu, zmienne, porównywane grupy; hipotezy główne oddzielnie od dodatkowych | H1: po ćwiczeniu samowspółczucia lęk przed oceną będzie niższy niż po ćwiczeniu kontrolnym |
| 2. Zmienne (D3, D4, A5–A7) | Definicję każdej zmiennej, pozycje, sposób liczenia wyniku | Lęk: średnia 6 pozycji (1–5), pozycje 2 i 5 odwrócone, wynik przy co najmniej 5 odpowiedziach |
| 3. Schemat (C1, C2) | Rodzaj schematu, przydział do warunków, pomiary i ich kolejność | Eksperyment, losowy przydział 1:1, pomiar lęku przed i po ćwiczeniu |
| 4. Liczebność (D6, D7, C4) | Najmniejszy interesujący efekt, analizę mocy, rezerwę, regułę zatrzymania | 133 osoby na grupę, rekrutacja 148 na grupę |
| 5. Wykluczenia (D5, A12) | Każde kryterium z progiem i kolejnością stosowania | Błędna odpowiedź na pytanie kontrolne, czas wypełnienia poniżej 120 s |
| 6. Braki danych (A1) | Regułę dla brakujących pozycji i całych zmiennych | Średnia z dostępnych pozycji (minimum 5 z 6) |
| 7. Obserwacje odstające (A4) | Definicję i decyzję podjętą z góry | Bez usuwania; analiza wrażliwości bez osób z |resztą| > 3 |
| 8. Założenia i plan B (A3) | Co sprawdzisz i co zrobisz, gdy założenie nie będzie spełnione | Stosunek wariancji reszt w grupach > 2 → błędy standardowe HC3 |
| 9. Model i kontrasty (A10, A13, A14) | Dokładny model, test, stronę testu, program | ANCOVA: lęk po ~ warunek + lęk przed, test dwustronny |
| 10. Korekty (A15) | Rodziny testów i metodę korekty | Korekta Holma dla dwóch hipotez dodatkowych |
| 11. Analizy wrażliwości i eksploracyjne (R6) | Listę analiz dodatkowych i ich status | Test Welcha bez kowarianty; moderacja przez płeć jako eksploracja |
| 12. Kryteria wnioskowania (A15) | Kiedy hipoteza jest potwierdzona, kiedy efektu nie ma, a kiedy wynik jest niejednoznaczny | p < .05 przy przewidywanym kierunku; równoważność, gdy 90% CI mieści się w ±0.30 pkt |
Hipotezy: kierunek, zmienne i test w jednym zdaniu
„Ćwiczenie wpłynie na lęk” to zła hipoteza do planu: nie mówi, w którą stronę, na jaki lęk, w porównaniu z czym ani jakim testem. Dobra hipoteza badawcza w planie ma cztery części: kierunek („niższy”), zmienną zależną z miarą („lęk przed oceną po zadaniu, średnia 6 pozycji”), porównanie („w porównaniu z ćwiczeniem kontrolnym”) i analizę („ANCOVA z lękiem wyjściowym jako kowariantą”). Kierunek hipotezy nie przesądza o stronie testu – zapisz osobno, czy testujesz dwustronnie, czy jednostronnie. Jak przejść od pytania badawczego do takiego zapisu, pokazujemy w poradniku pytania badawcze i hipotezy.
Wykluczenia, braki danych i obserwacje odstające
Te trzy elementy najczęściej rozjeżdżają się z praktyką. Claesen i in. (2021) przejrzeli 27 prerejestrowanych badań z czasopisma Psychological Science: tylko 2 nie odbiegały od planu, a odstępstwa – ujawnione i nieujawnione – dotyczyły głównie liczebności próby, kryteriów wykluczeń i analizy statystycznej. Dlatego przy wykluczeniach podawaj progi, a nie intencje. „Wykluczymy osoby nieuważne” nie wystarczy; „wykluczymy osoby, które błędnie odpowiedzą na pytanie kontrolne albo wypełnią ankietę w czasie krótszym niż 120 s” – tak. Wskaźniki nieuważnych odpowiedzi i ich progi omawiamy we wpisie o nieuważnych odpowiedziach w ankietach online.
Przy brakach danych zapisz regułę liczenia wyniku skali (np. średnia z co najmniej 5 z 6 pozycji) i próg, od którego zmienisz metodę – mechanizmy braków i imputację wielokrotną opisujemy w haśle braki danych MCAR, MAR i MNAR i w poradniku braki danych i imputacja wielokrotna w R. Obserwacje odstające to idealny przykład decyzji, którą łatwo dopasować do wyniku – na rysunku 1 sam wybór jednej z trzech reguł podniósł odsetek fałszywych alarmów do 7.7%. Regułę ustal z góry, a wariant alternatywny potraktuj jako analizę wrażliwości. Jak wybrać rozsądną regułę, piszemy w poradniku wartości odstające: jak je wykryć i co z nimi zrobić.
Założenia i plan B: reguły „jeśli…, to…”
Przewodnik OSF po rejestracjach zaleca zapisywanie decyzji warunkowych w postaci drzewa „jeśli…, to…”, np. co zrobisz, gdy założenia testu nie będą spełnione, a także przewidywanie możliwych odstępstw od planu (Center for Open Science, b.d.). Warunek musi być sprawdzalny: „jeśli stosunek wariancji reszt w grupach przekroczy 2, jako wynik główny podamy model z odpornymi błędami standardowymi HC3” – a nie „jeśli założenia będą naruszone”. Przy porównaniu dwóch grup bez kowarianty prostszym rozwiązaniem jest od razu test Welcha, który nie wymaga równości wariancji – wtedy plan B nie jest potrzebny.
Model, kontrasty i korekty
Zapisz model tak, by dało się go uruchomić: zmienna zależna, predyktory, kowarianty, interakcje, sposób kodowania grup, program i pakiet. W przykładzie hipotezę H1 testuje ANCOVA: lęk po zadaniu przewidywany przez warunek i lęk wyjściowy; interesuje nas współczynnik warunku, czyli skorygowana różnica średnich. Gdy hipotez jest kilka, określ rodziny testów i metodę korekty. W przykładzie hipoteza główna jest jedna i nie wymaga korekty, a dwie hipotezy dodatkowe (samokrytyka i nastrój) testujemy z korektą Holma – mniej konserwatywną odmianą korekty Bonferroniego.
Kryteria wnioskowania: co znaczy „potwierdzona”, a co „brak efektu”
Plan, który przewiduje tylko wynik „istotny”, nie mówi, co zrobisz z wynikiem nieistotnym. Tymczasem nieistotny wynik nie dowodzi braku efektu. Lakens i in. (2018) pokazują, jak to rozstrzygnąć testem równoważności TOST: określasz najmniejszy interesujący efekt (ang. smallest effect size of interest, SESOI) i sprawdzasz, czy możesz odrzucić efekty co najmniej tak duże. W przykładzie SESOI wynosi 0.30 punktu na skali 1–5, a reguła ma cztery wyjścia:
- H1 potwierdzona – współczynnik warunku jest ujemny, p < .05, a 90% przedział ufności nie mieści się w całości w granicach ±0.30;
- efekt istotny, ale mniejszy niż SESOI – p < .05, a 90% CI mieści się w granicach ±0.30;
- brak efektu co najmniej równego SESOI – p ≥ .05, a 90% CI mieści się w ±0.30;
- wynik niejednoznaczny – w pozostałych przypadkach (wtedy nie piszesz ani o efekcie, ani o jego braku).
Najlepszym testem takiej reguły jest kod napisany przed danymi i uruchomiony na danych symulowanych (przepis 3 w sekcji z kodem). Na danych z efektem równym SESOI reguła zwróciła „H1 potwierdzona” (b = −0.231, 95% CI [−0.399, −0.064], p = .007), a na danych bez efektu – „brak efektu co najmniej równego SESOI” (90% CI [−0.035, 0.218]). To nie są wyniki badania, tylko sprawdzenie, że plan da się wykonać. Co robić, gdy w prawdziwym badaniu hipoteza się nie potwierdzi, opisujemy we wpisie hipoteza się nie potwierdziła.
Liczebność próby: SESOI, moc i rezerwa na wykluczenia
Lakens (2022) opisuje sześć sposobów uzasadnienia liczebności próby – od zbadania (prawie) całej populacji, przez ograniczenia zasobów i analizę mocy a priori, po planowanie dokładności oszacowania – i podkreśla, że przy każdym trzeba wskazać, jakie wielkości efektu bierzesz pod uwagę. W przykładzie korzystamy z analizy mocy a priori dla SESOI. Różnica 0.30 punktu przy przewidywanym odchyleniu standardowym 0.75 to d = 0.40 (zob. d Cohena). Funkcja power.t.test w R zwraca dla testu dwustronnego (α = .05):
- moc .90 – 133 osoby na grupę (dokładnie 132.3),
- moc .80 – 100 osób na grupę (99.1).
Przy mocy .90 i zapasie 10% na wykluczenia rekrutujesz 148 osób na grupę, czyli 296 osób. Zapisz też regułę zatrzymania: zbieranie kończy się po 296 kompletnych ankietach albo w ustalonym dniu, bez analiz pośrednich. Dobieranie osób po nieistotnym wyniku to jedna z czterech swobód z rysunku 1 – sama podniosła odsetek fałszywych alarmów do 7.4%.
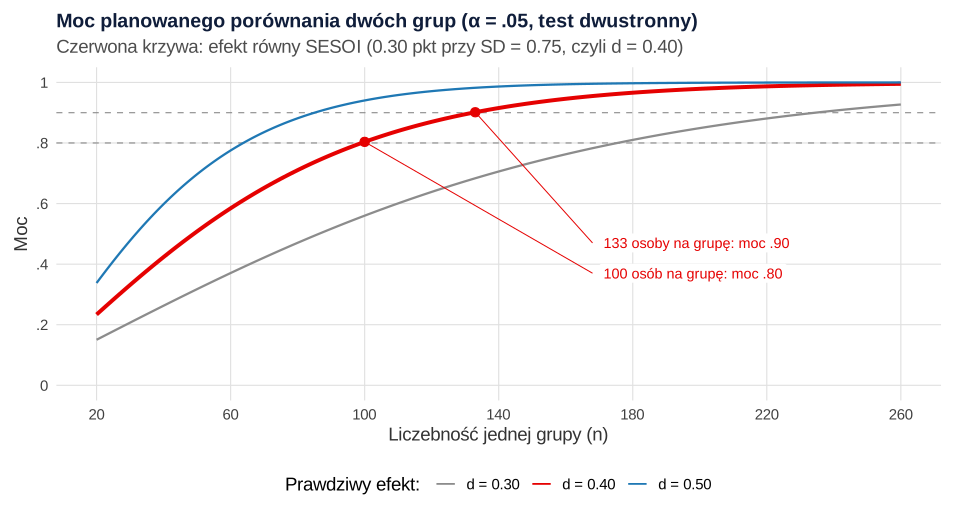
power.t.test.Rysunek 3 pokazuje też, co się stanie, jeśli prawdziwy efekt będzie inny niż SESOI. Przy 133 osobach na grupę moc wynosi .68 dla d = 0.30, .90 dla d = 0.40 i .98 dla d = 0.50. Dwa dodatki warto dopisać do planu:
- analizę wrażliwości – jaki efekt wykryjesz z mocą .80 przy liczebności, którą realnie zbierzesz. Przy 100 osobach na grupę jest to d = 0.40, przy 133 osobach – d = 0.34;
- moc planowanego modelu, a nie tylko testu t. Kowarianta silnie związana ze zmienną zależną zwiększa moc: w symulacji (5000 powtórzeń, korelacja pomiaru wstępnego z końcowym .50) ANCOVA osiągnęła moc .90 już przy 100 osobach na grupę i .97 przy 133. Ta sama symulacja pokazała, że przy 133 osobach na grupę i braku efektu test równoważności z granicami ±SESOI wykrywa równoważność w 97% przypadków.
Nie opieraj SESOI na wielkości efektu z małego badania pilotażowego – oszacowanie z kilkudziesięciu osób jest zbyt nieprecyzyjne, by na nim planować. Uzasadnij SESOI merytorycznie (jaka różnica ma praktyczne znaczenie) albo na podstawie metaanaliz. Więcej o uzasadnianiu liczebności piszemy w poradniku dobór liczebności próby, a o programie G*Power – w haśle analiza mocy a priori.
Wzór planu analizy statystycznej do skopiowania
Poniżej pełny plan dla przykładowego eksperymentu. Zastąp treść w nawiasach kwadratowych i przykładowe wartości własnymi. Ten sam wzór, z podpowiedziami do każdego punktu, tabelą hipotez i tabelą odstępstw, pobierzesz jako plik Word: plan-analizy-statystycznej-wzor.docx.
Status danych w chwili rejestracji: dane nie zostały zebrane.
1. Hipotezy. H1 (główna): osoby wykonujące 10-minutowe ćwiczenie samowspółczucia będą zgłaszać niższy lęk przed oceną po zadaniu niż osoby z grupy kontrolnej, przy kontroli lęku przed manipulacją. H2a i H2b (dodatkowe): w grupie ćwiczenia niższa będzie samokrytyka (H2a) i lepszy nastrój (H2b).
2. Schemat. Eksperyment z losowym przydziałem 1:1 do ćwiczenia samowspółczucia albo ćwiczenia kontrolnego; pomiar lęku przed manipulacją i po niej.
3. Zmienne. Zmienna niezależna: warunek (0 = kontrola, 1 = ćwiczenie). Zmienna zależna główna: lęk przed oceną po zadaniu – średnia 6 pozycji (1–5; pozycje 2 i 5 odwrócone), liczona przy co najmniej 5 odpowiedziach. Kowarianta: lęk przed manipulacją – średnia 3 pozycji (1–5). Zmienne dodatkowe: samokrytyka i nastrój (średnie pozycji, 1–5).
4. Liczebność. SESOI = 0.30 pkt (d = 0.40 przy SD = 0.75). Dla testu dwustronnego, alfa = .05 i mocy .90 potrzeba 133 osób na grupę (power.t.test w R). Z zapasem 10% na wykluczenia rekrutujemy 148 osób na grupę (razem 296). Zbieranie danych kończy się po 296 kompletnych ankietach albo [data], bez analiz pośrednich.
5. Wykluczenia (w tej kolejności): (a) błędna odpowiedź na pytanie kontrolne, (b) czas wypełnienia krótszy niż 120 s, (c) brak odpowiedzi na więcej niż 1 z 6 pozycji zmiennej zależnej, (d) brak kowarianty. Liczbę wykluczonych z każdego powodu podamy w diagramie przepływu.
6. Braki danych. Wynik skali to średnia z dostępnych pozycji (minimum 5 z 6). Jeśli z powodu braku kowarianty wykluczymy ponad 5% osób, dodamy analizę wrażliwości z imputacją wielokrotną.
7. Obserwacje odstające. Nie usuwamy osób z powodu wartości odstających (skala 1–5). W analizie wrażliwości powtórzymy H1 bez osób z resztą standaryzowaną powyżej |3|.
8. Założenia. Sprawdzimy jednorodność nachyleń (interakcja warunek × lęk przed) i rozkład reszt (wykres Q-Q). Jeśli stosunek wariancji reszt w grupach przekroczy 2, jako wynik główny podamy model z błędami standardowymi HC3.
9. Model. ANCOVA (MNK): lęk_po = b0 + b1 × warunek + b2 × lęk_przed. Test b1 dwustronny, alfa = .05. Raportujemy b1 z 95% CI oraz d = b1 / łączne SD zmiennej zależnej z 95% CI (bootstrap, 2000 prób). Program: R [wersja].
10. Korekty. H1 bez korekty; H2a i H2b z korektą Holma.
11. Analizy wrażliwości i eksploracyjne. Wrażliwość: (a) test Welcha bez kowarianty, (b) H1 bez wykluczeń 5a–5b, (c) H1 bez osób z |resztą| > 3. Eksploracja (bez wniosków konfirmacyjnych): moderacja efektu przez płeć i wiek.
12. Kryteria wnioskowania. H1 potwierdzona, jeśli b1 < 0, p < .05, a 90% CI dla b1 nie mieści się w całości w przedziale (−0.30; 0.30). Efekt istotny, ale mniejszy niż SESOI, jeśli b1 < 0, p < .05, a 90% CI mieści się w tym przedziale. Brak efektu co najmniej równego SESOI, jeśli p ≥ .05, a 90% CI mieści się w tym przedziale (test równoważności TOST, alfa = .05). W pozostałych przypadkach wynik uznamy za niejednoznaczny.
13. Odstępstwa. Każde odstępstwo od planu opiszemy w tabeli odstępstw w artykule lub w materiałach dodatkowych, z informacją, czy decyzję podjęto przed obejrzeniem danych, czy po nim.
Gdzie zarejestrować plan: OSF czy AsPredicted
Dwa popularne rejestry w psychologii to OSF Registries prowadzone przez Center for Open Science oraz AsPredicted. Tabela zestawia ich najważniejsze cechy według stron obu serwisów (stan na 16 października 2026 r.; Center for Open Science, b.d.; AsPredicted, b.d.).
| Cecha | OSF Registries | AsPredicted |
|---|---|---|
| Formularz | 14 szablonów, m.in. OSF Preregistration (najczęściej używany), Secondary Data Preregistration, szablon z ośmioma pytaniami AsPredicted | Osiem pytań; odpowiedź do 2900 znaków |
| Załączniki | Rejestracja z projektu zabiera jego pliki (do 5 GB) | Brak – sam tekst odpowiedzi |
| Współautorzy | Administratorzy zatwierdzają w ciągu 48 godzin, potem zatwierdzenie jest automatyczne | Współautorzy zatwierdzają prerejestrację przez e-mail |
| Widoczność | Publicznie od razu albo embargo do 4 lat | Prywatnie, dopóki autor nie utworzy pliku PDF ze stałym adresem |
| Recenzja z zaślepieniem | Embargo i zanonimizowany link tylko do odczytu | Anonimowa wersja PDF pod tym samym adresem |
| Identyfikator | DOI dla rejestracji publicznej | Numer i stały adres pliku PDF; kopia w Web Archive |
| Zmiany | Rejestracji nie można edytować ani usunąć; zmiany to aktualizacje z uzasadnieniem, wycofanie zostawia metadane | Po utworzeniu PDF nie da się zmienić ani usunąć prerejestracji |
AsPredicted pyta o: to, czy dane już zebrano, główną hipotezę, zmienną zależną i sposób jej pomiaru, warunki, dokładne analizy, definicję obserwacji odstających i reguły wykluczeń, liczebność oraz inne elementy, które chcesz zarejestrować (np. analizy dodatkowe). To dobry wybór dla krótkiego eksperymentu. Konto wymaga adresu e-mail instytucji – prywatny adres zostanie zaakceptowany tylko wtedy, gdy podasz artykuł, w którym go opublikowano (AsPredicted, b.d.). OSF lepiej sprawdzi się przy złożonym planie z załącznikami – kodem analizy, materiałami, obliczeniami mocy. Ma też osobne szablony dla danych wtórnych, przeglądów systematycznych i metaanaliz (zob. przegląd systematyczny i PRISMA) oraz badań jakościowych. Jeśli nie wiesz, który szablon wybrać, OSF Preregistration opisuje sam przewodnik jako standardowy, wszechstronny formularz ogólnego przeznaczenia (Center for Open Science, b.d.).
Prerejestracja na OSF krok po kroku
- Przygotuj projekt OSF (opcjonalnie), z planem analizy, kodem i materiałami. Rejestracja założona z projektu zabierze jego pliki – do 5 GB.
- Rozpocznij rejestrację na stronie „My Registrations” przyciskiem „Add a Registration”. Zaznacz, czy masz już projekt, i wybierz szablon.
- Uzupełnij metadane i odpowiedzi. Sekcja metadanych (tytuł, opis, autorzy, licencja, afiliacje, dziedziny, tagi) jest taka sama we wszystkich szablonach. Szkic zapisuje się automatycznie, a link do niego przychodzi e-mailem.
- Sprawdź stronę „Review” i kliknij „Register”. Wybierz, czy rejestracja ma być publiczna od razu (wtedy dostaje DOI), czy objęta embargiem – najwyżej do 4 lat.
- Zatwierdź. Wszyscy administratorzy dostają e-mail i mają 48 godzin na zatwierdzenie lub odrzucenie; po tym czasie rejestracja zostaje zatwierdzona automatycznie. Odrzucenie przez jednego administratora przywraca szkic.
- Do recenzji z zaślepieniem usuń dane identyfikujące z metadanych i plików, wybierz embargo i utwórz zanonimizowany link tylko do odczytu.
Złożonej rejestracji nie można edytować ani usunąć. Gdy coś zmienia się przed analizą, administrator może złożyć aktualizację z obowiązkowym uzasadnieniem; przewodnik zastrzega, że aktualizacje powinny dotyczyć zdarzeń, na które nie miałeś wpływu, albo nieoczekiwanych anomalii, a plików nie da się już dodać ani usunąć. Wycofanie usuwa treść, ale zostawia tytuł, autorów, daty, DOI i uzasadnienie wycofania (Center for Open Science, b.d.).
Registered report: recenzja przed zebraniem danych
W registered report rękopis przechodzi recenzję dwa razy. W etapie 1 recenzenci oceniają pytanie badawcze, metodę i plan analizy, zanim powstaną dane. Dobry protokół otrzymuje wstępną akceptację (ang. in-principle acceptance, IPA). W etapie 2 autor dopisuje wyniki i dyskusję, a recenzenci sprawdzają, czy wykonał to, co obiecał. Według strony Center for Open Science o registered reports (stan na 16 października 2026 r.) format stosuje ponad 300 czasopism, m.in. Cortex, Nature Human Behaviour, Psychological Science i Royal Society Open Science. Działa też platforma Peer Community In Registered Reports. Wstępnej akceptacji nie cofa się z powodu wyników, a jedynie z powodu problemów z jakością, odejścia od zarejestrowanego protokołu albo nieusuwalnych problemów z jasnością raportu. Zaakceptowany protokół rejestruje się na OSF w szablonie Registered Report Protocol Preregistration – dopiero po IPA (Center for Open Science, b.d.).
Skutek widać w danych. Scheel i in. (2021) porównali 71 registered reports z losową próbą 152 standardowych artykułów psychologicznych: pierwsza testowana hipoteza była potwierdzona w 96% standardowych artykułów i tylko w 44% registered reports. Autorzy wiążą tę różnicę z mniejszym efektem szuflady i mniejszą inflacją błędu I rodzaju. Registered report szczególnie opłaca się w doktoracie (wynik nie decyduje o publikacji), w replikacjach i przy hipotezach, które mogą się nie potwierdzić. Jak wpleść taki artykuł w harmonogram rozprawy, opisujemy we wpisie analiza statystyczna w doktoracie.
Odstępstwa od planu: tabela i gotowe zdania
Odstępstwa są normą, nie wyjątkiem. Willroth i Atherton (2024) przypominają, że większość odstępstw od prerejestracji w psychologii nie jest raportowana albo jest raportowana bez systemu, i proponują standardowy, przejrzysty sposób ich opisu, opracowany m.in. na podstawie ankiety wśród 34 redaktorów czasopism. Nosek i in. (2019) dodają, że podejmowanie decyzji przed analizą wymaga wprawy, a uczciwy raport musi szanować zarówno plan, jak i to, co faktycznie się wydarzyło. Prerejestracja z opisanymi odstępstwami jest wiarygodniejsza niż prerejestracja, której rzekomo nic nie zmieniło.
W praktyce najlepiej sprawdza się tabela w materiałach dodatkowych, w której każde odstępstwo ma jeden wiersz:
| Nr | Element planu | Plan | Wykonanie | Powód | Przed danymi czy po? | Wpływ na wnioski |
|---|---|---|---|---|---|---|
| 1 | Wykluczenia (5b) | Czas < 120 s | Czas < 90 s | Pilotaż nowej wersji platformy: uważne wypełnienie trwało co najmniej 95 s | Przed (dane pilotażowe spoza próby) | H1 podano dla obu progów |
| 2 | Liczebność (4) | 296 kompletnych ankiet | 281 ankiet | Koniec okresu rekrutacji w panelu | Przed analizą | Po wykluczeniach 126 osób na grupę; moc dla SESOI spadła z .90 do .89 |
Prerejestracja analiz danych wtórnych
Prerejestrować da się także analizę danych, które już istnieją – z dużych badań panelowych, z repozytoriów albo z własnego wcześniejszego projektu. Problem polega na tym, że hipotezy i analizy mogą być już skażone wiedzą o danych. Van den Akker i in. (2021) przygotowali na tę sytuację szablon z 25 pytaniami, komentarzami i przykładem. Szablon wymaga m.in.:
- dat pobrania danych i pierwszego dostępu do nich, osobno dla każdego autora;
- opisu wcześniejszej wiedzy o zbiorze – z własnych analiz, publikacji, książek kodowych – także osobno dla każdego autora;
- listy publikacji i prac wykonanych na tym zbiorze;
- informacji o brakach danych i wagach próby.
Jeśli możesz, zaślep się na dane: autorzy szablonu podają jako przykłady dodanie losowego szumu do zmiennej zależnej albo zmianę etykiet grup przez inną osobę. Na OSF odpowiada temu szablon Secondary Data Preregistration (Center for Open Science, b.d.). Najważniejsza jest szczerość: prerejestracja analizy danych, które już widziałeś, ma wartość tylko wtedy, gdy opisuje, co dokładnie widziałeś.
Mity o prerejestracji
| Mit | Fakt |
|---|---|
| „Prerejestracja zabrania analiz eksploracyjnych.” | Nie zabrania – wymaga, by je tak nazwać (Wagenmakers i in., 2012). Eksploracja oznaczona jako eksploracja to normalna część artykułu. |
| „Odstępstwo od planu unieważnia badanie.” | Nie unieważnia, jeśli jest opisane i uzasadnione (Willroth i Atherton, 2024). Nieujawnione odstępstwa są problemem, ujawnione – informacją. |
| „Plan musi przewidzieć wszystko.” | Nie musi. Wystarczą jasne reguły dla kluczowych decyzji i reguły „jeśli…, to…” dla przewidywalnych problemów (Center for Open Science, b.d.). |
| „Prerejestracja to to samo co registered report.” | Prerejestrację składasz sam, bez recenzji; registered report przechodzi recenzję przed zebraniem danych i daje wstępną akceptację. |
| „Po zebraniu danych jest już za późno.” | Na prerejestrację analizy przed jej wykonaniem nie jest za późno – trzeba tylko uczciwie opisać, co już wiesz o danych (Van den Akker i in., 2021). |
| „Prerejestracja gwarantuje dobre badanie.” | Nie gwarantuje. Słaba teoria albo zły pomiar pozostaną słabe. Prerejestracja pozwala odróżnić testowanie przewidywań od wyjaśnień dopasowanych po fakcie (Nosek i in., 2018) – nie poprawia samego badania. |
Jak opisać prerejestrację w artykule – wzory zdań
W części „Metoda” podaj link do rejestracji, datę, status danych w chwili rejestracji i informację o odstępstwach. W wynikach oddziel analizy konfirmacyjne od eksploracyjnych nagłówkami.
Brak uzasadnienia liczebności, nieujawnione odstępstwa i analizy eksploracyjne opisane jak konfirmacyjne należą do typowych zarzutów recenzentów – omawiamy je we wpisie o najczęstszych zarzutach recenzentów do statystyki, a wzory odpowiedzi znajdziesz w tekście odpowiedź recenzentom w sprawach statystycznych. Gdy plan zostanie wykonany, następnym krokiem jest pakiet replikacyjny z danymi i kodem, który pozwoli innym sprawdzić, że analizy przebiegły zgodnie z rejestracją.
Przykład w R: symulacja, moc i plan zapisany jako kod
Kod odtwarza wszystkie liczby z tekstu oraz rysunki 1 i 3. Przepisy są niezależne – każdy uruchomisz w osobnej sesji R. Przepis 1 symuluje 10 000 badań i trwa około 20 sekund, pozostałe – kilka sekund. Przepis 3 to wzór, jak zapisać plan analizy w postaci kodu i sprawdzić go, zanim powstaną prawdziwe dane.
1. Fałszywe alarmy przy nieujawnionej elastyczności (rysunek 1)
R
# B35 – przepis 1: ile fałszywych alarmów daje nieujawniona elastyczność analizy?
# Wpis: /blog/plan-analizy-statystycznej-prerejestracja/ (rysunek 1 i liczby w sekcji „Po co plan”)
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b35-1-elastycznosc-symulacja.R
# Dane symulowane: dwie grupy, prawdziwy efekt = 0 (każdy istotny wynik to fałszywy alarm).

set.seed(3535)
R <- 10000                      # liczba symulowanych badań
n1 <- 50; n2 <- 70              # osób na grupę: plan i „dobieranie” po nieistotnym wyniku

# p dla efektu grupy w regresji MNK (z kowariantą albo bez)
p_grupy <- function(y, g, x = NULL) {
  X <- if (is.null(x)) cbind(1, g) else cbind(1, g, x)
  fit <- lm.fit(X, y)
  df <- length(y) - ncol(X)
  se <- sqrt(sum(fit$residuals^2) / df * solve(crossprod(X))[2, 2])
  2 * pt(-abs(fit$coefficients[2] / se), df)
}

# Jedno badanie: 3 miary zależne × 3 reguły dla odstających × model z kowariantą lub bez,
# liczone przy 50 i (po dobraniu osób) przy 70 osobach na grupę
jedno_badanie <- function() {
  n <- 2 * n2
  g <- rep(0:1, each = n2)
  x <- rnorm(n)                                    # pomiar wyjściowy (kowarianta)
  e <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, 1/3, 1/3, 1), 2))
  dv <- cbind(dv1 = 0.5 * x + sqrt(0.75) * e[, 1], # dwie miary zależne, r = .50
              dv2 = 0.5 * x + sqrt(0.75) * e[, 2])
  dv <- cbind(dv, dv3 = rowMeans(dv))              # trzecia „miara”: średnia obu
  wynik <- array(NA, c(2, 3, 3, 2), dimnames = list(c("n50", "n70"), colnames(dv),
                 c("brak", "z2.5", "z2"), c("bez", "z_kow")))
  for (k in 1:2) {
    w <- if (k == 1) c(1:n1, n2 + 1:n1) else 1:n                 # osoby w analizie
    for (j in 1:3) {
      y <- dv[w, j]; z <- abs(as.numeric(scale(y)))
      for (r in 1:3) {
        zost <- switch(r, rep(TRUE, length(y)), z <= 2.5, z <= 2)  # reguła dla odstających
        wynik[k, j, r, 1] <- p_grupy(y[zost], g[w][zost])
        wynik[k, j, r, 2] <- p_grupy(y[zost], g[w][zost], x[w][zost])
      }
    }
  }
  istotny <- wynik < .05
  c(plan        = istotny["n50", "dv1", "brak", "bez"],
    miary       = any(istotny["n50", , "brak", "bez"]),
    odstajace   = any(istotny["n50", "dv1", , "bez"]),
    kowarianta  = any(istotny["n50", "dv1", "brak", ]),
    dobieranie  = any(istotny[, "dv1", "brak", "bez"]),
    wszystko    = any(istotny))
}

sym <- replicate(R, jedno_badanie())
odsetek <- rowMeans(sym)
se_mc <- sqrt(odsetek * (1 - odsetek) / R)        # błąd Monte Carlo
tab <- data.frame(strategia = names(odsetek),
                  falszywe_alarmy_proc = round(100 * odsetek, 1),
                  dolna = round(100 * (odsetek - 1.96 * se_mc), 1),
                  gorna = round(100 * (odsetek + 1.96 * se_mc), 1))
print(tab, row.names = FALSE)
saveRDS(tab, "b35-1-elastycznosc.rds")         # do rysunku 1
Wynik w R
  strategia falszywe_alarmy_proc dolna gorna
       plan                  4.9   4.4   5.3
      miary                  9.7   9.1  10.3
  odstajace                  7.7   7.2   8.2
 kowarianta                  7.0   6.5   7.5
 dobieranie                  7.4   6.9   7.9
   wszystko                 30.8  29.9  31.7
2. Liczebność, moc, analiza wrażliwości i moc testu równoważności (rysunek 3)
R
# B35 – przepis 2: liczebność próby dla planu analizy (SESOI, moc, rezerwa, analiza wrażliwości)
# Wpis: /blog/plan-analizy-statystycznej-prerejestracja/ (sekcja „Liczebność” i rysunek 3)
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b35-2-liczebnosc.R

# SESOI w jednostkach skali: 0.30 punktu (skala 1–5), przewidywane SD = 0.75  ->  d = 0.40
sesoi_pkt <- 0.30; sd_zak <- 0.75
d_sesoi <- sesoi_pkt / sd_zak
d_sesoi

# 1. Test dla dwóch grup, dwustronny, alfa = .05: ile osób na grupę?
n90 <- power.t.test(delta = d_sesoi, sd = 1, sig.level = .05, power = .90)$n
n80 <- power.t.test(delta = d_sesoi, sd = 1, sig.level = .05, power = .80)$n
c(n_moc_90 = n90, n_moc_80 = n80)
n_grupa <- ceiling(n90)                       # 133 osoby na grupę po wykluczeniach
n_rekrutacja <- ceiling(n_grupa / 0.90)       # rezerwa na 10% wykluczeń
c(n_grupa = n_grupa, n_rekrutacja = n_rekrutacja, razem = 2 * n_rekrutacja)

# 2. Moc przy innych prawdziwych efektach (ta sama liczebność)
sapply(c(d0.30 = 0.30, d0.40 = 0.40, d0.50 = 0.50), function(d)
  round(power.t.test(n = n_grupa, delta = d, sd = 1, sig.level = .05)$power, 3))

# 3. Analiza wrażliwości: jaki efekt wykryjesz z mocą .80, jeśli zbierzesz mniej osób?
sapply(c(n100 = 100, n133 = n_grupa), function(n)
  round(power.t.test(n = n, sd = 1, sig.level = .05, power = .80)$delta, 3))

# Przykład z tabeli odstępstw: zebrano 281 zamiast 296 ankiet (nadal 10% wykluczeń)
n_odst <- floor(281 * 0.90 / 2)
c(n_na_grupe = n_odst, moc = round(power.t.test(n = n_odst, delta = d_sesoi, sd = 1)$power, 3))

# 4. Planowany model to ANCOVA z pomiarem wstępnym (r = .50) – moc z symulacji
set.seed(4040)
moc_ancova <- function(n, d, kor = 0.50, R = 5000) {
  mean(replicate(R, {
    g <- rep(0:1, each = n)
    przed <- rnorm(2 * n)
    po <- kor * przed + sqrt(1 - kor^2) * rnorm(2 * n) - d * g   # ćwiczenie obniża lęk
    summary(lm(po ~ g + przed))$coefficients["g", 4] < .05
  }))
}
c(ancova_n100 = moc_ancova(100, d_sesoi), ancova_n133 = moc_ancova(n_grupa, d_sesoi))

# 5. Moc testu równoważności (TOST, granice ±SESOI) w ANCOVA, gdy prawdziwy efekt = 0
moc_tost <- function(n, granica, kor = 0.50, R = 5000) {
  mean(replicate(R, {
    g <- rep(0:1, each = n)
    przed <- rnorm(2 * n)
    po <- kor * przed + sqrt(1 - kor^2) * rnorm(2 * n)
    ci90 <- confint(lm(po ~ g + przed), level = .90)["g", ]
    ci90[1] > -granica && ci90[2] < granica
  }))
}
c(tost_n133 = moc_tost(n_grupa, d_sesoi))
Wynik w R
[1] 0.4
 n_moc_90  n_moc_80
132.31056  99.08057
     n_grupa n_rekrutacja        razem
         133          148          296
d0.30 d0.40 d0.50
0.684 0.901 0.982
 n100  n133
0.398 0.345
n_na_grupe        moc
   126.000      0.885
ancova_n100 ancova_n133
     0.8952      0.9662
tost_n133
   0.9658
3. Plan zapisany jako kod: reguła decyzyjna na danych symulowanych
R
# B35 – przepis 3: plan analizy zapisany jako kod i sprawdzony na danych symulowanych
# Wpis: /blog/plan-analizy-statystycznej-prerejestracja/ (sekcja „Kryteria wnioskowania” i kod)
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b35-3-plan-jako-kod.R
# Dane symulowane służą wyłącznie do sprawdzenia kodu – to nie są wyniki badania.

options(width = 110)
sesoi <- 0.30                                  # najmniejszy interesujący efekt: 0.30 pkt (skala 1–5)

# Reguła decyzyjna z planu (test dwustronny, alfa = .05; równoważność: 90% CI w ±SESOI)
decyzja <- function(b, p, ci90) {
  istotny <- p < .05
  rownowazny <- ci90[1] > -sesoi && ci90[2] < sesoi
  if (istotny && b < 0 && !rownowazny) return("H1 potwierdzona")
  if (istotny && b < 0 && rownowazny)  return("efekt istotny, ale mniejszy niż SESOI")
  if (istotny && b > 0)                return("efekt przeciwny do przewidywanego")
  if (!istotny && rownowazny)          return("brak efektu co najmniej równego SESOI")
  "wynik niejednoznaczny"
}

# Analiza konfirmacyjna z planu: ANCOVA (lęk po ~ warunek + lęk przed) i korekta Holma dla H2a–H2b
analiza_planowana <- function(d) {
  m <- lm(lek_po ~ warunek + lek_przed, data = d)
  b <- unname(coef(m)["warunek"])
  p <- summary(m)$coefficients["warunek", 4]
  ci95 <- confint(m)["warunek", ]; ci90 <- confint(m, level = .90)["warunek", ]
  p_h2 <- c(H2a = summary(lm(samokrytyka ~ warunek + lek_przed, data = d))$coefficients["warunek", 4],
            H2b = summary(lm(nastroj ~ warunek + lek_przed, data = d))$coefficients["warunek", 4])
  list(H1 = data.frame(b = round(b, 3), CI95 = sprintf("[%.3f, %.3f]", ci95[1], ci95[2]),
                       p = round(p, 4), CI90 = sprintf("[%.3f, %.3f]", ci90[1], ci90[2]),
                       decyzja = decyzja(b, p, ci90)),
       H2_holm = round(p.adjust(p_h2, method = "holm"), 4))
}

# Generator danych testowych: 133 osoby na grupę, lęk na skali 1–5 (M = 3.0, SD = 0.75)
symuluj <- function(efekt, n = 133) {
  warunek <- rep(0:1, each = n)
  z_przed <- rnorm(2 * n)
  z_po <- 0.5 * z_przed + sqrt(0.75) * rnorm(2 * n)
  ogr <- function(x) pmin(pmax(x, 1), 5)
  data.frame(warunek,
             lek_przed   = ogr(3.0 + 0.75 * z_przed),
             lek_po      = ogr(3.0 + 0.75 * z_po + efekt * warunek),
             samokrytyka = ogr(3.2 + 0.70 * rnorm(2 * n) + efekt / 2 * warunek),
             nastroj     = ogr(3.4 + 0.70 * rnorm(2 * n) - efekt / 2 * warunek))
}

set.seed(2026)
cat("Scenariusz A: prawdziwy efekt = -0.30 pkt (równy SESOI)\n")
print(analiza_planowana(symuluj(efekt = -0.30)))
cat("\nScenariusz B: prawdziwy efekt = 0\n")
print(analiza_planowana(symuluj(efekt = 0)))
Wynik w R
Scenariusz A: prawdziwy efekt = -0.30 pkt (równy SESOI)
$H1
       b             CI95     p             CI90         decyzja
1 -0.231 [-0.399, -0.064] 0.007 [-0.372, -0.091] H1 potwierdzona

$H2_holm
   H2a    H2b
0.0221 0.1420


Scenariusz B: prawdziwy efekt = 0
$H1
      b            CI95      p            CI90                               decyzja
1 0.092 [-0.059, 0.242] 0.2321 [-0.035, 0.218] brak efektu co najmniej równego SESOI

$H2_holm
H2a H2b
  1   1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2, a plik Word z wzorem planu – w pakietach officer i flextable. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents [R package]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting [R package]. https://doi.org/10.32614/CRAN.package.flextable
Najczęstsze błędy w planach analizy
- Hipoteza bez kierunku i bez testu. „Zbadamy związek X z Y” nie ogranicza żadnej decyzji.
- Kilka miar zależnych bez wskazania głównej. To najprostsza droga do fałszywego alarmu – na rysunku 1 podwoiła ich odsetek.
- Wykluczenia opisane intencją, a nie progiem. „Usuniemy osoby nieuważne” pozwala dobrać próg do wyniku.
- Liczebność bez uzasadnienia albo „moc post hoc”. Moc liczy się przed badaniem, dla efektu, który ma znaczenie, a nie z wyniku, który już masz.
- Brak reguły zatrzymania. Zaglądanie do danych i dobieranie osób po nieistotnym wyniku podnosi odsetek fałszywych alarmów.
- Brak kryterium „efektu nie ma”. Bez SESOI i testu równoważności nieistotny wynik zostanie niejednoznaczny.
- Plan, którego nie da się uruchomić. Zanim zarejestrujesz plan, napisz kod analizy i sprawdź go na danych symulowanych.
- Odstępstwa ukryte w tekście. Każde opisz w tabeli – także te, które wydają się drobne.
Lista kontrolna przed rejestracją
- Każda hipoteza ma kierunek, zmienną zależną z miarą, porównanie i test.
- Jest jedna zmienna zależna główna; pozostałe są oznaczone jako dodatkowe.
- Liczebność ma uzasadnienie: SESOI, analizę mocy z parametrami, rezerwę na wykluczenia i regułę zatrzymania.
- Wykluczenia, braki danych i obserwacje odstające mają progi i kolejność.
- Model jest zapisany jako kod, sprawdzony na danych symulowanych.
- Korekty dla wielu porównań obejmują jasno określone rodziny testów.
- Kryteria wnioskowania obejmują wynik „potwierdzona”, „brak efektu” i „niejednoznaczny”.
- Analizy wrażliwości i eksploracyjne są wymienione z nazwy.
- Przy danych wtórnych opisano daty dostępu i wcześniejszą wiedzę każdego autora.
- Wszyscy współautorzy przeczytali plan, a w artykule jest miejsce na tabelę odstępstw.
Jeśli chcesz, by plan przed rejestracją przejrzała niezależna osoba – sprawdziła model, policzyła moc symulacją dla Twojego schematu albo napisała kod analizy do przetestowania – zajrzyj do oferty analiz statystycznych dla badaczy. Decyzje merytoryczne i odpowiedzialność za plan zostają po stronie autorów.
Najczęstsze pytania
Co powinien zawierać plan analizy statystycznej (SAP)?
Hipotezy z kierunkiem, definicje zmiennych i sposób liczenia wyników, schemat badania, liczebność z uzasadnieniem i regułą zatrzymania, reguły wykluczeń, postępowanie z brakami danych i obserwacjami odstającymi, sprawdzanie założeń z planem B, dokładny model, korekty dla wielu porównań, analizy wrażliwości i eksploracyjne oraz kryteria wnioskowania, np. najmniejszy interesujący efekt (SESOI). W badaniach klinicznych minimalny zestaw obejmuje 55 elementów (Gamble i in., 2017).
Czym różni się prerejestracja od registered report?
Prerejestrację składasz sam w publicznym rejestrze (np. OSF, AsPredicted) – nikt jej nie recenzuje, ale data dowodzi, które decyzje zapadły przed danymi. W registered report plan przechodzi recenzję w czasopiśmie przed zebraniem danych, a dobry protokół dostaje wstępną akceptację, której nie cofa się z powodu wyników.
Ile pytań ma formularz AsPredicted i czym różni się od OSF?
AsPredicted ma osiem pytań (m.in. o hipotezę, zmienną zależną, warunki, analizy, wykluczenia i liczebność), a odpowiedź może mieć do 2900 znaków. OSF Registries oferuje 14 szablonów, pozwala dołączyć pliki projektu (do 5 GB), objąć rejestrację embargiem do 4 lat i nadaje DOI rejestracji publicznej (AsPredicted, b.d.; Center for Open Science, b.d.).
Czy można prerejestrować analizę danych, które już zebrano?
Tak, jeśli analizy jeszcze nie wykonano. Trzeba wtedy uczciwie opisać, kto i kiedy miał dostęp do danych oraz co każdy autor już o nich wie. Służy do tego szablon Van den Akkera i in. (2021) z 25 pytaniami, a na OSF szablon Secondary Data Preregistration.
Co zrobić, gdy trzeba odstąpić od prerejestrowanego planu?
Opisz odstępstwo: co zaplanowano, co zrobiono, dlaczego, czy decyzję podjęto przed obejrzeniem danych i jak wpływa na wnioski – najlepiej w tabeli w materiałach dodatkowych. Przed analizą na OSF możesz złożyć aktualizację rejestracji z uzasadnieniem. Odstępstwa są częste; problemem są te nieujawnione (Willroth i Atherton, 2024).
Powiązane hasła
Przeczytaj też
Pakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →Chcesz, by ktoś sprawdził plan analizy przed rejestracją?
Sprawdzimy model, policzymy moc symulacją dla Twojego schematu i pomożemy doprecyzować reguły wykluczeń, a decyzje i odpowiedzialność za plan pozostaną po Twojej stronie.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- AsPredicted. (b.d.). Help. Pobrano 16 października 2026 z https://aspredicted.org/help ● Otwarty dostęp
- Center for Open Science. (b.d.). Welcome to registrations & preregistrations! OSF Support. Pobrano 16 października 2026 z https://help.osf.io/article/229-select-a-registration-template ● Otwarty dostęp
- Claesen, A., Gomes, S., Tuerlinckx, F., & Vanpaemel, W. (2021). Comparing dream to reality: An assessment of adherence of the first generation of preregistered studies. Royal Society Open Science, 8(10), Article 211037. https://doi.org/10.1098/rsos.211037 ● Otwarty dostęp
- Gamble, C., Krishan, A., Stocken, D., Lewis, S., Juszczak, E., Doré, C., Williamson, P. R., Altman, D. G., Montgomery, A., Lim, P., Berlin, J., Senn, S., Day, S., Barbachano, Y., & Loder, E. (2017). Guidelines for the content of statistical analysis plans in clinical trials. JAMA, 318(23), 2337–2343. https://doi.org/10.1001/jama.2017.18556 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Nosek, B. A., Beck, E. D., Campbell, L., Flake, J. K., Hardwicke, T. E., Mellor, D. T., van ’t Veer, A. E., & Vazire, S. (2019). Preregistration is hard, and worthwhile. Trends in Cognitive Sciences, 23(10), 815–818. https://doi.org/10.1016/j.tics.2019.07.009 ● Otwarty dostęp: pełny tekst
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Scheel, A. M., Schijen, M. R. M. J., & Lakens, D. (2021). An excess of positive results: Comparing the standard psychology literature with registered reports. Advances in Methods and Practices in Psychological Science, 4(2), Article 25152459211007467. https://doi.org/10.1177/25152459211007467 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Van den Akker, O. R., Weston, S., Campbell, L., Chopik, B., Damian, R., Davis-Kean, P., Hall, A., Kosie, J., Kruse, E., Olsen, J., Ritchie, S., Valentine, K. D., Van 't Veer, A., & Bakker, M. (2021). Preregistration of secondary data analysis: A template and tutorial. Meta-Psychology, 5. https://doi.org/10.15626/mp.2020.2625 ● Otwarty dostęp
- Wagenmakers, E.-J., Wetzels, R., Borsboom, D., van der Maas, H. L. J., & Kievit, R. A. (2012). An agenda for purely confirmatory research. Perspectives on Psychological Science, 7(6), 632–638. https://doi.org/10.1177/1745691612463078
- Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, Article 1832. https://doi.org/10.3389/fpsyg.2016.01832 ● Otwarty dostęp
- Willroth, E. C., & Atherton, O. E. (2024). Best laid plans: A guide to reporting preregistration deviations. Advances in Methods and Practices in Psychological Science, 7(1), Article 25152459231213802. https://doi.org/10.1177/25152459231213802 ● Otwarty dostęp
Cytowania BibTeX
@misc{aspredictednd, author={{AsPredicted}}, title={{Help}}, url={https://aspredicted.org/help}}@misc{cosndrejestracje, author={{Center for Open Science}}, title={{Welcome to registrations \& preregistrations!}}, howpublished={OSF Support}, url={https://help.osf.io/article/229-select-a-registration-template}}@article{claesen2021comparing, author={Claesen, Aline and Gomes, Sara and Tuerlinckx, Francis and Vanpaemel, Wolf}, title={{Comparing dream to reality: An assessment of adherence of the first generation of preregistered studies}}, journal={Royal Society Open Science}, year={2021}, volume={8}, number={10}, eid={211037}, doi={10.1098/rsos.211037}}@article{gamble2017guidelines, author={Gamble, Carrol and Krishan, Ashma and Stocken, Deborah and Lewis, Steff and Juszczak, Edmund and Doré, Caroline and Williamson, Paula R. and Altman, Douglas G. and Montgomery, Alan and Lim, Pilar and Berlin, Jesse and Senn, Stephen and Day, Simon and Barbachano, Yolanda and Loder, Elizabeth}, title={{Guidelines for the content of statistical analysis plans in clinical trials}}, journal={JAMA}, year={2017}, volume={318}, number={23}, pages={2337--2343}, doi={10.1001/jama.2017.18556}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{nosek2019preregistration, author={Nosek, Brian A. and Beck, Emorie D. and Campbell, Lorne and Flake, Jessica K. and Hardwicke, Tom E. and Mellor, David T. and van ’t Veer, Anna E. and Vazire, Simine}, title={{Preregistration is hard, and worthwhile}}, journal={Trends in Cognitive Sciences}, year={2019}, volume={23}, number={10}, pages={815--818}, doi={10.1016/j.tics.2019.07.009}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@article{scheel2021excess, author={Scheel, Anne M. and Schijen, Mitchell R. M. J. and Lakens, Daniël}, title={{An excess of positive results: Comparing the standard psychology literature with registered reports}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={2}, eid={25152459211007467}, doi={10.1177/25152459211007467}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{vandenakker2021preregistration, author={Van den Akker, Olmo R. and Weston, Sara and Campbell, Lorne and Chopik, Bill and Damian, Rodica and Davis-Kean, Pamela and Hall, Andrew and Kosie, Jessica and Kruse, Elliott and Olsen, Jerome and Ritchie, Stuart and Valentine, KD and Van 't Veer, Anna and Bakker, Marjan}, title={{Preregistration of secondary data analysis: A template and tutorial}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2020.2625}}@article{wagenmakers2012agenda, author={Wagenmakers, Eric-Jan and Wetzels, Ruud and Borsboom, Denny and van der Maas, Han L. J. and Kievit, Rogier A.}, title={{An agenda for purely confirmatory research}}, journal={Perspectives on Psychological Science}, year={2012}, volume={7}, number={6}, pages={632--638}, doi={10.1177/1745691612463078}}@article{wicherts2016degrees, author={Wicherts, Jelte M. and Veldkamp, Coosje L. S. and Augusteijn, Hilde E. M. and Bakker, Marjan and van Aert, Robbie C. M. and van Assen, Marcel A. L. M.}, title={{Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking}}, journal={Frontiers in Psychology}, year={2016}, volume={7}, eid={1832}, doi={10.3389/fpsyg.2016.01832}}@article{willroth2024best, author={Willroth, Emily C. and Atherton, Olivia E.}, title={{Best laid plans: A guide to reporting preregistration deviations}}, journal={Advances in Methods and Practices in Psychological Science}, year={2024}, volume={7}, number={1}, eid={25152459231213802}, doi={10.1177/25152459231213802}}