Zanim zaczniesz odpowiadać recenzentom
Decyzja „major revision” z uwagami do statystyki nie przekreśla artykułu – redaktor czeka na dowód, że wnioski wytrzymują krytykę. Poniżej znajdziesz zasady i strukturę odpowiedzi na recenzję oraz wzory po angielsku i po polsku na dwanaście typowych próśb recenzentów. Cytowane uwagi recenzentów to przykłady ułożone na potrzeby tego tekstu – nie pochodzą z konkretnych recenzji ani czasopism. Jeśli rękopis dopiero powstaje, zacznij od wpisu o najczęstszych zarzutach recenzentów do statystyki.
- Rozpisz uwagi w tabeli i ponumeruj je (R1.1, R1.2…); uwagę o dwóch sprawach podziel na dwie.
- Przy każdej uwadze zdecyduj, z czym masz do czynienia: z błędem (poprawiasz i przyznajesz), rozsądną prośbą (wykonujesz analizę), nieporozumieniem (poprawiasz tekst) czy prośbą wątpliwą (wyjaśniasz stanowisko ze źródłem).
- Najpierw wykonaj analizy, potem pisz, a każdą nową analizę zapisz w skrypcie (zob. pakiet replikacyjny).
- Pierwszą wersję napisz tylko dla zespołu. Noble (2017) radzi pisać odpowiedź dwa razy: najpierw wersję, w której można dać upust emocjom, a po kilku dniach – wersję dla recenzentów.
Zasady dobrej odpowiedzi
Noble (2017) zebrał dziesięć praktycznych reguł pisania odpowiedzi recenzentom. W sprawach statystycznych najważniejsze są te:
- Odpowiadaj na każdy punkt – pominięte uwagi to częsta skarga recenzentów.
- Zacznij od sedna: czy się zgadzasz i co zrobiłeś. Uzasadnienie podaj potem.
- Pokaż zmianę: zacytuj nowy fragment i podaj stronę oraz wiersze, zaznaczając, której wersji dotyczą. Zdanie „This point is addressed in the manuscript” nie mówi, czy cokolwiek zmieniono.
- Odróżnij graficznie uwagę, odpowiedź i zmieniony tekst, np. kursywą i cudzysłowem.
- Gdy możesz, zrób to, o co prosi recenzent – nawet analizę, którą uważasz za mało informatywną. Pokaż wynik w odpowiedzi i wyjaśnij, dlaczego nie trafi do artykułu.
- Możesz się nie zgodzić – uprzejmie, z argumentem statystycznym, źródłem i propozycją kompromisu (np. wynik w suplemencie). Decyzję zostaw redaktorowi.
Przykładami uprzejmej niezgody są sytuacje 1 i 7, a pozostałe wzory pokazują zgodę z wprowadzeniem zmiany.
Struktura listu i dokumentu z odpowiedziami
Odpowiedź to zwykle krótki list do redaktora i dokument z odpowiedziami. Noble (2017) zaleca, by dokument zaczynał się od podsumowania zmian i opisu konwencji zapisu, a dalej zawierał pełne recenzje z odpowiedziami po każdym punkcie. Tabele tylko dla recenzentów oznacz jako takie, a wymogi formalne sprawdź w instrukcji czasopisma.
Pobierz wzór odpowiedzi recenzentom w formacie Word (.docx) – list do redakcji i tabela „uwaga – odpowiedź – miejsce zmiany” po angielsku i po polsku, wypełniona przykładami z tego wpisu.
Sprzeczne uwagi recenzentów
Gdy prośby recenzentów się wykluczają, Noble (2017) radzi wskazać to redaktorowi prowadzącemu w osobnym liście. Nie rozstrzygaj sporu po cichu: zaproponuj rozwiązanie z uzasadnieniem i poproś o decyzję.
Przykład: jeden rękopis i prośby recenzentów
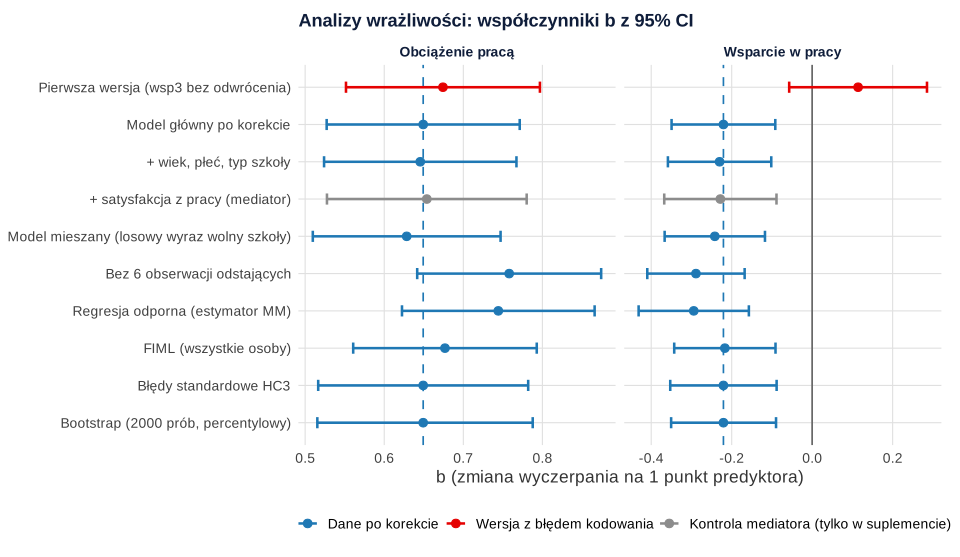
Wzory odnoszą się do jednego badania (dane symulowane): 480 nauczycieli z 40 szkół. Hipoteza H1 zakładała, że wyższe obciążenie pracą (skala 1–5) wiąże się z silniejszym wyczerpaniem emocjonalnym (1–7), a H2 – że wyższe wsparcie w pracy wiąże się ze słabszym wyczerpaniem. Czterdzieści osób (8.3%) pominęło pytania o wsparcie, więc regresję wieloraką policzono na 440 osobach. Po korekcie błędu kodowania (sytuacja 12): obciążenie b = 0.65, 95% CI [0.53, 0.77], p < .001; wsparcie b = −0.22, 95% CI [−0.35, −0.09], p < .001; R² = .23. Tabela 1 i rysunek 1 zbierają analizy, o które poprosili recenzenci – taka tabela przekonuje bardziej niż zapewnienia, że wyniki „są odporne”.
Tabela 1
Związek obciążenia pracą i wsparcia w pracy z wyczerpaniem emocjonalnym w analizach wykonanych na prośbę recenzentów
| Wariant analizy | N | Obciążenie pracą, b [95% CI] | Wsparcie w pracy, b [95% CI] |
|---|---|---|---|
| Pierwsza wersja (pozycja wsp3 bez odwrócenia)a | 440 | 0.67 [0.55, 0.80] | 0.11 [−0.06, 0.29] |
| Model główny po korekcie kodowania | 440 | 0.65 [0.53, 0.77] | −0.22 [−0.35, −0.09] |
| + wiek, płeć i typ szkoły | 440 | 0.65 [0.52, 0.77] | −0.23 [−0.36, −0.10] |
| + satysfakcja z pracy (mediator)b | 440 | 0.65 [0.53, 0.78] | −0.23 [−0.37, −0.09] |
| Model mieszany (losowy wyraz wolny szkoły) | 440 | 0.63 [0.51, 0.75] | −0.24 [−0.37, −0.12] |
| Bez 6 obserwacji odstających | 434 | 0.76 [0.64, 0.87] | −0.29 [−0.41, −0.17] |
| Regresja odporna (estymator MM) | 440 | 0.74 [0.62, 0.87] | −0.29 [−0.43, −0.16] |
| FIML (wszystkie osoby) | 480 | 0.68 [0.56, 0.79] | −0.22 [−0.34, −0.09] |
| Błędy standardowe HC3 | 440 | 0.65 [0.52, 0.78] | −0.22 [−0.35, −0.09] |
| Bootstrap (2000 prób) | 440 | 0.65 [0.52, 0.79] | −0.22 [−0.35, −0.09] |
Uwaga. Zmienna zależna: wyczerpanie emocjonalne (1–7); b – niestandaryzowany współczynnik regresji. W modelu mieszanym 95% CI wyznaczono ze stopni swobody Satterthwaite’a, a w wariancie FIML uwzględniono 40 osób bez odpowiedzi na pytania o wsparcie. Dane symulowane.
a Wersja z błędem kodowania (sytuacja 12). b Tylko dla przejrzystości – satysfakcja jest prawdopodobnie mediatorem (sytuacja 3).
1. Prośba o moc post hoc
Przykładowa uwaga recenzenta: „The association between support and reduced efficacy was not significant. Please report the post hoc power of this test.”
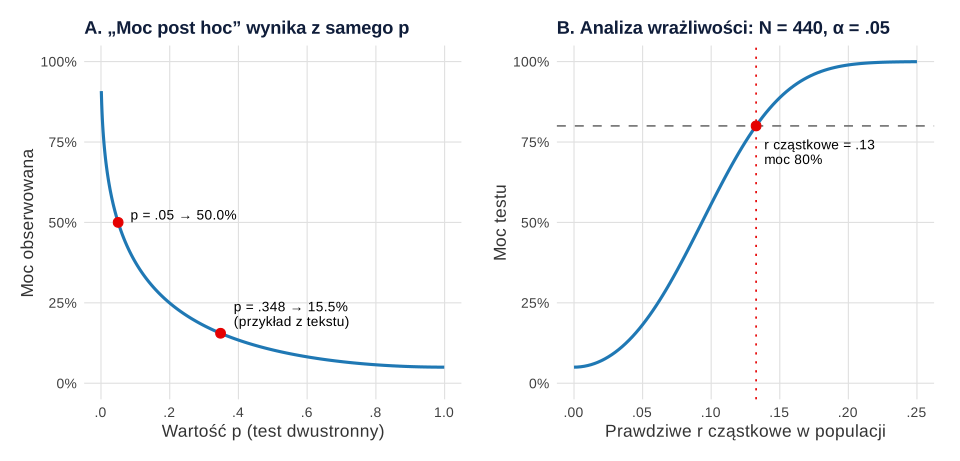
Moc obserwowana, czyli moc policzona z uzyskanego efektu, jest funkcją samej wartości p. Przy p = .05 wynosi 50.0%, a w przykładzie (b = 0.07, 95% CI [−0.08, 0.22], p = .348) – 15.5% (rysunek 2A). Hoenig i Heisey (2001) pokazali, że interpretowanie wyników nieistotnych mocą liczoną po badaniu jest błędem logicznym. Na pytanie, jakie efekty badanie mogło wykryć, odpowiada analiza wrażliwości (rysunek 2B) i przedział ufności. Brak efektu wykażesz dopiero testem równoważności (zob. gdy hipoteza się nie potwierdziła).
2. Korekta na wielokrotne porównania
Przykładowa uwaga recenzenta: „Six tests (two predictors × three burnout dimensions) are reported without any correction for multiple testing. Please correct or justify.”
Ustal rodzinę testów. Jeśli sześć testów sprawdza jedną parę hipotez, kontroluj ryzyko choćby jednego błędu I rodzaju w całej rodzinie, np. procedurą Holma (Holm, 1979), która nigdy nie odrzuca mniej hipotez niż korekta Bonferroniego. W przykładzie związek wsparcia z cynizmem po korekcie przestał być istotny. Gdy testy odpowiadają na odrębne pytania, możesz się nie zgodzić: Perneger (1998) przypomina, że korekta Bonferroniego dotyczy hipotezy o prawdziwości wszystkich hipotez zerowych naraz i zwiększa ryzyko błędu II rodzaju.
3. Dodatkowe zmienne kontrolne
Przykładowa uwaga recenzenta: „Please control for age, gender, school type and job satisfaction, which are known correlates of burnout.”
Wysocki i in. (2022) pokazują, że niewłaściwie dobrane zmienne kontrolne mogą zwiększyć obciążenie oszacowania, dlatego każdą trzeba uzasadnić przyczynowo. Wiek, płeć i typ szkoły mogą być zmiennymi zakłócającymi. Satysfakcja z pracy jest raczej skutkiem obciążenia, czyli mediatorem – jej kontrola usunęłaby część związku, który chcesz oszacować. W przykładzie kowarianty prawie nic nie zmieniły (tabela 1), a model z satysfakcją pokazano tylko w suplemencie.
4. Model mieszany dla danych zagnieżdżonych
Przykładowa uwaga recenzenta: „Teachers are nested within 40 schools. Please account for clustering, for example with a multilevel model, and report the intraclass correlation.”
Aarts i in. (2014) pokazali, że ignorowanie zależności między obserwacjami może podnieść odsetek wyników fałszywie istotnych z nominalnych 5% nawet do 80%. W przykładzie ICC = .10, a model wielopoziomowy dał podobne współczynniki (tabela 1), bo obciążenie różni się głównie między nauczycielami tej samej szkoły. Dla predyktora na poziomie szkoły różnica była wyraźna: błąd standardowy typu szkoły wzrósł z 0.124 do 0.185, a p – z .112 do .283. Przy pomiarach powtarzanych zob. ANOVA z powtarzanymi pomiarami czy model mieszany.
5. Wartości odstające
Przykładowa uwaga recenzenta: „Figure 2 suggests a few respondents with maximal workload but minimal exhaustion. Were outliers examined, and do they affect the results?”
Gdy reguły nie zapisano przed badaniem, Leys i in. (2019) radzą podać wyniki z obserwacjami odstającymi i bez nich albo wyniki metod odpornych. W przykładzie kryterium |reszta studentyzowana| > 3 wskazało sześć osób (t = −3.18). Przy wszystkich pozycjach obciążenia wybrały 5, a przy pozycjach pozostałych skal – 1. To raczej nieuważne odpowiedzi niż prawdziwe wyniki. Bez nich oba związki się wzmocniły (tabela 1). Zob. też wartości odstające – jak je wykryć.
6. Braki danych
Przykładowa uwaga recenzenta: „The sample drops from 480 to 440, but missing data handling is not described. Please describe it and use an appropriate method.”
Programy domyślnie usuwają osoby z brakami. Schafer i Graham (2002) – poza nielicznymi wyjątkami – odradzają takie starsze, doraźne metody i zalecają estymację metodą największej wiarygodności albo imputację wielokrotną. Podaj, ile brakuje, co wiadomo o mechanizmie braków (MCAR, MAR, MNAR) i jak zmieniły się wyniki. W przykładzie FIML dał wyniki zbliżone do analizy pełnych przypadków (tabela 1). Więcej: braki danych i imputacja wielokrotna w R.
7. Normalność rozkładu
Przykładowa uwaga recenzenta: „Exhaustion is skewed and the Shapiro–Wilk test is significant (p < .001). Please use non-parametric methods or transform the variable.”
Tu recenzent się myli – odpowiedź to uprzejma korekta poparta analizą. Regresja liniowa zakłada normalność błędów, a nie zmiennej zależnej czy predyktorów (Williams i in., 2013), dlatego sprawdzasz reszty regresji. Przy dużej próbie test Shapiro–Wilka wykrywa nawet drobne odchylenia. Najmocniejszym argumentem jest pokazanie, że wnioski nie zależą od założenia: przedziały z błędami HC3 i z bootstrapu są praktycznie takie same (tabela 1). Zob. też jak sprawdzić normalność rozkładu.
8. Błąd wspólnej metody (CMV) i test Harmana
Przykładowa uwaga recenzenta: „All variables were self-reported in one survey. Please address common method variance, for example with Harman’s single-factor test.”
Podsakoff i in. (2003) opisują źródła błędu wspólnej metody oraz proceduralne i statystyczne sposoby jego ograniczania. Aguirre-Urreta i Hu (2019) wykazali jednak w symulacjach, że test Harmana słabo wykrywa ten błąd. W naszych danych celowo dodany wspólny czynnik metody podniósł korelację obciążenia z wyczerpaniem z .41 do .54, a pierwsza nierotowana składowa wyjaśniała tylko 29.2% wariancji 21 pozycji – mniej niż popularny próg 50%. Test możesz wykonać, ale nie jako dowód braku CMV. Zob. też zarzuty dotyczące CMV i trafności narzędzi.
9. Inwariancja pomiaru
Przykładowa uwaga recenzenta: „Women and men are compared on exhaustion, but measurement invariance across gender is not tested.”
Putnick i Bornstein (2016) podkreślają, że przed porównaniem średnich trzeba sprawdzić inwariancję pomiaru – zwykle w krokach: konfiguracyjnym, metrycznym i skalarnym. W przykładzie wielogrupowa CFA skali wyczerpania (362 kobiety, 118 mężczyzn, estymator MLR) pokazała, że równość ładunków i wyrazów wolnych nie pogorszyła dopasowania. Kryteria i częściową inwariancję omawiamy we wpisie inwariancja pomiaru krok po kroku, a definicję – w haśle inwariancja pomiaru w CB-SEM.
10. Język przyczynowy
Przykładowa uwaga recenzenta: „The design is cross-sectional, yet workload ‘leads to’ burnout and support ‘protects’ teachers. Please revise the causal language.”
Grosz i in. (2020) zauważają, że autorzy badań nieeksperymentalnych unikają jawnych pytań przyczynowych, a mimo to interpretują wyniki przyczynowo – tylko nie wypowiadają swoich założeń. Masz dwie uczciwe drogi: język związków, zgodny ze schematem przekrojowym, albo jawne pytanie przyczynowe z wypisanymi założeniami i ograniczeniami. Zamiana pojedynczych słów nie wystarczy, jeśli abstrakt nadal mówi o wpływie. Tabelę dopuszczalnych sformułowań znajdziesz we wpisie jak napisać dyskusję wyników.
| Przed | Po |
|---|---|
| Workload leads to emotional exhaustion. | Higher workload was associated with higher emotional exhaustion. |
| Support protects teachers against burnout. | Teachers who reported more support reported lower exhaustion. |
| Reducing workload will reduce burnout. | If the association is causal, which our design cannot establish, reducing workload might reduce burnout. |
11. Prośba o dane i kod
Przykładowa uwaga recenzenta: „Data are ‘available upon reasonable request’. Please deposit the data and code in a public repository or explain why this is not possible.”
Hardwicke i in. (2018) zbadali skutki obowiązku udostępniania danych w czasopiśmie Cognition. Odsetek artykułów z deklaracją dostępności danych wzrósł z 25% do 78%, ale nie wszystkie dane nadawały się do ponownego użycia, a część wyników udało się odtworzyć dopiero z pomocą autorów. Udostępnij więc dane z książką kodową i skryptem, który odtwarza wszystkie wyniki (zob. pakiet replikacyjny i hasło open science). Jeśli uczestnicy nie zgodzili się na udostępnienie danych, zaproponuj rozwiązanie zastępcze (zob. świadoma zgoda i RODO).
12. Przyznanie się do błędu
Przykładowa uwaga recenzenta: „The support scale has unusually low reliability (α = .35), and its positive coefficient contradicts previous studies. Please check the scoring of this scale.”
W przykładzie recenzent miał rację: negatywnie sformułowana pozycja wsp3 nie została odwrócona (zob. pozycja odwrócona). Po korekcie rzetelność wzrosła z α = .35 do .77, a związek wsparcia z wyczerpaniem stał się istotny – zmienił się wniosek dotyczący H2. Przyznaj się do błędu wprost: napisz, co było źle, co poprawiono i które wnioski się zmieniły. Potem powtórz wszystkie analizy jednym skryptem od danych surowych. Nazwanie zmiany wniosków „drobną korektą” podważa zaufanie bardziej niż sam błąd.
Analizy dla recenzentów w R
Pięć przepisów odtwarza wszystkie liczby z tabeli 1, rysunków i wzorów odpowiedzi. Przepis 1 tworzy dane symulowane – jego część do komentarza „analiza (przepis 1)” zapisz jako plik dane-nauczyciele.R, bo korzystają z niego przepisy 2–5.
1. Dane symulowane i model główny przed korektą błędu kodowania i po niej
R
# B34, przepis 1: dane symulowane (cały blok to plik dane-nauczyciele.R, używany w przepisach 2–5),
# rzetelność skali wsparcia i model główny – przed korektą błędu kodowania i po niej
# Dane symulowane do wpisu B34: badanie przekrojowe 480 nauczycieli z 40 szkół.
# Obciążenie pracą (4 pozycje, 1–5), wsparcie w pracy (4 pozycje, 1–5; pozycja wsp3 sformułowana negatywnie),
# wypalenie: wyczerpanie (5 pozycji), cynizm (4) i obniżone poczucie skuteczności (4) – skale 1–7,
# satysfakcja z pracy (3 pozycje, 1–5), wiek, płeć, typ szkoły. Wszystkie odpowiedzi zawierają wspólny czynnik metody.
set.seed(3434)
J <- 40; nj <- 12; N <- J * nj
szkola <- rep(1:J, each = nj)
typ_szkoly <- rep(sample(c("podstawowa", "ponadpodstawowa"), J, replace = TRUE, prob = c(.6, .4)), each = nj)
plec <- sample(c("kobieta", "mężczyzna"), N, replace = TRUE, prob = c(.78, .22))
wiek <- pmin(67, pmax(24, round(rnorm(N, 45, 10))))

# zmienne latentne (wyniki standaryzowane)
obc <- rnorm(J, 0, sqrt(.10))[szkola] + rnorm(N, 0, sqrt(.90))           # obciążenie pracą
wsp <- -.25 * obc + rnorm(N, 0, sqrt(1 - .25^2))                          # wsparcie
sat <- -.40 * obc + .30 * wsp + rnorm(N, 0, .80)                          # satysfakcja (mediator)
wyc <- .45 * obc - .30 * wsp - .20 * sat + .006 * (wiek - 45) +
       rnorm(J, 0, .46)[szkola] + rnorm(N, 0, .70)                         # wyczerpanie
cyn <- .18 * obc - .19 * wsp - .26 * sat + rnorm(N, 0, .86)               # cynizm
efe <- .04 * obc - .08 * wsp - .16 * sat + rnorm(N, 0, .92)               # obniżona skuteczność
M <- rnorm(N)                                                             # wspólny czynnik metody

lam <- .72; lam_m <- .30                                 # ładunki: cecha i czynnik metody
pozycje <- function(eta, k, prog, znak = rep(1, k), metoda = M, E = matrix(rnorm(N * k), N, k)) {
  eta <- as.numeric(scale(eta))
  sapply(1:k, function(i) findInterval(znak[i] * lam * eta + lam_m * metoda + sqrt(1 - lam^2 - lam_m^2) * E[, i], prog) + 1)
}
prog5 <- c(-1.6, -.7, .2, 1.1)                         # skala 1–5
prog7 <- c(-1.1, -.45, .1, .65, 1.2, 1.8)              # skala 1–7, rozkład prawoskośny
E_obc <- matrix(rnorm(N * 4), N, 4); E_wyc <- matrix(rnorm(N * 5), N, 5)
E_wyc[, 5] <- .25 * E_wyc[, 4] + sqrt(1 - .25^2) * E_wyc[, 5]   # wyc4 i wyc5 o podobnym brzmieniu: skorelowane błędy
P_obc <- pozycje(obc, 4, prog5, E = E_obc)
P_wsp <- pozycje(wsp, 4, prog5, znak = c(1, 1, -1, 1))
P_wyc <- pozycje(wyc, 5, prog7, E = E_wyc)
P_cyn <- pozycje(cyn, 4, prog7)
P_efe <- pozycje(efe, 4, prog7)
P_sat <- pozycje(sat, 3, prog5)
colnames(P_obc) <- paste0("obc", 1:4); colnames(P_wsp) <- paste0("wsp", 1:4)
colnames(P_wyc) <- paste0("wyc", 1:5); colnames(P_cyn) <- paste0("cyn", 1:4)
colnames(P_efe) <- paste0("efe", 1:4); colnames(P_sat) <- paste0("sat", 1:3)

# Kontrfakt do pokazania CMV: te same osoby i błędy, ale czynnik metody osobny dla każdej skali
cmv <- data.frame(obc_wspolna = rowMeans(P_obc), wyc_wspolna = rowMeans(P_wyc),
                  obc_osobna = rowMeans(pozycje(obc, 4, prog5, metoda = rnorm(N), E = E_obc)),
                  wyc_osobna = rowMeans(pozycje(wyc, 5, prog7, metoda = rnorm(N), E = E_wyc)))

nauczyciele <- data.frame(id = 1:N, szkola, typ_szkoly, plec, wiek, P_obc, P_wsp, P_wyc, P_cyn, P_efe, P_sat)

# braki danych: część osób pominęła blok pytań o wsparcie (MAR – zależy od obciążenia i wyczerpania)
z <- function(x) as.numeric(scale(x))
p_brak <- plogis(-2.45 + .45 * z(rowMeans(P_wyc)) + .30 * z(rowMeans(P_obc)))
nauczyciele[runif(N) < p_brak, paste0("wsp", 1:4)] <- NA

# 6 osób z nietypowym wzorcem odpowiedzi: 5 przy wszystkich pozycjach obciążenia, 1 przy pozostałych
odst <- sample(which(!is.na(nauczyciele$wsp1) & rowMeans(P_obc) >= 3 & rowMeans(P_obc) < 4.5), 6)
nauczyciele[odst, paste0("obc", 1:4)] <- 5
nauczyciele[odst, c(paste0("wsp", 1:4), paste0("wyc", 1:5), paste0("cyn", 1:4), paste0("efe", 1:4), paste0("sat", 1:3))] <- 1

# wyniki skal (średnie pozycji); wsparcie: wersja błędna (bez odwrócenia wsp3) i poprawna
nauczyciele <- within(nauczyciele, {
  obciazenie  <- rowMeans(cbind(obc1, obc2, obc3, obc4))
  wsparcie_bl <- rowMeans(cbind(wsp1, wsp2, wsp3, wsp4))         # błąd z pierwszej wersji rękopisu
  wsparcie    <- rowMeans(cbind(wsp1, wsp2, 6 - wsp3, wsp4))     # po odwróceniu pozycji wsp3
  wyczerpanie <- rowMeans(cbind(wyc1, wyc2, wyc3, wyc4, wyc5))
  cynizm      <- rowMeans(cbind(cyn1, cyn2, cyn3, cyn4))
  skutecznosc <- rowMeans(cbind(efe1, efe2, efe3, efe4))
  satysfakcja <- rowMeans(cbind(sat1, sat2, sat3))
  plec <- factor(plec); typ_szkoly <- factor(typ_szkoly)
})

# ---- analiza (przepis 1) ----
d <- nauczyciele
c(N = nrow(d), szkoly = length(unique(d$szkola)), braki_wsparcia = sum(is.na(d$wsparcie)))

alfa <- function(X) round(psych::alpha(X, check.keys = FALSE, warnings = FALSE)$total$raw_alpha, 2)
c(alfa_wsparcie_blad = alfa(d[, paste0("wsp", 1:4)]),                       # wsp3 bez odwrócenia
  alfa_wsparcie_korekta = alfa(cbind(d$wsp1, d$wsp2, 6 - d$wsp3, d$wsp4)),
  alfa_obciazenie = alfa(d[, paste0("obc", 1:4)]), alfa_wyczerpanie = alfa(d[, paste0("wyc", 1:5)]))
round(c(r_wsparcie_blad = cor(d$wsparcie_bl, d$wyczerpanie, use = "complete.obs"),
        r_wsparcie_korekta = cor(d$wsparcie, d$wyczerpanie, use = "complete.obs")), 2)

tabela <- function(m) {                                   # b, 95% CI i p (cztery miejsca, by odróżnić p < .001)
  x <- cbind(b = coef(m), confint(m))[-1, , drop = FALSE]
  noquote(cbind(formatC(x, format = "f", digits = 3), p = formatC(summary(m)$coefficients[-1, 4], format = "f", digits = 4)))
}
m_blad   <- lm(wyczerpanie ~ obciazenie + wsparcie_bl, data = d)            # pierwsza wersja rękopisu
m_glowny <- lm(wyczerpanie ~ obciazenie + wsparcie, data = d)               # po korekcie
tabela(m_blad)
tabela(m_glowny)
c(N = nobs(m_glowny), R2 = round(summary(m_glowny)$r.squared, 3))
Wynik w R
             N         szkoly braki_wsparcia
           480             40             40
   alfa_wsparcie_blad alfa_wsparcie_korekta       alfa_obciazenie
                 0.35                  0.77                  0.84
     alfa_wyczerpanie
                 0.88
   r_wsparcie_blad r_wsparcie_korekta
              0.05              -0.19
            b     2.5 %  97.5 % p
obciazenie  0.674 0.552  0.797  0.0000
wsparcie_bl 0.114 -0.057 0.285  0.1908
           b      2.5 %  97.5 % p
obciazenie 0.649  0.527  0.771  0.0000
wsparcie   -0.220 -0.349 -0.092 0.0008
     N     R2
440.00   0.23
2. Analiza wrażliwości zamiast mocy post hoc i korekta Holma
R
# B34, przepis 2: prośba o „moc post hoc” (analiza wrażliwości) i korekta Holma dla sześciu testów
source("dane-nauczyciele.R")
d <- nauczyciele

# a) wynik nieistotny: wsparcie a obniżone poczucie skuteczności
m_efe <- lm(skutecznosc ~ obciazenie + wsparcie, data = d)
w <- c(b = coef(m_efe)[["wsparcie"]], confint(m_efe)["wsparcie", ], p = summary(m_efe)$coefficients["wsparcie", 4])
round(w, 3)
beta <- coef(m_efe)[["wsparcie"]] * sd(model.frame(m_efe)$wsparcie) / sd(model.frame(m_efe)$skutecznosc)
round(c(beta = beta, CI = confint(m_efe)["wsparcie", ] * sd(model.frame(m_efe)$wsparcie) / sd(model.frame(m_efe)$skutecznosc)), 3)

# b) „moc obserwowana” wynika wprost z wartości p (przybliżenie testem z)
z <- qnorm(1 - w[["p"]] / 2)
round(pnorm(z - qnorm(.975)) + pnorm(-z - qnorm(.975)), 3)

# c) analiza wrażliwości: najmniejszy efekt jednego predyktora (f², r cząstkowe) wykrywalny z mocą 80%
N <- nobs(m_efe); k <- 2; df2 <- N - k - 1
moc <- function(f2) 1 - pf(qf(.95, 1, df2), 1, df2, ncp = f2 * N)
f2 <- uniroot(function(f) moc(f) - .80, c(1e-4, .5))$root
round(c(N = N, f2 = f2, r_czastkowe = sqrt(f2 / (1 + f2))), 3)

# d) korekta Holma: 3 wymiary wypalenia × 2 predyktory = 6 testów
wyniki <- do.call(rbind, lapply(c("wyczerpanie", "cynizm", "skutecznosc"), function(y) {
  m <- lm(reformulate(c("obciazenie", "wsparcie"), y), data = d)
  data.frame(wynik = y, predyktor = c("obciazenie", "wsparcie"), b = coef(m)[2:3],
             p = summary(m)$coefficients[2:3, 4], row.names = NULL)
}))
wyniki$p_holm <- p.adjust(wyniki$p, method = "holm")
wyniki$b <- round(wyniki$b, 3); wyniki$p <- round(wyniki$p, 4); wyniki$p_holm <- round(wyniki$p_holm, 4)
wyniki
Wynik w R
     b  2.5 % 97.5 %      p
 0.071 -0.077  0.219  0.348
     beta  CI.2.5 % CI.97.5 %
    0.044    -0.049     0.137
[1] 0.155
          N          f2 r_czastkowe
    440.000       0.018       0.133
        wynik  predyktor      b      p p_holm
1 wyczerpanie obciazenie  0.649 0.0000 0.0000
2 wyczerpanie   wsparcie -0.220 0.0008 0.0025
3      cynizm obciazenie  0.529 0.0000 0.0000
4      cynizm   wsparcie -0.156 0.0298 0.0595
5 skutecznosc obciazenie  0.281 0.0001 0.0004
6 skutecznosc   wsparcie  0.071 0.3478 0.3478
3. Zmienne kontrolne i model mieszany
R
# B34, przepis 3: dodatkowe kowarianty, kontrola mediatora (czego nie robić) i model mieszany
source("dane-nauczyciele.R")
suppressPackageStartupMessages(library(lmerTest))
d <- nauczyciele
wiersz <- function(m, x) {                    # b z 95% CI i p dla wybranego predyktora (lm)
  c(b = coef(m)[[x]], confint(m)[x, ], p = summary(m)$coefficients[x, 4])
}
m_glowny <- lm(wyczerpanie ~ obciazenie + wsparcie, data = d)
m_kow    <- lm(wyczerpanie ~ obciazenie + wsparcie + wiek + plec + typ_szkoly, data = d)
m_med    <- lm(wyczerpanie ~ obciazenie + wsparcie + satysfakcja, data = d)   # satysfakcja = mediator
round(rbind(glowny_obciazenie = wiersz(m_glowny, "obciazenie"), glowny_wsparcie = wiersz(m_glowny, "wsparcie"),
            kowarianty_obciazenie = wiersz(m_kow, "obciazenie"), kowarianty_wsparcie = wiersz(m_kow, "wsparcie"),
            z_mediatorem_obciazenie = wiersz(m_med, "obciazenie"), z_mediatorem_wsparcie = wiersz(m_med, "wsparcie")), 3)
round(summary(m_kow)$coefficients[4:6, ], 3)                                   # same kowarianty

# Model mieszany: nauczyciele zagnieżdżeni w 40 szkołach
m0 <- lmer(wyczerpanie ~ 1 + (1 | szkola), data = d)
vc <- as.data.frame(VarCorr(m0))
round(c(ICC = vc$vcov[1] / sum(vc$vcov)), 3)
m_mix <- lmer(wyczerpanie ~ obciazenie + wsparcie + (1 | szkola), data = d)   # REML, df Satterthwaite'a
ws <- summary(m_mix)$coefficients[-1, ]
round(cbind(ws, CI_d = ws[, 1] - qt(.975, ws[, 3]) * ws[, 2], CI_g = ws[, 1] + qt(.975, ws[, 3]) * ws[, 2]), 3)
round(summary(m_glowny)$coefficients[-1, 1:2], 3)                              # porównaj błędy standardowe z OLS

# Predyktor na poziomie szkoły (typ szkoły): błąd standardowy w OLS i w modelu mieszanym
m_mix_kow <- lmer(wyczerpanie ~ obciazenie + wsparcie + wiek + plec + typ_szkoly + (1 | szkola), data = d)
round(rbind(OLS = summary(m_kow)$coefficients["typ_szkolyponadpodstawowa", c(1, 2, 4)],
            mieszany = summary(m_mix_kow)$coefficients["typ_szkolyponadpodstawowa", c(1, 2, 5)]), 3)
Wynik w R
                             b  2.5 % 97.5 %     p
glowny_obciazenie        0.649  0.527  0.771 0.000
glowny_wsparcie         -0.220 -0.349 -0.092 0.001
kowarianty_obciazenie    0.646  0.524  0.767 0.000
kowarianty_wsparcie     -0.230 -0.358 -0.102 0.000
z_mediatorem_obciazenie  0.654  0.528  0.780 0.000
z_mediatorem_wsparcie   -0.228 -0.368 -0.089 0.001
                          Estimate Std. Error t value Pr(>|t|)
wiek                         0.014      0.006   2.334    0.020
plecmężczyzna                0.135      0.131   1.032    0.303
typ_szkolyponadpodstawowa   -0.198      0.124  -1.592    0.112
  ICC
0.098
           Estimate Std. Error      df t value Pr(>|t|)   CI_d   CI_g
obciazenie    0.628      0.060 426.814  10.404        0  0.510  0.747
wsparcie     -0.242      0.063 422.358  -3.814        0 -0.367 -0.117
           Estimate Std. Error
obciazenie    0.649      0.062
wsparcie     -0.220      0.066
         Estimate Std. Error Pr(>|t|)
OLS        -0.198      0.124    0.112
mieszany   -0.201      0.185    0.283
4. Obserwacje odstające, braki danych (FIML) i odporne przedziały ufności
R
# B34, przepis 4: obserwacje odstające, braki danych (FIML) i rozkład reszt (HC3, bootstrap)
source("dane-nauczyciele.R")
suppressPackageStartupMessages({library(robustbase); library(lavaan); library(sandwich); library(lmtest); library(boot)})
d <- nauczyciele
m_glowny <- lm(wyczerpanie ~ obciazenie + wsparcie, data = d)
wsp <- function(m) round(cbind(b = coef(m), confint(m))[-1, ], 3)

# a) obserwacje odstające: reguła |reszta studentyzowana| > 3
rs <- rstudent(m_glowny)
odstajace <- as.numeric(names(rs)[abs(rs) > 3])
round(rs[abs(rs) > 3], 2)
d[odstajace, c("obciazenie", "wsparcie", "wyczerpanie")]
m_bez <- lm(wyczerpanie ~ obciazenie + wsparcie, data = d[-odstajace, ])
wsp(m_bez); round(summary(m_bez)$coefficients[-1, 4], 4)
m_mm <- lmrob(wyczerpanie ~ obciazenie + wsparcie, data = d)                # regresja odporna (estymator MM)
round(cbind(b = coef(m_mm), confint(m_mm))[-1, ], 3)

# b) braki danych: 41 osób bez odpowiedzi na pytania o wsparcie
round(tapply(d$wyczerpanie, is.na(d$wsparcie), mean), 2)                   # FALSE = komplet, TRUE = brak
fit_fiml <- sem("wyczerpanie ~ obciazenie + wsparcie", data = d, missing = "fiml", fixed.x = FALSE)
pe <- parameterEstimates(fit_fiml)
c(N = lavInspect(fit_fiml, "nobs"))
cbind(round(pe[pe$op == "~", c("est", "ci.lower", "ci.upper")], 3), p = formatC(pe[pe$op == "~", "pvalue"], format = "f", digits = 4))

# c) rozkład reszt i odporne błędy standardowe
round(c(skosnosc = psych::skew(resid(m_glowny)), kurtoza = psych::kurtosi(resid(m_glowny))), 2)
sw_y <- shapiro.test(d$wyczerpanie); sw_e <- shapiro.test(resid(m_glowny))   # test Shapiro–Wilka
round(c(W_wynik = unname(sw_y$statistic), p_wynik = sw_y$p.value, W_reszty = unname(sw_e$statistic), p_reszty = sw_e$p.value), 4)
round(coefci(m_glowny, vcov. = vcovHC(m_glowny, type = "HC3"))[-1, ], 3)    # 95% CI z błędami HC3
set.seed(2034)
b_boot <- boot(model.frame(m_glowny), function(x, i) coef(lm(wyczerpanie ~ obciazenie + wsparcie, data = x[i, ]))[-1], R = 2000)
round(rbind(obciazenie = boot.ci(b_boot, type = "perc", index = 1)$percent[4:5],
            wsparcie   = boot.ci(b_boot, type = "perc", index = 2)$percent[4:5]), 3)
Wynik w R
   33    36   413   421   466   471
-3.18 -3.18 -3.18 -3.18 -3.18 -3.18
    obciazenie wsparcie wyczerpanie
33           5        2           1
36           5        2           1
413          5        2           1
421          5        2           1
466          5        2           1
471          5        2           1
                b  2.5 % 97.5 %
obciazenie  0.758  0.642  0.874
wsparcie   -0.289 -0.410 -0.168
obciazenie   wsparcie
         0          0
                b  2.5 % 97.5 %
obciazenie  0.744  0.622  0.866
wsparcie   -0.294 -0.431 -0.157
FALSE  TRUE
 3.27  3.88
  N
480
     est ci.lower ci.upper      p
1  0.677    0.561    0.793 0.0000
2 -0.217   -0.343   -0.091 0.0007
skosnosc  kurtoza
   -0.16     0.29
 W_wynik  p_wynik W_reszty p_reszty
  0.9788   0.0000   0.9900   0.0043
            2.5 % 97.5 %
obciazenie  0.516  0.782
wsparcie   -0.353 -0.088
             [,1]   [,2]
obciazenie  0.515  0.788
wsparcie   -0.350 -0.090
5. Test Harmana i inwariancja pomiaru względem płci
R
# B34, przepis 5: test jednego czynnika Harmana na danych z wbudowanym czynnikiem metody
# oraz inwariancja pomiaru skali wyczerpania względem płci (wielogrupowa CFA)
source("dane-nauczyciele.R")
suppressPackageStartupMessages(library(lavaan))
d <- nauczyciele
d$wsp3r <- 6 - d$wsp3
pozycje <- c(paste0("obc", 1:4), "wsp1", "wsp2", "wsp3r", "wsp4", paste0("wyc", 1:5), paste0("cyn", 1:4), paste0("efe", 1:4))

# a) test Harmana: udział pierwszej nierotowanej składowej w wariancji 21 pozycji
X <- d[complete.cases(d[, pozycje]), pozycje]
ew <- eigen(cor(X))$values
round(c(n = nrow(X), procent_pierwszej = 100 * ew[1] / sum(ew)), 1)

# b) ile korelacji obciążenia z wyczerpaniem „dodaje” wspólna metoda? (kontrfakt z symulacji)
round(c(r_wspolna_metoda = cor(cmv$obc_wspolna, cmv$wyc_wspolna),
        r_osobne_metody = cor(cmv$obc_osobna, cmv$wyc_osobna)), 3)

# c) inwariancja pomiaru skali wyczerpania: kobiety i mężczyźni
table(d$plec)
model <- "WYCZ =~ wyc1 + wyc2 + wyc3 + wyc4 + wyc5"          # czynnik latentny wyczerpania
konf <- cfa(model, data = d, group = "plec", estimator = "MLR")
metr <- cfa(model, data = d, group = "plec", estimator = "MLR", group.equal = "loadings")
skal <- cfa(model, data = d, group = "plec", estimator = "MLR", group.equal = c("loadings", "intercepts"))
miary <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
tab <- round(t(sapply(list(konfiguracyjna = konf, metryczna = metr, skalarna = skal), fitMeasures, miary)), 3)
cbind(tab, dCFI = c(NA, diff(tab[, "cfi.robust"])), dRMSEA = c(NA, diff(tab[, "rmsea.robust"])))
lavTestLRT(konf, metr, skal)[, c("Df", "Chisq diff", "Df diff", "Pr(>Chisq)")]
Wynik w R
                n procent_pierwszej
            440.0              29.2
r_wspolna_metoda  r_osobne_metody
           0.538            0.413

  kobieta mężczyzna
      362       118
               chisq.scaled df.scaled cfi.robust rmsea.robust  srmr  dCFI
konfiguracyjna       22.064        10      0.989        0.074 0.020    NA
metryczna            25.394        14      0.990        0.059 0.026 0.001
skalarna             26.770        18      0.992        0.045 0.027 0.002
               dRMSEA
konfiguracyjna     NA
metryczna      -0.015
skalarna       -0.014
     Df Chisq diff Df diff Pr(>Chisq)
konf 10
metr 14      2.472       4     0.6497
skal 18      1.224       4     0.8741
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork, a plik Word – w pakietach officer i flextable. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- robustbase (wersja 0.99-7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents [R package]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting [R package]. https://doi.org/10.32614/CRAN.package.flextable
Najczęstsze błędy w odpowiedziach recenzentom
- „We have addressed this point” bez wskazania zmiany – recenzent musi sam szukać zmian.
- Wybiórcze pokazywanie dodatkowych analiz – pokazanie tylko „najlepszego” wariantu to też p-hacking. Zbierz wszystkie warianty w jednej tabeli i niczego nie zmieniaj po cichu.
- Kosmetyka zamiast zmiany wniosków – zamiana słowa „wpływ” na „związek” nie wystarczy, jeśli abstrakt nadal zakłada przyczynowość.
- Niespójne liczby po ponownych analizach – sprawdź tekst, tabele, abstrakt i odpowiedź (zob. niespójne liczby).
- Niezgoda bez źródła albo ton obronny – słuszny argument przegrywa bez uzasadnienia.
Lista kontrolna przed wysłaniem odpowiedzi
- Każda uwaga ma numer i odpowiedź zaczynającą się od sedna.
- Przy każdej zmianie jest cytat nowego fragmentu oraz strona i wiersze w wersji poprawionej.
- Nowe analizy są w tabeli lub suplemencie, z tymi samymi liczbami co w tekście i abstrakcie.
- Każda niezgoda ma uzasadnienie, źródło i propozycję kompromisu.
- Odpowiedź przeczytała osoba spoza zespołu – ton jest uprzejmy.
Jeśli recenzja wymaga analiz, których nie chcesz wykonywać sam – np. modelu mieszanego, imputacji czy wielogrupowej CFA – możemy je przeprowadzić i omówić z zespołem wyniki oraz argumentację statystyczną (zob. analizy statystyczne dla badaczy). Odpowiedź podpisują autorzy, więc muszą rozumieć każdą analizę, a pomoc warto ujawnić zgodnie z zasadami czasopisma.
Najczęstsze pytania
Jak napisać odpowiedź na recenzję artykułu naukowego?
Zacznij od krótkiego listu do redaktora z listą najważniejszych zmian, a potem odpowiedz na każdą uwagę po kolei: zacytuj ją, zacznij od bezpośredniej odpowiedzi, opisz zmianę i zacytuj nowy fragment z numerem strony i wiersza. Noble (2017) radzi też odróżnić typografią uwagę, odpowiedź i zmieniony tekst oraz nie pomijać żadnego punktu.
Czy można nie zgodzić się z recenzentem?
Tak, jeśli niezgoda jest uprzejma i uzasadniona: podaj konkretny argument statystyczny i źródło, a najlepiej wykonaj proponowaną analizę i pokaż, że wnioski się nie zmieniają. Zaproponuj kompromis, np. wynik w materiałach dodatkowych, i zostaw decyzję redaktorowi.
Co odpowiedzieć, gdy recenzent prosi o moc post hoc?
Wyjaśnij, że moc obserwowana wynika wprost z wartości p – przy p = .05 wynosi około 50%, a przy wyniku nieistotnym zawsze jest niska – więc nie wnosi nowej informacji (Hoenig i Heisey, 2001). Zamiast niej podaj analizę wrażliwości, czyli najmniejszy efekt wykrywalny z mocą 80% przy Twojej liczebności, oraz przedział ufności dla efektu.
Co zrobić, gdy recenzenci mają sprzeczne uwagi?
Nie rozstrzygaj sporu po cichu. Napisz osobny list do redaktora, wskaż obie uwagi z numerami, zaproponuj rozwiązanie z uzasadnieniem i poproś o decyzję – taką drogę wskazuje Noble (2017). W odpowiedziach dla recenzentów opisz, co ostatecznie zrobiono i dlaczego.
Czy w odpowiedzi recenzentom trzeba podawać numery stron i wierszy?
Tak, to bardzo ułatwia pracę recenzentowi. Podaj stronę i wiersze, zaznaczając, że dotyczą wersji poprawionej, a zmieniony fragment zacytuj w odpowiedzi. Zdanie „poprawiliśmy to w tekście” bez wskazania miejsca zmusza recenzenta do szukania i często rodzi nowe pytania.
Jak przyznać się do błędu w analizie po recenzji?
Napisz wprost, na czym polegał błąd, jak go poprawiono i które wyniki oraz wnioski się zmieniły – także wtedy, gdy zmienił się wniosek dotyczący hipotezy. Podziękuj recenzentowi, sprawdź pozostałe analizy i powtórz je jednym skryptem od danych surowych. Opisanie zmiany wniosków jako „drobnej korekty” podważa zaufanie bardziej niż sam błąd.
Powiązane hasła
Przeczytaj też
Zarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Recenzent prosi o dodatkowe analizy?
Wykonamy uzupełniające obliczenia, sprawdzimy argumentację statystyczną i omówimy wyniki z zespołem, aby każda odpowiedź opierała się na analizie, którą rozumiecie.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Aguirre-Urreta, M. I., & Hu, J. (2019). Detecting common method bias: Performance of the Harman's single-factor test. ACM SIGMIS Database: The DATABASE for Advances in Information Systems, 50(2), 45–70. https://doi.org/10.1145/3330472.3330477
- Grosz, M. P., Rohrer, J. M., & Thoemmes, F. (2020). The taboo against explicit causal inference in nonexperimental psychology. Perspectives on Psychological Science, 15(5), 1243–1255. https://doi.org/10.1177/1745691620921521 ● Otwarty dostęp
- Hardwicke, T. E., Mathur, M. B., MacDonald, K., Nilsonne, G., Banks, G. C., Kidwell, M. C., Hofelich Mohr, A., Clayton, E., Yoon, E. J., Henry Tessler, M., Lenne, R. L., Altman, S., Long, B., & Frank, M. C. (2018). Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition. Royal Society Open Science, 5(8), Article 180448. https://doi.org/10.1098/rsos.180448 ● Otwarty dostęp
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Noble, W. S. (2017). Ten simple rules for writing a response to reviewers. PLOS Computational Biology, 13(10), Article e1005730. https://doi.org/10.1371/journal.pcbi.1005730 ● Otwarty dostęp
- Perneger, T. V. (1998). What's wrong with Bonferroni adjustments. BMJ, 316(7139), 1236–1238. https://doi.org/10.1136/bmj.316.7139.1236 ● Otwarty dostęp: pełny tekst
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{aguirreurreta2019detecting, author={Aguirre-Urreta, Miguel I. and Hu, Jiang}, title={{Detecting common method bias: Performance of the Harman's single-factor test}}, journal={ACM SIGMIS Database: The DATABASE for Advances in Information Systems}, year={2019}, volume={50}, number={2}, pages={45--70}, doi={10.1145/3330472.3330477}}@article{grosz2020taboo, author={Grosz, Michael P. and Rohrer, Julia M. and Thoemmes, Felix}, title={{The taboo against explicit causal inference in nonexperimental psychology}}, journal={Perspectives on Psychological Science}, year={2020}, volume={15}, number={5}, pages={1243--1255}, doi={10.1177/1745691620921521}}@article{hardwicke2018data, author={Hardwicke, Tom E. and Mathur, Maya B. and MacDonald, Kyle and Nilsonne, Gustav and Banks, George C. and Kidwell, Mallory C. and Hofelich Mohr, Alicia and Clayton, Elizabeth and Yoon, Erica J. and Henry Tessler, Michael and Lenne, Richie L. and Altman, Sara and Long, Bria and Frank, Michael C.}, title={{Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition}}, journal={Royal Society Open Science}, year={2018}, volume={5}, number={8}, eid={180448}, doi={10.1098/rsos.180448}}@article{hoenig2001abuse, author={Hoenig, John M. and Heisey, Dennis M.}, title={{The abuse of power: The pervasive fallacy of power calculations for data analysis}}, journal={The American Statistician}, year={2001}, volume={55}, number={1}, pages={19--24}, doi={10.1198/000313001300339897}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{noble2017ten, author={Noble, William Stafford}, title={{Ten simple rules for writing a response to reviewers}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={10}, eid={e1005730}, doi={10.1371/journal.pcbi.1005730}}@article{perneger1998whats, author={Perneger, Thomas V.}, title={{What's wrong with Bonferroni adjustments}}, journal={BMJ}, year={1998}, volume={316}, number={7139}, pages={1236--1238}, doi={10.1136/bmj.316.7139.1236}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}