Braki danych: problem większy niż mniejsze N
W prawie każdym badaniu ktoś pomija pytanie, przerywa wypełnianie ankiety albo nie wraca na drugi pomiar. W badaniach podłużnych i eksperymentach internetowych ubytek bywa duży: w eksperymentach prowadzonych na platformie MTurk odsetek osób, które porzuciły badanie, wynosił 30–50% i różnił się między warunkami, co prowadziło do zaskakujących, ale fałszywych wniosków (Zhou i Fishbach, 2016). Braki danych to więc nie tylko mniejsza liczebność próby. Mogą obciążać oszacowania, obniżać moc testów i zawyżać błędy standardowe (Dong i Peng, 2013).
Programy statystyczne zwykle „rozwiązują” ten problem po cichu. W regresji i większości innych procedur SPSS i R domyślnie usuwają z analizy każdą osobę, której brakuje choć jednej wartości w zmiennych modelu. To wygodne, ale poprawne tylko przy bardzo mocnym założeniu. W tym poradniku pokazujemy, jak sprawdzić, z jakimi brakami masz do czynienia, dlaczego popularne „łatki” – wpisanie średniej albo ostatniego pomiaru – psują wyniki, i jak krok po kroku przeprowadzić imputację wielokrotną w R. Na końcu znajdziesz gotowy opis do rozdziału metodologicznego i do wyników w stylu APA.
Przykład, na którym pracujemy
Wszystkie kroki pokazujemy na jednym zbiorze (dane symulowane, kod na końcu wpisu). 250 studentów i studentek wypełniło ankietę na początku semestru (T1): skalę odczuwanego stresu PSS-10 (0–40 punktów), skalę wsparcia społecznego MSPSS (1–7) i wskaźnik jakości snu PSQI (0–21; więcej punktów oznacza gorszy sen), a także podało płeć i wiek. W sesji egzaminacyjnej (T2) te same osoby poproszono o ponowne wypełnienie skali stresu i skali zadowolenia z życia SWLS (5–35). To typowy schemat podłużny z dwoma pomiarami.
Pytanie badawcze brzmi: czy wsparcie społeczne wiąże się z niższym stresem w sesji, przy kontroli płci? Modelem analizy jest regresja liniowa stresu T2 względem wsparcia i płci. Drugim celem jest oszacowanie średniego stresu w sesji. Problem: drugiej ankiety nie wypełniły 73 osoby (29.2%), a część osób pominęła pojedyncze pytania.
MCAR, MAR i MNAR – trzy mechanizmy braków danych
Najważniejsze pytanie nie brzmi „ile brakuje?”, tylko „dlaczego brakuje?”. Rubin (1976) ujął to formalnie: mechanizm braków to związek między tym, czy wartość jest brakująca, a wartościami zmiennych – zarówno obserwowanych, jak i nieobserwowanych. Z tej teorii pochodzą trzy nazwy, które pojawiają się w każdym podręczniku (definicje znajdziesz też w haśle braki danych MCAR, MAR i MNAR):
- MCAR (ang. missing completely at random) – braki całkowicie losowe: szansa braku nie zależy od niczego, co ma związek z badaniem. Przykład: część ankiet T2 przepadła, bo serwer losowo gubił zapisane odpowiedzi.
- MAR (ang. missing at random) – braki losowe pod warunkiem zmiennych obserwowanych: szansa braku zależy od tego, co zmierzyliśmy, ale nie od samej brakującej wartości. Przykład: osoby z wysokim stresem na początku semestru częściej rezygnują z pomiaru w sesji – a stres T1 mamy w danych.
- MNAR (ang. missing not at random) – szansa braku zależy od nieznanej wartości, nawet po uwzględnieniu zmiennych obserwowanych. Przykład: rezygnują osoby, którym stres wzrósł w sesji najbardziej – niezależnie od tego, jak zaczynały semestr.
Rysunek 1 pokazuje te trzy mechanizmy na tych samych 300 symulowanych osobach. W każdym panelu brakuje około 30% pomiarów T2 (czerwone punkty), ale za każdym razem z innego powodu.
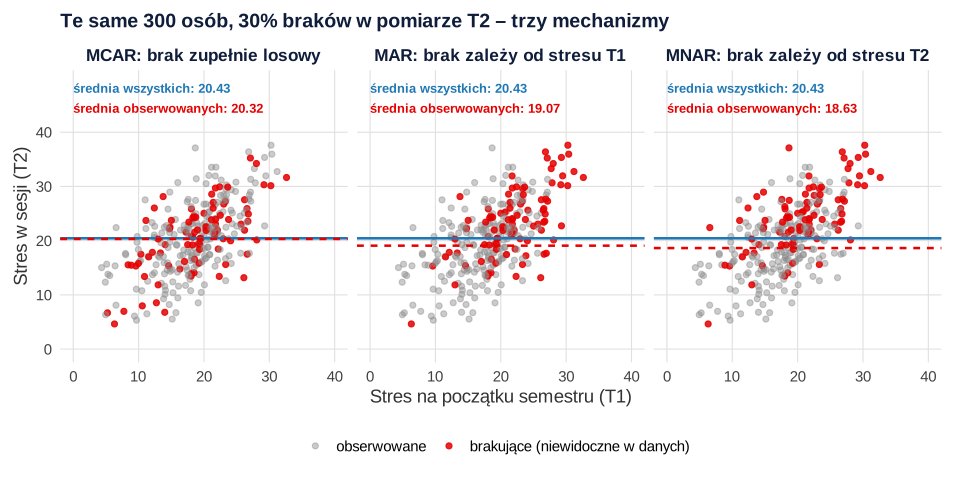
Przy MCAR średnia z obserwowanych wyników (20.32) prawie pokrywa się ze średnią wszystkich osób (20.43). Przy MAR i MNAR wypadają głównie osoby o wysokim stresie, więc średnia obserwowanych spada do 19.07 i 18.63. Różnica między tymi dwoma panelami jest jednak zasadnicza. Przy MAR brakujące punkty skupiają się po prawej stronie, czyli przy wysokim stresie T1, który znamy. Możemy więc częściowo „przewidzieć” brakujące wyniki ze stresu T1. Przy MNAR braki zależą od samego stresu w sesji, a stres T1 oddaje ten mechanizm tylko częściowo.
Rubin (1976) wykazał, że przy MAR proces powodujący braki można pominąć we wnioskowaniu, a we wnioskowaniu opartym na wiarygodności lub bayesowskim – gdy dodatkowo parametry mechanizmu braków są odrębne od parametrów modelu. Na tym fundamencie stoją dwie metody rekomendowane przez Schafera i Grahama (2002): estymacja metodą największej wiarygodności z pełną informacją (FIML) i imputacja wielokrotna. Ci sami autorzy wyjaśniają nieporozumienia wokół MAR, a sedno dobrze oddaje uwaga Sterne’a i in. (2009): MAR to założenie, które uzasadnia analizę, a nie właściwość danych. Testem statystycznym nie odróżnisz MAR od MNAR, bo do tego potrzebne byłyby właśnie brakujące wartości.
| Mechanizm | Od czego zależy brak | Czy da się to sprawdzić? | Usuwanie przypadków | Imputacja wielokrotna lub FIML |
|---|---|---|---|---|
| MCAR | Od niczego, co wiąże się z badaniem | Częściowo: test Little’a może MCAR odrzucić, ale nie potwierdzić | Bez obciążenia, ale mniejsza moc | Bez obciążenia, lepsza precyzja |
| MAR | Od zmiennych obserwowanych (np. stres T1) | Nie wprost; można pokazać, że braki zależą od zmiennych obserwowanych | Zwykle obciążone | Bez obciążenia, jeśli model zawiera zmienne związane z brakami |
| MNAR | Od samej brakującej wartości (np. stres T2) | Nie – tylko analiza wrażliwości | Obciążone | Też obciążone; wnioski trzeba sprawdzić przy różnych założeniach |
Krok 1. Diagnoza: ile brakuje, gdzie i od czego to zależy
Ile brakuje i w jakim układzie
Zacznij od zestawienia braków dla każdej zmiennej (w R: naniar::miss_var_summary()) i od odsetka osób z kompletem danych. W naszym zbiorze braki dotyczą czterech zmiennych: zadowolenia z życia T2 (79 osób, 31.6%), stresu T2 (73 osoby, 29.2%), wsparcia (18 osób, 7.2%) i jakości snu (6 osób, 2.4%). Pustych jest tylko 10.1% wszystkich komórek tabeli, a mimo to co najmniej jednej wartości brakuje aż 38.4% osób – komplet danych ma 154 z 250 uczestników. Tak działają braki rozproszone po wielu zmiennych: każda zmienna dokłada do puli niepełnych przypadków inne osoby.
Układ braków najlepiej widać na mapie (rysunek 2), którą rysuje funkcja naniar::vis_miss().
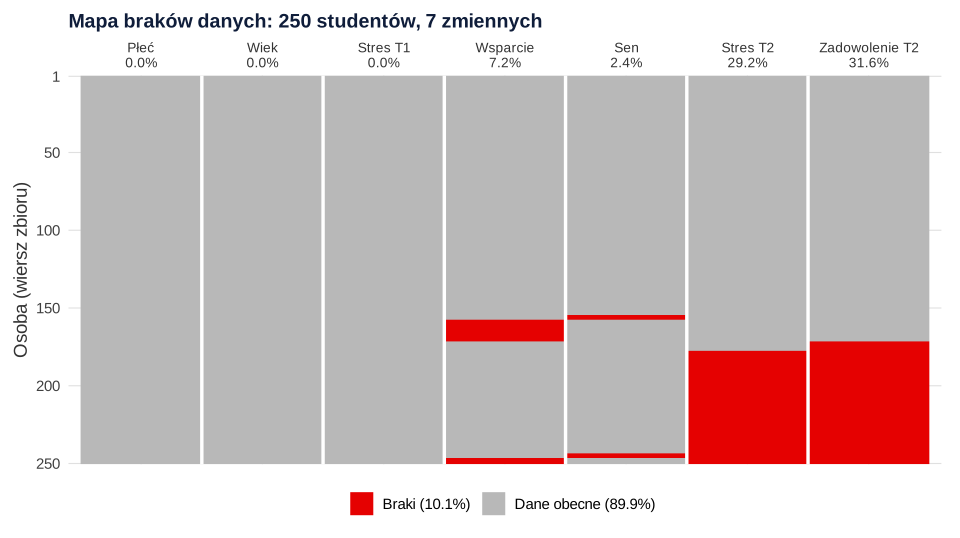
Na mapie widać dwa wzorce. Pierwszy to rezygnacja z drugiego pomiaru: 73 osoby nie mają ani stresu T2, ani zadowolenia T2 (blok po prawej). Drugi to pojedyncze pominięte pytania – rozproszone braki we wsparciu i jakości snu oraz kilka braków w samym zadowoleniu z życia. Rezygnacja z badania ma zwykle inne przyczyny niż pominięcie jednego pytania, więc każdy wzorzec przemyśl osobno.
Zanim zaczniesz analizę braków, upewnij się, że są prawdziwe. Puste pola powstają też przy eksporcie i kodowaniu danych z formularzy (zob. dane z Google Forms i LimeSurvey w SPSS i R), a także wtedy, gdy sam usuwasz obserwacje odstające albo odpowiedzi osób wypełniających ankietę nieuważnie (nieuważne odpowiedzi w ankietach online). Takie braki stworzone przez badacza też trzeba opisać i uwzględnić w analizie.
Test MCAR Little’a
Little (1988) zaproponował jeden globalny test hipotezy, że braki są MCAR. Zamiast wielu skorelowanych porównań średnich między osobami z brakami i bez braków test wykorzystuje naraz wszystkie dostępne dane. W R wykonasz go funkcją naniar::mcar_test(). W naszym zbiorze wynik jest jednoznaczny: χ²(25) = 73.16, p < .001, przy 7 wzorcach braków. Hipotezę MCAR odrzucamy – osoby z brakami różnią się od pozostałych.
Uważaj na odwrotne wnioskowanie. Nieistotny wynik testu Little’a nie dowodzi, że braki są MCAR (Jakobsen i in., 2017) – w małej próbie test ma po prostu małą moc. Test nie odróżnia też MAR od MNAR.
Od czego zależy brak? Porównaj osoby z brakami i bez braków
Bardziej praktyczne jest pytanie, które zmienne wiążą się z brakami. Utwórz wskaźnik braku (TRUE, gdy brakuje pomiaru T2) i porównaj grupy, na przykład na wykresie pudełkowym i testem. Osoby, które nie wypełniły ankiety w sesji, miały na początku semestru wyraźnie wyższy stres: M = 23.63 (SD = 4.88) wobec M = 17.69 (SD = 5.24), test Welcha t(143.44) = −8.56, p < .001. W regresji logistycznej wskaźnika braku na stres T1, wsparcie, płeć i wiek istotny był tylko stres T1. Każdy punkt na skali PSS-10 zwiększał szansę rezygnacji 1.27 raza (OR = 1.270, 95% CI [1.175, 1.373]), czyli około 4.2 raza na 6 punktów, mniej więcej jedno odchylenie standardowe.
Wniosek z diagnozy: braki nie są MCAR, a ich najważniejszy znany predyktor – stres T1 – mamy w zbiorze. Założenie MAR jest więc wiarygodne pod warunkiem, że stres T1 trafi do modelu imputacji. Nie mamy natomiast dowodu, że braki nie zależą dodatkowo od samego stresu w sesji (MNAR). Do tego wrócimy przy analizie wrażliwości.
Czego nie robić: usuwanie przypadków, średnia i LOCF
Schafer i Graham (2002) odradzają – poza nielicznymi wyjątkami – starsze metody doraźne. Przegląd Korczyńskiego (2014) prowadzi do podobnego wniosku: metody oparte na wiarygodności i imputacja wielokrotna lepiej ograniczają obciążenie i dają precyzyjniejsze oszacowania niż analiza przypadków kompletnych czy imputacja pojedyncza. Tabela zbiera najpopularniejsze sposoby i ich skutki.
| Metoda | Co robi | Kiedy nie obciąża wyników | Główny problem |
|---|---|---|---|
| Usuwanie przypadków (listwise) | Analizuje tylko osoby z kompletem danych; domyślne w SPSS i R | Przy MCAR; w regresji także wtedy, gdy braki w zmiennej zależnej zależą tylko od predyktorów modelu | Utrata mocy; obciążenie przy większości mechanizmów MAR |
| Usuwanie parami (pairwise) | Każdą korelację liczy na innej podgrupie osób | Przy MCAR | Niespójna macierz korelacji, niejasne n |
| Imputacja średnią | Wpisuje w miejsce braku średnią zmiennej | Właściwie nigdy: nawet przy MCAR zaniża zmienność | Za małe SD, osłabione korelacje i nachylenia, za wąskie przedziały ufności |
| LOCF (ostatnia obserwacja) | Wpisuje ostatni dostępny pomiar tej osoby | Tylko gdy wyniki się nie zmieniają | Obciążenie, gdy ludzie się zmieniają; zbyt mała niepewność |
| Imputacja regresyjna (pojedyncza) | Wpisuje wartość przewidzianą z regresji | Średnie bywają trafne przy MAR, ale niepewność jest zawsze zaniżona | Zawyżone korelacje, zaniżone błędy standardowe |
| Imputacja wielokrotna lub FIML | Uwzględnia niepewność co do brakujących wartości | Przy MCAR i MAR, jeśli model zawiera zmienne związane z brakami | Wymaga przemyślanego modelu; nie chroni przed MNAR |
Najbardziej podstępna jest imputacja średnią, bo po niej tabela statystyk opisowych wygląda porządnie. Każda imputowana osoba dostaje jednak dokładnie przeciętny wynik, więc wariancja maleje, a związki z innymi zmiennymi słabną. Do tego program traktuje wpisane średnie jak prawdziwe pomiary i liczy błędy standardowe dla pełnego N. LOCF (ang. last observation carried forward) zakłada z kolei, że osoba, która odpadła, „zatrzymała się” na poziomie ostatniego pomiaru. W badaniu stresu przed sesją to założenie jest sprzeczne z samą hipotezą o wzroście stresu.
Symulacja: jak metody radzą sobie, gdy znamy prawdę
Żeby zobaczyć skutki tych decyzji, przeprowadziliśmy symulację. Z populacji o znanych parametrach 2000 razy losowaliśmy próbę 250 osób. Prawdziwy średni stres w sesji wynosi 21.00 punktu, a prawdziwe nachylenie regresji stresu T2 względem wsparcia b = −2.60 (każdy punkt wsparcia to średnio 2.6 punktu stresu mniej). Stres T1 korelował ze stresem T2 na poziomie r = .60. W każdej próbie usuwaliśmy 30% pomiarów T2 – raz całkowicie losowo (MCAR), raz tak, by szansa braku rosła ze stresem T1 (MAR). Następnie każdą metodą liczyliśmy średnią i nachylenie wraz z 95% przedziałem ufności. Imputację wielokrotną (20 imputacji) sprawdziliśmy w dwóch wersjach: bez zmiennej pomocniczej i ze stresem T1 jako zmienną pomocniczą.
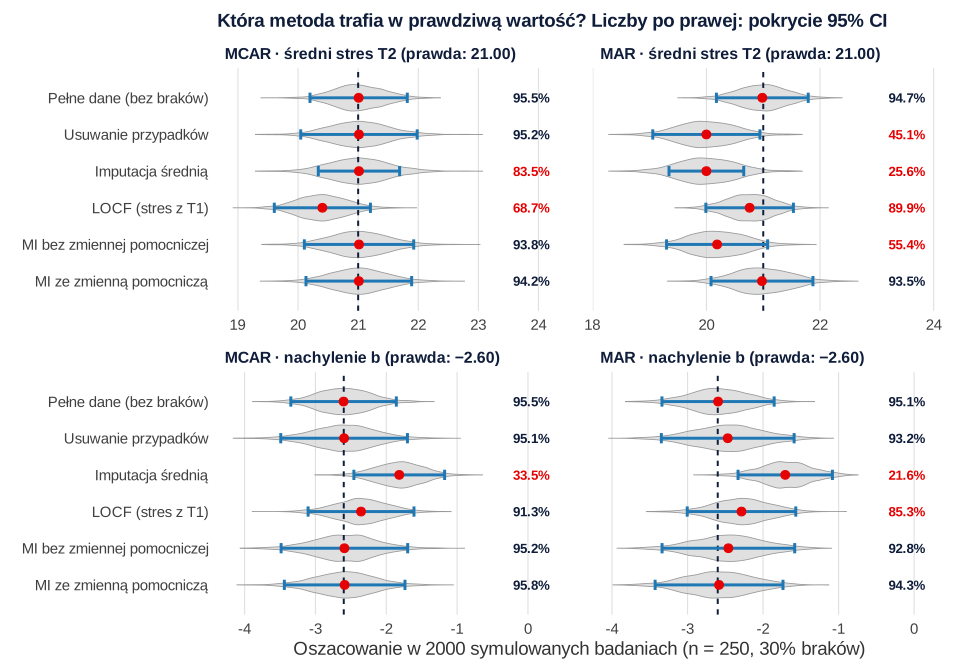
Najważniejsze wnioski z rysunku 3:
- Przy MCAR usuwanie przypadków nie obciąża wyników (średnia 21.01, pokrycie 95.2%), ale traci precyzję: przeciętny przedział ufności dla średniej miał szerokość 1.94 punktu wobec 1.62 w pełnych danych. Imputacja wielokrotna ze zmienną pomocniczą odzyskała część tej informacji (1.76).
- Imputacja średnią szkodzi nawet przy MCAR. Średnia jest poprawna, ale przedziały ufności są za wąskie i obejmowały prawdziwą wartość tylko w 83.5% prób zamiast w 95%. Przeciętny błąd standardowy wyniósł 0.34, choć rzeczywista zmienność oszacowań między próbami była równa 0.50. Nachylenie spłaszczyło się z −2.60 do −1.82 (pokrycie 33.5%).
- LOCF zaniżył średni stres w sesji już przy MCAR (20.40; pokrycie 68.7%), bo w miejsce braku wpisuje wynik sprzed wzrostu stresu. Przy MAR obciążenie średniej przypadkiem częściowo się zniosło (20.76), bo rezygnowały osoby z wysokim stresem T1, ale nachylenie i tak było spłaszczone (−2.29; pokrycie 85.3%).
- Przy MAR usuwanie przypadków zaniża średni stres (20.00 zamiast 21.00) – 95% CI objął prawdziwą wartość tylko w 45.1% prób. Imputacja średnią daje tę samą obciążoną średnią z jeszcze węższym przedziałem (pokrycie 25.6%).
- Imputacja wielokrotna działa tylko z właściwymi zmiennymi. Bez stresu T1 w modelu imputacji średnia pozostała obciążona (20.19; pokrycie 55.4%). Ze stresem T1 oszacowania niemal pokryły się z prawdą: średnia 20.98 (pokrycie 93.5%) i nachylenie −2.58 (94.3%).
Nachylenie okazało się mniej wrażliwe na braki niż średnia: przy usuwaniu przypadków wyniosło −2.47 (pokrycie 93.2%). Tak bywa, gdy braki zależą od zmiennej spoza modelu, która z wynikiem wiąże się tylko częściowo. Gdyby braki zależały wyłącznie od predyktora (wsparcia), usuwanie przypadków nie obciążyłoby nachylenia wcale. Nie ma więc jednej odpowiedzi na pytanie „czy usuwanie przypadków jest złe?” – zależy to od mechanizmu i od tego, co szacujesz.
Znaczenie mają też ustawienia imputacji. W symulacji użyliśmy w funkcji aregImpute() losowania z modelu regresji (type = "regression"). Domyślne w tej funkcji dopasowanie predykcyjne średnich (PMM) dało przy MAR nieco gorsze wyniki: średnią 20.91 i nachylenie −2.48, z pokryciem 92.4% w obu przypadkach. PMM uzupełnia brak wartością „pożyczoną” od osoby z danymi o podobnym wyniku przewidywanym. Gdy braki skupiają się na jednym końcu rozkładu, takich dawców jest niewielu.
Krok 2. Imputacja wielokrotna krok po kroku
Klasyczną monografią imputacji wielokrotnej (ang. multiple imputation, MI) jest książka Rubina (1987), który przedstawił ją jako sposób postępowania z brakami odpowiedzi w badaniach sondażowych – razem z bayesowskimi podstawami i porównaniem z imputacją pojedynczą. Pomysł jest prosty: zamiast jednej „najlepszej” wartości wpisujemy kilka wiarygodnych wartości, które różnią się losowo. Różnice między nimi wyrażają naszą niepewność co do tego, jaka była brakująca wartość. Procedura ma trzy etapy:
- Imputacja. Tworzysz m kompletnych kopii zbioru. W każdej brakujące wartości są losowane z rozkładu przewidywanego przez model imputacji (np. regresję stresu T2 na stres T1, wsparcie, sen i pozostałe zmienne), z uwzględnieniem niepewności parametrów tego modelu.
- Analiza. W każdej kopii wykonujesz dokładnie tę samą analizę – u nas regresję stresu T2 na wsparcie i płeć. Dostajesz m oszacowań i m błędów standardowych.
- Łączenie. Wyniki łączysz regułami Rubina w jedno oszacowanie z jednym błędem standardowym, przedziałem ufności i wartością p.
Reguły Rubina są proste. Jeśli Qi to oszacowanie (np. współczynnik b) z i-tego zbioru, a SEi – jego błąd standardowy, to:
- Q̄ – średnia oszacowań, czyli końcowy wynik;
- W – wariancja wewnątrz imputacji: niepewność, jaką mielibyśmy przy pełnych danych;
- B – wariancja między imputacjami: dodatkowa niepewność z powodu braków;
- T – wariancja całkowita; czynnik (1 + 1/m) koryguje skończoną liczbę imputacji.
W naszym przykładzie dla efektu wsparcia W = 0.1197 i B = 0.0401, więc T = 0.1197 + (1 + 1/40) × 0.0401 = 0.1608, a SE = √0.1608 = 0.40. Z tych samych składników liczy się stopnie swobody testu t (z poprawką Barnarda–Rubina dla małych prób) i frakcję brakującej informacji (FMI) – część niepewności oszacowania, która wynika z braków. Pełne wyprowadzenie i przykład liczbowy znajdziesz w haśle imputacja wielokrotna.
Najpopularniejszym narzędziem do imputacji wielokrotnej w R jest pakiet mice, który imputuje kolejne zmienne metodą łańcuchowych równań i automatycznie łączy wyniki (van Buuren i Groothuis-Oudshoorn, 2011). W tym wpisie używamy funkcji aregImpute() z pakietu Hmisc. Dla każdej zmiennej z brakami dopasowuje ona model addytywny na próbie bootstrapowej – losowanie ze zwracaniem odzwierciedla niepewność parametrów modelu – a następnie uzupełnia braki. Wybraliśmy wariant regresyjny, który dokumentacja funkcji zaleca, gdy zmienne z brakami są ciągłe, a braki obejmują całe przedziały wartości w populacji – jak u nas, gdzie brakuje głównie wysokich wyników stresu. Teorię i praktykę imputacji, w tym diagnostykę modeli, świetnie opisuje bezpłatna w wersji online książka van Buurena (2018), a podręcznik Endersa (2022) omawia równolegle trzy nowoczesne podejścia: metodę największej wiarygodności, estymację bayesowską i imputację wielokrotną. Alternatywą dla imputacji jest estymacja FIML, dostępna m.in. w programach do modelowania równań strukturalnych. W danych z wieloma powtarzanymi pomiarami podobną zaletę ma model wielopoziomowy, który przy MAR wykorzystuje wszystkie dostępne pomiary każdej osoby.
Krok 3. Co włożyć do modelu imputacji i ile imputacji wykonać
Zmienne w modelu imputacji
Model imputacji powinien być „bogatszy” niż model analizy. Graham (2009) podkreśla rolę zmiennych pomocniczych: zmiennych, które nie występują w analizie, ale wiążą się z brakującymi wartościami lub z samym faktem braku – dzięki nim rośnie moc, a maleje obciążenie. Nasza symulacja pokazała to wprost: ten sam algorytm bez stresu T1 dawał obciążoną średnią, a ze stresem T1 – trafną. Do modelu imputacji włącz:
- wszystkie zmienne z modelu analizy, łącznie ze zmienną zależną – pominięcie wyniku przy imputacji predyktorów fałszywie osłabia badane związki (Sterne i in., 2009);
- zmienne, od których zależą braki – u nas stres T1;
- zmienne skorelowane ze zmiennymi z brakami – u nas jakość snu, zadowolenie z życia i wiek;
- interakcje i składniki nieliniowe, jeśli występują w modelu analizy – inaczej imputacja je osłabi.
Ile imputacji?
Klasyczna rada mówiła o 3–5 imputacjach. Van Buuren (2018) zauważa, że często warto ustawić liczbę imputacji wyżej, w przedziale 20–100, a za standard de facto uznaje regułę, że liczba imputacji powinna być zbliżona do odsetka niepełnych przypadków. Na etapie budowania modelu wystarczy m = 5, a liczbę imputacji zwiększa się w analizie końcowej. U nas 38.4% osób ma przynajmniej jeden brak, więc wykonaliśmy 40 imputacji. Sterne i in. (2009) również zauważają, że choć pięć zbiorów uznawano za wystarczające ze względów teoretycznych, większa liczba (co najmniej 20) może być lepsza, bo zmniejsza losową zmienność samego procesu imputacji.
Ile braków to za dużo?
Popularne reguły kciuka wiążą decyzję z odsetkiem braków. Jakobsen i in. (2017) piszą na przykład w odniesieniu do badań klinicznych, że przy brakach poniżej około 5%, nieskupionych w określonych grupach, analiza przypadków kompletnych może być analizą główną, a przy bardzo dużym odsetku (np. powyżej 40%) w ważnych zmiennych wyniki można traktować jedynie jako generujące hipotezy. Madley-Dowd i in. (2019) pokazali jednak w symulacjach, że gdy dostępne są dobre zmienne pomocnicze, imputacja wielokrotna zmniejsza obciążenie i nie pogarsza efektywności nawet przy dużym odsetku braków MAR. Lepszym przewodnikiem niż odsetek braków jest według nich frakcja brakującej informacji. W naszym przykładzie regresja przypadków kompletnych traci 87 osób (34.8%), ale FMI dla efektu wsparcia wynosi tylko .27 – stres T1, sen i zadowolenie z życia odzyskują sporą część utraconej informacji.
Krok 4. Wyniki przykładu: imputacja wielokrotna a usuwanie przypadków
Zanim zinterpretujesz wyniki, porównaj wartości obserwowane i imputowane – Sterne i in. (2009) zalecają to zwłaszcza wtedy, gdy imputowana jest duża część danych. Rysunek 4 pokazuje stres w sesji: 177 wyników obserwowanych i 73 imputowane w każdym z 40 zbiorów.
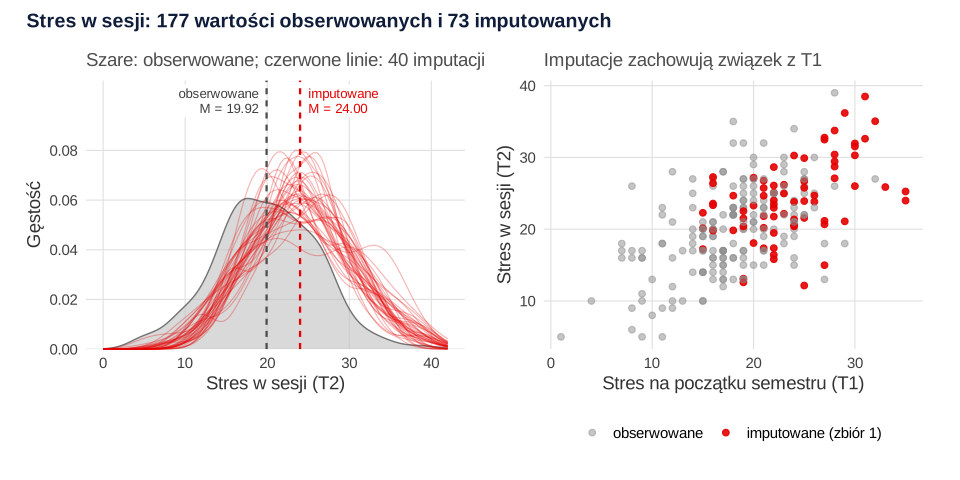
Imputowane wartości są średnio wyższe (M = 24.00) niż obserwowane (M = 19.92). To nie błąd, tylko oczekiwany skutek MAR: w sesji brakuje głównie osób, które już na początku semestru miały wysoki stres, a model imputacji to uwzględnia. Imputacje mieszczą się w zakresie wyników obserwowanych (5–39 punktów; w wariancie regresyjnym funkcja domyślnie przycina je do tego zakresu) i układają się wzdłuż związku stresu T1 ze stresem T2. Niepokój powinny budzić raczej wartości niemożliwe albo imputacje zupełnie oderwane od zmiennych pomocniczych.
Tabela 1 zestawia wyniki regresji po imputacji wielokrotnej z analizą przypadków kompletnych.
Tabela 1
Regresja stresu w sesji na wsparcie społeczne i płeć: imputacja wielokrotna i analiza przypadków kompletnych
| Predyktor | Imputacja wielokrotna (N = 250) | Przypadki kompletne (n = 163) | |||||||
|---|---|---|---|---|---|---|---|---|---|
| b | SE | 95% CI | p | FMI | b | SE | 95% CI | p | |
| Stała | 32.68 | 2.18 | [28.37, 36.98] | < .001 | .28 | 30.30 | 2.34 | [25.67, 34.93] | < .001 |
| Wsparcie społeczne | −2.21 | 0.40 | [−3.00, −1.42] | < .001 | .27 | −1.97 | 0.43 | [−2.81, −1.12] | < .001 |
| Płeć (mężczyzna)a | −0.10 | 0.99 | [−2.06, 1.86] | .920 | .31 | 0.34 | 1.00 | [−1.64, 2.31] | .737 |
Uwaga. Imputacja wielokrotna: 40 zbiorów (funkcja aregImpute, pakiet Hmisc), wyniki połączone regułami Rubina; stopnie swobody Barnarda–Rubina od 123.8 do 139.7. FMI = frakcja brakującej informacji. Zmienna zależna: stres w sesji (PSS-10, 0–40).
a Kategoria odniesienia: kobieta.
Po imputacji wielokrotnej związek wsparcia ze stresem w sesji jest nieco silniejszy (b = −2.21) niż w analizie przypadków kompletnych (b = −1.97), a przedział ufności – węższy, bo analiza korzysta z danych wszystkich 250 osób. Wyraźniej różni się średni stres w sesji: wśród osób, które wypełniły pomiar T2, wynosi M = 19.92 (SD = 6.13), a po imputacji wielokrotnej M = 21.11, 95% CI [20.20, 22.03]. Różnica 1.19 punktu to obciążenie, które wprowadziłaby analiza samych kompletnych przypadków – dokładnie w kierunku, który przewidziała symulacja.
Analiza wrażliwości: co, jeśli to jednak MNAR?
Założenia MAR nie da się sprawdzić, ale można sprawdzić, jak bardzo wnioski od niego zależą. Najprostsza analiza wrażliwości to przesunięcie imputowanych wartości o stałą δ: zakładamy, że osoby, które zrezygnowały, miały w sesji stres wyższy, niż przewiduje model MAR, i liczymy wszystko jeszcze raz. Przy δ = 2 punkty średni stres wzrasta do 21.70, 95% CI [20.75, 22.64], a efekt wsparcia wynosi b = −2.35, 95% CI [−3.17, −1.52]. Przy δ = 4 punkty średnia to 22.28, 95% CI [21.29, 23.28], a efekt wsparcia b = −2.49, 95% CI [−3.35, −1.62]. Wniosek o związku wsparcia ze stresem jest więc odporny na umiarkowane odstępstwa od MAR, natomiast oszacowanie średniego stresu zależy od założeń – i tak trzeba to opisać w pracy.
Jak opisać braki danych i imputację w pracy (APA)
Sterne i in. (2009) proponują listę informacji, które powinien zawierać raport z badania z brakami danych, a Jakobsen i in. (2017) – diagramy decyzyjne, kiedy i jak stosować imputację wielokrotną. Na tej podstawie przygotowaliśmy listę kontrolną:
- podaj liczbę i odsetek braków w każdej zmiennej oraz odsetek osób z kompletem danych;
- opisz, czy osoby z brakami i bez braków różnią się w ważnych zmiennych;
- nazwij metodę postępowania z brakami i jej założenie (MCAR, MAR);
- podaj program, funkcję i najważniejsze ustawienia imputacji oraz liczbę utworzonych zbiorów;
- wymień zmienne w modelu imputacji, w tym zmienne pomocnicze, i napisz, jak potraktowano zmienne kategorialne i o rozkładzie nienormalnym;
- przy dużym odsetku imputowanych danych porównaj wartości obserwowane i imputowane;
- w miarę możliwości podaj też wyniki analizy przypadków kompletnych;
- przedyskutuj, czy założenie MAR jest wiarygodne, i pokaż analizę wrażliwości.
Opis braków danych zwykle trafia do rozdziału metodologicznego, w podrozdziale o analizie danych (zob. jak napisać rozdział metodologiczny). Przykładowy akapit dla naszego badania:
I opis w rozdziale z wynikami:
Więcej gotowych zdań do raportowania regresji, testów i tabel znajdziesz we wpisie jak opisać wyniki w stylu APA.
Przykład w R: diagnoza braków i imputacja wielokrotna
Kod tworzy zbiór z przykładu (dane symulowane), diagnozuje braki, wykonuje imputację wielokrotną funkcją aregImpute(), łączy wyniki regułami Rubina i przeprowadza analizę wrażliwości. Liczby w tekście, w tabeli 1 i na rysunkach 2 i 4 pochodzą z tego kodu; symulację z rysunku 3 wykonano osobnym skryptem według tych samych zasad. Potrzebne pakiety: naniar, Hmisc i MASS.
1. Dane i diagnoza braków
R
library(naniar)   # diagnostyka braków danych
library(Hmisc, warn.conflicts = FALSE)   # aregImpute: imputacja wielokrotna

# Dane symulowane: 250 studentów, pomiar na początku semestru (T1) i w sesji (T2)
set.seed(2026)
n <- 250
R <- matrix(c( 1.00, -0.30,  0.35,  0.60, -0.35,
              -0.30,  1.00, -0.20, -0.40,  0.45,
               0.35, -0.20,  1.00,  0.40, -0.30,
               0.60, -0.40,  0.40,  1.00, -0.50,
              -0.35,  0.45, -0.30, -0.50,  1.00), 5)
z <- MASS::mvrnorm(n, mu = rep(0, 5), Sigma = R)
ogranicz <- function(x, od, do) pmin(pmax(x, od), do)
plec <- factor(sample(c("kobieta", "mężczyzna"), n, replace = TRUE, prob = c(.7, .3)))
k <- as.numeric(plec == "kobieta")
dane <- data.frame(
  plec           = plec,
  wiek           = sample(19:26, n, replace = TRUE),
  stres_t1       = round(ogranicz(18 + 1.5 * k + 6 * z[, 1], 0, 40)),     # PSS-10, 0–40
  wsparcie       = round(ogranicz(5.2 + 1.1 * z[, 2], 1, 7), 2),          # MSPSS, 1–7
  sen            = round(ogranicz(7 + 3 * z[, 3], 0, 21)),                # PSQI, 0–21 (więcej = gorszy sen)
  stres_t2       = round(ogranicz(20 + 1.5 * k + 6.5 * z[, 4], 0, 40)),   # PSS-10 w sesji
  zadowolenie_t2 = round(ogranicz(20 + 6 * z[, 5], 5, 35)))               # SWLS, 5–35
# Braki: rezygnacja z pomiaru T2 tym częstsza, im wyższy stres na początku semestru (MAR)
rezygnacja <- runif(n) < plogis(-1 + 1.0 * (dane$stres_t1 - 19) / 6)
dane$stres_t2[rezygnacja] <- NA
dane$zadowolenie_t2[rezygnacja | runif(n) < .03] <- NA
dane$wsparcie[runif(n) < .06] <- NA                                 # pominięte pytania
dane$sen[runif(n) < .05] <- NA

# 1. Ile braków i ile pełnych przypadków?
miss_var_summary(dane)
round(100 * mean(!complete.cases(dane)), 1)        # % osób z przynajmniej jednym brakiem

# 2. Test MCAR Little'a (zmienne liczbowe)
mcar_test(dane[, c("wiek", "stres_t1", "wsparcie", "sen", "stres_t2", "zadowolenie_t2")])

# 3. Czy brak pomiaru T2 zależy od zmiennych obserwowanych?
dane$brak_t2 <- is.na(dane$stres_t2)
t.test(stres_t1 ~ brak_t2, data = dane)
m_brak <- glm(brak_t2 ~ stres_t1 + wsparcie + plec + wiek, family = binomial, data = dane)
round(cbind(OR = exp(coef(m_brak)), p = summary(m_brak)$coefficients[, 4]), 3)
Wynik w R
# A tibble: 7 × 3
  variable       n_miss pct_miss
  <chr>           <int>    <num>
1 zadowolenie_t2     79     31.6
2 stres_t2           73     29.2
3 wsparcie           18      7.2
4 sen                 6      2.4
5 plec                0      0
6 wiek                0      0
7 stres_t1            0      0
[1] 38.4
# A tibble: 1 × 4
  statistic    df    p.value missing.patterns
      <dbl> <dbl>      <dbl>            <int>
1      73.2    25 0.00000129                7

	Welch Two Sample t-test

data:  stres_t1 by brak_t2
t = -8.5579, df = 143.44, p-value = 1.602e-14
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
 -7.313054 -4.568689
sample estimates:
mean in group FALSE  mean in group TRUE
           17.68927            23.63014

                 OR     p
(Intercept)   0.004 0.010
stres_t1      1.270 0.000
wsparcie      0.986 0.929
plecmężczyzna 1.017 0.963
wiek          0.988 0.871
2. Imputacja wielokrotna, reguły Rubina i analiza wrażliwości
R
# 4. Imputacja wielokrotna: m = 40 zbiorów (tyle, ile procent przypadków ma braki)
imp <- aregImpute(~ stres_t2 + zadowolenie_t2 + wsparcie + sen + stres_t1 + plec + wiek,
                  data = dane, n.impute = 40, type = "regression", nk = 0, pr = FALSE)
uzupelniony <- function(i) {                       # i-ty uzupełniony zbiór danych
  d <- dane
  for (v in c("stres_t2", "zadowolenie_t2", "wsparcie", "sen")) d[[v]][is.na(d[[v]])] <- imp$imputed[[v]][, i]
  d
}

# 5. Ta sama analiza w każdym zbiorze i łączenie wyników regułami Rubina
rubin <- function(modele) {
  m <- length(modele)
  Q <- sapply(modele, coef); U <- sapply(modele, function(f) diag(vcov(f)))
  if (is.null(dim(Q))) { Q <- matrix(Q, nrow = 1); U <- matrix(U, nrow = 1) }
  Qbar <- rowMeans(Q)                    # średnia oszacowań
  W <- rowMeans(U)                       # wariancja wewnątrz imputacji
  B <- apply(Q, 1, var)                  # wariancja między imputacjami
  Tv <- W + (1 + 1 / m) * B              # wariancja całkowita
  lambda <- (1 + 1 / m) * B / Tv
  df_com <- modele[[1]]$df.residual
  df_old <- (m - 1) / lambda^2
  df_obs <- (df_com + 1) / (df_com + 3) * df_com * (1 - lambda)
  df <- df_old * df_obs / (df_old + df_obs)            # stopnie swobody Barnarda–Rubina
  se <- sqrt(Tv); r <- (1 + 1 / m) * B / W
  wynik <- data.frame(b = Qbar, SE = se, t = Qbar / se, df = df, p = 2 * pt(-abs(Qbar / se), df),
                      dolna = Qbar - qt(.975, df) * se, gorna = Qbar + qt(.975, df) * se,
                      FMI = (r + 2 / (df + 3)) / (r + 1))
  rownames(wynik) <- rownames(Q)
  round(wynik, 3)
}
modele <- lapply(1:40, function(i) lm(stres_t2 ~ wsparcie + plec, data = uzupelniony(i)))
rubin(modele)

# 6. Dla porównania: usuwanie przypadków (lm pomija wiersze z brakami)
cc <- lm(stres_t2 ~ wsparcie + plec, data = dane)
nobs(cc)
round(cbind(summary(cc)$coefficients, confint(cc)), 3)

# 7. Średni stres w sesji: przypadki kompletne a imputacja wielokrotna
round(c(M = mean(dane$stres_t2, na.rm = TRUE), SD = sd(dane$stres_t2, na.rm = TRUE)), 2)
rubin(lapply(1:40, function(i) lm(stres_t2 ~ 1, data = uzupelniony(i))))

# 8. Analiza wrażliwości (odstępstwo od MAR): imputowany stres T2 wyższy o delta punktów
wrazliwosc <- function(delta) {
  zbiory <- lapply(1:40, function(i) {
    d <- uzupelniony(i); b <- is.na(dane$stres_t2)
    d$stres_t2[b] <- d$stres_t2[b] + delta
    d
  })
  rbind(srednia = rubin(lapply(zbiory, function(d) lm(stres_t2 ~ 1, data = d))),
        rubin(lapply(zbiory, function(d) lm(stres_t2 ~ wsparcie + plec, data = d)))["wsparcie", ])
}
wrazliwosc(2)
wrazliwosc(4)
Wynik w R
                   b    SE      t      df    p  dolna  gorna   FMI
(Intercept)   32.678 2.176 15.019 132.660 0.00 28.374 36.981 0.284
wsparcie      -2.212 0.401 -5.515 139.711 0.00 -3.005 -1.419 0.266
plecmężczyzna -0.099 0.989 -0.101 123.847 0.92 -2.056  1.857 0.308
[1] 163
              Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)     30.297      2.344  12.926    0.000 25.668 34.926
wsparcie        -1.965      0.429  -4.579    0.000 -2.813 -1.118
plecmężczyzna    0.336      0.998   0.337    0.737 -1.635  2.307
    M    SD
19.92  6.13
       b    SE      t      df p  dolna  gorna   FMI
1 21.113 0.462 45.727 149.273 0 20.201 22.025 0.245
              b    SE      t      df p  dolna  gorna   FMI
srednia  21.697 0.480 45.235 156.655 0 20.750 22.644 0.227
wsparcie -2.349 0.417 -5.630 144.670 0 -3.173 -1.524 0.254
              b    SE      t      df p  dolna  gorna   FMI
srednia  22.281 0.504 44.246 165.582 0 21.287 23.275 0.207
wsparcie -2.485 0.439 -5.659 151.496 0 -3.353 -1.618 0.237
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, naniar i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- naniar (wersja 1.1.0): Tierney, N., & Cook, D. (2023). Expanding tidy data principles to facilitate missing data exploration, visualization and assessment of imputations. Journal of Statistical Software, 105(7), 1–31. https://doi.org/10.18637/jss.v105.i07
- Hmisc (wersja 5.2.5): Harrell, F. E., Jr. (2026). Hmisc: Harrell miscellaneous (R package version 5.2-5) [Computer software]. https://doi.org/10.32614/CRAN.package.Hmisc
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy brakach danych
- Brak jakiejkolwiek informacji o brakach – czytelnik nie wie, ile osób odpadło i dlaczego n różni się między tabelami. Podawaj liczbę braków w każdej zmiennej (Sterne i in., 2009).
- Nieświadome usuwanie przypadków – domyślne ustawienia programu po cichu zmniejszają próbę. Sprawdzaj n w każdym wydruku.
- Imputacja średnią „bo tak było w SPSS” – zaniża zmienność i osłabia związki nawet przy MCAR (rysunek 3).
- Traktowanie nieistotnego testu Little’a jako dowodu MCAR – test może co najwyżej MCAR odrzucić (Jakobsen i in., 2017).
- Model imputacji bez zmiennej zależnej i bez zmiennych pomocniczych – imputacja osłabia wtedy badane związki albo nie usuwa obciążenia (Graham, 2009; Sterne i in., 2009).
- Analiza tylko jednego uzupełnionego zbioru albo uśrednianie danych zamiast wyników – to imputacja pojedyncza, która zaniża błędy standardowe. Analizuj każdy zbiór i łącz wyniki regułami Rubina.
- Decyzja wyłącznie na podstawie odsetka braków – liczy się mechanizm i dostępność zmiennych pomocniczych, a lepszą miarą jest frakcja brakującej informacji (Madley-Dowd i in., 2019).
- Imputowanie bez sprawdzenia wyniku – porównaj wartości obserwowane i imputowane, zanim przejdziesz do interpretacji.
Najczęstsze pytania
Co to są braki danych MCAR, MAR i MNAR?
To trzy mechanizmy braków opisane przez Rubina (1976). MCAR – braki całkowicie losowe, niezależne od czegokolwiek w badaniu. MAR – szansa braku zależy od zmiennych obserwowanych (np. stresu w pierwszym pomiarze). MNAR – szansa braku zależy od samej brakującej wartości. Od mechanizmu zależy, czy usuwanie przypadków lub imputacja dadzą trafne wyniki.
Czy można zastąpić braki danych średnią?
Nie. Imputacja średnią zaniża zmienność, osłabia korelacje i daje za wąskie przedziały ufności nawet przy brakach MCAR. W naszej symulacji 95% CI dla średniej obejmowały prawdziwą wartość tylko w 83.5% prób, a nachylenie regresji spadło z −2.60 do −1.82. Lepszym wyborem jest imputacja wielokrotna albo estymacja FIML.
Ile imputacji wykonać w imputacji wielokrotnej?
Dawniej zalecano 3–5 imputacji, dziś zwykle więcej. Według van Buurena (2018) standardem de facto stała się reguła, by liczba imputacji była zbliżona do odsetka niepełnych przypadków; Sterne i in. (2009) wskazują, że co najmniej 20 może być lepsze niż 5. Przy 38.4% niepełnych przypadków wykonaliśmy 40 imputacji.
Jaki odsetek braków danych jest dopuszczalny?
Nie ma jednego progu. Reguły kciuka (np. poniżej 5% można ograniczyć się do przypadków kompletnych) dotyczą sytuacji, gdy braki nie skupiają się w określonych grupach. Madley-Dowd i in. (2019) pokazali, że przy dobrych zmiennych pomocniczych imputacja wielokrotna działa także przy dużym odsetku braków MAR, a lepszym wskaźnikiem jest frakcja brakującej informacji (FMI).
Jak zrobić imputację wielokrotną w R?
Utwórz kilkadziesiąt uzupełnionych zbiorów, np. funkcją aregImpute() z pakietu Hmisc, w każdym wykonaj tę samą analizę, a wyniki połącz regułami Rubina: średnia oszacowań, wariancja całkowita T = W + (1 + 1/m)B. Do modelu imputacji włącz wszystkie zmienne analizy, także zmienną zależną, oraz zmienne pomocnicze.
Czy test Little’a potwierdza, że braki są losowe?
Nie. Istotny wynik testu Little’a pozwala odrzucić hipotezę MCAR, ale wynik nieistotny jej nie dowodzi, bo w małej próbie test ma niską moc. Test nie odróżnia też braków MAR od MNAR – tego nie da się sprawdzić na podstawie danych, dlatego warto dodać analizę wrażliwości.
Powiązane hasła
Przeczytaj też
Dane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dong, Y., & Peng, C.-Y. J. (2013). Principled missing data methods for researchers. SpringerPlus, 2(1), Article 222. https://doi.org/10.1186/2193-1801-2-222 ● Otwarty dostęp
- Enders, C. K. (2022). Applied missing data analysis (2nd ed.). Guilford Press.
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Jakobsen, J. C., Gluud, C., Wetterslev, J., & Winkel, P. (2017). When and how should multiple imputation be used for handling missing data in randomised clinical trials – A practical guide with flowcharts. BMC Medical Research Methodology, 17(1), Article 162. https://doi.org/10.1186/s12874-017-0442-1 ● Otwarty dostęp
- Korczyński, A. (2014). Review of methods for data sets with missing values and practical applications. Śląski Przegląd Statystyczny, 12(18), 83–103. https://doi.org/10.15611/sps.2014.12.05 ● Otwarty dostęp
- Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
- Madley-Dowd, P., Hughes, R., Tilling, K., & Heron, J. (2019). The proportion of missing data should not be used to guide decisions on multiple imputation. Journal of Clinical Epidemiology, 110, 63–73. https://doi.org/10.1016/j.jclinepi.2019.02.016 ● Otwarty dostęp
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley. https://doi.org/10.1002/9780470316696
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Sterne, J. A. C., White, I. R., Carlin, J. B., Spratt, M., Royston, P., Kenward, M. G., Wood, A. M., & Carpenter, J. R. (2009). Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls. BMJ, 338, Article b2393. https://doi.org/10.1136/bmj.b2393 ● Otwarty dostęp
- van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429492259 ● Otwarty dostęp: pełny tekst
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03 ● Otwarty dostęp
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{dong2013principled, author={Dong, Yiran and Peng, Chao-Ying Joanne}, title={{Principled missing data methods for researchers}}, journal={SpringerPlus}, year={2013}, volume={2}, number={1}, eid={222}, doi={10.1186/2193-1801-2-222}}@book{enders2022applied, author={Enders, Craig K.}, title={{Applied missing data analysis (2nd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Applied-Missing-Data-Analysis/Craig-Enders/9781462549863}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{jakobsen2017when, author={Jakobsen, Janus Christian and Gluud, Christian and Wetterslev, Jørn and Winkel, Per}, title={{When and how should multiple imputation be used for handling missing data in randomised clinical trials – A practical guide with flowcharts}}, journal={BMC Medical Research Methodology}, year={2017}, volume={17}, number={1}, eid={162}, doi={10.1186/s12874-017-0442-1}}@article{korczynski2014review, author={Korczyński, Adam}, title={{Review of methods for data sets with missing values and practical applications}}, journal={Śląski Przegląd Statystyczny}, year={2014}, volume={12}, number={18}, pages={83--103}, doi={10.15611/sps.2014.12.05}}@article{little1988test, author={Little, Roderick J. A.}, title={{A test of missing completely at random for multivariate data with missing values}}, journal={Journal of the American Statistical Association}, year={1988}, volume={83}, number={404}, pages={1198--1202}, doi={10.1080/01621459.1988.10478722}}@article{madleydowd2019proportion, author={Madley-Dowd, Paul and Hughes, Rachael and Tilling, Kate and Heron, Jon}, title={{The proportion of missing data should not be used to guide decisions on multiple imputation}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={110}, pages={63--73}, doi={10.1016/j.jclinepi.2019.02.016}}@article{rubin1976inference, author={Rubin, Donald B.}, title={{Inference and missing data}}, journal={Biometrika}, year={1976}, volume={63}, number={3}, pages={581--592}, doi={10.1093/biomet/63.3.581}}@book{rubin1987multiple, author={Rubin, Donald B.}, title={{Multiple imputation for nonresponse in surveys}}, year={1987}, publisher={Wiley}, doi={10.1002/9780470316696}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{sterne2009multiple, author={Sterne, Jonathan A. C. and White, Ian R. and Carlin, John B. and Spratt, Michael and Royston, Patrick and Kenward, Michael G. and Wood, Angela M. and Carpenter, James R.}, title={{Multiple imputation for missing data in epidemiological and clinical research: Potential and pitfalls}}, journal={BMJ}, year={2009}, volume={338}, eid={b2393}, doi={10.1136/bmj.b2393}}@book{vanbuuren2018flexible, author={van Buuren, Stef}, title={{Flexible imputation of missing data (2nd ed.)}}, year={2018}, publisher={Chapman \& Hall/CRC}, doi={10.1201/9780429492259}}@article{vanbuuren2011mice, author={van Buuren, Stef and Groothuis-Oudshoorn, Karin}, title={{mice: Multivariate imputation by chained equations in R}}, journal={Journal of Statistical Software}, year={2011}, volume={45}, number={3}, pages={1--67}, doi={10.18637/jss.v045.i03}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}