Co to jest odchylenie standardowe?
Odchylenie standardowe (ang. standard deviation; w raportach SD, we wzorach s, w populacji σ) mówi, jak bardzo wyniki rozpraszają się wokół średniej. Jest pierwiastkiem z wariancji, co ma znaczenie praktyczne: wariancja jest wyrażona w jednostkach do kwadratu, a odchylenie standardowe – w jednostkach mierzonej zmiennej, np. w punktach testu albo w milisekundach. Dlatego do opisu danych wygodniejsze jest SD (Lee i in., 2015).
W psychologii odchylenie standardowe towarzyszy niemal każdej średniej: w tabeli charakterystyki próby, w normach testów (skala IQ ma SD = 15, skala tenowa – 10), we wzorze na wyniki standaryzowane z i w wielkości efektu d Cohena. Altman i Bland (2005) podkreślają, że SD opisuje zmienność obserwacji i jest poprawną miarą tej zmienności niezależnie od kształtu rozkładu. Kształt rozkładu ma natomiast znaczenie, gdy chcemy z SD odczytać odsetek osób w danym przedziale.
Wzór na odchylenie standardowe
- xi – wynik i-tej osoby,
- M – średnia w próbie,
- (xi − M)² – kwadrat odchylenia wyniku od średniej,
- n − 1 – liczba stopni swobody.
Dzielimy przez n − 1, a nie przez n, bo odchylenia liczymy od średniej z próby, a nie od nieznanej średniej populacji. Dzięki tej poprawce wariancja z próby średnio nie zaniża wariancji w populacji – symulację pokazujemy w haśle o wariancji. Wzór z n w mianowniku (σ) stosuje się wtedy, gdy znamy wyniki całej populacji. Funkcja sd() w R, SPSS oraz funkcja STDEV.S w Excelu (w polskiej wersji ODCH.STANDARD.PRÓBKI) liczą wersję z n − 1.
Przykład krok po kroku
Sześcioro studentów wypełniło skalę odczuwanego stresu PSS-10 (zakres 0–40 pkt). Ich wyniki to 30, 17, 21, 13, 14 i 19 punktów, a średnia wynosi M = 114 / 6 = 19 pkt.
| Osoba | Wynik x | Odchylenie x − M | Kwadrat (x − M)² |
|---|---|---|---|
| 1 | 30 | 11 | 121 |
| 2 | 17 | −2 | 4 |
| 3 | 21 | 2 | 4 |
| 4 | 13 | −6 | 36 |
| 5 | 14 | −5 | 25 |
| 6 | 19 | 0 | 0 |
| Suma | 114 | 0 | 190 |
- Odejmij średnią od każdego wyniku. Odchylenia sumują się do zera, dlatego nie można ich po prostu uśrednić.
- Podnieś odchylenia do kwadratu i zsumuj: Σ(x − M)² = 190.
- Podziel sumę przez n − 1 = 5 – otrzymujesz wariancję s² = 190 / 5 = 38.
- Wyciągnij pierwiastek: SD = √38 = 6.16 pkt.
Po podzieleniu przez n = 6 wyszłoby 5.63 pkt – przy tak małej próbie różnica jest wyraźna. Wynik interpretujemy w jednostkach skali: wyniki studentów różnią się od średniej typowo o około 6 punktów. Ściśle biorąc, SD to pierwiastek ze średniego kwadratu odchylenia, a nie zwykła średnia odległość od średniej, ale do interpretacji ta intuicja wystarcza.
Jak interpretować odchylenie standardowe?
Sama średnia nie mówi, czy wyniki są do siebie podobne. Rysunek 1 pokazuje dwie grupy po 40 osób z identyczną średnią lęku przed egzaminem (M = 45.30 pkt na skali 20–80), ale bardzo różnym rozproszeniem.
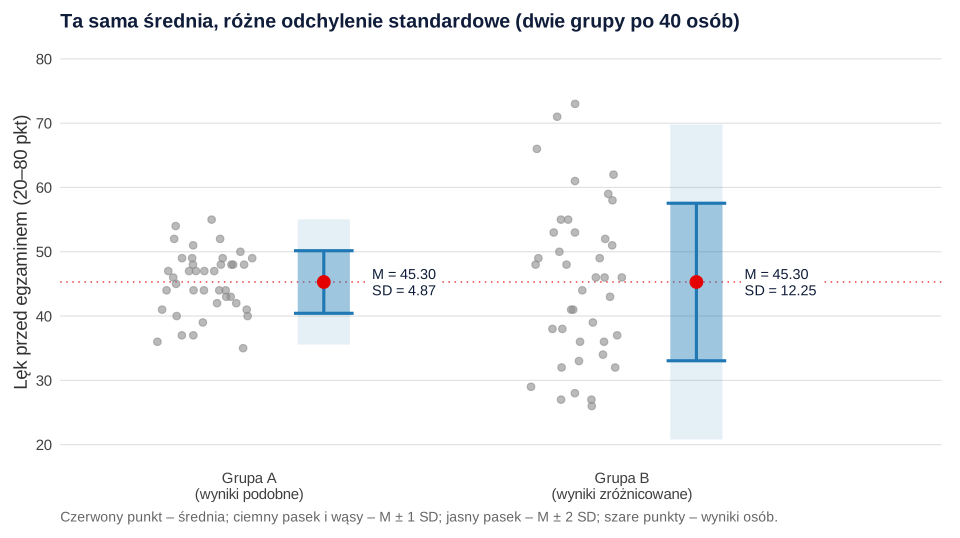
W grupie A odchylenie standardowe wynosi 4.87 pkt, a w grupie B – 12.25 pkt, czyli 2.52 raza więcej. W grupie A nikt nie uzyskał 60 punktów lub więcej, a w grupie B takich osób jest pięć – i tyle samo ma wynik 30 punktów lub niższy. Średnie są równe, ale z perspektywy praktyka to dwie różne grupy: w B są zarówno osoby bardzo spokojne, jak i silnie zestresowane. Przy interpretacji pamiętaj o trzech zasadach:
- Odnoś SD do zakresu skali i do norm. 12 punktów na skali 20–80 to duże zróżnicowanie; w skali IQ odchylenie standardowe z definicji wynosi 15.
- Porównuj SD tylko dla tej samej miary. Wyniki z różnych skal sprowadź najpierw do wspólnej miary: z = (x − M) / SD.
- SD nie maleje wraz z liczebnością próby. Gdy n rośnie, stabilizuje się wokół wartości w populacji – maleje dopiero błąd standardowy.
Reguła 68–95–99.7 i jej granice
Jeśli zmienna ma rozkład normalny, odchylenie standardowe wyznacza stałe proporcje: w przedziale M ± 1 SD leży 68.27% wyników, w przedziale M ± 2 SD – 95.45%, a w M ± 3 SD – 99.73%. To tzw. reguła trzech sigm. W skali IQ (100 ± 15) około dwie trzecie osób ma więc wynik od 85 do 115, a około 95% – od 70 do 130.
W danych zbliżonych do normalnych reguła działa nieźle: w grupie A w przedziale ±1 SD znalazło się 70.0% osób, a w przedziale ±2 SD – 97.5%. W rozkładzie skośnym reguła wprowadza w błąd. Dla 120 czasów reakcji z hasła o średniej (M = 644.71 ms, SD = 154.37) w przedziale ±1 SD mieści się 81.7% osób, a dolna granica przedziału ±2 SD (336.0 ms) leży daleko poniżej najszybszego wyniku (420 ms). Rozproszenie jest asymetryczne: poniżej M − 1 SD jest 8 osób, a powyżej M + 1 SD – 14. Odsetki w przedziałach ±1, ±2 i ±3 SD zależą od kształtu rozkładu – jego asymetrii i grubości ogonów (kurtozy). Przy skośnych danych opisz rozproszenie rozstępem ćwiartkowym albo pokaż cały rozkład na histogramie.
Odchylenie standardowe a błąd standardowy
Odchylenie standardowe opisuje rozproszenie wyników osób, a błąd standardowy (SE = SD / √n) – niepewność oszacowania średniej. To różnica między opisem danych a wnioskowaniem (Altman i Bland, 2005). Ponieważ czytelnika interesuje zmienność w próbie, w statystykach opisowych podawaj SD, a SE wykorzystuj do wyznaczania przedziałów ufności (Barde i Barde, 2012). W grupie B SD = 12.25, a SE = 12.25 / √40 = 1.94. Podanie SE w miejscu SD sprawiłoby, że grupa wyglądałaby na ponad sześć razy mniej zróżnicowaną.
Jak opisać odchylenie standardowe w pracy (APA)
W APA odchylenie standardowe zapisuje się kursywą jako SD i podaje razem ze średnią – w tekście w nawiasie po średniej albo w sąsiedniej kolumnie tabeli (zob. tabela statystyk opisowych w APA). Użyj tej samej liczby miejsc po przecinku co przy średniej.
Krótszy zapis w nawiasie: „grupa A: M = 45.30, SD = 4.87; grupa B: M = 45.30, SD = 12.25”. To, czy różnica rozproszenia jest istotna statystycznie, sprawdzisz testem równości wariancji, np. testem Levene’a – przykład dla tych samych grup pokazujemy w haśle o wariancji.
Przykład w R
Kod liczy odchylenie standardowe krok po kroku i funkcją sd(), a potem porównuje dwie grupy z rysunku 1. W SPSS odchylenie standardowe znajdziesz w menu Analyze → Descriptive Statistics → Descriptives (pole Std. deviation).
Odchylenie standardowe ręcznie i funkcją sd()
R
set.seed(130)
pss <- round(rnorm(6, mean = 20, sd = 6))   # stres (PSS-10) u 6 osób
pss
odch <- pss - mean(pss)                     # odchylenia od średniej
rbind(odch = odch, kwadrat = odch^2)
sum(odch^2) / (length(pss) - 1)             # wariancja z próby
sqrt(sum(odch^2) / (length(pss) - 1))       # SD „ręcznie”
sd(pss)                                     # to samo funkcją sd() (mianownik n - 1)
set.seed(540)
a <- pmin(pmax(round(rnorm(40, 45, 5)), 20), 80)    # grupa A: lęk przed egzaminem
b <- pmin(pmax(round(rnorm(40, 45, 12)), 20), 80)   # grupa B
sapply(list(A = a, B = b), function(x)
  round(c(M = mean(x), SD = sd(x), w_1SD = mean(abs(x - mean(x)) <= sd(x))), 2))
Wynik w R
[1] 30 17 21 13 14 19
        [,1] [,2] [,3] [,4] [,5] [,6]
odch      11   -2    2   -6   -5    0
kwadrat  121    4    4   36   25    0
[1] 38
[1] 6.164414
[1] 6.164414
          A     B
M     45.30 45.30
SD     4.87 12.25
w_1SD  0.70  0.62
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- SE zamiast SD w statystykach opisowych – wyniki wyglądają na mniej zróżnicowane, niż są (Barde i Barde, 2012).
- Wzór z n zamiast n − 1 – zdarza się przy liczeniu w arkuszu (STDEV.P zamiast STDEV.S); w małych próbach zaniża SD.
- Przedział M ± 2 SD dla skośnych danych – może wyjść poza możliwy zakres wyników, np. poniżej najkrótszego czasu reakcji albo minimum skali.
- Wykrywanie obserwacji odstających regułą M ± 3 SD – średnia i SD same reagują na wartości odstające; Leys i in. (2013) zalecają zamiast tego medianę i MAD (zob. obserwacja odstająca).
- Porównywanie SD zmiennych mierzonych na różnych skalach – najpierw ustandaryzuj wyniki albo porównuj tylko tę samą miarę.
- SD bez średniej – zawsze podawaj obie wartości razem: M (SD).
Najczęstsze pytania
Jak obliczyć odchylenie standardowe?
Policz średnią, odejmij ją od każdego wyniku, podnieś odchylenia do kwadratu i zsumuj. Sumę podziel przez n − 1 (to wariancja), a z wyniku wyciągnij pierwiastek. Dla wyników 30, 17, 21, 13, 14 i 19 suma kwadratów wynosi 190, wariancja 38, a SD = √38 = 6.16. W R: sd(x).
Co oznacza odchylenie standardowe?
Mówi, o ile wyniki typowo różnią się od średniej, w jednostkach mierzonej zmiennej. SD = 4.87 pkt oznacza wyniki skupione wokół średniej, a SD = 12.25 pkt przy tej samej średniej – duże różnice między osobami. Przy rozkładzie normalnym około 68% wyników leży w przedziale M ± 1 SD.
Dlaczego we wzorze na odchylenie standardowe dzieli się przez n − 1?
Odchylenia liczy się od średniej z próby, która jest dopasowana do tych samych danych, więc suma kwadratów odchyleń jest średnio mniejsza niż wokół prawdziwej średniej populacji. Dzielenie przez n zaniżałoby wariancję, a poprawka n − 1 usuwa to obciążenie. Symulację pokazujemy w haśle wariancja.
Czym różni się odchylenie standardowe od błędu standardowego?
SD opisuje rozproszenie wyników w próbie, a błąd standardowy (SE = SD/√n) – precyzję oszacowania średniej. W statystykach opisowych podawaj SD, a SE wykorzystuj do przedziałów ufności. Więcej w haśle błąd standardowy.
Jakie odchylenie standardowe jest duże, a jakie małe?
Nie ma uniwersalnego progu – SD ocenia się względem zakresu skali, norm testu i wyników innych badań z tą samą miarą. Pomaga wynik standaryzowany: osoba o jedno odchylenie standardowe powyżej średniej ma z = 1. Przy porównywaniu grup tę rolę pełnią miary wielkości efektu, np. d Cohena.
Jak zapisać odchylenie standardowe w APA?
Kursywą jako SD, razem ze średnią i z tą samą liczbą miejsc po przecinku: M = 45.30, SD = 12.25 albo M = 45.30 (SD = 12.25). W tabelach M i SD umieszcza się w sąsiednich kolumnach.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- Barde, M. P., & Barde, P. J. (2012). What to use to express the variability of data: Standard deviation or standard error of mean? Perspectives in Clinical Research, 3(3), 113–116. https://doi.org/10.4103/2229-3485.100662 ● Otwarty dostęp
- Lee, D. K., In, J., & Lee, S. (2015). Standard deviation and standard error of the mean. Korean Journal of Anesthesiology, 68(3), 220–223. https://doi.org/10.4097/kjae.2015.68.3.220 ● Otwarty dostęp
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@article{barde2012what, author={Barde, Mohini P. and Barde, Prajakt J.}, title={{What to use to express the variability of data: Standard deviation or standard error of mean?}}, journal={Perspectives in Clinical Research}, year={2012}, volume={3}, number={3}, pages={113--116}, doi={10.4103/2229-3485.100662}}@article{lee2015standard, author={Lee, Dong Kyu and In, Junyong and Lee, Sangseok}, title={{Standard deviation and standard error of the mean}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={3}, pages={220--223}, doi={10.4097/kjae.2015.68.3.220}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}