Co to jest reguła trzech sigm?
Reguła trzech sigm (reguła 68–95–99.7, ang. three-sigma rule, empirical rule) mówi, że w rozkładzie normalnym w odległości do jednego odchylenia standardowego (σ, sigma) od średniej leży 68.27% wyników, do dwóch – 95.45%, a do trzech – 99.73%. Poza przedziałem μ ± 3σ zostaje 0.27% wyników, czyli mniej więcej jeden na 370. Ilustrację tych pasm na skali IQ znajdziesz w haśle o rozkładzie normalnym.
Tą nazwą określa się w praktyce dwie rzeczy. Pierwsza to opis rozkładu: jaki odsetek wyników przypada na kolejne odchylenia standardowe. Druga to reguła decyzyjna: wynik oddalony od średniej o więcej niż trzy odchylenia standardowe uznaje się za bardzo nietypowy. Tak wyznacza się granice w kontroli jakości i tak działa najpopularniejsze kryterium obserwacji odstających, |z| > 3 (zob. standaryzacja zmiennej). Obie wersje mają ten sam warunek: dokładne odsetki obowiązują tylko w rozkładzie normalnym.
| Przedział | W przedziale | Poza przedziałem | Skala IQ (100 ± 15) |
|---|---|---|---|
| μ ± 1σ | 68.27% | 31.73% | 85–115 |
| μ ± 2σ | 95.45% | 4.55% | 70–130 |
| μ ± 2.5σ | 98.76% | 1.24% | 62.5–137.5 |
| μ ± 3σ | 99.73% | 0.27% | 55–145 |
Co gwarantuje reguła, gdy rozkład nie jest normalny?
Dla dowolnego rozkładu o skończonej wariancji nierówność Czebyszewa gwarantuje tylko tyle, że w przedziale ±k odchyleń standardowych leży co najmniej 1 − 1/k² wyników. Dla rozkładów jednomodalnych, czyli z jednym szczytem, ograniczenie jest ostrzejsze. Nierówność Wysoczańskiego–Petunina daje co najmniej 1 − 4/(9k²) wyników w przedziale (dla k > 1.63). Pukelsheim (1994) pokazał, że właśnie z tej nierówności – opartej z kolei na nierówności Gaussa – wynika reguła trzech sigm dla rozkładów jednomodalnych.
| Rozkład | ±1 SD | ±2 SD | ±3 SD |
|---|---|---|---|
| Normalny (dokładnie) | 68.27% | 95.45% | 99.73% |
| Dowolny jednomodalny (co najmniej) | — | 88.89% | 95.06% |
| Dowolny (co najmniej) | 0% | 75.00% | 88.89% |
W rozkładzie z jednym szczytem poza ±3 SD może więc leżeć najwyżej 4.94% wyników. To górna granica, ale nawet znacznie mniejsze wartości są wielokrotnie wyższe niż 0.27% z rozkładu normalnego.
Kiedy reguła zawodzi: symulacja
Idealnie normalne dane w psychologii zdarzają się rzadko. Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów osiągnięć i miar psychometrycznych – wszystkie istotnie odbiegały od normalności, m.in. asymetrią i ciężkimi ogonami. Cain i in. (2017) stwierdzili odchylenie od normalności w 74% z 1567 rozkładów jednowymiarowych z publikowanych badań. Sprawdziliśmy więc, jak reguła działa w rozkładach typowych dla psychologii. Wylosowaliśmy po milion wyników z pięciu rozkładów i policzyliśmy, jaki odsetek mieści się w przedziałach M ± 1, 2 i 3 SD.
| Rozkład | Skośność | Kurtoza | ±1 SD | ±2 SD | ±3 SD | Poniżej −3 SD | Powyżej +3 SD |
|---|---|---|---|---|---|---|---|
| Normalny (np. IQ) | 0.00 | 0.00 | 68.29% | 95.45% | 99.73% | 0.13% | 0.14% |
| Czas reakcji (prawoskośny) | 1.71 | 4.94 | 77.53% | 95.24% | 98.35% | 0.00% | 1.65% |
| Liczba objawów (dużo zer) | 2.05 | 6.17 | 86.86% | 94.15% | 98.25% | 0.00% | 1.75% |
| Łatwy test z efektem sufitu (0–20 pkt) | −0.60 | 0.27 | 74.53% | 95.65% | 99.75% | 0.25% | 0.00% |
| Ciężkie ogony (90% osób typowych, 10% bardziej zmiennych) | 0.00 | 5.32 | 77.26% | 95.64% | 98.21% | 0.89% | 0.90% |
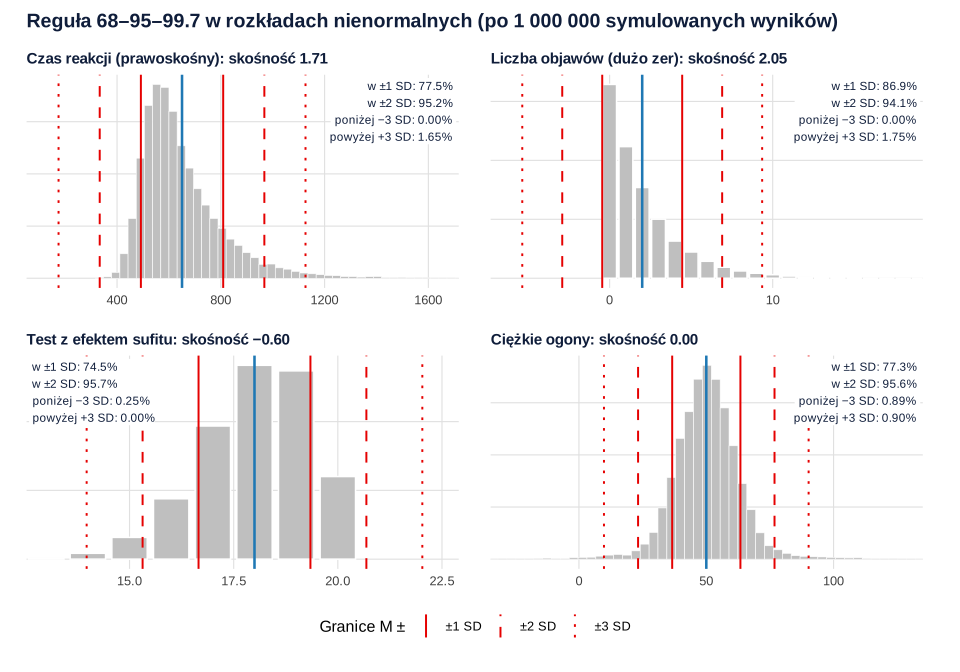
Z symulacji płyną trzy wnioski:
- „Dwie trzecie wyników w ±1 SD” to cecha rozkładu normalnego. W pozostałych rozkładach przedział ten obejmował od 74.53% do 86.86% wyników. Przedział ±2 SD okazał się stabilniejszy – od 94.15% do 95.65%.
- Za granicą ±3 SD wychodzi kilka razy więcej wyników. W rozkładzie czasów reakcji było to 1.65%, w liczbie objawów 1.75%, a w rozkładzie o ciężkich ogonach łącznie 1.79% – sześć do siedmiu razy więcej niż 0.27%. Ciężkie ogony oznaczają wysoką kurtozę.
- W rozkładach skośnych skrajne wyniki leżą tylko po jednej stronie. W czasach reakcji i liczbie objawów wyłącznie w prawym ogonie, w łatwym teście – wyłącznie w lewym. Granica +3 SD w łatwym teście wynosi 22.03 pkt, czyli leży poza zakresem skali (zob. efekt sufitu i podłogi), a granica −3 SD w liczbie objawów to −5.36.
Zanim użyjesz reguły, sprawdź kształt rozkładu na histogramie i wykresie Q-Q. Jak to zrobić i co dalej, opisujemy we wpisie jak sprawdzić normalność rozkładu.
Reguła trzech sigm a obserwacje odstające
Kryterium |z| > 3 to najczęściej stosowana reguła wykrywania obserwacji odstających. Ma jednak cztery słabości:
- W danych normalnych też oznacza prawidłowe wyniki. Oczekiwana liczba wyników poza ±3 SD to 0.27 na 100 osób i 2.7 na 1000. W naszej symulacji (10 000 prób z rozkładu normalnego) co najmniej jedną „obserwację odstającą” znaleziono w 20.3% prób stuosobowych, w 54.9% prób trzystuosobowych i w 94.2% prób tysiącosobowych.
- W małej próbie nie działa wcale. Wynik z obliczony z próby nie może przekroczyć (n − 1)/√n: przy n = 5 to 1.79, a przy n = 10 – 2.85. W próbie do 10 osób reguła |z| > 3 nie oznaczy więc żadnego wyniku, nawet całkowicie niemożliwego. Dopiero przy 11 osobach granica przekracza 3 (3.02).
- Maskowanie. Średnia i SD są liczone razem z obserwacjami odstającymi, które zawyżają SD i oddalają granice (Leys i in., 2013).
- Asymetria. W rozkładzie skośnym reguła oznacza wyniki tylko w jednym ogonie – często prawdziwe i ważne dla badania.
Bakker i Wicherts (2014) pokazali ponadto, że usuwanie obserwacji odstających według progów z przed testem t silnie zawyża błąd I rodzaju, zwłaszcza gdy próg wybiera się po obejrzeniu wyników. Leys i in. (2013) zalecają zastąpić średnią i SD medianą i medianowym odchyleniem bezwzględnym (MAD). Pełną procedurę z przykładami opisujemy w poradniku wartości odstające: jak je wykryć i co z nimi zrobić.
Przykład: objawy depresji u 500 studentów
Pięciuset studentów wypełniło kwestionariusz objawów depresji (0–63 pkt; dane symulowane). Średnia wyniosła M = 10.14, odchylenie standardowe SD = 7.58, a skośność 1.11. Granice M ± 3 SD to −12.60 i 32.88 pkt. Dolna leży poniżej minimum skali, więc w lewym ogonie nikt nie może jej przekroczyć. W przedziale ±1 SD mieści się 70.0% osób, ±2 SD – 95.2%, a ±3 SD – 98.6%. Poza górną granicą znalazło się 7 osób z wynikami od 33 do 45 pkt.
Czy to obserwacje odstające do usunięcia? Raczej nie. To osoby z najsilniejszymi objawami, które w badaniu nad depresją bywają najważniejsze, a ich usunięcie zaniżyłoby zmienność i osłabiło związki z innymi zmiennymi. Kryterium Mdn ± 3 MAD (granice −13.24 i 31.24 pkt) oznaczyło dokładnie te same 7 osób. W wyraźnie skośnym rozkładzie żadna symetryczna reguła nie odróżni prawdziwych skrajnych wyników od błędów. Rozsądniej sprawdzić zakres – wszystkie wyniki mieszczą się w skali 0–63 – i analizować dane metodami, które nie wymagają normalności, np. testami nieparametrycznymi.
Jak opisać w pracy
Jeśli używasz reguły do opisu rozkładu, najpierw sprawdź, czy rozkład jest zbliżony do normalnego, i napisz, na jakiej podstawie to oceniłeś. Jeśli stosujesz |z| > 3 jako kryterium obserwacji odstających, podaj uzasadnienie, liczbę oznaczonych osób i wyniki analizy bez wykluczeń; lepiej jednak zaplanować kryterium odporne. Przykładowy opis dla danych z przykładu:
Przykład w R
Kod liczy odsetki z rozkładu normalnego i z nierówności, powtarza symulację pięciu rozkładów, sprawdza regułę |z| > 3 w małych i dużych próbach oraz w przykładzie z objawami depresji. Skośność i kurtozę liczy funkcja z pakietu psych tym samym wzorem co SPSS (type = 2).
Reguła 68–95–99.7 w rozkładzie normalnym i poza nim
R
library(psych)
# 1. Rozkład normalny i gwarancje dla innych rozkładów (odsetek wyników w M ± k SD)
k <- c(1, 2, 3)
gwarancje <- rbind(normalny     = 100 * (pnorm(k) - pnorm(-k)),
                   jednomodalny = c(NA, 100 * (1 - 4 / (9 * k[2:3]^2))),  # Wysoczański–Petunin, k > 1.63
                   dowolny      = 100 * (1 - 1 / k^2))                 # Czebyszew
colnames(gwarancje) <- paste0("±", k, " SD"); round(gwarancje, 2)

# 2. Symulacja: po 1 000 000 wyników z rozkładów typowych dla psychologii
set.seed(49)
N <- 1e6
rozklady <- list(
  normalny     = rnorm(N, 100, 15),                          # np. IQ
  czas_reakcji = rnorm(N, 500, 50) + rexp(N, 1 / 150),       # prawoskośny (ms)
  objawy       = rnbinom(N, mu = 2, size = 1),               # liczba objawów, dużo zer
  sufit        = rbinom(N, 20, 0.9),                         # łatwy test 0–20 pkt
  ciezkie_ogony = ifelse(runif(N) < .9, rnorm(N, 50, 10), rnorm(N, 50, 30)))
round(t(sapply(rozklady, function(x) {
  z <- (x - mean(x)) / sd(x)
  c(skos = skew(x, type = 2), kurt = kurtosi(x, type = 2), w1 = 100 * mean(abs(z) <= 1),
    w2 = 100 * mean(abs(z) <= 2), w3 = 100 * mean(abs(z) <= 3),
    pod3 = 100 * mean(z < -3), nad3 = 100 * mean(z > 3))
})), 2)

# 3. Reguła jako kryterium obserwacji odstających
n <- c(5, 10, 11, 20, 30)
round((n - 1) / sqrt(n), 2)                          # największe możliwe |z| w próbie n osób
set.seed(4903)
sapply(c(30, 100, 300, 1000), function(n)            # P(choć jeden |z| > 3) w danych normalnych
  mean(replicate(10000, { x <- rnorm(n); any(abs(x - mean(x)) / sd(x) > 3) })))

# 4. Przykład: objawy depresji (0–63 pkt) u 500 studentów
set.seed(63)
dep <- pmin(rnbinom(500, mu = 10, size = 2.2), 63)
z <- (dep - mean(dep)) / sd(dep)
round(c(M = mean(dep), SD = sd(dep), skosnosc = skew(dep, type = 2),
        dolna = mean(dep) - 3 * sd(dep), gorna = mean(dep) + 3 * sd(dep)), 2)
sort(dep[abs(z) > 3])                                # wyniki poza M ± 3 SD
Wynik w R
             ±1 SD ±2 SD ±3 SD
normalny     68.27 95.45 99.73
jednomodalny    NA 88.89 95.06
dowolny       0.00 75.00 88.89
               skos kurt    w1    w2    w3 pod3 nad3
normalny       0.00 0.00 68.29 95.45 99.73 0.13 0.14
czas_reakcji   1.71 4.94 77.53 95.24 98.35 0.00 1.65
objawy         2.05 6.17 86.86 94.15 98.25 0.00 1.75
sufit         -0.60 0.27 74.53 95.65 99.75 0.25 0.00
ciezkie_ogony  0.00 5.32 77.26 95.64 98.21 0.89 0.90
[1] 1.79 2.85 3.02 4.25 5.29
[1] 0.0326 0.2034 0.5495 0.9423
       M       SD skosnosc    dolna    gorna
   10.14     7.58     1.11   -12.60    32.88
[1] 33 34 35 35 35 37 45
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Stosowanie reguły do rozkładów skośnych, np. czasów reakcji czy liczby objawów – odsetki w ±1 i ±3 SD są wtedy zupełnie inne niż 68% i 99.7%.
- Granica spoza zakresu skali jako „próg” – w przykładzie M − 3 SD wynosiło −12.60 pkt przy skali 0–63.
- Usuwanie wszystkich wyników |z| > 3 w dużej próbie – nawet w danych normalnych taki wynik pojawił się w 94.2% prób tysiącosobowych.
- Szukanie |z| > 3 w małej próbie – przy 10 osobach i mniej żaden wynik nie może przekroczyć tej granicy.
- Odczytywanie rzadkości wyniku z tablic rozkładu normalnego („jeden na 370”), gdy rozkład jest skośny albo ma ciężkie ogony.
- Utożsamianie wyniku poza ±3 SD z błędem – to sygnał do sprawdzenia, a nie dowód (zob. obserwacja odstająca).
Najczęstsze pytania
Co to jest reguła trzech sigm?
To zasada, według której w rozkładzie normalnym w przedziale średnia ± 1 odchylenie standardowe leży 68.27% wyników, ± 2 – 95.45%, a ± 3 – 99.73%. Poza przedziałem ± 3σ zostaje 0.27% wyników, czyli około jeden na 370. Dokładne odsetki dotyczą tylko rozkładu normalnego.
Czy reguła 68–95–99.7 działa dla każdego rozkładu?
Nie. Dla dowolnego rozkładu nierówność Czebyszewa gwarantuje tylko co najmniej 75% wyników w ± 2 SD i 88.89% w ± 3 SD, a dla rozkładów z jednym szczytem – co najmniej 88.89% i 95.06%. W symulowanych rozkładach skośnych w ± 1 SD leżało od 74.53% do 86.86% wyników, a poza ± 3 SD – do 1.79%.
Czy można usuwać obserwacje odstające regułą 3 SD?
To ryzykowne. Średnia i SD same reagują na wartości odstające, więc kilka skrajnych wyników może się zamaskować; w próbie do 10 osób żaden wynik nie może mieć |z| > 3, a w dużej próbie z rozkładu normalnego reguła zawsze oznaczy kilka prawidłowych wyników. Leys i in. (2013) zalecają medianę i medianowe odchylenie bezwzględne (MAD).
Ile wyników leży poza 3 odchyleniami standardowymi?
W rozkładzie normalnym 0.27%, czyli 2.7 osoby na 1000. W rozkładach skośnych i o ciężkich ogonach może to być kilka razy więcej – w naszej symulacji 1.65% dla czasów reakcji i 1.75% dla liczby objawów, w obu przypadkach wyłącznie w prawym ogonie.
Skąd się wzięła nazwa reguła trzech sigm?
Od greckiej litery σ (sigma), którą oznacza się odchylenie standardowe w populacji. „Trzy sigmy” to przedział μ ± 3σ, który w rozkładzie normalnym obejmuje 99.73% wyników. Pukelsheim (1994) pokazał, że słabsza wersja tej reguły obowiązuje dla każdego rozkładu jednomodalnego: poza ± 3σ leży wtedy najwyżej 4.94% wyników.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bakker, M., & Wicherts, J. M. (2014). Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations. Psychological Methods, 19(3), 409–427. https://doi.org/10.1037/met0000014
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Pukelsheim, F. (1994). The three sigma rule. The American Statistician, 48(2), 88–91. https://doi.org/10.1080/00031305.1994.10476030 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bakker2014outlier, author={Bakker, Marjan and Wicherts, Jelte M.}, title={{Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations}}, journal={Psychological Methods}, year={2014}, volume={19}, number={3}, pages={409--427}, doi={10.1037/met0000014}}@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{pukelsheim1994three, author={Pukelsheim, Friedrich}, title={{The three sigma rule}}, journal={The American Statistician}, year={1994}, volume={48}, number={2}, pages={88--91}, doi={10.1080/00031305.1994.10476030}}