Co to jest nierówność Czebyszewa?
Nierówność Czebyszewa (ang. Chebyshev’s inequality, także nierówność Bienaymé–Czebyszewa) mówi, że dla każdej zmiennej o skończonej wariancji P(|X − μ| ≥ kσ) ≤ 1/k2. Niezależnie od kształtu rozkładu dalej niż k odchyleń standardowych od średniej leży najwyżej 1/k2 wyników: przy k = 2 najwyżej 25%, przy k = 3 najwyżej 11.1%. Seneta (2013) pokazuje, że w historii prawa wielkich liczb to właśnie ta nierówność łączy kierunek francuski z rosyjskim.
Do czego służy
- Gwarancja bez założeń. Ograniczenie obowiązuje dla dowolnego rozkładu, ale dlatego jest ostrożne. W rozkładzie normalnym poza ±3σ leży 0.27% wyników, a Czebyszew dopuszcza 11.1%.
- Prawo wielkich liczb. Średnia z n obserwacji ma wariancję σ2/n, więc P(|M − μ| ≥ ε) ≤ σ2/(nε2). Gdy n rośnie, prawa strona maleje do zera – to najprostszy dowód prawa wielkich liczb.
- Ostrzejsze wersje. Dla rozkładów jednomodalnych granicę zaostrza nierówność Wysoczańskiego–Petunina, z której Pukelsheim (1994) wyprowadza regułę trzech sigm.
Przykład w R
Dla k = 1.5, 2 i 3 nierówność dopuszcza .4444, .2500 i .1111 wyników poza przedziałem μ ± kσ. Rzeczywiste odsetki wyniosły .1336, .0455 i .0027 w rozkładzie normalnym, .0814, .0493 i .0182 w wykładniczym oraz .0797, .0406 i .0139 w rozkładzie t z 3 stopniami swobody (po 100 000 losowań). Żeby średnia z prawdopodobieństwem co najmniej .95 nie odbiegała od μ o więcej niż 0.1σ, Czebyszew wymaga n = 2000 osób, a przybliżenie normalne – 385.
Na rysunku
Jak bardzo ostrożna jest granica 1/k2, widać, gdy zestawi się ją z dokładnymi odsetkami dla kilku znanych rozkładów. Wszystkie krzywe policzono wzorami, bez losowania, dlatego liczby różnią się nieco od symulacji z przykładu.
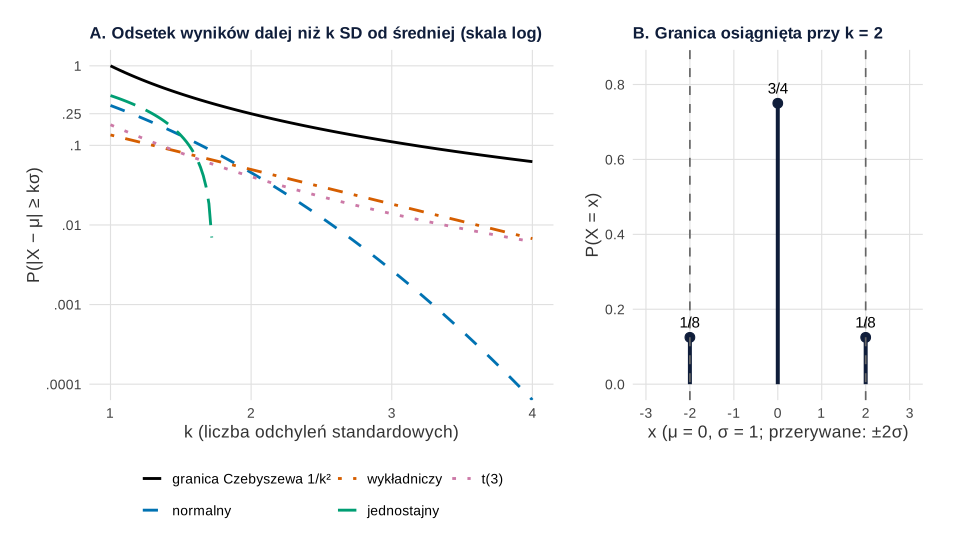
Co widać. Czarna krzywa 1/k2 leży nad wszystkimi rozkładami w całym zakresie. Przy k = 2 dopuszcza .2500, a rzeczywiste odsetki wynoszą .0455 w rozkładzie normalnym, .0498 w wykładniczym, .0405 w rozkładzie t z 3 stopniami swobody i 0 w jednostajnym, który kończy się w odległości 1.73σ od średniej. Przy k = 3 granica (.1111) jest 41 razy wyższa niż odsetek w rozkładzie normalnym (.0027). Rozkłady o grubych ogonach – wykładniczy i t(3) – opadają wolniej niż normalny, ale przy k = 4 (.0067 i .0062) wciąż leżą 9–10 razy niżej niż granica (.0625). Panel B pokazuje, że granicy nie da się poprawić bez dodatkowych założeń: rozkład z masą 3/4 w średniej i po 1/8 w punktach ±2σ ma odsetek wyników w odległości co najmniej 2σ równy dokładnie .25.
Na co uważać. Skala logarytmiczna zwęża duże różnice: odległość między krzywymi przy k = 3 to rząd wielkości, nie kilka procent. Rozkład z panelu B jest sztuczny – granica jest dokładna tylko dla takich „najgorszych” rozkładów, dlatego w praktyce Czebyszew daje gwarancję, a nie oszacowanie. Rysunek pokazuje też parametry populacji; w próbie średnia i SD są oszacowaniami, a wyniki skrajne same podnoszą SD.
Podpis do pracy:
Kod rysunku drukuje też tabelę odsetków dla k = 1.5, 2, 3 i 4 oraz momenty rozkładu z panelu B. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Granica Czebyszewa 1/k² a rzeczywisty odsetek wyników dalej niż k SD od średniej
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("granica Czebyszewa 1/k²" = "#000000", "normalny" = "#0072B2", "wykładniczy" = "#D55E00",
         "jednostajny" = "#009E73", "t(3)" = "#CC79A7")
lin <- c("granica Czebyszewa 1/k²" = "solid", "normalny" = "dashed", "wykładniczy" = "dotdash",
         "jednostajny" = "longdash", "t(3)" = "dotted")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# P(|X − μ| ≥ kσ) policzone wzorami (bez losowania); każdy rozkład ma tu średnią μ i SD σ
poza <- list(
  "granica Czebyszewa 1/k²" = function(k) pmin(1, 1 / k^2),
  "normalny"    = function(k) 2 * pnorm(-k),
  "wykładniczy" = function(k) exp(-(1 + k)) + ifelse(k < 1, 1 - exp(-(1 - k)), 0),   # Exp(1): μ = σ = 1
  "jednostajny" = function(k) pmax(0, 1 - k / sqrt(3)),                                # połowa szerokości = √3 σ
  "t(3)"        = function(k) 2 * pt(-k * sqrt(3), df = 3))                            # t(3) przeskalowany do SD = 1

k <- seq(1, 4, by = 0.02)
krzywe <- do.call(rbind, lapply(names(poza), function(r) data.frame(rozklad = r, k = k, odsetek = poza[[r]](k))))
krzywe$rozklad <- factor(krzywe$rozklad, levels = names(poza))
tab <- sapply(poza, function(f) f(c(1.5, 2, 3, 4)))
rownames(tab) <- paste0("k = ", c(1.5, 2, 3, 4))
round(t(tab), 4)

pA <- ggplot(subset(krzywe, odsetek > 0), aes(k, odsetek, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
  scale_y_log10(breaks = c(0.0001, 0.001, 0.01, 0.1, 0.25, 1), labels = c(".0001", ".001", ".01", ".1", ".25", "1")) +
  coord_cartesian(ylim = c(0.0001, 1)) +
  labs(title = "A. Odsetek wyników dalej niż k SD od średniej (skala log)",
       x = "k (liczba odchyleń standardowych)", y = "P(|X − μ| ≥ kσ)") +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) + motyw

# Rozkład, dla którego granica jest osiągnięta przy k = 2: masa 1/8 w ±2 i 3/4 w zerze
skrajny <- data.frame(x = c(-2, 0, 2), P = c(1/8, 3/4, 1/8))
round(c(srednia = sum(skrajny$x * skrajny$P), wariancja = sum(skrajny$x^2 * skrajny$P),
        poza_2SD = sum(skrajny$P[abs(skrajny$x) >= 2])), 3)
pB <- ggplot(skrajny, aes(x, P)) +
  geom_segment(aes(xend = x, yend = 0), linewidth = 1.4, colour = "#0f1d3a") +
  geom_point(size = 3, colour = "#0f1d3a") +
  geom_vline(xintercept = c(-2, 2), linetype = "dashed", colour = "grey40") +
  geom_text(aes(label = c("1/8", "3/4", "1/8")), vjust = -0.9, size = 4) +
  scale_x_continuous(breaks = -3:3, limits = c(-3, 3)) + scale_y_continuous(limits = c(0, 0.85)) +
  labs(title = "B. Granica osiągnięta przy k = 2",
       x = "x (μ = 0, σ = 1; przerywane: ±2σ)", y = "P(X = x)") + motyw

p <- pA + pB + plot_layout(widths = c(1.6, 1))
p
Wynik w R
                        k = 1.5  k = 2  k = 3  k = 4
granica Czebyszewa 1/k²  0.4444 0.2500 0.1111 0.0625
normalny                 0.1336 0.0455 0.0027 0.0001
wykładniczy              0.0821 0.0498 0.0183 0.0067
jednostajny              0.1340 0.0000 0.0000 0.0000
t(3)                     0.0805 0.0405 0.0138 0.0062
  srednia wariancja  poza_2SD
     0.00      1.00      0.25
Jak opisać w pracy
Na co uważać
- Parametry, a nie statystyki z próby. Nierówność dotyczy μ i σ. Saw i in. (1984) podają prostą modyfikację dla średniej i wariancji oszacowanych z próby – działa nawet wtedy, gdy momenty populacji nie istnieją.
- To nie kryterium odstawania. Wynik poza ±3SD nie musi być błędem; o regułach dla obserwacji odstających piszemy osobno.
Nierówność Czebyszewa w R
Kod porównuje granicę Czebyszewa z rzeczywistym odsetkiem wyników poza przedziałem μ ± kσ w trzech rozkładach i liczy liczebność próby gwarantującą zadaną precyzję średniej.
Granica 1/k² a rzeczywiste odsetki
R
k <- c(1.5, 2, 3)
set.seed(5031)
x <- rexp(100000)                            # wykładniczy: mu = 1, sigma = 1
y <- rt(100000, df = 3) / sqrt(3)            # t z 3 df przeskalowany do SD = 1
round(rbind(czebyszew = 1 / k^2,             # górna granica P(|X - mu| >= k*sigma)
            normalny  = 2 * pnorm(-k),
            wykladniczy = sapply(k, function(k) mean(abs(x - 1) >= k)),
            t3 = sapply(k, function(k) mean(abs(y) >= k))), 4)
# liczebność, przy której P(|M - mu| >= 0.1 sigma) <= .05
c(czebyszew = 1 / (0.1^2 * 0.05), normalny = ceiling((qnorm(.975) / 0.1)^2))
Wynik w R
              [,1]   [,2]   [,3]
czebyszew   0.4444 0.2500 0.1111
normalny    0.1336 0.0455 0.0027
wykladniczy 0.0814 0.0493 0.0182
t3          0.0797 0.0406 0.0139
czebyszew  normalny
     2000       385
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Ile wyników leży w przedziale średnia ± 2 SD według nierówności Czebyszewa?
Co najmniej 75%, niezależnie od kształtu rozkładu, jeśli tylko wariancja jest skończona. W rozkładzie normalnym jest to 95.45%, więc granica Czebyszewa jest bardzo ostrożna.
Czym nierówność Czebyszewa różni się od reguły trzech sigm?
Reguła trzech sigm podaje dokładne odsetki dla rozkładu normalnego. Nierówność Czebyszewa daje tylko górną granicę odsetka wyników skrajnych, ale dla każdego rozkładu o skończonej wariancji.
Czy nierówność Czebyszewa działa dla rozkładu Cauchy’ego?
W klasycznej postaci nie, bo rozkład Cauchy’ego nie ma wariancji. Wersja ze średnią i wariancją oszacowanymi z próby (Saw i in., 1984) obowiązuje jednak nawet wtedy, gdy momenty populacji nie istnieją.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Pukelsheim, F. (1994). The three sigma rule. The American Statistician, 48(2), 88–91. https://doi.org/10.1080/00031305.1994.10476030 ● Otwarty dostęp: pełny tekst
- Saw, J. G., Yang, M. C. K., & Mo, T. C. (1984). Chebyshev inequality with estimated mean and variance. The American Statistician, 38(2), 130–132. https://doi.org/10.1080/00031305.1984.10483182
- Seneta, E. (2013). A tricentenary history of the law of large numbers. Bernoulli, 19(4), 1088–1121. https://doi.org/10.3150/12-bejsp12 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{pukelsheim1994three, author={Pukelsheim, Friedrich}, title={{The three sigma rule}}, journal={The American Statistician}, year={1994}, volume={48}, number={2}, pages={88--91}, doi={10.1080/00031305.1994.10476030}}@article{saw1984chebyshev, author={Saw, John G. and Yang, Mark C. K. and Mo, Tse Chin}, title={{Chebyshev inequality with estimated mean and variance}}, journal={The American Statistician}, year={1984}, volume={38}, number={2}, pages={130--132}, doi={10.1080/00031305.1984.10483182}}@article{seneta2013tricentenary, author={Seneta, Eugene}, title={{A tricentenary history of the law of large numbers}}, journal={Bernoulli}, year={2013}, volume={19}, number={4}, pages={1088--1121}, doi={10.3150/12-bejsp12}}