Co to jest wariancja?
Wariancja (ang. variance; w próbie s², w populacji σ²) to średni kwadrat odchylenia wyników od średniej. Mierzy rozproszenie danych: im bardziej wyniki różnią się między sobą, tym większa wariancja. Pierwiastek z wariancji to odchylenie standardowe.
Nazwę wprowadził Fisher (1919). W pracy o dziedziczeniu cech zauważył, że gdy działają dwie niezależne przyczyny zmienności, sumują się kwadraty odchyleń standardowych, a nie same odchylenia. Zaproponował więc, by przyczyny zmienności analizować za pomocą kwadratu odchylenia standardowego, i nazwał tę wielkość wariancją. Wydawca datuje tę pracę na 1919 rok, choć bywa cytowana z rokiem 1918. Z tej idei wyrosła analiza wariancji.
Wzór: wariancja w populacji i w próbie
s² = Σ(xi − M)² / (n − 1)
- σ² – wariancja w populacji: odchylenia od średniej populacji μ, N – liczba wszystkich obserwacji,
- s² – wariancja z próby: odchylenia od średniej z próby M,
- Σ(xi − M)² – suma kwadratów odchyleń (ang. sum of squares, SS),
- n − 1 – liczba stopni swobody.
Lee i in. (2015) przypominają, że wariancję z próby oblicza się z mianownikiem n − 1, a ponieważ jest wyrażona w jednostkach podniesionych do kwadratu, do opisu danych wygodniejsze jest odchylenie standardowe. Kwadrat zmienia też skalę: pomnożenie wszystkich wyników przez 2 mnoży wariancję przez 4 (w przykładzie poniżej z 38 do 152), a odchylenie standardowe – tylko przez 2.
Przykład: kwadraty odchyleń
Weźmy sześć wyników w skali stresu PSS-10 z hasła o odchyleniu standardowym: 30, 17, 21, 13, 14 i 19 pkt (M = 19). Rysunek 1 pokazuje wariancję w sensie dosłownym: każde odchylenie od średniej jest bokiem kwadratu, a wariancja to „przeciętne pole” tych kwadratów.
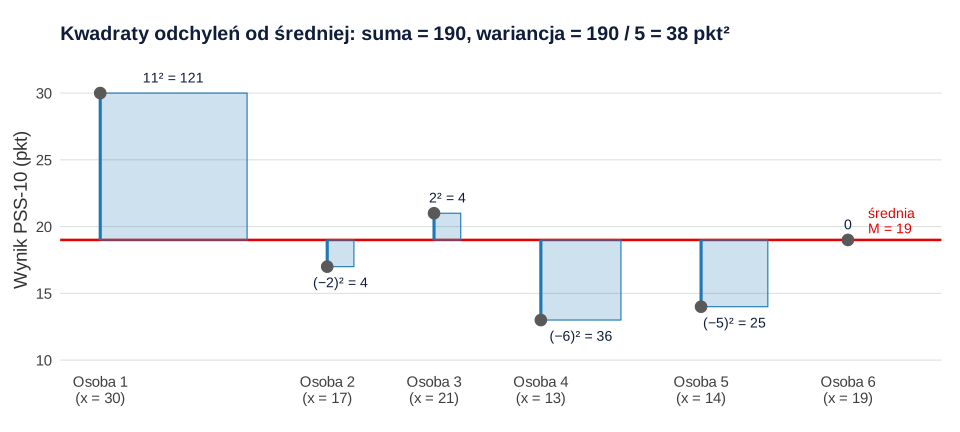
Suma pól wynosi 190, więc wariancja z próby to s² = 190 / 5 = 38 pkt², a gdyby te sześć osób było całą populacją – σ² = 190 / 6 = 31.67 pkt². Rysunek pokazuje też, dlaczego wariancja tak silnie reaguje na wyniki odległe od średniej: osoba 1, oddalona o 11 punktów, wnosi 121 z 190, czyli 63.7% sumy kwadratów, a osoba 6, której wynik równa się średniej, nie wnosi nic. Jednostka „punkt do kwadratu” nie ma intuicyjnej interpretacji, dlatego w opisie próby podaje się SD = 6.16 pkt.
Dlaczego dzielimy przez n − 1?
Odchylenia w próbie liczymy od średniej M, policzonej z tych samych danych. Średnia minimalizuje sumę kwadratów odchyleń, więc wokół prawdziwej średniej populacji μ suma kwadratów byłaby co najmniej tak samo duża, a zwykle większa. Dzielenie przez n systematycznie zaniżałoby zatem wariancję populacji – tym bardziej, im mniejsza próba. Poprawka n − 1 (tzw. poprawka Bessela) usuwa to obciążenie: s² jest nieobciążonym estymatorem σ².
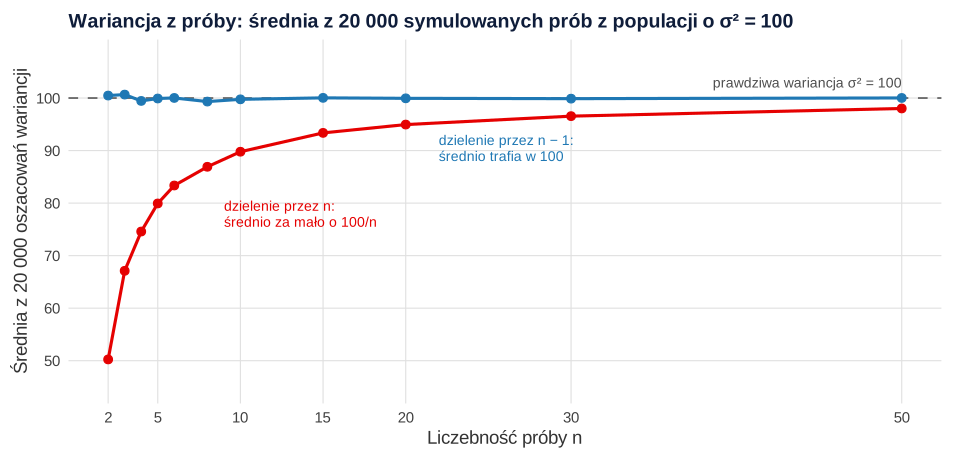
Dla prób pięcioosobowych z populacji o σ² = 100 średnia z 20 000 oszacowań wyniosła 99.92 przy dzieleniu przez n − 1 i tylko 79.93 przy dzieleniu przez n – zgodnie z teorią obciążenie wynosi σ²/n = 20. Przy n = 50 różnica maleje do około 2% (100.02 wobec 98.02). Nieobciążona jest jednak wariancja, a nie odchylenie standardowe: pierwiastek wprowadza niewielkie zaniżenie. W osobnej symulacji 20 000 prób pięcioosobowych średnie SD wyniosło 9.40 przy σ = 10.
Wariancje się sumują, odchylenia standardowe – nie
Z tej własności korzysta psychometria. W klasycznej teorii testów wynik obserwowany jest sumą wyniku prawdziwego i błędu pomiaru: X = T + E. Jeśli T i E są niezależne, ich wariancje się sumują:
W symulacji 100 000 osób z wynikami prawdziwymi o SD = 12 i błędem pomiaru o SD = 5 otrzymaliśmy Var(T) = 143.4, Var(E) = 25.0 i Var(X) = 168.7 – niemal dokładnie sumę obu wariancji. Odchylenie standardowe wyniku obserwowanego wyniosło 12.99, a nie 12 + 5 = 17. Stosunek Var(T) / Var(X) = .850 to rzetelność pomiaru w rozumieniu klasycznej teorii testów. Gdy składniki są skorelowane, dochodzi człon z kowariancją: Var(X + Y) = Var(X) + Var(Y) + 2Cov(X, Y).
Rozkład wariancji: między grupami i wewnątrz grup
Na rozkładzie sumy kwadratów opiera się ANOVA. W przykładzie 30 studentów losowo przydzielono do trzech rodzajów przerwy (kontrolna, relaksacja, mindfulness) i zmierzono ich stres. Całkowitą sumę kwadratów dzielimy na część związaną z różnicami między średnimi grup (wariancja międzygrupowa) i część wynikającą z różnic między osobami w tej samej grupie (wariancja wewnątrzgrupowa):
| Źródło zmienności | SS | df | MS = SS / df |
|---|---|---|---|
| Między grupami | 110.60 | 2 | 55.30 |
| Wewnątrz grup | 332.60 | 27 | 12.32 |
| Razem | 443.20 | 29 | 15.28 |
Średnie w grupach wyniosły 21.8, 19.3 i 17.1 pkt, a średnia ogólna 19.4 pkt. Ostatni wiersz to zwykła wariancja wszystkich 30 wyników: całkowita suma kwadratów podzielona przez n − 1 = 29 daje 15.28. Iloraz średnich kwadratów (MS) między grupami i wewnątrz grup to statystyka F = 55.30 / 12.32 = 4.49 (p = .021). Odsetek całkowitej zmienności związany z przynależnością do grupy to eta kwadrat (Richardson, 2011): η² = 110.60 / 443.20 = .25. Podobnie w regresji R² to odsetek wariancji zmiennej zależnej wyjaśnionej przez predyktory. Pełny tok analizy opisujemy w poradniku ANOVA krok po kroku.
Porównywanie wariancji między grupami
Klasyczny test t i ANOVA zakładają równość wariancji w grupach. Do jej sprawdzania służy test Levene’a. Brown i Forsythe (1974) pokazali, że jego warianty, w których średnią zastąpiono odporniejszym estymatorem położenia (najczęściej medianą), są odporne na odstępstwa od normalności – w przeciwieństwie do wersji niezmodyfikowanej. Dla dwóch grup z hasła o odchyleniu standardowym (lęk przed egzaminem, po 40 osób) wariancje wynoszą 23.70 i 150.06, a ich iloraz 6.33. Test Browna–Forsythe’a potwierdza różnicę: F(1, 78) = 24.74, p < .001.
Test wstępny nie powinien jednak decydować o wyborze testu dla średnich. Delacre i in. (2017) pokazują, że założenie równych wariancji rzadko jest spełnione w psychologii, a wybór testu na podstawie testu wstępnego często zawodzi. Zalecają domyślnie test t Welcha, który lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy są one równe.
Jak raportować wariancję (APA)?
W statystykach opisowych wariancji zwykle się nie podaje – do opisu próby używaj odchylenia standardowego, bo jest wyrażone w jednostkach zmiennej. Wariancja pojawia się w raportach gdzie indziej: jako średnie kwadraty (MS) w tabelach ANOVA (zob. tabela ANOVA w APA), jako komponenty wariancji w modelach wielopoziomowych i jako odsetek wyjaśnionej wariancji (η², R²). Jeśli porównujesz rozproszenie grup, opisz je przez SD i podaj wynik testu:
Przykład w R
Kod liczy wariancję z próby i populacji, rozkłada sumę kwadratów w ANOVA i porównuje wariancje dwóch grup testem Browna–Forsythe’a. W SPSS wariancję podaje Analyze → Descriptive Statistics → Descriptives (opcja Variance), a test Levene’a z medianą – procedura Explore (wiersz Based on Median).
Wariancja, sumy kwadratów i test Browna–Forsythe’a
R
options(show.signif.stars = FALSE)            # bez gwiazdek przy wartościach p
set.seed(130)
pss <- round(rnorm(6, mean = 20, sd = 6))     # stres (PSS-10) u 6 osób
n <- length(pss)
SS <- sum((pss - mean(pss))^2)                # suma kwadratów odchyleń
round(c(SS = SS, s2 = SS / (n - 1), sigma2 = SS / n, var = var(pss)), 2)
set.seed(187)
grupa <- factor(rep(c("kontrolna", "relaksacja", "mindfulness"), each = 10),
                levels = c("kontrolna", "relaksacja", "mindfulness"))
stres <- round(rnorm(30, mean = rep(c(22, 19, 17), each = 10), sd = 4))
summary(aov(stres ~ grupa))                   # SS między grupami i wewnątrz grup
sum((stres - mean(stres))^2)                  # SS całkowita
set.seed(540)
a <- pmin(pmax(round(rnorm(40, 45, 5)), 20), 80)    # lęk: grupa A
b <- pmin(pmax(round(rnorm(40, 45, 12)), 20), 80)   # lęk: grupa B
round(c(var_A = var(a), var_B = var(b), iloraz = var(b) / var(a)), 2)
lek <- data.frame(y = c(a, b), gr = factor(rep(c("A", "B"), each = 40)))
car::leveneTest(y ~ gr, data = lek)           # center = median: wersja Browna–Forsythe’a
Wynik w R
    SS     s2 sigma2    var
190.00  38.00  31.67  38.00
            Df Sum Sq Mean Sq F value Pr(>F)
grupa        2  110.6   55.30   4.489 0.0207
Residuals   27  332.6   12.32
[1] 443.2
 var_A  var_B iloraz
 23.70 150.06   6.33
Levene's Test for Homogeneity of Variance (center = median)
      Df F value    Pr(>F)
group  1  24.742 3.814e-06
      78
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test Levene’a z pakietu car); symulacje i rysunki przygotowano w R i pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wariancja w tabeli statystyk opisowych zamiast SD – czytelnik musiałby myśleć w jednostkach do kwadratu; podaj M i SD.
- Dodawanie odchyleń standardowych – sumują się wariancje niezależnych składników, a nie SD: składniki o SD 12 i 5 dają łącznie 12.99, a nie 17.
- Wzór populacyjny w próbie – dzielenie przez n zaniża wariancję; przy n = 5 średnio o 20%.
- Klasyczny test Levene’a przy skośnych danych – bezpieczniejsza jest wersja z medianą (Brown i Forsythe, 1974).
Najczęstsze pytania
Jak obliczyć wariancję?
Policz średnią, odejmij ją od każdego wyniku, podnieś różnice do kwadratu i zsumuj. Sumę podziel przez n − 1 (w próbie) albo przez N (gdy masz dane całej populacji). Dla wyników 30, 17, 21, 13, 14 i 19 suma kwadratów wynosi 190, a wariancja z próby 190 / 5 = 38. W R: var(x).
Czym różni się wariancja od odchylenia standardowego?
Odchylenie standardowe to pierwiastek z wariancji. Wariancja jest wyrażona w jednostkach do kwadratu (np. punktach²), a SD w jednostkach zmiennej, dlatego do opisu danych używa się odchylenia standardowego. Wariancja jest za to wygodna w obliczeniach, bo wariancje niezależnych składników się sumują.
Dlaczego wariancję z próby dzieli się przez n − 1?
Odchylenia liczy się od średniej z próby, która leży bliżej danych niż prawdziwa średnia populacji. Dzielenie przez n zaniżałoby wariancję średnio o σ²/n – w symulacji dla n = 5 o około 20%. Dzielenie przez n − 1 (poprawka Bessela) daje estymator nieobciążony.
Co to jest wariancja międzygrupowa i wewnątrzgrupowa?
To dwie części, na które ANOVA rozkłada całkowitą zmienność wyników. Wariancja międzygrupowa odzwierciedla różnice między średnimi grup, a wewnątrzgrupowa – różnice między osobami w tej samej grupie. Ich iloraz to statystyka F, a udział części międzygrupowej w całości to η².
Czy w pracy dyplomowej podaje się wariancję?
W statystykach opisowych zwykle nie – podaje się średnią i odchylenie standardowe. Wariancja pojawia się w tabelach ANOVA (średnie kwadraty), w modelach wielopoziomowych i jako odsetek wyjaśnionej wariancji, np. η² albo R².
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Fisher, R. A. (1919). The correlation between relatives on the supposition of Mendelian inheritance. Transactions of the Royal Society of Edinburgh, 52(2), 399–433. https://doi.org/10.1017/S0080456800012163
- Lee, D. K., In, J., & Lee, S. (2015). Standard deviation and standard error of the mean. Korean Journal of Anesthesiology, 68(3), 220–223. https://doi.org/10.4097/kjae.2015.68.3.220 ● Otwarty dostęp
- Richardson, J. T. E. (2011). Eta squared and partial eta squared as measures of effect size in educational research. Educational Research Review, 6(2), 135–147. https://doi.org/10.1016/j.edurev.2010.12.001
Cytowania BibTeX
@article{brown1974robust, author={Brown, Morton B. and Forsythe, Alan B.}, title={{Robust tests for the equality of variances}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={346}, pages={364--367}, doi={10.1080/01621459.1974.10482955}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{fisher1919correlation, author={Fisher, R. A.}, title={{The correlation between relatives on the supposition of Mendelian inheritance}}, journal={Transactions of the Royal Society of Edinburgh}, year={1919}, volume={52}, number={2}, pages={399--433}, doi={10.1017/s0080456800012163}}@article{lee2015standard, author={Lee, Dong Kyu and In, Junyong and Lee, Sangseok}, title={{Standard deviation and standard error of the mean}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={3}, pages={220--223}, doi={10.4097/kjae.2015.68.3.220}}@article{richardson2011eta, author={Richardson, John T. E.}, title={{Eta squared and partial eta squared as measures of effect size in educational research}}, journal={Educational Research Review}, year={2011}, volume={6}, number={2}, pages={135--147}, doi={10.1016/j.edurev.2010.12.001}}