Co to jest wariancja indywidualna?
Wariancja indywidualna to część zmienności wyników, która wynika z trwałych różnic między osobami: jedni badani mają wyniki systematycznie wyższe, inni niższe, niezależnie od warunku, w którym są mierzeni. Mówi się też o wariancji międzyosobniczej, wariancji różnic indywidualnych albo – w modelach mieszanych – o wariancji losowego wyrazu wolnego (ang. between-person variance, subject variance, random intercept variance). Pojęcie ma sens wtedy, gdy tę samą osobę mierzysz więcej niż raz: w ANOVA z powtarzanymi pomiarami, w badaniach dzienniczkowych, w schemacie podłużnym albo przy ocenach wielu sędziów.
Wariancja indywidualna różni się od pojęć, z którymi łatwo ją pomylić:
- od wariancji międzygrupowej – ta opisuje różnice między średnimi grup lub warunków (efekt badanego czynnika), a nie między osobami;
- od wariancji wewnątrzgrupowej – w schemacie międzygrupowym różnice indywidualne są jej częścią i nie da się ich oddzielić od błędu, bo każda osoba ma tylko jeden wynik;
- od wariancji wewnątrzosobniczej – to wahania wyników tej samej osoby wokół jej własnej średniej;
- od wariancji swoistej w analizie czynnikowej – tam chodzi o część wariancji pozycji testu niewspólną z innymi pozycjami (zob. zasoby zmienności wspólnej), a nie o różnice między ludźmi.
Rozkład zmienności w schemacie wewnątrzosobowym
Gdy każda z n osób przechodzi przez k warunków, całkowitą sumę kwadratów da się rozłożyć na trzy części:
SSosoby = k × Σ(Mosoby − M)² to właśnie wariancja indywidualna: zmienność średnich poszczególnych osób wokół średniej ogólnej. SSreszta (interakcja osoba × warunek) to wszystko, czego nie wyjaśniają ani warunki, ani stały poziom osoby. W ANOVA z powtarzanymi pomiarami efekt warunku testuje się względem samej reszty – wariancja indywidualna zostaje z błędu usunięta. Na tym polega przewaga czynnika wewnątrzobiektowego nad międzyobiektowym: każda osoba jest własną kontrolą.
W modelu mieszanym (wielopoziomowym) ten sam podział wyraża się parametrami. Wynik osoby i w pomiarze j to suma efektów stałych, odchylenia osoby u0i i reszty eij. Wariancja odchyleń osób, τ00, to wariancja indywidualna, a σ² – wariancja wewnątrzosobnicza. Ich proporcja daje korelację wewnątrzklasową:
ICC mówi, jaka część zmienności (przy stałych efektach w modelu) przypada na różnice między osobami. Hox i in. (2017) omawiają ten podział jako punkt wyjścia analizy wielopoziomowej; model można rozbudować o losowe nachylenia, gdy osoby różnią się także reakcją na warunek (zob. efekty stałe i losowe).
Przykład: napięcie w trzech warunkach zadania
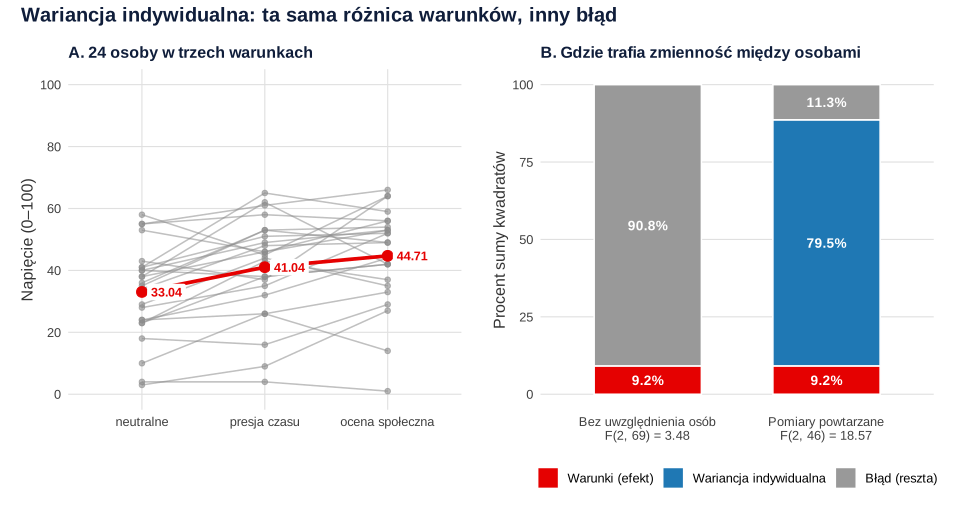
24 studentów oceniało swoje napięcie (0–100) po trzech zadaniach w losowej kolejności: neutralnym, z presją czasu i z oceną społeczną (dane symulowane). Średnie wyniosły 33.04, 41.04 i 44.71. Jak pokazuje rysunek 1A, linie poszczególnych osób przebiegają na bardzo różnych wysokościach, ale większość z nich rośnie od warunku neutralnego do oceny społecznej.
| Źródło zmienności | SS | % całości |
|---|---|---|
| Warunki (efekt zadania) | 1708.4 | 9.2% |
| Osoby (wariancja indywidualna) | 14821.3 | 79.5% |
| Reszta (osoba × warunek) | 2115.6 | 11.3% |
| Całkowita | 18645.3 | 100% |
Prawie 80% zmienności to różnice między osobami. Gdy analizę przeprowadzisz błędnie, jakby trzy warunki tworzyły niezależne grupy, cała ta zmienność trafia do błędu: F(2, 69) = 3.48, p = .036. ANOVA z powtarzanymi pomiarami usuwa ją z mianownika: F(2, 46) = 18.57, p < .001 (rysunek 1B). Różnice średnich są w obu analizach identyczne; zmienia się tylko to, z czym się je porównuje. Model mieszany daje wariancję indywidualną τ00 = 199.47 (SD = 14.12) i wewnątrzosobniczą σ² = 45.99 (SD = 6.78), czyli ICC = .81.
Dlaczego wariancja indywidualna ma znaczenie
Moc testu. Im większa wariancja indywidualna, tym więcej zyskujesz na schemacie wewnątrzosobowym, bo mniejszy staje się człon błędu. Przy małych różnicach między osobami zysk jest niewielki.
Wielkość efektu. Cząstkowe eta kwadrat z ANOVA z powtarzanymi pomiarami pomija wariancję indywidualną w mianowniku, więc bywa bardzo duże: w przykładzie η²p = .447. Uogólnione eta kwadrat (η²G) ją uwzględnia i wynosi .092. Bakeman (2005) zaleca η²G, bo pozwala porównywać efekty ze schematów międzyosobowych i wewnątrzosobowych.
Rzetelność różnic indywidualnych. Ta sama wariancja, która w eksperymencie jest „szumem”, w psychometrii jest sygnałem. Hedge i in. (2018) pokazują paradoks rzetelności: klasyczne zadania poznawcze, takie jak Stroop czy flanker, dają silne efekty eksperymentalne właśnie dlatego, że różnice między osobami są w nich małe – a przez to słabo nadają się do pomiaru różnic indywidualnych (zob. rzetelność test–retest).
Zależność obserwacji. Gdy wariancja indywidualna jest duża, wyniki tej samej osoby są silnie skorelowane. Traktowanie ich jak niezależnych obserwacji fałszuje wnioski: Aarts i in. (2014) pokazują, że ignorowanie zagnieżdżenia może podnieść odsetek fałszywie istotnych wyników daleko powyżej nominalnego α. W przykładzie analiza „jak grupy niezależne” zaniżyła F dla czynnika wewnątrzosobowego. Gdy jednak porównujesz cechę osób (np. dwie grupy), a każda osoba dostarcza wielu pomiarów, ten sam błąd działa w przeciwną stronę: liczba niezależnych obserwacji jest zawyżona i wyniki wychodzą „istotne” za często.
Wybór między ANOVA z powtarzanymi pomiarami a modelem mieszanym omawia poradnik ANOVA z powtarzanymi pomiarami czy model mieszany.
Jak opisać wynik w pracy (APA)
W raporcie z modelu mieszanego podaj obie wariancje (lub odchylenia standardowe) i ICC; w ANOVA z powtarzanymi pomiarami – wybrane wskaźniki wielkości efektu i informację, który z nich uwzględnia różnice indywidualne. Wzór dla przykładu:
Przy trzech i więcej poziomach czynnika wewnątrzobiektowego sprawdź też założenie sferyczności.
Przykład w R
Kod tworzy dane z przykładu, rozkłada sumę kwadratów na warunki, osoby i resztę, porównuje analizę ignorującą osoby z ANOVA z powtarzanymi pomiarami, liczy dwa wskaźniki eta kwadrat i szacuje wariancję indywidualną w modelu mieszanym. Liczby w tekście, tabeli i na rysunku 1 pochodzą z tego kodu.
Wariancja indywidualna w ANOVA z powtarzanymi pomiarami i w modelu mieszanym
R
# Dane symulowane: 24 studentów oceniało napięcie (0–100) w trzech warunkach w losowej kolejności:
# zadanie neutralne, zadanie z presją czasu, zadanie z oceną społeczną (schemat wewnątrzosobowy)
set.seed(2261)
n <- 24
osoba <- factor(rep(1:n, each = 3))
warunek <- factor(rep(c("neutralne", "presja czasu", "ocena społeczna"), n),
                  levels = c("neutralne", "presja czasu", "ocena społeczna"))
poziom_osoby <- rnorm(n, 0, 10)                       # trwałe różnice indywidualne
efekt <- c(neutralne = 0, `presja czasu` = 5, `ocena społeczna` = 9)
napiecie <- round(pmin(pmax(38 + poziom_osoby[osoba] + efekt[as.character(warunek)] + rnorm(3 * n, 0, 7), 0), 100))
dane <- data.frame(osoba, warunek, napiecie)
round(tapply(dane$napiecie, dane$warunek, mean), 2)

# 1. Rozkład sumy kwadratów: całkowita = warunki + osoby (wariancja indywidualna) + reszta
SS_calk <- sum((dane$napiecie - mean(dane$napiecie))^2)
SS_war  <- n * sum((tapply(dane$napiecie, dane$warunek, mean) - mean(dane$napiecie))^2)
SS_os   <- 3 * sum((tapply(dane$napiecie, dane$osoba, mean) - mean(dane$napiecie))^2)
SS_res  <- SS_calk - SS_war - SS_os
round(c(calkowita = SS_calk, warunki = SS_war, osoby = SS_os, reszta = SS_res), 1)
round(100 * c(warunki = SS_war, osoby = SS_os, reszta = SS_res) / SS_calk, 1)

# 2. Ta sama różnica warunków: analiza ignorująca osoby (błędnie – jak grupy niezależne) ...
summary(aov(napiecie ~ warunek, data = dane))
# ... i ANOVA z powtarzanymi pomiarami: wariancja indywidualna usunięta z członu błędu
summary(aov(napiecie ~ warunek + Error(osoba / warunek), data = dane))
# wielkość efektu: cząstkowe eta kwadrat (bez wariancji indywidualnej) i uogólnione eta kwadrat (z nią)
round(c(eta2_czastkowe = SS_war / (SS_war + SS_res), eta2_uogolnione = SS_war / (SS_war + SS_os + SS_res)), 3)

# 3. Model mieszany z losowym wyrazem wolnym: wariancja indywidualna jako parametr i ICC
suppressPackageStartupMessages(library(lme4))
m <- lmer(napiecie ~ warunek + (1 | osoba), data = dane, REML = TRUE)
vc <- as.data.frame(VarCorr(m))[, c("grp", "vcov", "sdcor")]
vc[, 2:3] <- round(vc[, 2:3], 2); vc
round(vc$vcov[1] / sum(vc$vcov), 3)                   # ICC: udział wariancji indywidualnej (przy stałym warunku)
Wynik w R
      neutralne    presja czasu ocena społeczna
          33.04           41.04           44.71
calkowita   warunki     osoby    reszta
  18645.3    1708.4   14821.3    2115.6
warunki   osoby  reszta
    9.2    79.5    11.3
            Df Sum Sq Mean Sq F value Pr(>F)
warunek      2   1708   854.2    3.48 0.0363 *
Residuals   69  16937   245.5
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Error: osoba
          Df Sum Sq Mean Sq F value Pr(>F)
Residuals 23  14821   644.4

Error: osoba:warunek
          Df Sum Sq Mean Sq F value   Pr(>F)
warunek    2   1708   854.2   18.57 1.22e-06 ***
Residuals 46   2116    46.0
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 eta2_czastkowe eta2_uogolnione
          0.447           0.092
       grp   vcov sdcor
1    osoba 199.47 14.12
2 Residual  45.99  6.78
[1] 0.813
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lme4 (model mieszany); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Analiza pomiarów powtarzanych jak grup niezależnych. Wariancja indywidualna trafia wtedy do błędu, a obserwacje tej samej osoby są traktowane jak niezależne – wynik testu jest niewiarygodny.
- Utożsamianie wariancji indywidualnej z błędem pomiaru. Różnice między osobami są rzeczywiste i często same w sobie interesujące; to, czy traktujesz je jako szum, zależy od pytania badawczego.
- Porównywanie η²p z pomiarów powtarzanych z η² ze schematu międzygrupowego. Bez wariancji indywidualnej w mianowniku efekt wygląda na wielokrotnie większy (.447 wobec .092).
- Podawanie samego ICC bez wariancji składowych. Ten sam ICC może wynikać z dużych różnic między osobami albo z małej zmienności wewnątrzosobniczej.
- Interpretowanie ICC bez modelu. Wariancja indywidualna zależy od efektów stałych w modelu; po dodaniu predyktorów poziomu osoby (np. neurotyczności) jej część zostaje wyjaśniona i τ00 maleje.
Najczęstsze pytania
Czym różni się wariancja indywidualna od wariancji wewnątrzosobniczej?
Wariancja indywidualna opisuje różnice między średnimi poziomami różnych osób, a wewnątrzosobnicza – wahania wyników tej samej osoby wokół jej własnej średniej. W przykładzie na tej stronie pierwsza wynosiła 199.47, a druga 45.99.
Dlaczego ANOVA z powtarzanymi pomiarami ma większą moc niż ANOVA międzygrupowa?
Bo efekt warunków testuje względem błędu pozbawionego wariancji indywidualnej – każda osoba jest własną kontrolą. Im większe różnice między osobami, tym większy zysk; w przykładzie F wzrosło z 3.48 do 18.57 przy tych samych średnich.
Jak policzyć wariancję indywidualną w R?
Najprościej modelem mieszanym z losowym wyrazem wolnym, np. lmer(wynik ~ warunek + (1 | osoba)) z pakietu lme4. Wiersz osoba w VarCorr() to wariancja indywidualna, Residual – wewnątrzosobnicza, a ich proporcja daje ICC.
Czy wariancja indywidualna to błąd pomiaru?
Nie. To rzeczywiste, stałe różnice między ludźmi. W eksperymencie bywa traktowana jak szum, który warto usunąć z błędu, ale w badaniach różnic indywidualnych i w psychometrii jest właśnie tym, co chcesz mierzyć.
Które eta kwadrat podać przy pomiarach powtarzanych?
Cząstkowe η²p pomija wariancję indywidualną i bywa bardzo wysokie; uogólnione η²G ją uwzględnia i daje się porównywać ze schematami międzygrupowymi (Bakeman, 2005). Napisz, który wskaźnik podajesz – najlepiej oba.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Hedge, C., Powell, G., & Sumner, P. (2018). The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences. Behavior Research Methods, 50(3), 1166–1186. https://doi.org/10.3758/s13428-017-0935-1 ● Otwarty dostęp
- Hox, J. J., Moerbeek, M., & van de Schoot, R. (2017). Multilevel analysis: Techniques and applications (3rd ed.). Routledge. https://doi.org/10.4324/9781315650982
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{hedge2018reliability, author={Hedge, Craig and Powell, Georgina and Sumner, Petroc}, title={{The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={1166--1186}, doi={10.3758/s13428-017-0935-1}}@book{hox2017multilevel, author={Hox, Joop J. and Moerbeek, Mirjam and van de Schoot, Rens}, title={{Multilevel analysis: Techniques and applications (3rd ed.)}}, year={2017}, publisher={Routledge}, doi={10.4324/9781315650982}}