Co to jest rzetelność test–retest?
Rzetelność test–retest (ang. test–retest reliability), nazywana też stabilnością bezwzględną albo współczynnikiem stabilności, mówi, czy to samo narzędzie zastosowane dwukrotnie u tych samych osób daje podobne wyniki. Badanym podaje się test, po ustalonym czasie – ten sam test ponownie (retest), a następnie porównuje oba pomiary; to więc krótki schemat podłużny. To jeden z kilku rodzajów rzetelności: spójność wewnętrzna (np. omega McDonalda) dotyczy jednego pomiaru, a zgodność sędziów – różnych oceniających.
Koo i Li (2016) opisują rzetelność test–retest jako zmienność pomiarów wykonanych tym samym narzędziem u tych samych osób w tych samych warunkach i wskazują, że to właściwa miara tam, gdzie nie ma oceniających, np. w kwestionariuszach samoopisowych. Wynik zależy od trzech źródeł: rzeczywistej stałości cechy, błędu losowego i zmian systematycznych między pomiarami, takich jak efekt praktyki. Dlatego test–retest ma sens tylko dla cech, które w danym odstępie czasu nie powinny się zmieniać – dla lęku jako cechy, ale nie dla lęku jako stanu.
Jak wybrać odstęp między pomiarami?
Odstęp to najważniejsza decyzja w badaniu test–retest. Polit (2014) krytykuje praktykę wybierania go bez uzasadnienia i akceptowania niskich współczynników. Zaleca uzasadniony odstęp, kryteria akceptowalności ustalone przed badaniem, analizę na poziomie pozycji oraz duże, zróżnicowane próby. Koo i Li (2016) jako regułę kciuka podają co najmniej 30 zróżnicowanych osób.
| Sytuacja | Co się dzieje | Co zrobić |
|---|---|---|
| Zbyt krótki odstęp (kilka dni) | badani pamiętają odpowiedzi, działa efekt praktyki – współczynnik jest zawyżony | wydłuż odstęp, zwłaszcza w testach wiadomości i zadaniach poznawczych |
| Zbyt długi odstęp (kilka miesięcy) | cecha mogła się naprawdę zmienić – współczynnik jest zaniżony | wybierz odstęp krótszy niż czas realnej zmiany cechy |
| Pomiar stanu (nastrój, lęk-stan) | wynik ma się zmieniać z sytuacją | oceniaj spójność wewnętrzną, nie stabilność |
| Wydarzenie między pomiarami (np. sesja, terapia) | zmiana systematyczna u wielu osób | zaplanuj pomiary poza takimi okresami i opisz je w pracy |
Osobny problem dotyczy zadań eksperymentalnych. Hedge i in. (2018) stwierdzili, że rzetelność test–retest siedmiu klasycznych zadań poznawczych (m.in. Stroopa, flanker, stop-signal) wahała się od 0 do .82. Nazwali to „paradoksem rzetelności”: zadania dają silne efekty eksperymentalne właśnie dlatego, że ludzie mało się w nich różnią, a mała zmienność międzyosobnicza obniża rzetelność pomiaru różnic indywidualnych.
Korelacja Pearsona czy ICC?
Najczęściej liczy się korelację Pearsona między testem a retestem. Berchtold (2016) przypomina jednak, że korelacja mierzy tylko zachowanie kolejności osób, a nie to, czy osoby uzyskały te same wyniki, i krytykuje opieranie oceny wyłącznie na niej. Aldridge i in. (2017) dodają, że korelacja ukrywa błąd systematyczny, a nieistotny test t dla prób zależnych nie dowodzi, że wyniki są zgodne. Lepszym wyborem jest współczynnik korelacji wewnątrzklasowej (ICC), liczony z tabeli analizy wariancji dla pomiarów powtarzanych. Jego dwie definicje różnią się tym, co traktują jako błąd:
ICC(A,1) = σ²osoby / (σ²osoby + σ²pomiar + σ²błąd)
- σ²osoby – wariancja prawdziwych różnic między osobami,
- σ²pomiar – wariancja związana z systematyczną różnicą między pomiarami (np. średni wzrost wyników w retescie),
- σ²błąd – losowy błąd pomiaru.
ICC zgodności (C, ang. consistency) – podobnie jak korelacja – ignoruje przesunięcie wyników, a ICC zgodności bezwzględnej (A, ang. absolute agreement) traktuje je jak błąd. Koo i Li (2016) zalecają, by w badaniach test–retest zawsze wybierać zgodność bezwzględną i model dwuczynnikowy mieszany, a typ (pojedynczy pomiar czy średnia z kilku) dobierać do tego, jak narzędzie będzie używane w praktyce. Liljequist i in. (2019) proponują dodatkowo porównać ICC(C,1) z ICC(A,1): gdy zgodność jest wyraźnie wyższa niż zgodność bezwzględna, w danych jest błąd systematyczny i warto podać oba współczynniki. Gdy wynik jest kategorialny (np. diagnoza: jest – nie ma), stabilność ocenia się nie ICC, lecz kappą Cohena.
Przykład: ta sama korelacja, różna zgodność
Osiemdziesięciu studentów dwukrotnie, w odstępie czterech tygodni, wypełniło skalę lęku-cechy (wynik od 20 do 80 punktów; dane symulowane). W pierwszym pomiarze średnia wyniosła M = 44.09 (SD = 9.87), w drugim M = 44.66 (SD = 9.69). To wariant A. W wariancie B do każdego wyniku retestu dodaliśmy 5 punktów – tak wyglądałyby dane, gdyby drugi pomiar wypadł w sesji egzaminacyjnej, która podnosi lęk u wszystkich podobnie.
| Miara | Wariant A: bez zmiany | Wariant B: retest +5 pkt |
|---|---|---|
| Korelacja Pearsona r | .884 | .884 |
| ICC(C,1) – zgodność | .884 | .884 |
| ICC(A,1) – zgodność bezwzględna, 95% CI | .883 [.824, .924] | .761 [.075, .914] |
| Średnia różnica retest − test | 0.58 pkt | 5.58 pkt |
Korelacja i ICC(C,1) w obu wariantach są identyczne, bo dodanie stałej nie zmienia kolejności osób ani odległości między nimi. Spada tylko ICC(A,1) – z .883 do .761. Przedział ufności dla ICC(A,1) w wariancie B jest bardzo szeroki (.075–.914), bo wariancję systematycznej różnicy przy dwóch pomiarach szacujemy z jednego stopnia swobody. W wariancie A różnica średnich była nieistotna, t(79) = 1.09, p = .279, w wariancie B – wyraźna, t(79) = 10.57, p < .001. Wykres rozrzutu na rysunku 1 pokazuje, co się dzieje: punkty przesuwają się nad linię pełnej zgodności (y = x), ale nadal leżą wzdłuż prostej.
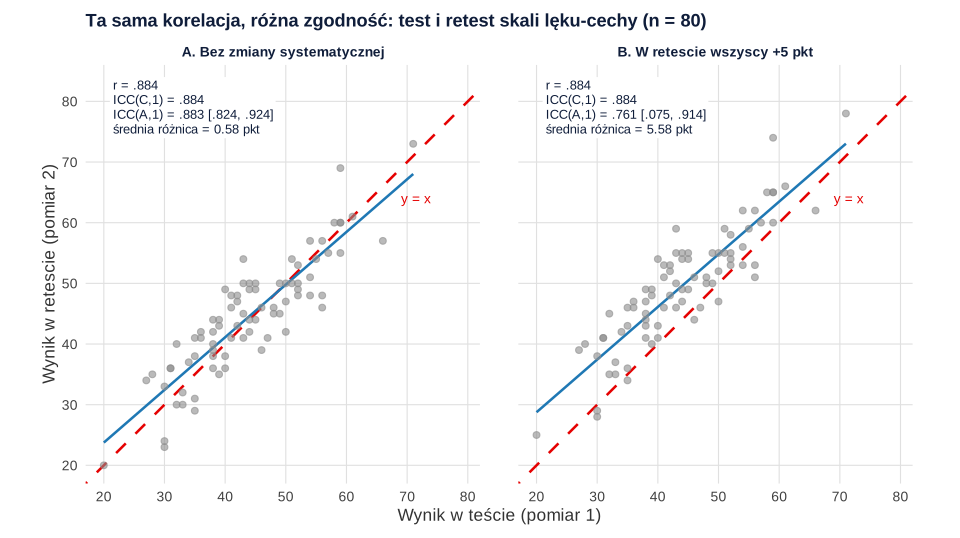
Wyniki ICC(1) z modelu jednoczynnikowego (.883 w wariancie A i .743 w wariancie B) prowadzą do podobnego wniosku. Zgodnie z zaleceniem Liljequista i in. (2019) w wariancie A – gdzie trzy jednopomiarowe ICC są niemal równe – błędu systematycznego nie ma, a w wariancie B różnica między .884 a .761 go ujawnia.
Wykres Blanda–Altmana i błąd pomiaru
ICC to jedna liczba. Aldridge i in. (2017) zalecają dodatkowo granice zgodności (ang. limits of agreement): średnią różnicę między pomiarami ± 1.96 odchylenia standardowego różnic. Wyznaczają one przedział, w którym mieści się 95% różnic między testem a retestem. Na wykresie Blanda–Altmana różnice nanosi się na tle średniej z obu pomiarów (rysunek 2).
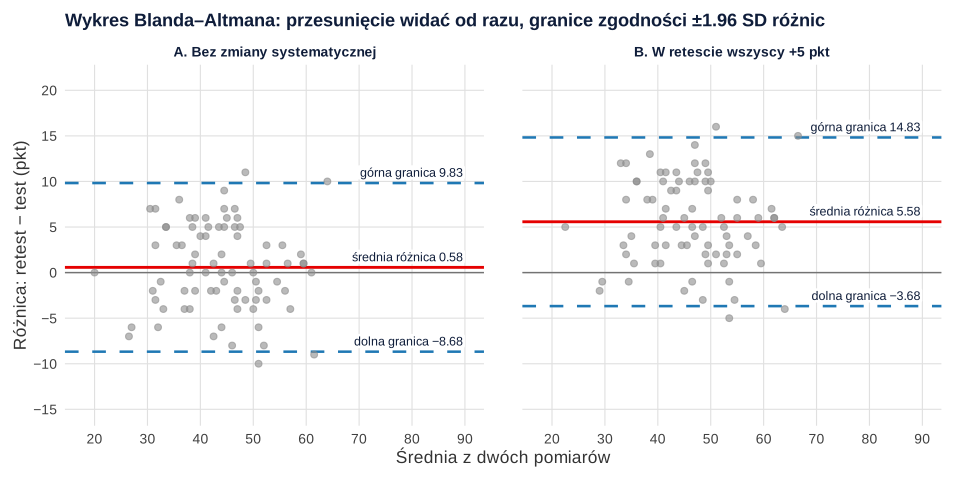
W wariancie A średnia różnica wynosi 0.58 punktu, a granice zgodności – od −8.68 do 9.83 punktu. W wariancie B cały pas przesuwa się w górę (od −3.68 do 14.83), więc systematyczny wzrost widać od razu. Z ICC można też policzyć błąd standardowy pomiaru (SEM) i najmniejszą wykrywalną zmianę (MDC) – przydatne, gdy wynik pojedynczej osoby porównujesz w czasie albo z normami testowymi:
MDC95 = 1.96 × √2 × SEM = 9.34
Zmiana wyniku pojedynczej osoby mniejsza niż około 9 punktów mieści się więc w granicach błędu pomiaru. Nie myl SEM z błędem standardowym średniej – ten zależy od liczebności próby, a SEM od rzetelności narzędzia.
Jak opisać rzetelność test–retest w pracy (APA)
W opisie narzędzia w rozdziale metodologicznym podaj odstęp, liczebność, formę ICC (model, typ, definicję), program, przedział ufności i – najlepiej – średnią różnicę z granicami zgodności. Koo i Li (2016) proponują oceniać rzetelność na podstawie całego 95% przedziału ufności: poniżej .50 słaba, .50–.75 umiarkowana, .75–.90 dobra, powyżej .90 doskonała.
Jeśli porównujesz kilka skal, dodaj kolumnę ICC do tabeli rzetelności. Odstęp między pomiarami zaplanuj już na etapie badania pilotażowego.
Przykład w R
Kod odtwarza dane z przykładu i liczy korelację Pearsona, wszystkie formy ICC, test t dla prób zależnych, granice zgodności Blanda–Altmana oraz SEM i MDC. Liczby w tekście i na rysunkach pochodzą z tego kodu.
Test–retest: korelacja, ICC i granice zgodności
R
library(psych)
set.seed(2034)                                      # dane symulowane: 80 studentów, dwa pomiary
n <- 80
prawdziwy <- rnorm(n, mean = 44, sd = 9)            # stały poziom lęku-cechy
test   <- pmin(pmax(round(prawdziwy + rnorm(n, 0, 4)), 20), 80)   # pomiar 1 (wynik 20–80)
retest <- pmin(pmax(round(prawdziwy + rnorm(n, 0, 4)), 20), 80)   # pomiar 2 po 4 tygodniach
retest_B <- retest + 5                              # wariant B: w retescie wszyscy +5 pkt

round(c(r_A = cor(test, retest), r_B = cor(test, retest_B)), 3)  # korelacja Pearsona
ICC(data.frame(test, retest))                       # wariant A: sześć form ICC
round(ICC(data.frame(test, retest_B))$results[1:3, c("ICC", "lower bound", "upper bound")], 3)  # wariant B
t.test(retest, test, paired = TRUE)                 # wariant A: różnica średnich
roznice <- data.frame(A = retest - test, B = retest_B - test)
round(sapply(roznice, function(d) c(srednia = mean(d), dolna_LOA = mean(d) - 1.96 * sd(d),
                                    gorna_LOA = mean(d) + 1.96 * sd(d))), 2)   # Bland–Altman
icc_A <- ICC(data.frame(test, retest))$results["Single_random_raters", "ICC"]   # ICC(A,1)
SEM <- sd(test) * sqrt(1 - icc_A)                   # błąd standardowy pomiaru
round(c(SEM = SEM, MDC95 = 1.96 * sqrt(2) * SEM), 2)                # najmniejsza wykrywalna zmiana
Wynik w R
  r_A   r_B
0.884 0.884
Call: ICC(x = data.frame(test, retest))

Intraclass correlation coefficients
                         type  ICC  F df1 df2       p lower bound upper bound
Single_raters_absolute   ICC1 0.88 16  79  80 2.7e-28        0.82        0.92
Single_random_raters     ICC2 0.88 16  79  79 4.7e-28        0.82        0.92
Single_fixed_raters      ICC3 0.88 16  79  79 4.7e-28        0.82        0.92
Average_raters_absolute ICC1k 0.94 16  79  80 2.7e-28        0.90        0.96
Average_random_raters   ICC2k 0.94 16  79  79 4.7e-28        0.90        0.96
Average_fixed_raters    ICC3k 0.94 16  79  79 4.7e-28        0.90        0.96

 Number of subjects = 80     Number of Judges =  2
See the help file for a discussion of the other 4 McGraw and Wong estimates,                         ICC lower bound upper bound
Single_raters_absolute 0.743       0.627       0.827
Single_random_raters   0.761       0.075       0.914
Single_fixed_raters    0.884       0.824       0.924

	Paired t-test

data:  retest and test
t = 1.0897, df = 79, p-value = 0.2791
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -0.4752522  1.6252522
sample estimates:
mean difference
          0.575

              A     B
srednia    0.58  5.58
dolna_LOA -8.68 -3.68
gorna_LOA  9.83 14.83
  SEM MDC95
 3.37  9.34
SPSS i JASP. W SPSS wybierz Analiza → Skala → Analiza rzetelności, przenieś obie zmienne, w Statystykach zaznacz współczynnik korelacji wewnątrzklasowej i ustaw model dwuczynnikowy mieszany (Two-Way Mixed) oraz typ zgodność bezwzględna (Absolute Agreement); wiersz Single Measures to ICC(A,1). W JASP moduł Reliability ma analizy Intraclass Correlation i – w nowszych wersjach – Bland-Altman Plots.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://doi.org/10.32614/CRAN.package.psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Sama korelacja Pearsona – nie wykrywa zmian systematycznych między pomiarami (Berchtold, 2016). Podawaj ICC(A,1), a przy różnicy między ICC(C,1) i ICC(A,1) – oba (Liljequist i in., 2019).
- Nieistotny test t jako dowód zgodności – brak istotnej różnicy średnich nie mówi, jak bardzo różnią się wyniki poszczególnych osób (Aldridge i in., 2017). Pokaż granice zgodności.
- Odstęp „z przyzwyczajenia” – uzasadnij go naturą cechy i ryzykiem zapamiętania odpowiedzi (Polit, 2014).
- Test–retest dla stanu – nastrój czy lęk-stan mają się zmieniać; niski współczynnik nie świadczy wtedy o złym narzędziu.
- Mała i jednorodna próba – ICC zależy od zróżnicowania osób; przy małej zmienności międzyosobniczej będzie niski nawet dla precyzyjnego narzędzia (Hedge i in., 2018).
- Stabilność jako dowód trafności – wynik może być stabilny i zarazem mierzyć nie to, co trzeba; trafność wymaga osobnych dowodów, np. trafności kryterialnej.
- Brak formy ICC – napisz, jaki model, typ i definicję wybrano (Koo i Li, 2016); „ICC = .88” bez tych informacji jest niejednoznaczne.
Najczęstsze pytania
Co to jest rzetelność test–retest?
To stabilność wyników narzędzia w czasie. Te same osoby wypełniają ten sam test dwukrotnie, a następnie sprawdza się, czy uzyskały podobne wyniki – najlepiej współczynnikiem korelacji wewnątrzklasowej ICC(A,1) z 95% przedziałem ufności.
Jaki odstęp między testem a retestem wybrać?
Taki, żeby badani nie pamiętali odpowiedzi, a mierzona cecha nie zdążyła się naprawdę zmienić. Odstęp trzeba uzasadnić naturą cechy, a nie przyjmować z przyzwyczajenia. Unikaj okresów, które mogą zmienić wyniki wszystkich osób, np. sesji egzaminacyjnej między pomiarami.
Czy do rzetelności test–retest można użyć korelacji Pearsona?
Można ją podać pomocniczo, ale nie jako jedyną miarę. Korelacja sprawdza tylko zachowanie kolejności osób: gdyby w retescie wszyscy uzyskali o 5 punktów więcej, r pozostałoby bez zmian. ICC zgodności bezwzględnej traktuje takie przesunięcie jako błąd.
Jaka wartość rzetelności test–retest jest dobra?
Według wytycznych Koo i Li (2016) ICC poniżej .50 oznacza słabą rzetelność, .50–.75 umiarkowaną, .75–.90 dobrą, a powyżej .90 doskonałą. Oceniaj cały 95% przedział ufności, a nie samą wartość punktową: przedział [.82, .92] oznacza rzetelność dobrą do doskonałej.
Jak policzyć rzetelność test–retest w SPSS?
Wybierz Analiza → Skala → Analiza rzetelności, przenieś zmienne z obu pomiarów, a w Statystykach zaznacz współczynnik korelacji wewnątrzklasowej. Ustaw model dwuczynnikowy mieszany i typ zgodność bezwzględna, a z tabeli odczytaj wiersz Single Measures.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikBadanie pilotażowe: po co, ile osób, co sprawdzić
Pilotaż a pretest, ile osób zbadać, co sprawdzić w danych i dlaczego nie liczyć mocy z efektu z pilotażu. Z symulacją, kodem R i wzorem opisu.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aldridge, V. K., Dovey, T. M., & Wade, A. (2017). Assessing test-retest reliability of psychological measures: Persistent methodological problems. European Psychologist, 22(4), 207–218. https://doi.org/10.1027/1016-9040/a000298 ● Otwarty dostęp: pełny tekst
- Berchtold, A. (2016). Test–retest: Agreement or reliability? Methodological Innovations, 9, Article 2059799116672875. https://doi.org/10.1177/2059799116672875 ● Otwarty dostęp
- Hedge, C., Powell, G., & Sumner, P. (2018). The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences. Behavior Research Methods, 50(3), 1166–1186. https://doi.org/10.3758/s13428-017-0935-1 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Liljequist, D., Elfving, B., & Skavberg Roaldsen, K. (2019). Intraclass correlation – A discussion and demonstration of basic features. PLOS ONE, 14(7), Article e0219854. https://doi.org/10.1371/journal.pone.0219854 ● Otwarty dostęp
- Polit, D. F. (2014). Getting serious about test–retest reliability: A critique of retest research and some recommendations. Quality of Life Research, 23(6), 1713–1720. https://doi.org/10.1007/s11136-014-0632-9
Cytowania BibTeX
@article{aldridge2017assessing, author={Aldridge, Victoria K. and Dovey, Terence M. and Wade, Angie}, title={{Assessing test-retest reliability of psychological measures: Persistent methodological problems}}, journal={European Psychologist}, year={2017}, volume={22}, number={4}, pages={207--218}, doi={10.1027/1016-9040/a000298}}@article{berchtold2016test, author={Berchtold, André}, title={{Test–retest: Agreement or reliability?}}, journal={Methodological Innovations}, year={2016}, volume={9}, eid={2059799116672875}, doi={10.1177/2059799116672875}}@article{hedge2018reliability, author={Hedge, Craig and Powell, Georgina and Sumner, Petroc}, title={{The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={1166--1186}, doi={10.3758/s13428-017-0935-1}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{liljequist2019intraclass, author={Liljequist, David and Elfving, Britt and Skavberg Roaldsen, Kirsti}, title={{Intraclass correlation – A discussion and demonstration of basic features}}, journal={PLOS ONE}, year={2019}, volume={14}, number={7}, eid={e0219854}, doi={10.1371/journal.pone.0219854}}@article{polit2014getting, author={Polit, Denise F.}, title={{Getting serious about test–retest reliability: A critique of retest research and some recommendations}}, journal={Quality of Life Research}, year={2014}, volume={23}, number={6}, pages={1713--1720}, doi={10.1007/s11136-014-0632-9}}