Co to jest wykres rozrzutu?
Wykres rozrzutu (inaczej wykres punktowy albo korelacyjny; ang. scatterplot) przedstawia jednocześnie dwie zmienne ilościowe. Każda osoba badana to jeden punkt: jego położenie na osi poziomej wyznacza wynik w jednej zmiennej, a na osi pionowej – w drugiej. Z chmury punktów odczytasz kierunek i siłę związku, jego kształt, nietypowe obserwacje i podgrupy.
Od tego wykresu zaczyna się analiza korelacji i regresji liniowej. Korelacja Pearsona mierzy siłę związku liniowego, a dla danych nienormalnych, porządkowych lub z obserwacjami odstającymi Schober i in. (2018) zalecają korelację Spearmana jako miarę związku monotonicznego. To, który współczynnik pasuje do danych, najszybciej podpowiada właśnie wykres. Mimo to w publikacjach wykresy rozrzutu pojawiają się rzadko: Weissgerber i in. (2015) w przeglądzie 703 artykułów z czołowych czasopism fizjologicznych stwierdzili, że dane ciągłe pokazywano głównie na wykresach słupkowych i liniowych.
Jak zbudować dobry wykres rozrzutu
- Osie. Na osi poziomej umieść predyktor, np. stres, a na pionowej – zmienną wynikową. Podpisz osie nazwą zmiennej i zakresem skali, np. „Problemy ze snem (0–21)”. Oś nie musi zaczynać się od zera – inaczej niż na wykresie słupkowym.
- Punkty. Małe, jednolite i półprzezroczyste. Przy kilkuset osobach przezroczystość pokazuje, gdzie punkty się zagęszczają.
- Linia. Prosta regresji (linia najlepszego dopasowania) z 95% pasmem ufności pokazuje kierunek związku i niepewność oszacowania. Wygładzona krzywa (loess) pomaga sprawdzić, czy związek jest naprawdę liniowy.
- Rozkłady brzegowe. Histogramy przy osiach pokazują rozkład każdej zmiennej osobno, np. skośność albo efekt sufitu.
- Grupy. Jeśli w danych są grupy, np. warunki eksperymentalne, oznacz je kolorem i kształtem punktów.
- Skale dyskretne. Przy odpowiedziach 1–5 dodaj niewielki rozrzut losowy albo pokaż liczbę osób wielkością punktu – szczegóły niżej.
Gdy zmiennych jest kilka, zamiast pojedynczych rysunków przygotuj macierz wykresów rozrzutu (ang. scatterplot matrix): każda para zmiennych ma osobne pole, a na przekątnej widać rozkład każdej zmiennej. W R zrobisz ją funkcją pairs() albo pairs.panels() z pakietu psych, która dopisuje współczynniki korelacji. Przy kilkunastu zmiennych macierz staje się nieczytelna – wtedy pokaż tylko pary, których dotyczą hipotezy.
Co odczytać z wykresu rozrzutu?
Ten sam współczynnik korelacji może opisywać zupełnie różne dane. Klasyczny przykład to cztery zbiory Anscombe’a (1973), dostępne w R jako anscombe. Każdy ma średnią x równą 9, średnią y równą 7.50, korelację r = .82 i tę samą prostą regresji y = 3.00 + 0.50x, a na wykresach wyglądają zupełnie inaczej. Matejka i Fitzmaurice (2017) opracowali metodę generowania takich zbiorów – o identycznych statystykach i odmiennych wykresach – bo właśnie nimi najlepiej pokazuje się, po co oglądać dane. Rysunek 1 przenosi ten pomysł na przykład z psychologii.
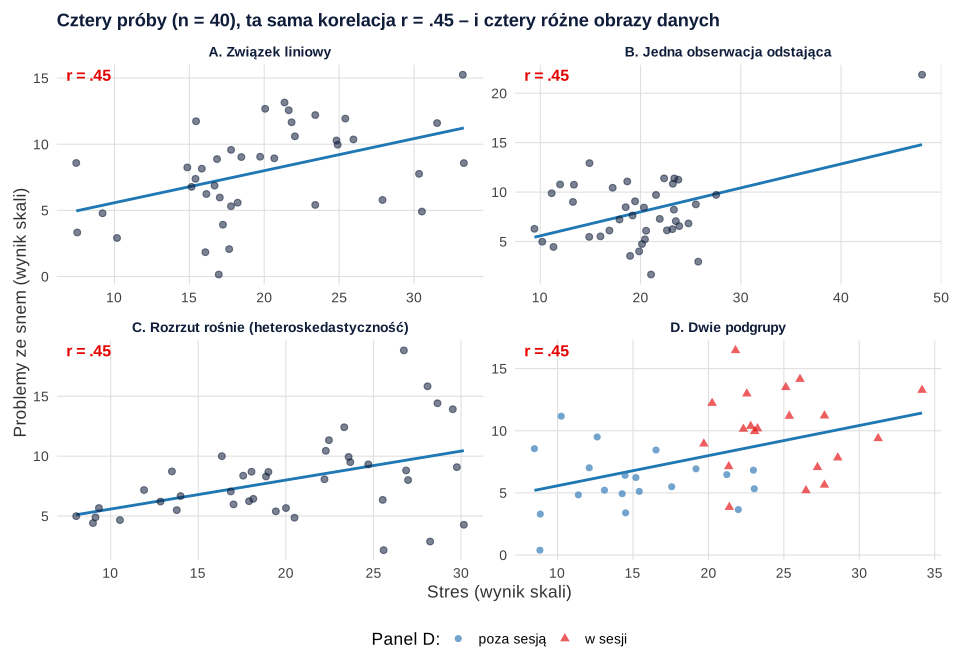
We wszystkich próbach korelacja wynosi r = .45, ale tylko w panelu A ta liczba dobrze opisuje dane. Na wykresie szukaj czterech rzeczy:
- Liniowość. Czy punkty układają się wzdłuż prostej, czy wzdłuż krzywej? Przy związku krzywoliniowym r Pearsona zaniża siłę zależności, a przy zależności w kształcie litery U może być bliski zera (zob. regresja krzywoliniowa).
- Obserwacje odstające. W panelu B u 39 osób nie ma żadnego związku (r = .00). Całą korelację tworzy jedna osoba z wynikiem stresu 48.1 i problemów ze snem 21.9. Sprawdź, czy to błąd wprowadzania danych, czy prawdziwy wynik (zob. obserwacja odstająca).
- Heteroskedastyczność. W panelu C rozrzut punktów wokół prostej rośnie razem ze stresem: odchylenie standardowe reszt wynosi 1.30 przy wynikach stresu poniżej 20 i 4.28 przy wynikach 20 i wyższych. Prosta dobrze przewiduje problemy ze snem u osób mało zestresowanych, a słabo u bardzo zestresowanych. W regresji narusza to założenie homoskedastyczności.
- Podgrupy. W panelu D w każdej z dwóch grup – studentów w sesji i poza nią – korelacja wynosi .00. Ogólną korelację tworzy różnica między grupami: w sesji wyższy jest zarówno stres, jak i problemy ze snem. Taki związek może być pozorny, bo za oba wyniki odpowiada trzecia zmienna.
Nakładające się punkty: dane z ankiet
Gdy obie zmienne mają tylko kilka możliwych wartości, np. odpowiedzi 1–5 na pojedyncze pozycje kwestionariusza, wiele osób ma te same pary odpowiedzi i ich punkty nakładają się na siebie. W przykładzie 300 studentów oceniło zmęczenie po zajęciach i trudności z koncentracją. Na zwykłym wykresie (rysunek 2A) widać tylko 23 punkty, bo tyle niepustych pól ma tabela 5 × 5, a punkt reprezentujący 41 osób wygląda tak samo jak punkt jednej osoby.
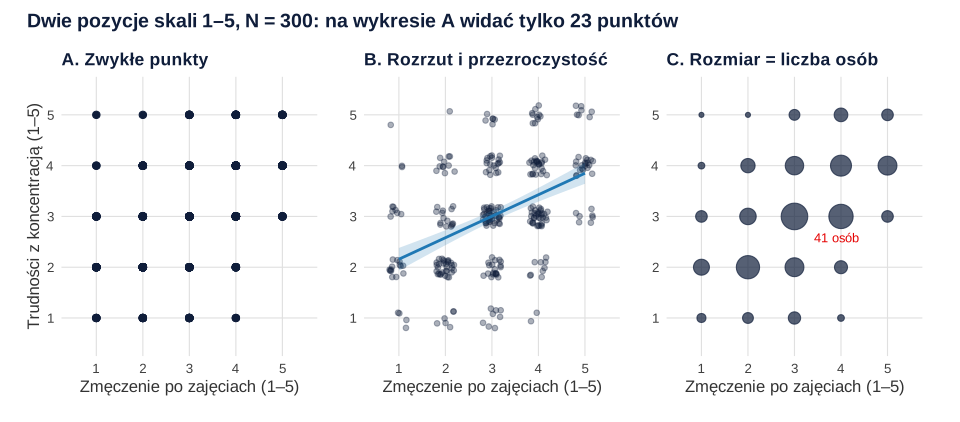
Są dwa proste rozwiązania. Rozrzut losowy (ang. jitter, rysunek 2B) przesuwa każdy punkt o niewielką, losową wartość, a przezroczystość pokazuje zagęszczenia. Przesunięcie dotyczy tylko rysunku: korelację liczysz na oryginalnych wartościach – tu r = .46, 95% CI [.37, .54]. Drugie rozwiązanie to wielkość punktu proporcjonalna do liczby osób (rysunek 2C). Pojedyncze pozycje skali Likerta są porządkowe, dlatego obok r Pearsona warto podać korelację Spearmana (Schober i in., 2018) – w przykładzie rs = .47. Wyniki skal liczone z kilku pozycji mają więcej możliwych wartości, więc punkty nakładają się rzadziej.
Wykres rozrzutu w pracy (APA)
Rysunek 3 to wersja, którą można wstawić do pracy: wyniki skal 300 osób jako półprzezroczyste punkty, prosta regresji z 95% pasmem ufności, wygładzony trend i histogramy rozkładów brzegowych.
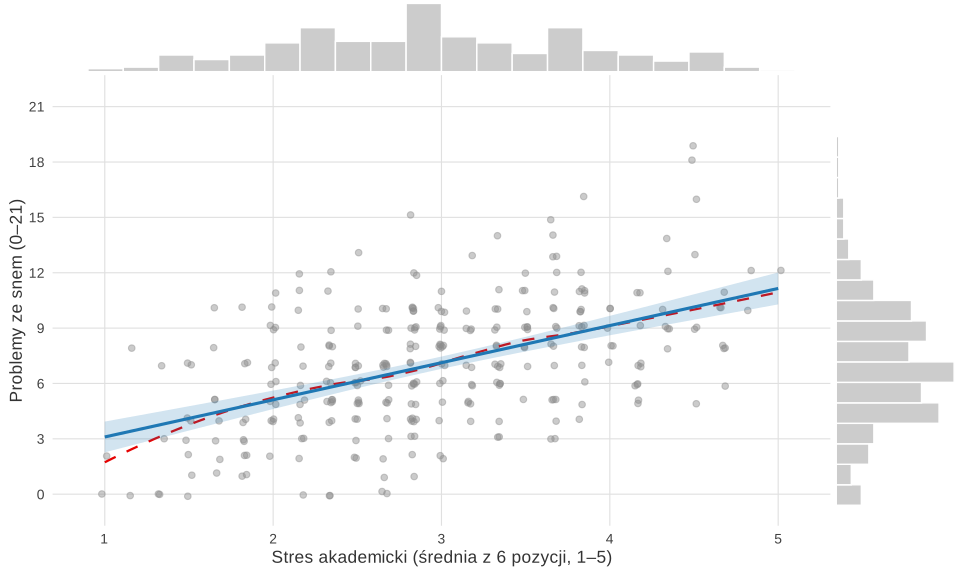
Krzywa wygładzona niemal pokrywa się z prostą, więc założenie liniowości jest rozsądne, a rozkład problemów ze snem jest prawie symetryczny (skośność 0.20). W stylu APA nad wykresem umieść numer i tytuł rysunku, a w nocie podaj liczebność, znaczenie linii i pasma oraz informację o rozrzucie losowym, jeśli go użyto. W tekście przywołaj rysunek i podaj współczynnik korelacji z przedziałem ufności:
Gdy zmiennych jest więcej, zestaw korelacje w tabeli korelacji w APA, a wykresy pokaż dla najważniejszych par. Jak sprawdzić nietypowe obserwacje, zanim usuniesz je z analizy, opisujemy w poradniku wartości odstające: jak je wykryć.
Przykład w R
Kod sprawdza korelacje w kwartecie Anscombe’a, odtwarza dane z rysunków 2 i 3, liczy korelację Pearsona i rysuje wykresy w pakiecie ggplot2 (rozkłady brzegowe dodaje pakiet ggExtra). W SPSS wykres rozrzutu narysujesz w menu Wykresy → Kreator wykresów → Rozrzutu/Punktowy (Graphs → Chart Builder → Scatter/Dot), a prostą regresji dodasz w edytorze wykresu poleceniem Elements → Fit Line at Total.
Korelacja i wykres rozrzutu z rozrzutem losowym, prostą regresji i rozkładami brzegowymi
R
library(ggplot2)
library(ggExtra)   # ggMarginal(): histogramy na marginesach wykresu

# Kwartet Anscombe'a: cztery zbiory, ta sama korelacja
sapply(1:4, function(i) round(cor(anscombe[[i]], anscombe[[i + 4]]), 3))

# Dane symulowane: dwie pozycje skali 1–5 (N = 300)
set.seed(2087)
l1 <- rnorm(300); l2 <- 0.5 * l1 + sqrt(1 - 0.5^2) * rnorm(300)
progi <- c(-Inf, -1.4, -0.5, 0.35, 1.2, Inf)
lik <- data.frame(zmeczenie = as.integer(cut(l1, progi)), koncentracja = as.integer(cut(l2, progi)))
table(lik)                                   # liczba osób w każdym z 25 pól
cor.test(lik$zmeczenie, lik$koncentracja)    # korelację licz na oryginalnych wartościach

# Rozrzut losowy (jitter) i przezroczystość – tylko na rysunku
wykres_likert <- ggplot(lik, aes(zmeczenie, koncentracja)) +
  geom_jitter(width = 0.2, height = 0.2, alpha = 0.35) +
  geom_smooth(method = "lm", formula = y ~ x) +   # prosta regresji z 95% pasmem ufności
  labs(x = "Zmęczenie po zajęciach (1–5)", y = "Trudności z koncentracją (1–5)")
wykres_likert   # alternatywa: geom_count() – wielkość punktu proporcjonalna do liczby osób

# Wyniki skal: stres (średnia z 6 pozycji, 1–5) i problemy ze snem (0–21), N = 300
set.seed(870)
lat <- rnorm(300)
stres_poz <- sapply(1:6, function(i) as.integer(cut(0.7 * lat + sqrt(1 - 0.49) * rnorm(300),
                                                    c(-Inf, -1.3, -0.45, 0.4, 1.25, Inf))))
sen_lat <- 0.5 * lat + sqrt(1 - 0.25) * rnorm(300)
skale <- data.frame(stres = rowMeans(stres_poz),
                    sen = pmin(pmax(round(7 + 3.2 * sen_lat + 0.6 * rnorm(300)), 0), 21))
cor.test(skale$stres, skale$sen)
wykres_skale <- ggplot(skale, aes(stres, sen)) +
  geom_point(alpha = 0.45) +
  geom_smooth(method = "loess", formula = y ~ x, se = FALSE, linetype = "dashed", colour = "red") +
  geom_smooth(method = "lm", formula = y ~ x) +
  labs(x = "Stres akademicki (średnia z 6 pozycji, 1–5)", y = "Problemy ze snem (0–21)")
ggMarginal(wykres_skale, type = "histogram")
Wynik w R
[1] 0.816 0.816 0.816 0.817
         koncentracja
zmeczenie  1  2  3  4  5
        1  4 14  7  2  1
        2  6 31 15 11  1
        3  8 20 41 19  6
        4  2  9 34 25 10
        5  0  0  7 20  7

	Pearson's product-moment correlation

data:  lik$zmeczenie and lik$koncentracja
t = 8.9283, df = 298, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.3651514 0.5443202
sample estimates:
      cor
0.4593962


	Pearson's product-moment correlation

data:  skale$stres and skale$sen
t = 10.135, df = 298, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.4169595 0.5859416
sample estimates:
      cor
0.5062947
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, ggExtra i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggExtra (wersja 0.11.0): Attali, D., & Baker, C. (2025). ggExtra: Add marginal histograms to 'ggplot2', and more 'ggplot2' enhancements [R package]. https://doi.org/10.32614/CRAN.package.ggExtra
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Korelacja bez wykresu – ta sama wartość r może opisywać związek liniowy, efekt jednej osoby albo różnicę między podgrupami (rysunek 1).
- Analiza na danych z rozrzutem losowym – jitter służy tylko do rysowania; statystyki licz na oryginalnych wartościach.
- Nakładające się punkty bez komentarza – przy skalach 1–5 czytelnik nie widzi, ile osób kryje się za punktem.
- Jedna prosta dla dwóch podgrup – oznacz grupy na wykresie i uwzględnij je w analizie.
- Przedłużanie prostej poza zakres danych – model opisuje zależność tylko w przedziale, w którym są obserwacje.
- Wnioski przyczynowe – wykres pokazuje współwystępowanie, a nie wpływ jednej zmiennej na drugą.
Najczęstsze pytania
Co to jest wykres rozrzutu?
To wykres, na którym każda osoba badana jest punktem: położenie na osi poziomej to jej wynik w jednej zmiennej, a na osi pionowej – w drugiej. Chmura punktów pokazuje kierunek, siłę i kształt związku dwóch zmiennych ilościowych oraz nietypowe obserwacje.
Jak czytać wykres rozrzutu?
Sprawdź kierunek (czy punkty rosną, czy maleją), kształt (prosta czy krzywa), siłę (jak ciasno punkty układają się wokół linii), obserwacje odstające, zmiany rozrzutu wzdłuż osi i ewentualne podgrupy. Dopiero potem wybierz współczynnik korelacji – Pearsona dla związku liniowego, Spearmana dla monotonicznego.
Którą zmienną umieścić na osi X?
Na osi poziomej umieść predyktor, czyli zmienną, od której zależność opisujesz (np. stres), a na osi pionowej – zmienną wynikową (np. problemy ze snem). Przy korelacji bez założonego kierunku wybór jest umowny, ale opisz osie nazwą zmiennej i zakresem skali.
Co zrobić, gdy punkty na wykresie rozrzutu się nakładają?
Przy danych dyskretnych, np. odpowiedziach 1–5, dodaj niewielki rozrzut losowy (jitter) i przezroczystość albo pokaż liczbę osób wielkością punktu. Rozrzut losowy stosuj tylko na rysunku – korelację i regresję licz na oryginalnych wartościach. W R: geom_jitter(width = 0.2, height = 0.2, alpha = 0.35) albo geom_count().
Czy wykres rozrzutu może zastąpić korelację?
Nie – wykres i współczynnik się uzupełniają. Wykres pokazuje, czy związek jest liniowy i czy nie tworzy go jedna obserwacja albo różnica między podgrupami, a korelacja z 95% przedziałem ufności podaje jego siłę i precyzję oszacowania.
Jak zrobić wykres rozrzutu w SPSS?
Wybierz Wykresy → Kreator wykresów, w galerii zaznacz Rozrzutu/Punktowy i przeciągnij prosty wykres rozrzutu na kanwę, a potem zmienne na osie. Prostą regresji dodasz po dwukrotnym kliknięciu wykresu w edytorze: Elements → Fit Line at Total.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Zawsze narysuj dane
Kwartet Anscombe’a i cztery pułapki korelacji na wykresach z R – z podpisem APA i zdaniem do Wyników przy każdym rysunku.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Matejka, J., & Fitzmaurice, G. (2017). Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing. In Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems (pp. 1290–1294). Association for Computing Machinery. https://doi.org/10.1145/3025453.3025912
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{anscombe1973graphs, author={Anscombe, Francis J.}, title={{Graphs in statistical analysis}}, journal={The American Statistician}, year={1973}, volume={27}, number={1}, pages={17--21}, doi={10.1080/00031305.1973.10478966}}@inproceedings{matejka2017same, author={Matejka, Justin and Fitzmaurice, George}, title={{Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing}}, booktitle={Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems}, year={2017}, pages={1290--1294}, publisher={Association for Computing Machinery}, doi={10.1145/3025453.3025912}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}