Co to jest wykres słupkowy?
Wykres słupkowy (ang. bar chart, bar graph) przedstawia kategorie jako słupki, których długość odpowiada liczebności, odsetkowi albo innej wartości. Kategorie leżą na jednej osi, wartości na drugiej, a słupki mogą być pionowe (wykres kolumnowy) albo poziome. To jedno z podstawowych narzędzi statystyki opisowej. W odróżnieniu od histogramu, który pokazuje rozkład zmiennej ilościowej w przylegających przedziałach, słupki są tu oddzielone – każdy odpowiada osobnej kategorii.
Weissgerber i in. (2015) przypominają, że wykresy słupkowe zaprojektowano dla zmiennych kategorialnych. Do tego nadają się bardzo dobrze: pokazują, ile osób wybrało każdą odpowiedź, jaki odsetek próby stanowią studenci danego roku albo który kierunek jest najliczniejszy. Kłopot zaczyna się wtedy, gdy słupek ma przedstawiać średnią zmiennej mierzonej na skali ilościowej, dlatego dużą część hasła poświęcamy właśnie tej sytuacji.
Wykres słupkowy dla liczebności i odsetków
Gdy pokazujesz rozkład zmiennej nominalnej albo porządkowej, trzymaj się kilku zasad:
- Oś wartości zaczyna się od zera. Czytelnik porównuje długości słupków, więc ucięta oś wyolbrzymia różnice.
- Kolejność ma znaczenie. Kategorie nominalne ułóż według liczebności – najdłuższy słupek wskaże wtedy od razu dominantę – a porządkowe w naturalnym porządku skali.
- Długie etykiety – słupki poziome. Treść odpowiedzi czyta się wtedy bez przekręcania głowy.
- Podaj podstawę odsetków. Napisz, od ilu osób liczono procenty, np. tylko od tych, które odpowiedziały na pytanie.
- Bez efektów 3D i zbędnych kolorów. Gdy kategorie różnią się tylko etykietą, wystarczy jeden kolor.
Cleveland i McGill (1984) uporządkowali elementarne zadania percepcyjne, które wykonujemy, odczytując liczby z wykresu, według tego, jak dokładnie ludzie je wykonują. Zalecili, by wykres opierał się na zadaniach możliwie wysoko w tym porządku. Po zastosowaniu tej zasady do wykresów słupkowych, słupków dzielonych i wykresów kołowych zaproponowali zamienniki, m.in. wykres punktowy (ang. dot chart) – kropkę na końcu niewidocznego słupka. W praktyce porównanie końców słupków albo kropek na wspólnej osi jest łatwiejsze niż porównanie kątów wycinków koła, dlatego wykres kołowy rzadko jest dobrym wyborem.
Słupki średnich, czyli wykres „dynamitowy”
W wielu pracach średnie grup przedstawia się jako słupki z wąsem błędu skierowanym w górę. Taki wykres nazywa się żartobliwie „dynamitowym” (ang. dynamite plot), bo przypomina laski dynamitu z lontem. Rysunek 1 pokazuje, co może ukrywać: trzy grupy po 30 studentów uczyły się listy 40 słów różnymi technikami.
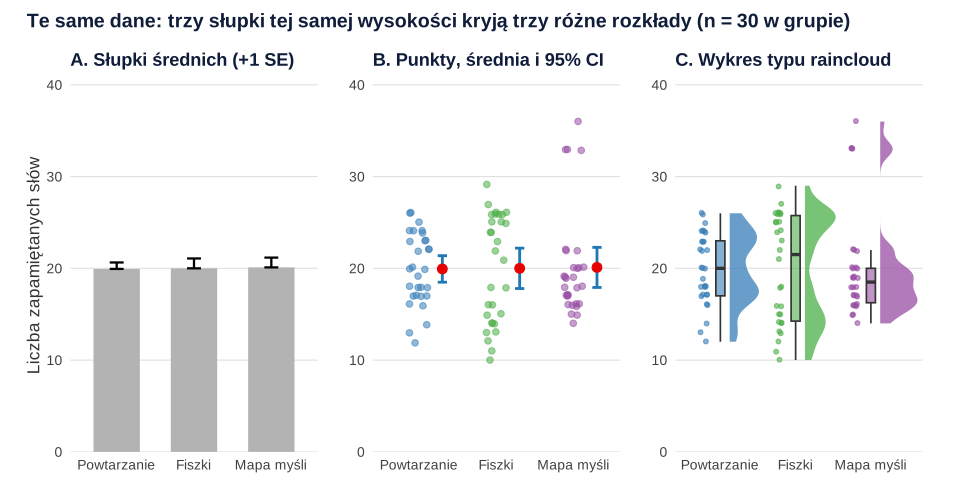
We wszystkich grupach średnia wynosi około 20 słów (19.93, 20.00 i 20.10), a błędy standardowe w grupach z fiszkami i mapą myśli są niemal identyczne (1.08 i 1.07). Słupki na panelu A wyglądają więc prawie tak samo – podobnie jak wynik analizy wariancji, F(2, 87) = 0.01, p = .992. Panel B pokazuje jednak trzy różne historie:
- powtarzanie – wyniki skupione wokół średniej, od 12 do 26 słów;
- fiszki – dwie podgrupy: 12 osób zapamiętało najwyżej 17 słów, a 14 osób co najmniej 23; w okolicy średniej (18–22 słowa) znalazły się tylko 4 osoby;
- mapa myśli – 23 z 30 osób ma wynik poniżej średniej, którą podnoszą cztery bardzo wysokie wyniki (33, 33, 33 i 36 słów).
To dokładnie problem opisany przez Weissgerber i in. (2015). Po przeglądzie 703 artykułów z czołowych czasopism fizjologicznych stwierdzili, że dane ciągłe przedstawiano tam głównie na wykresach słupkowych i liniowych, choć wiele różnych rozkładów daje taki sam wykres słupkowy, a pełne dane mogą prowadzić do innych wniosków niż same średnie. Słupek średniej ma też inne wady:
- Złudzenie „wewnątrz słupka”. Newman i Scholl (2012) pokazali, że oglądający uznają wartości leżące wewnątrz słupka za bardziej prawdopodobne niż wartości równie odległe od średniej, ale leżące nad słupkiem – tak, jakby słupek „zawierał” dane. Efekt pojawiał się z wąsami błędu i bez nich, u studentów, dorosłych spoza uczelni i w próbach internetowych.
- Zero bez znaczenia. Słupek musi zaczynać się od zera, a przy skali 1–7 czy czasach reakcji zero leży poza zakresem możliwych wyników. Duża część długości słupka nic wtedy nie znaczy.
- Niejasne wąsy. Wąs może oznaczać odchylenie standardowe, błąd standardowy albo przedział ufności, a każdy z nich niesie inną informację (Cumming i in., 2007). Wąs z panelu A (+1 SE) jest ponad dwa razy krótszy od ramienia 95% przedziału ufności z panelu B, które przy n = 30 wynosi 2.045 SE.
Co pokazać zamiast słupków średnich?
Allen i in. (2021) przypominają, że słupki średnich lub median z wąsami błędu krytykuje się za zniekształcanie wielkości efektu, ukrywanie wzorców w surowych danych i maskowanie założeń testów statystycznych. Lepsze wykresy pokazują jednocześnie dane i ich podsumowanie:
| Dane | Polecany wykres |
|---|---|
| Liczebności lub odsetki kategorii | wykres słupkowy albo punktowy |
| Zmienna ilościowa w kilku grupach, małe próby | wszystkie punkty, średnia i 95% CI (rysunek 1B) |
| Zmienna ilościowa, większe próby | wykres typu raincloud (rysunek 1C), wykres pudełkowy z punktami |
| Dwa pomiary tych samych osób | punkty połączone liniami dla każdej osoby |
| Pozycje skali Likerta | skumulowane słupki rozbieżne (rysunek 2B) |
Weissgerber i in. (2015) radzą, by przy małych próbach pokazywać pełne dane, np. na jednowymiarowym wykresie rozrzutu – z punktem dla każdej osoby. Słupki dla danych sparowanych są szczególnie mylące, bo sugerują niezależne grupy, choć chodzi o te same osoby. Wykres typu raincloud (Allen i in., 2021) łączy surowe punkty, krzywą gęstości („chmurę”) i podsumowanie, np. medianę, średnią albo przedział ufności. Na rysunku 1C od razu widać dwa szczyty w grupie z fiszkami i długi ogon w grupie z mapą myśli. Sens przedziału wokół średniej wyjaśniamy w haśle przedział ufności, a różnice między SD, SE i CI – w haśle błąd standardowy.
Słupki grupowane czy skumulowane? Dane z ankiet
Gdy kilka pytań ma tę samą skalę odpowiedzi, masz dwie możliwości. Słupki grupowane (ang. clustered) stawiają obok siebie osobny słupek dla każdej odpowiedzi – przy czterech stwierdzeniach i pięciu kategoriach to 20 słupków (rysunek 2A). Dobrze porównuje się w nich pojedyncze kategorie, ale trudno uchwycić ogólny obraz. Słupki skumulowane (ang. stacked) dzielą jeden słupek na części, które sumują się do 100%. Pokazują strukturę odpowiedzi, ale wspólną linię startu ma tylko pierwszy odcinek, więc pozostałe trudno porównywać między słupkami.
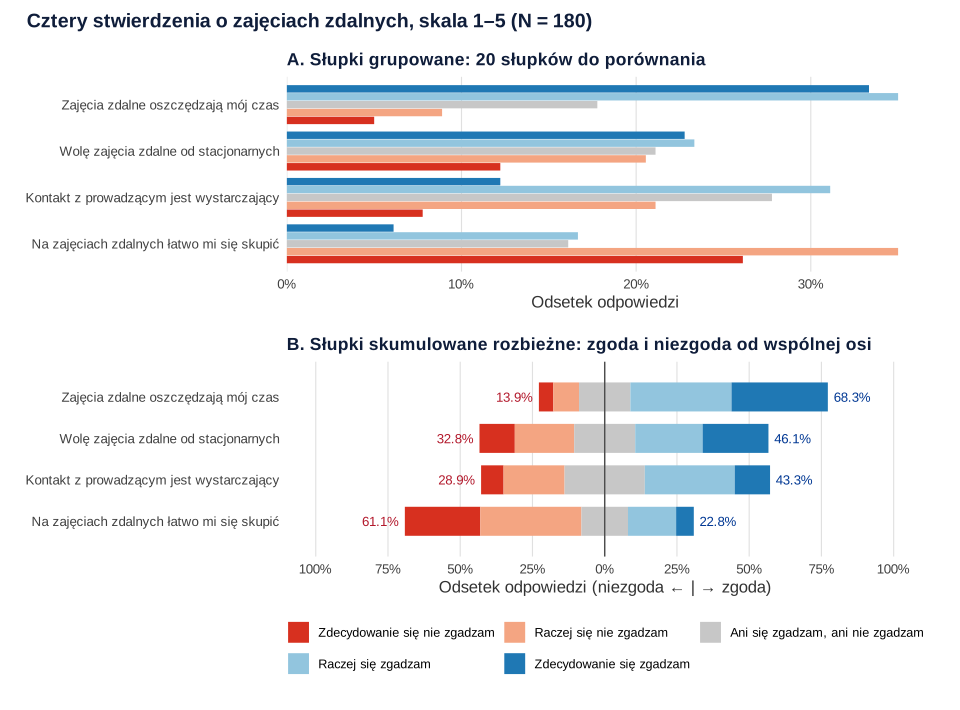
Heiberger i Robbins (2014) zalecają dla skal Likerta skumulowane słupki rozbieżne (ang. diverging stacked bar charts). Odpowiedzi wyrażające niezgodę rysuje się na lewo od wspólnej osi, zgodę – na prawo, a odpowiedź środkową dzieli się po połowie. Słupki mają wtedy wspólny punkt odniesienia, a stwierdzenia można uporządkować według odsetka zgody. Na rysunku 2B od razu widać, że z oszczędnością czasu zgodziło się 68.3% osób, a z łatwością skupienia tylko 22.8% (61.1% się nie zgodziło). Na panelu A ta sama informacja jest rozproszona w 20 słupkach.
Słupki grupowane wybierz, gdy porównujesz kilka kategorii między dwiema–trzema grupami, np. odsetek osób w trzech przedziałach wieku. Słupki skumulowane do 100% sprawdzą się przy porównaniu struktury odpowiedzi w grupach, a rozbieżne – przy pozycjach skali Likerta. Jak analizować i opisywać takie pytania, piszemy w poradniku analiza ankiety.
Wykres słupkowy w pracy (APA)
W stylu APA nad rysunkiem umieszczasz pogrubiony numer („Rysunek 1”), pod nim tytuł kursywą, a pod wykresem notę. W nocie podaj liczebność, podstawę odsetków i znaczenie wąsów błędu. W tekście przywołaj rysunek i opisz najważniejszy wynik, nie powtarzając wszystkich liczb:
Jeśli promotor lub czasopismo wymaga słupków średnich, nałóż na nie punkty z danymi, rysuj 95% przedział ufności w obie strony i napisz w nocie, co oznaczają wąsy. Więcej wzorów opisu wyników znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod odtwarza dane z rysunków, liczy statystyki do wykresu i buduje wykres punktowy ze średnią i 95% CI oraz wykres typu raincloud w pakietach ggplot2 i ggdist. W SPSS wykres słupkowy zbudujesz w menu Wykresy → Kreator wykresów → Słupkowy (Graphs → Chart Builder → Bar), gdzie wybierzesz wersję prostą, grupowaną albo skumulowaną; wąsy włączysz we właściwościach elementu (Element Properties → Display error bars), wskazując, czy mają przedstawiać 95% CI, SE czy SD.
Statystyki grup, wykres punktowy, raincloud i odsetki z ankiety
R
library(ggplot2)
library(ggdist)    # stat_halfeye(): „chmura” gęstości w wykresie typu raincloud

# Dane symulowane: liczba zapamiętanych słów po trzech technikach nauki (n = 30 w grupie)
set.seed(312)
powt <- round(rnorm(30, 20, 4))
fisz <- round(c(rnorm(15, 14, 2.5), rnorm(15, 26, 2.5)))
mapa <- round(c(rnorm(26, 17.6, 2.3), rnorm(4, 33, 2)))
dane <- data.frame(technika = factor(rep(c("Powtarzanie", "Fiszki", "Mapa myśli"), each = 30),
                                     levels = c("Powtarzanie", "Fiszki", "Mapa myśli")),
                   slowa = pmin(pmax(c(powt, fisz, mapa), 0), 40))

# M, SD, SE i 95% CI w każdej grupie
statystyki <- function(x) {
  se <- sd(x) / sqrt(length(x)); tk <- qt(0.975, length(x) - 1)
  c(M = mean(x), SD = sd(x), SE = se, CI_dolna = mean(x) - tk * se, CI_gorna = mean(x) + tk * se)
}
round(do.call(rbind, tapply(dane$slowa, dane$technika, statystyki)), 2)

# Zamiast słupków średnich: punkty, średnia i 95% CI (mean_cl_normal korzysta z pakietu Hmisc)
wykres_punkty <- ggplot(dane, aes(technika, slowa)) +
  geom_jitter(width = 0.1, height = 0, alpha = 0.5) +
  stat_summary(fun.data = mean_cl_normal, colour = "red", position = position_nudge(x = 0.3)) +
  labs(x = NULL, y = "Liczba zapamiętanych słów")

# Wykres typu raincloud: krzywa gęstości, wykres pudełkowy i punkty
wykres_raincloud <- ggplot(dane, aes(technika, slowa)) +
  stat_halfeye(adjust = 0.6, width = 0.5, justification = -0.3, .width = 0, point_colour = NA) +
  geom_boxplot(width = 0.12, outlier.shape = NA) +
  geom_jitter(width = 0.05, height = 0, alpha = 0.5)
wykres_punkty; wykres_raincloud

# Ankieta: cztery stwierdzenia na skali 1–5 (N = 180) – odsetki do wykresu rozbieżnego
set.seed(88)
prawd <- list(c(.05, .10, .15, .35, .35), c(.25, .32, .20, .15, .08),
              c(.12, .25, .28, .25, .10), c(.18, .22, .22, .20, .18))
ank <- sapply(prawd, function(p) sample(1:5, 180, replace = TRUE, prob = p))
colnames(ank) <- c("czas", "skupienie", "kontakt", "wole_zdalne")
round(100 * apply(ank, 2, function(x) table(factor(x, levels = 1:5))) / 180, 1)
round(100 * rbind(niezgoda = colMeans(ank <= 2), neutralnie = colMeans(ank == 3),
                  zgoda = colMeans(ank >= 4)), 1)
Wynik w R
                M   SD   SE CI_dolna CI_gorna
Powtarzanie 19.93 3.87 0.71    18.49    21.38
Fiszki      20.00 5.90 1.08    17.80    22.20
Mapa myśli  20.10 5.85 1.07    17.92    22.28
  czas skupienie kontakt wole_zdalne
1  5.0      26.1     7.8        12.2
2  8.9      35.0    21.1        20.6
3 17.8      16.1    27.8        21.1
4 35.0      16.7    31.1        23.3
5 33.3       6.1    12.2        22.8
           czas skupienie kontakt wole_zdalne
niezgoda   13.9      61.1    28.9        32.8
neutralnie 17.8      16.1    27.8        21.1
zgoda      68.3      22.8    43.3        46.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, ggdist i patchwork, a przedziały ufności w stat_summary() liczy pakiet Hmisc. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2025). ggdist: Visualizations of distributions and uncertainty [R package]. https://doi.org/10.5281/zenodo.3879620
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- Hmisc (wersja 5.2.5): Harrell, F. E., Jr. (2026). Hmisc: Harrell miscellaneous [R package]. https://doi.org/10.32614/CRAN.package.Hmisc
Najczęstsze błędy
- Słupki średnich bez danych – takie same słupki mogą kryć zupełnie różne rozkłady (Weissgerber i in., 2015); pokaż punkty, wykres pudełkowy albo raincloud.
- Wąsy bez opisu albo tylko w górę – czytelnik nie wie, czy to SD, SE czy 95% CI (Cumming i in., 2007).
- Oś nie od zera przy liczebnościach – różnice między słupkami wyglądają na większe, niż są.
- Słupki dla pomiarów powtarzanych – sugerują niezależne grupy; połącz punkty każdej osoby liniami.
- Odsetki bez podstawy – podaj N i napisz, czy procenty liczono od wszystkich badanych, czy od osób, które odpowiedziały na pytanie.
- Efekty 3D, wykres kołowy, wiele odcinków w słupku bez wspólnej osi – utrudniają porównania; przy skali Likerta użyj słupków rozbieżnych.
Najczęstsze pytania
Kiedy stosować wykres słupkowy?
Gdy pokazujesz liczebności albo odsetki kategorii zmiennej nominalnej lub porządkowej, np. kierunku studiów albo odpowiedzi na pytanie zamknięte. Oś wartości zacznij od zera, kategorie nominalne ułóż według liczebności, a przy długich etykietach użyj słupków poziomych.
Czym różni się wykres słupkowy od histogramu?
Wykres słupkowy przedstawia osobne kategorie, więc słupki są oddzielone i można je dowolnie uporządkować. Histogram pokazuje rozkład zmiennej ilościowej w przylegających przedziałach, a kolejność słupków wynika ze skali.
Czy można pokazywać średnie na wykresie słupkowym?
Lepiej tego unikać. Słupki średnich ukrywają rozkład i liczebność grup, a oglądający uznają wartości wewnątrz słupka za bardziej prawdopodobne niż równie odległe wartości nad nim (Newman i Scholl, 2012). Pokaż wszystkie punkty ze średnią i 95% przedziałem ufności albo wykres typu raincloud.
Co to jest wykres dynamitowy?
To potoczna nazwa wykresu słupkowego średnich z wąsem błędu skierowanym w górę – przypomina laski dynamitu z lontem. Wiele różnych rozkładów daje taki sam wykres tego typu, dlatego przy danych ciągłych warto go zastąpić wykresem pokazującym pojedyncze wyniki (Weissgerber i in., 2015).
Słupki skumulowane czy grupowane – co wybrać?
Słupki grupowane są dobre do porównania kilku kategorii między niewieloma grupami. Słupki skumulowane do 100% pokazują strukturę odpowiedzi, ale tylko pierwszy odcinek ma wspólną linię startu. Dla pozycji skali Likerta najlepsze są skumulowane słupki rozbieżne: niezgoda na lewo, zgoda na prawo od wspólnej osi (Heiberger i Robbins, 2014).
Co oznaczają wąsy na wykresie słupkowym?
Mogą przedstawiać odchylenie standardowe, błąd standardowy albo przedział ufności – a każdy z nich niesie inną informację (Cumming i in., 2007). Dlatego w podpisie lub nocie rysunku zawsze napisz, co pokazują wąsy, np. „wąsy: 95% przedział ufności”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Porównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →PoradnikWykresy w Excelu do pracy dyplomowej
Słupki błędów z UFNOŚĆ.T, histogram, linia trendu i R², Likert 100% skumulowany i wykres przed–po – krok po kroku, z plikiem XLSX i przenoszeniem do Worda.
Czytaj →PoradnikPytanie wielokrotnego wyboru: tabela i wykres APA
Tabela APA z % osób i 95% CI, porównanie grup, poziome słupki, punkty dla grup, macierz współwystępowania i wykres kombinacji – z kodem R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., van Langen, J., & Kievit, R. A. (2021). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, Article 63. https://doi.org/10.12688/wellcomeopenres.15191.2 ● Otwarty dostęp
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05 ● Otwarty dostęp
- Newman, G. E., & Scholl, B. J. (2012). Bar graphs depicting averages are perceptually misinterpreted: The within-the-bar bias. Psychonomic Bulletin & Review, 19(4), 601–607. https://doi.org/10.3758/s13423-012-0247-5 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@article{allen2021raincloud, author={Allen, Micah and Poggiali, Davide and Whitaker, Kirstie and Marshall, Tom Rhys and van Langen, Jordy and Kievit, Rogier A.}, title={{Raincloud plots: A multi-platform tool for robust data visualization}}, journal={Wellcome Open Research}, year={2021}, volume={4}, eid={63}, doi={10.12688/wellcomeopenres.15191.2}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{heiberger2014design, author={Heiberger, Richard M. and Robbins, Naomi B.}, title={{Design of diverging stacked bar charts for Likert scales and other applications}}, journal={Journal of Statistical Software}, year={2014}, volume={57}, number={5}, pages={1--32}, doi={10.18637/jss.v057.i05}}@article{newman2012bar, author={Newman, George E. and Scholl, Brian J.}, title={{Bar graphs depicting averages are perceptually misinterpreted: The within-the-bar bias}}, journal={Psychonomic Bulletin \& Review}, year={2012}, volume={19}, number={4}, pages={601--607}, doi={10.3758/s13423-012-0247-5}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}