Co to jest błąd standardowy?
Błąd standardowy (ang. standard error, SE) mówi, jak bardzo oszacowanie – najczęściej średnia – zmieniałoby się, gdyby badanie powtarzać wiele razy na nowych próbach z tej samej populacji. Formalnie jest to odchylenie standardowe rozkładu z prób danej statystyki (Lee i in., 2015). Im mniejszy błąd standardowy, tym precyzyjniej średnia z próby szacuje średnią w populacji.
Błąd standardowy nie opisuje więc różnic między osobami badanymi, tylko niepewność oszacowania. To rozróżnienie – opis danych a wnioskowanie – podkreślają Altman i Bland (2005): odchylenie standardowe opisuje zmienność obserwacji, a błąd standardowy służy do oceny precyzji wyniku, na przykład przy budowaniu przedziału ufności.
Własny błąd standardowy ma każda statystyka liczona z próby: średnia, różnica średnich, odsetek, współczynnik korelacji czy współczynnik regresji. W wydrukach programów (SPSS, R, JASP) to kolumna „Std. Error” albo „SE”. Gdy ktoś mówi po prostu „błąd standardowy”, zwykle ma na myśli błąd standardowy średniej (ang. standard error of the mean, SEM).
Wzór na błąd standardowy średniej
- SEM – błąd standardowy średniej,
- SD – odchylenie standardowe w próbie (liczone z mianownikiem n − 1),
- n – liczebność próby.
Wzór pokazuje dwie rzeczy. Po pierwsze, błąd standardowy rośnie razem ze zróżnicowaniem wyników: im bardziej osoby różnią się między sobą, tym mniej pewna jest średnia. Po drugie, maleje wraz z pierwiastkiem z liczebności – czterokrotnie większa próba daje dwukrotnie mniejszy błąd standardowy. Przejście z 25 do 100 osób poprawia więc precyzję o połowę, a z 100 do 400 osób – znowu tylko o połowę. Ma to bezpośrednie znaczenie przy planowaniu badania (zob. dobór liczebności próby).
Inne często używane wzory zebraliśmy w tabeli:
| Statystyka | Błąd standardowy | Przykład |
|---|---|---|
| Średnia | SE = SD / √n | SD = 13.48, n = 25 → SE = 2.70 |
| Odsetek (proporcja) | SE = √[p(1 − p) / n] | 40% odpowiedzi „tak” wśród 200 osób → SE = .035, czyli 3.5 punktu procentowego |
| Różnica dwóch niezależnych średnich | SE = √(SE1² + SE2²) | SE1 = 2.0, SE2 = 1.5 → SE = 2.5 |
W modelach statystycznych, na przykład w regresji, błędy standardowe współczynników liczy program. Interpretacja jest ta sama: to typowa wielkość „wahania” oszacowania między kolejnymi próbami.
Skąd się bierze błąd standardowy? Symulacja
Błąd standardowy najłatwiej zrozumieć, gdy zobaczy się rozkład z prób. W symulacji wylosowaliśmy 10 000 prób z populacji wyników testu o średniej 100 i odchyleniu standardowym 15 – najpierw po 10 osób, potem po 40 – i w każdej próbie policzyliśmy średnią. Histogramy na rysunku 1 pokazują, jak rozkładają się te średnie.
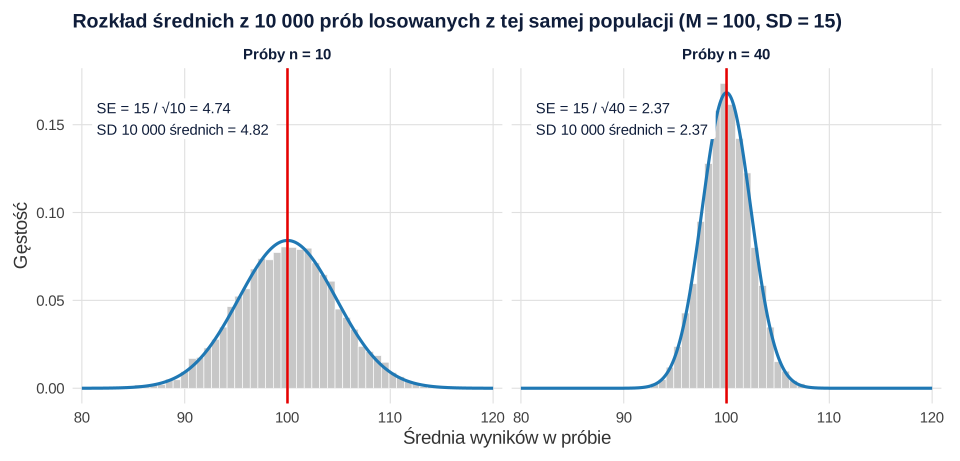
Średnie z prób skupiają się wokół prawdziwej wartości 100, ale nie trafiają w nią idealnie. Ich odchylenie standardowe wyniosło 4.82 dla prób dziesięcioosobowych i 2.37 dla prób czterdziestoosobowych – prawie dokładnie tyle, ile przewiduje wzór: 15/√10 = 4.74 i 15/√40 = 2.37. To właśnie jest błąd standardowy: odchylenie standardowe średnich, które uzyskalibyśmy, powtarzając badanie. Kształt tego rozkładu zbliża się do rozkładu normalnego także wtedy, gdy same wyniki nie mają rozkładu normalnego – mówi o tym centralne twierdzenie graniczne.
W prawdziwym badaniu mamy tylko jedną próbę, więc rozkładu z prób nie widzimy. Błąd standardowy szacujemy wtedy ze wzoru, podstawiając odchylenie standardowe z próby.
Błąd standardowy a odchylenie standardowe
Pomylenie tych dwóch miar to jeden z najczęstszych błędów w raportach z badań. Nagele (2003) przejrzał cztery czołowe czasopisma anestezjologiczne i stwierdził, że w 2001 roku 23% artykułów (198 z 860) opisywało zmienność próby za pomocą SE zamiast SD. Ponieważ SE jest zawsze mniejszy od SD, czytelnik nie docenia wtedy rozproszenia wyników.
| Cecha | Odchylenie standardowe (SD) | Błąd standardowy (SE) |
|---|---|---|
| Co opisuje | Rozproszenie wyników osób w próbie | Niepewność oszacowania (np. średniej) |
| Czy maleje, gdy rośnie n? | Nie – stabilizuje się wokół wartości w populacji | Tak – proporcjonalnie do 1/√n |
| Do czego służy | Opis danych (statystyka opisowa) | Wnioskowanie: przedziały ufności, testy |
| Gdzie go raportować | Tabela statystyk opisowych: M (SD) | Pośrednio – przez 95% CI; wprost w tabelach modeli |
Zasada praktyczna: gdy opisujesz próbę, podaj SD; gdy opisujesz precyzję oszacowania, podaj przedział ufności. Tak właśnie odróżniają oba zastosowania Altman i Bland (2005).
Przykład: średnia, SD, SE i 95% przedział ufności
Dwadzieścia pięć osób rozwiązało test uwagi, którego norma populacyjna wynosi 100 punktów. Średni wynik w próbie to M = 106.24, a odchylenie standardowe SD = 13.48. Błąd standardowy średniej wynosi więc:
Aby zbudować 95% przedział ufności, mnożymy SE przez wartość krytyczną rozkładu t dla 24 stopni swobody, czyli 2.064:
Przedział nie obejmuje normy 100, co odpowiada istotnemu wynikowi testu t dla jednej próby: t(24) = 2.31, p = .030. Błąd standardowy jest zresztą mianownikiem statystyki t: (106.24 − 100) / 2.70 = 2.31. Różnica względem normy to 0.46 odchylenia standardowego (d = 0.46) – tę informację o wielkości efektu warto podać obok wyniku testu.
Słupki błędów: SD, SE czy przedział ufności?
Na wykresach ten sam punkt – średnią – można otoczyć trzema rodzajami słupków, które znaczą zupełnie co innego. Rysunek 2 pokazuje je dla danych z przykładu.
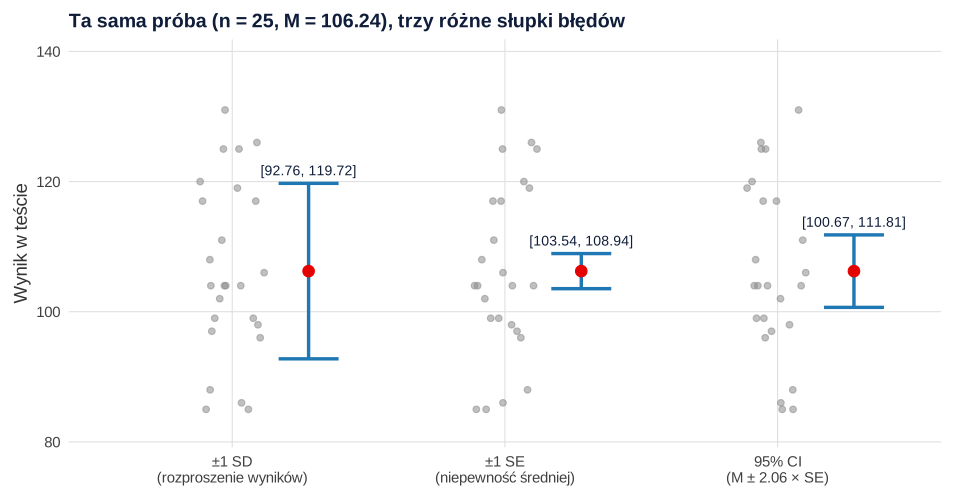
Cumming, Fidler i Vaux (2007) zwracają uwagę, że słupki błędów mogą przedstawiać odchylenia standardowe, błędy standardowe albo przedziały ufności, a każdy z tych typów niesie inną informację. Dlatego podpis rysunku zawsze musi mówić, co pokazują słupki. W praktyce:
- ±1 SD pokazuje rozproszenie osób – przydaje się, gdy chcesz pokazać, jak bardzo różnią się wyniki;
- ±1 SE to w przybliżeniu 68% przedział ufności – słupek jest wąski, więc łatwo przecenić precyzję i różnice między grupami;
- 95% CI (w przybliżeniu ±2 SE) najlepiej nadaje się do wnioskowania o średniej w populacji.
Jak opisać wynik w pracy (APA)
W rozdziale z wynikami przy statystykach opisowych zwykle nie podaje się SE – jego rolę przejmuje przedział ufności. Przykładowy opis wyniku z naszego przykładu:
Jeśli mimo to podajesz SE – na wykresie albo w tabeli modelu – zawsze napisz wprost, że to błąd standardowy. Nie zapisuj go w nawiasie po średniej bez oznaczenia: zapis „M = 106.24 (2.70)” czytelnik odczyta jako SD. Gotowy wzór znajdziesz w haśle tabela statystyk opisowych w APA.
Przykład w R
Kod liczy średnią, odchylenie standardowe, błąd standardowy, 95% przedział ufności i test t dla jednej próby. Liczby w tekście i na rysunku 2 pochodzą z tego kodu.
Błąd standardowy średniej i 95% CI
R
set.seed(15)
wyniki <- round(rnorm(25, mean = 104, sd = 15))   # wyniki 25 osób w teście uwagi
n  <- length(wyniki)
M  <- mean(wyniki)
SD <- sd(wyniki)                 # odchylenie standardowe (mianownik n - 1)
SE <- SD / sqrt(n)               # błąd standardowy średniej
t_kr <- qt(0.975, df = n - 1)    # wartość krytyczna t dla 95% CI
round(c(n = n, M = M, SD = SD, SE = SE, t_kr = t_kr), 3)
round(M + c(-1, 1) * t_kr * SE, 2)   # 95% przedział ufności dla średniej
t.test(wyniki, mu = 100)              # czy średnia różni się od normy 100?
(M - 100) / SD                        # d Cohena dla jednej próby
Wynik w R
      n       M      SD      SE    t_kr
 25.000 106.240  13.482   2.696   2.064
[1] 100.67 111.81

	One Sample t-test

data:  wyniki
t = 2.3141, df = 24, p-value = 0.02954
alternative hypothesis: true mean is not equal to 100
95 percent confidence interval:
 100.6748 111.8052
sample estimates:
mean of x
   106.24

[1] 0.4628279
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- SE zamiast SD w statystykach opisowych – wyniki wyglądają na mniej zróżnicowane, niż są w rzeczywistości (Nagele, 2003).
- Słupki błędów bez opisu – czytelnik nie wie, czy to SD, SE czy przedział ufności (Cumming i in., 2007).
- Wnioskowanie z nakładania się słupków SE – to, że dwa słupki ±1 SE na siebie nie nachodzą, nie oznacza jeszcze istotnej różnicy. Do porównań używaj testu albo przedziału ufności dla różnicy średnich.
- Mylenie błędu standardowego średniej ze standardowym błędem pomiaru – ten drugi pochodzi z psychometrii i zależy od rzetelności testu, a nie od liczebności próby.
- Utożsamianie małego SE z ważnym wynikiem – w bardzo dużej próbie SE jest mały nawet przy znikomej różnicy. Oceniaj także wielkość efektu.
Najczęstsze pytania
Co to jest błąd standardowy?
Błąd standardowy (SE) to odchylenie standardowe rozkładu statystyki z prób. Dla średniej mówi, o ile średnia z próby typowo różniłaby się od średniej w populacji, gdyby badanie powtarzać na nowych próbach. Im mniejszy SE, tym precyzyjniejsze oszacowanie.
Jak obliczyć błąd standardowy średniej?
Podziel odchylenie standardowe przez pierwiastek z liczebności próby: SE = SD / √n. Na przykład przy SD = 13.48 i n = 25 błąd standardowy wynosi 13.48 / 5 = 2.70. W R: sd(x) / sqrt(length(x)).
Czym różni się błąd standardowy od odchylenia standardowego?
Odchylenie standardowe opisuje, jak bardzo różnią się wyniki osób w próbie, i nie maleje wraz z liczebnością. Błąd standardowy opisuje niepewność oszacowania średniej i maleje proporcjonalnie do 1/√n. SD służy do opisu danych, SE – do wnioskowania.
Czy w pracy dyplomowej podawać SD czy SE?
Przy statystykach opisowych podawaj średnią i odchylenie standardowe, M (SD). Precyzję oszacowania pokazuj 95% przedziałem ufności. SE podawaj tam, gdzie jest standardem – np. w tabelach modeli regresji – i zawsze opisuj go wprost.
Czym jest standardowy błąd pomiaru w psychometrii?
To inna miara: opisuje typową różnicę między wynikiem obserwowanym a prawdziwym wynikiem osoby i zależy od rzetelności testu (SEM = SD × √(1 − rxx)). Błąd standardowy średniej zależy natomiast od liczebności próby i dotyczy oszacowania średniej w populacji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Czym jest centralne twierdzenie graniczne?
Intuicja, warunki i interaktywna symulacja pokazująca, dlaczego rozkład średnich może zbliżać się do normalnego, choć surowe dane są skośne.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Lee, D. K., In, J., & Lee, S. (2015). Standard deviation and standard error of the mean. Korean Journal of Anesthesiology, 68(3), 220–223. https://doi.org/10.4097/kjae.2015.68.3.220 ● Otwarty dostęp
- Nagele, P. (2003). Misuse of standard error of the mean (SEM) when reporting variability of a sample. A critical evaluation of four anaesthesia journals. British Journal of Anaesthesia, 90(4), 514–516. https://doi.org/10.1093/bja/aeg087 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{lee2015standard, author={Lee, Dong Kyu and In, Junyong and Lee, Sangseok}, title={{Standard deviation and standard error of the mean}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={3}, pages={220--223}, doi={10.4097/kjae.2015.68.3.220}}@article{nagele2003misuse, author={Nagele, Peter}, title={{Misuse of standard error of the mean (SEM) when reporting variability of a sample. A critical evaluation of four anaesthesia journals}}, journal={British Journal of Anaesthesia}, year={2003}, volume={90}, number={4}, pages={514--516}, doi={10.1093/bja/aeg087}}