P value – co to jest?
P value (wartość p, ang. p-value) to prawdopodobieństwo uzyskania wyniku co najmniej tak skrajnego jak zaobserwowany, przy założeniu, że hipoteza zerowa i pozostałe założenia testu są prawdziwe. Im mniejsza, tym gorzej dane pasują do modelu z H0: według oświadczenia Amerykańskiego Towarzystwa Statystycznego (ASA) wartość p może wskazywać, w jakim stopniu dane są niezgodne z określonym modelem statystycznym (Wasserstein i Lazar, 2016). Definicję, synonimy i zasady ASA zebraliśmy w haśle wartość p (p-value), a tutaj pokazujemy, skąd ta liczba się bierze.
Definicja brzmi abstrakcyjnie, dopóki nie wyobrazisz sobie świata, w którym H0 jest prawdziwa. W takim świecie to samo badanie powtarza się tysiące razy, za każdym razem na nowej próbie z tej samej populacji. Wyniki się różnią, bo każda próba jest trochę inna. P value odpowiada na pytanie: jaki odsetek tych powtórzeń dałby wynik co najmniej tak daleki od przewidywań H0 jak Twój? Jeśli bardzo mały – Twój wynik byłby w świecie H0 rzadkością.
Nikt nie powtarza badania tysiące razy i nie musi, bo kształt rozkładu wyników z takich powtórzeń znamy z teorii. Prowadzi do niego pięć kroków – i według nich zbudowaliśmy ten wpis:
- Rozkład z prób – jak zachowują się średnie z wielu prób w świecie H0.
- Centralne twierdzenie graniczne – dlaczego ten rozkład jest prawie normalny.
- Błąd standardowy – jak jest szeroki.
- Statystyka Z – gdzie na nim leży Twój wynik.
- Pole pod krzywą Z – jaka część rozkładu leży dalej niż Twój wynik. To jest p value.
Lakens (2021) przekonuje, że w niektórych sytuacjach to właśnie wartość p odpowiada na pytanie badacza, a priorytetem powinno być zapobieganie jej błędnym odczytaniom przez lepszą edukację. Dlatego zamiast listy zakazów pokazujemy mechanizm – na jednym przykładzie, policzonym ręcznie, w R i w Excelu.
Przykład, który przejdzie przez cały wpis
Kwestionariusz lęku ma normy w wynikach T: w populacji, na której go znormalizowano, średnia wynosi 50, a odchylenie standardowe 10 (zob. skala tenowa i normy testowe). Badasz 40 osób studiujących tuż przed egzaminem i otrzymujesz średnią M = 53.40 (dane symulowane, wszystkie obliczenia w R). Czy to więcej, niż mogłyby dać przypadkowe różnice między próbami? Hipoteza zerowa mówi, że średni lęk studentów przed egzaminem jest taki jak w normach: μ = 50.
Krok 1 i 2: rozkład z prób i centralne twierdzenie graniczne
Rozkład z prób (ang. sampling distribution) to rozkład wartości statystyki – tutaj średniej – w bardzo wielu próbach o tej samej liczebności, pobranych z tej samej populacji. To właśnie „rozkład wyników z powtórzeń” ze świata H0. Zbudujmy go symulacją.
Wyniki lęku w populacji nie układają się w dzwon. Większość osób ma lęk niski lub umiarkowany, a nieliczne – bardzo wysoki, więc rozkład jest prawostronnie skośny. Wyniki T liczone liniowo zachowują tę skośność; czym różnią się od wyników normalizowanych, wyjaśniamy w haśle wynik znormalizowany. W symulacji przyjęliśmy populację o średniej 50, odchyleniu standardowym 10 i skośności 1.41, a potem wylosowaliśmy z niej po 200 000 prób losowych liczących 5 i 40 osób. W każdej próbie policzyliśmy średnią (rysunek 1).
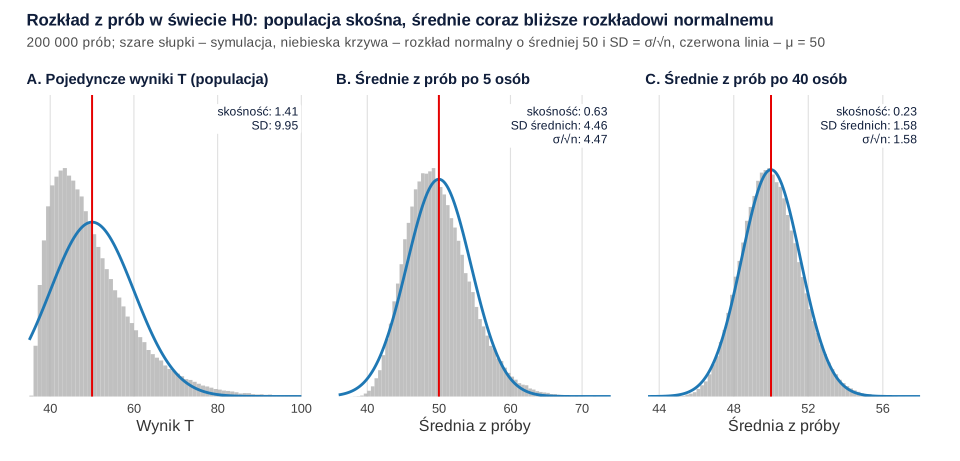
Z rysunku można odczytać trzy rzeczy, które składają się na centralne twierdzenie graniczne:
- Średnie skupiają się wokół średniej populacji: średnia z 200 000 średnich wyniosła 50.00.
- Rozkład średnich jest węższy niż rozkład osób. Pojedyncze wyniki mają SD = 9.95, średnie z 5 osób – 4.46, a z 40 osób – 1.58, czyli prawie dokładnie σ/√n (10/√5 = 4.47 i 10/√40 = 1.58).
- Kształt zbliża się do normalnego. Skośność spada z 1.41 dla osób do 0.63 dla średnich z 5 osób i 0.23 dla średnich z 40 osób, a krzywa rozkładu normalnego coraz lepiej pasuje do słupków.
Formalnie: według centralnego twierdzenia granicznego średnie z prób losowych o liczebności n, pobranych z populacji o średniej μ i wariancji σ², mają w przybliżeniu rozkład normalny o średniej μ i wariancji σ²/n, a przybliżenie poprawia się wraz ze wzrostem n. Kwak i Kim (2017) wyjaśniają, że na tym twierdzeniu oparto wiele testów parametrycznych, i omawiają jego rolę w teście t Studenta. Intuicję twierdzenia i interaktywną symulację znajdziesz we wpisie czym jest centralne twierdzenie graniczne.
Dwie rzeczy łatwo przeoczyć. Po pierwsze, twierdzenie dotyczy średnich, a nie danych: pojedyncze wyniki zostają skośne. Powyżej 50 + 1.96 × 10 = 69.6 punktu leży 4.86% osób, a poniżej 30.4 – nikt, choć w rozkładzie normalnym byłoby po 2.5%. Po drugie, „prawie normalny” nie znaczy „idealnie normalny”: poza granicami 50 ± 1.96 × 1.58 wypadło 3.07% średnich z 40 osób u góry i 1.84% u dołu. Razem to 4.91%, prawie dokładnie 5%, ale ogony są nierówne – wrócimy do tego przy symulacji.
Krok 3: błąd standardowy – jak szeroki jest rozkład średnich
Odchylenie standardowe rozkładu z prób ma własną nazwę: błąd standardowy (SE, ang. standard error). Dla średniej, gdy znasz odchylenie standardowe w populacji (σ), wynosi:
W przykładzie σ = 10 (z norm testu) i n = 40, więc SE = 10 / √40 = 1.581. Pojedyncza osoba różni się od średniej populacji typowo o około 10 punktów T, ale średnia z 40 osób – tylko o około 1.6 punktu. Dlatego różnica 3.4 punktu, mało znacząca u jednej osoby, jest duża jak na średnią z 40 osób.
| Liczebność próby n | SE = 10 / √n | Co się zmienia |
|---|---|---|
| 10 | 3.16 | punkt odniesienia |
| 40 | 1.58 | 4 razy więcej osób – SE 2 razy mniejszy |
| 160 | 0.79 | 16 razy więcej osób – SE 4 razy mniejszy |
Nie myl błędu standardowego z odchyleniem standardowym. Altman i Bland (2005) wyjaśniają, że odchylenie standardowe opisuje zmienność obserwacji, a błąd standardowy służy do wnioskowania o niepewności oszacowania. SD nie maleje wraz z liczebnością próby, SE – tak. Wzory na SE innych statystyk i słupki błędów omawiamy w haśle o błędzie standardowym.
We wzorze występuje σ, czyli odchylenie standardowe w populacji. W przykładzie znamy je z norm testu; gdy trzeba je oszacować z próby, używa się rozkładu t (zob. „Gdy σ nie jest znane”).
Krok 4: statystyka Z, czyli standaryzacja średniej
Znasz już rozkład, w którym trzeba umieścić wynik: w świecie H0 średnie z prób po 40 osób mają w przybliżeniu rozkład normalny o średniej 50 i odchyleniu standardowym 1.58. Żeby nie rysować osobnej krzywej dla każdego badania, wynik się standaryzuje – tak jak pojedynczy wynik testu zamienia się na wynik z (zob. standaryzacja zmiennej). Wynik z mówi, o ile odchyleń standardowych wartość leży powyżej lub poniżej średniej, a rozkład wyników z ma średnią 0 i odchylenie standardowe 1; gdy wynik odnosisz do norm, używasz średniej i odchylenia standardowego populacji, a nie próby (Andrade, 2021).
Dla średniej z próby rolę odchylenia standardowego pełni błąd standardowy, więc:
W przykładzie z = (53.40 − 50) / 1.581 = 2.15. Średnia z Twojej próby leży 2.15 błędu standardowego powyżej średniej, której należałoby oczekiwać w świecie H0.
Porównaj to z pojedynczą osobą. Wynik T = 53.4 u jednej osoby to tylko z = (53.4 − 50) / 10 = 0.34 – nic niezwykłego. Jako średnia 40 osób ta sama liczba daje z = 2.15, bo średnie wahają się znacznie mniej niż pojedyncze wyniki. Pierwsza z tych liczb (0.34) to zresztą wielkość efektu d, do której wrócimy w przykładzie.
Według centralnego twierdzenia granicznego tak policzona statystyka ma w świecie H0 w przybliżeniu standardowy rozkład normalny N(0, 1). Niezależnie od skali testu, liczebności próby i wartości μ0 każde takie badanie sprowadzasz więc do jednej krzywej.
Krok 5: pole pod krzywą Z – to jest p value
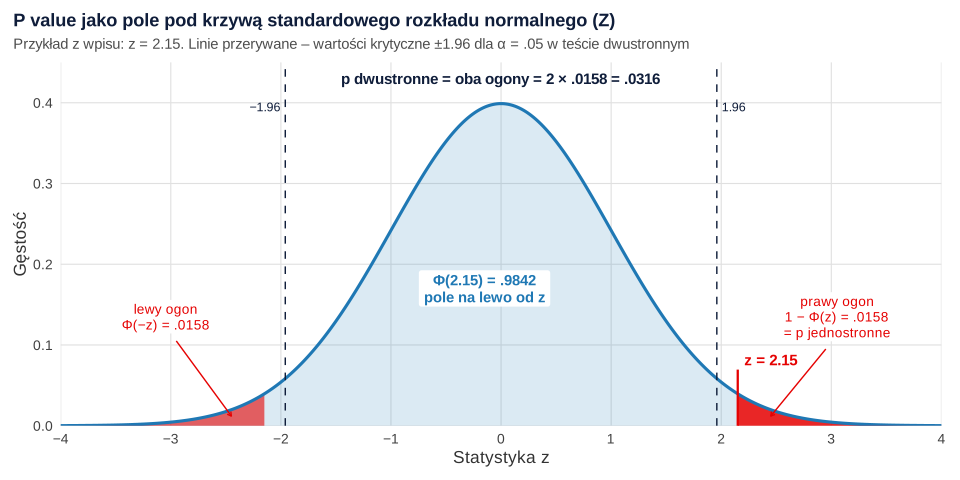
Pole pod krzywą standardowego rozkładu normalnego na lewo od wartości z to wartość dystrybuanty, oznaczana Φ(z). Całe pole pod krzywą równa się 1, więc pole na prawo od z wynosi 1 − Φ(z). P value to pole tej części rozkładu, która jest „co najmniej tak skrajna” jak Twój wynik:
Dla z = 2.15 pole na lewo wynosi Φ(2.15) = .9842, prawy ogon 1 − .9842 = .0158, a oba ogony razem 2 × .0158 = .0316. W zapisie APA to p = .032. R, który nie zaokrągla z po drodze, podaje .0315 – po zaokrągleniu do trzech miejsc to ta sama wartość (rysunek 2).
Jeden ogon czy dwa?
Który ogon liczyć, wynika z hipotezy alternatywnej, a nie z danych. Przy hipotezie niekierunkowej „lęk studentów różni się od normy” (μ ≠ 50) skrajne są średnie zarówno dużo wyższe, jak i dużo niższe od 50, więc sumujesz oba ogony. Hipoteza kierunkowa „lęk jest wyższy niż w normie” (μ > 50) prowadzi do jednego ogona: p = .016. Bland i Altman (1994) krytycznie oceniają uzasadnianie testu jednostronnego tym, że wynik w przeciwnym kierunku „nas nie interesuje”. Kierunek ustal więc przed zebraniem danych, a gdy nie masz mocnych powodów, licz test dwustronny (zob. test jednostronny i dwustronny).
Wartość krytyczna a p value
Tę samą decyzję podejmiesz bez liczenia pola. Przy poziomie istotności α = .05 i teście dwustronnym w każdym ogonie zostaje .025 pola, a granica tego obszaru to wartość krytyczna 1.96. Twoje |z| = 2.15 jest większe niż 1.96, więc wynik leży w obszarze odrzucenia H0 – to ta sama informacja co p = .032 < .05. Wartość p mówi jednak więcej: także, jak daleko za granicą leży wynik.
Skąd 1.96? Z reguły 68–95–99.7: w rozkładzie normalnym około 95% wartości leży nie dalej niż 2 odchylenia standardowe od średniej, a dokładnie 95% – nie dalej niż 1.96. W świecie H0 „odchyleniem standardowym” średnich jest SE, więc środkowe 95% średnich z prób po 40 osób leży między 50 − 1.96 × 1.58 = 46.90 a 53.10. Twoja średnia 53.40 wychodzi poza ten przedział.
Tabela zbiera wartości z, które spotkasz najczęściej (obliczenia w R):
| z | Φ(z) | p jednostronne | p dwustronne | Wartość krytyczna dla |
|---|---|---|---|---|
| 1.645 | .9500 | .0500 | .1000 | testu jednostronnego, α = .05 |
| 1.96 | .9750 | .0250 | .0500 | testu dwustronnego, α = .05 (95% CI) |
| 2.15 | .9842 | .0158 | .0316 | – (przykład z tego wpisu) |
| 2.33 | .9901 | .0099 | .0198 | ≈ testu jednostronnego, α = .01 |
| 2.58 | .9951 | .0049 | .0099 | ≈ testu dwustronnego, α = .01 (99% CI) |
| 3.29 | .9995 | .0005 | .0010 | testu dwustronnego, α = .001 |
Jak czytać tablice rozkładu normalnego
Pola pod krzywą odczytuje się też z tablic, które wciąż są w podręcznikach i na kolokwiach. Andrade (2021) przypomina, że z tablicy pola pod krzywą normalną odczytasz prawdopodobieństwo dla dowolnej wartości z. Najczęstsza tablica podaje Φ(z), czyli pole na lewo od z:
- Wiersz – z z dokładnością do jednego miejsca po przecinku (dla 2.15: wiersz 2.1).
- Kolumna – druga cyfra po przecinku (dla 2.15: kolumna .05).
- Komórka – Φ(z); dla 2.15 to .9842.
- Ogon – 1 − .9842 = .0158, czyli p jednostronne; dwa ogony – 2 × .0158 = .0316.
| z | .00 | .01 | .02 | .03 | .04 | .05 | .06 | .07 | .08 | .09 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1.9 | .9713 | .9719 | .9726 | .9732 | .9738 | .9744 | .9750 | .9756 | .9761 | .9767 |
| 2.0 | .9772 | .9778 | .9783 | .9788 | .9793 | .9798 | .9803 | .9808 | .9812 | .9817 |
| 2.1 | .9821 | .9826 | .9830 | .9834 | .9838 | .9842 | .9846 | .9850 | .9854 | .9857 |
| 2.2 | .9861 | .9864 | .9868 | .9871 | .9875 | .9878 | .9881 | .9884 | .9887 | .9890 |
Zanim skorzystasz z cudzej tablicy, sprawdź, co podaje. Spotkasz trzy rodzaje: pole na lewo od z (Φ), pole między 0 a z (Φ − .5) i sam prawy ogon (1 − Φ). Najprościej rozpoznać je po wierszu z = 1.00: wartość .8413 oznacza Φ, .3413 – pole od 0 do z, a .1587 – ogon. Tablice zwykle zawierają tylko dodatnie z, bo krzywa jest symetryczna: dla z = −2.15 lewy ogon ma tyle samo co prawy dla 2.15, czyli .0158.
Pełną tablicę możesz pobrać: tablica-rozkladu-normalnego.xlsx (34 KB). Plik ma trzy arkusze: Tablica – klasyczny układ Φ(z) dla z od 0.00 do 3.99; Lista – 400 wartości z z kolumnami Φ(z), prawy ogon i p dwustronne; Instrukcja – jak czytać tablicę, z formułami Excela i R. Wartości policzyliśmy w R funkcją pnorm.
P value krok po kroku: pełny przykład
Zbierzmy wszystkie kroki w jedną procedurę, którą powtórzysz na własnych danych (w przykładzie: 40 wyników T, normy μ = 50 i σ = 10).
- Hipotezy i α – przed zebraniem danych. H0: μ = 50; H1: μ ≠ 50 (test dwustronny); α = .05.
- Statystyki z próby. n = 40, M = 53.40, SD = 10.00, mediana = 51.5. Mediana niższa od średniej zdradza prawostronną skośność – dla średniej z 40 osób to, jak pokazał rysunek 1, niewielki problem.
- Błąd standardowy. SE = σ / √n = 10 / √40 = 1.581. Bierzesz σ z norm, a nie SD z próby.
- Statystyka Z. z = (53.40 − 50) / 1.581 = 2.15.
- Pole pod krzywą. Φ(2.15) = .9842, więc p = 2 × (1 − .9842) = .032 (test dwustronny).
- Decyzja. p = .032 < α = .05, a |z| = 2.15 > 1.96: odrzucasz H0 na rzecz wniosku, że średni lęk studentów przed egzaminem jest wyższy niż w normach.
- Wielkość efektu i przedział ufności. d = (53.40 − 50) / 10 = 0.34 – średnia jest wyższa o około jedną trzecią odchylenia standardowego (zob. d Cohena – interpretacja). 95% przedział ufności dla średniej to 53.40 ± 1.96 × 1.581, czyli [50.30, 56.50], a dla d – [0.03, 0.65]. Przedział jest szeroki: dane są zgodne zarówno z lękiem wyższym o 0.3 punktu T (praktycznie bez różnicy), jak i o 6.5 punktu (ponad pół odchylenia standardowego).
- Opis w pracy. Podaj statystykę, p, wielkość efektu i przedział ufności:
To samo w R i w Excelu
W R wystarczą dwie funkcje: pnorm() zwraca pole na lewo od z, a qnorm() – wartość z dla zadanego pola. W Excelu odpowiadają im funkcje ROZKŁ.NORMALNY.S i ROZKŁ.NORMALNY.S.ODWR (Microsoft, b.d.). Formuły podajemy w polskiej wersji Excela, ze średnikiem między argumentami i przecinkiem dziesiętnym; w nawiasach – nazwy angielskie.
| Co liczysz | R | Excel (wersja polska) |
|---|---|---|
| Błąd standardowy (w Excelu komórka B2) | SE <- 10 / sqrt(40) | =10/PIERWIASTEK(40) (SQRT) |
| Statystyka z (komórka B3) | z <- (53.4 - 50) / SE | =(53,4-50)/B2 |
| Φ(z) – pole na lewo od z | pnorm(z) | =ROZKŁ.NORMALNY.S(B3;PRAWDA) (NORM.S.DIST) |
| p jednostronne (prawy ogon) | pnorm(z, lower.tail = FALSE) | =1-ROZKŁ.NORMALNY.S(B3;PRAWDA) |
| p dwustronne | 2 * pnorm(-abs(z)) | =2*(1-ROZKŁ.NORMALNY.S(MODUŁ.LICZBY(B3);PRAWDA)) (ABS) |
| Wartość krytyczna dla α = .05 (test dwustronny) | qnorm(.975) | =ROZKŁ.NORMALNY.S.ODWR(0,975) (NORM.S.INV) |
Excel ma też funkcję Z.TEST, ale według pomocy Microsoft zwraca ona jednostronne prawdopodobieństwo testu z (Microsoft, b.d.). Gdy średnia jest wyższa od μ0, wynik tej funkcji to prawy ogon, czyli połowa p dwustronnego – przepisany bez zmian da w pracy dwa razy za małe p. Co Excel liczy dobrze, a gdzie trzeba uważać, opisujemy w poradniku analiza statystyczna w Excelu.
Sprawdzenie symulacją: p value jako odsetek prób w świecie H0
Czy pole pod krzywą Z naprawdę opisuje to, co obiecuje definicja – odsetek powtórzeń badania, które w świecie H0 dałyby wynik co najmniej tak skrajny? Sprawdźmy to wprost. Murdoch i in. (2008) proponują uczyć wartości p właśnie przez symulację, bo pokazuje ona, że wartość p jest zmienną losową, a nie stałą cechą badanego zjawiska.
Wracamy do świata H0 z rysunku 1: 200 000 prób po 40 osób ze skośnej populacji o średniej 50 i odchyleniu standardowym 10. Liczymy, w ilu próbach średnia odbiegła od 50 o co najmniej 3.4 punktu – tyle co w Twoim badaniu – w którąkolwiek stronę (rysunek 3).
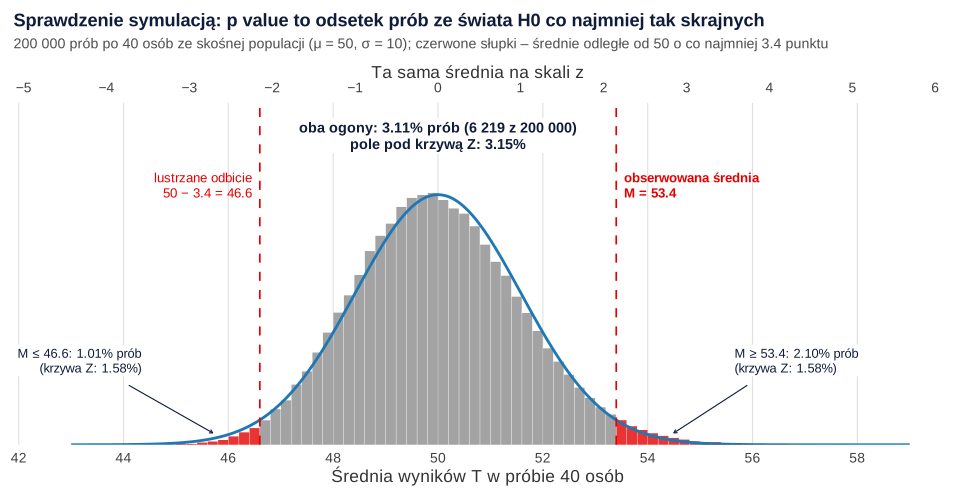
Co najmniej tak skrajną średnią dało 6 219 z 200 000 prób, czyli 3.11%. Dwustronne p z krzywej Z (.0315) i odsetek skrajnych prób w symulacji (.0311) praktycznie się pokrywają – różnica (.0004) jest mniejsza niż dwa błędy standardowe samej symulacji (.0008). To sedno całego wpisu: p value z rozkładu normalnego przybliża odsetek „co najmniej tak skrajnych” prób w świecie H0, a przybliżenie jest dobre dzięki centralnemu twierdzeniu granicznemu, choć same wyniki lęku są wyraźnie skośne.
Każdy ogon osobno zgadza się jednak gorzej. Populacja jest prawostronnie skośna, więc rozkład średnich z 40 osób ma nieco dłuższy prawy ogon: średnich co najmniej tak wysokich jak 53.4 było 2.10%, a nie 1.58%, a symetrycznie niskich – tylko 1.01%. W sumie błędy się znoszą i p dwustronne jest trafne, ale jednostronne p z rozkładu normalnego bywa przy skośnych danych zaniżone – tutaj .016 zamiast około .021. To kolejny argument, by test jednostronny stosować tylko z dobrym uzasadnieniem.
Gdy σ nie jest znane: rozkład t
W większości badań σ nie znasz – na przykład gdy używasz własnej ankiety albo gdy normy nie pasują do Twojej grupy. Wtedy σ zastępujesz odchyleniem standardowym z próby, SE = SD / √n, a statystykę porównujesz nie z rozkładem normalnym, tylko z rozkładem t o n − 1 stopniach swobody. To test t dla jednej próby.
Policzmy go na tych samych danych. Odchylenie standardowe w próbie wyniosło 10.00 – przypadkiem tyle co σ w normach – więc statystyka jest taka sama: t(39) = 2.15. Mimo to p jest inne: .038 zamiast .032. Ta sama liczba 2.15 trafia na inną krzywą: rozkład t ma grubsze ogony niż rozkład normalny, bo uwzględnia niepewność oszacowania SD. Z tego samego powodu przedział ufności dla średniej jest nieco szerszy: [50.20, 56.60] zamiast [50.30, 56.50].
| Rozkład odniesienia | p dwustronne dla statystyki 2.15 | Wartość krytyczna (α = .05, test dwustronny) |
|---|---|---|
| t(9), czyli n = 10 | .060 | 2.262 |
| t(19), czyli n = 20 | .045 | 2.093 |
| t(39), czyli n = 40 | .038 | 2.023 |
| t(99), czyli n = 100 | .034 | 1.984 |
| Z (σ znane) | .032 | 1.960 |
Przy 10 osobach ta sama wartość statystyki dałaby wynik nieistotny (p = .060), a przy 100 osobach różnica między rozkładem t a Z jest już niewielka. Programy statystyczne liczą więc dla jednej średniej test t, bo zakładają, że σ szacujesz z próby. Test z ma sens, gdy σ naprawdę pochodzi spoza Twoich danych – z norm testu albo z dużych badań populacyjnych.
Centralne twierdzenie graniczne pracuje także tutaj. Rozkład t wyprowadzono dla danych normalnych, ale Lumley i in. (2002) pokazali w symulacjach na skrajnie nienormalnych danych, że w dużych próbach test t i regresja liniowa dają trafne wyniki niezależnie od rozkładu. Jak czytać „istotność dwustronną” w wydruku testu t, pokazujemy we wpisie jak czytać wyniki z SPSS.
Jak liczebność próby zmienia p value
Ze wzoru z = (M − μ0) / (σ / √n) widać, że ta sama różnica średnich daje tym większe z – i tym mniejsze p – im większa jest próba. Tabela pokazuje różnicę z przykładu (3.4 punktu T, d = 0.34) przy sześciu liczebnościach:
| n | SE | z | p (dwustronne) | 95% CI dla średniej | d |
|---|---|---|---|---|---|
| 10 | 3.16 | 1.08 | .282 | [47.20, 59.60] | 0.34 |
| 20 | 2.24 | 1.52 | .128 | [49.02, 57.78] | 0.34 |
| 40 | 1.58 | 2.15 | .032 | [50.30, 56.50] | 0.34 |
| 80 | 1.12 | 3.04 | .002 | [51.21, 55.59] | 0.34 |
| 160 | 0.79 | 4.30 | < .001 | [51.85, 54.95] | 0.34 |
| 320 | 0.56 | 6.08 | < .001 | [52.30, 54.50] | 0.34 |
Wielkość efektu się nie zmienia – zmienia się tylko precyzja. Ta sama różnica bywa „nieistotna” w małej próbie i „wysoce istotna” w dużej, więc sama wartość p nie mówi, jak duży jest efekt. Dlatego obok p zawsze podawaj wielkość efektu i przedział ufności; szerzej piszemy o tym we wpisie wielkość efektu: jak ocenić znaczenie wyniku poza wartością p.
Wiersz dla 10 osób to częsta sytuacja w pracach dyplomowych: różnica jest ta sama, ale danych za mało, by odróżnić ją od przypadku. Nieistotny wynik nie dowodzi wtedy braku efektu – jak go uczciwie opisać, pokazujemy w poradniku hipoteza się nie potwierdziła, a ile osób potrzeba do wykrycia efektu tej wielkości, mówi analiza mocy testu.
Wartość p zmienia się też między powtórzeniami tego samego badania. Cumming (2008) w symulacji 25 powtórzeń typowego eksperymentu otrzymał wartości p od poniżej .001 do .76 i pokazał, że wartość p słabo przewiduje wynik replikacji, a przedziały ufności – znacznie lepiej.
Czego p value nie mówi
Wiedząc, jak powstaje wartość p, łatwiej zrozumieć, czego z niej nie wyczytasz:
- Nie jest prawdopodobieństwem, że H0 jest prawdziwa. Całe obliczenie odbywa się w świecie, w którym H0 jest prawdziwa, więc nie powie, jak prawdopodobny jest ten świat. Goodman (2008) za najpoważniejszy skutek błędnych interpretacji uznaje przekonanie, że z danych jednego badania można obliczyć prawdopodobieństwo błędnego wniosku bez odwołania do innych dowodów i wiarygodności mechanizmu (zob. też czynnik Bayesa).
- Nie mierzy wielkości efektu. Ta sama d = 0.34 dała w tabeli wyżej p od .282 do poniżej .001; oświadczenie ASA podkreśla, że wartość p nie mierzy wielkości efektu ani wagi wyniku (Wasserstein i Lazar, 2016).
- Nie sprawdza założeń. Wartość p liczy się przy założeniu całego modelu: losowej próby, niezależnych obserwacji, znanego σ, a także tego, że analizy nie wybrano po obejrzeniu wyników. Greenland i in. (2016) zwracają uwagę, że naruszenie takich ukrytych założeń może dać małą wartość p nawet przy prawdziwej hipotezie zerowej (zob. p-hacking).
- Nie gwarantuje, że wynik się powtórzy. Gdy H0 jest prawdziwa, przy α = .05 około 5% badań da fałszywy alarm (błąd I rodzaju); gdy efekt istnieje, szansa na istotny wynik w replikacji zależy od mocy.
- Wynik nieistotny nie dowodzi braku efektu. Amrhein i in. (2019) apelują, by nie wnioskować o braku różnicy tylko dlatego, że p > .05, i by omawiać praktyczne konsekwencje wszystkich wartości z przedziału ufności.
Szczegółowo o interpretacji piszemy w poradniku wartość p: co naprawdę oznacza i jak ją poprawnie interpretować, a definicję i zasady ASA zebraliśmy w haśle wartość p.
Jak zapisać p value w pracy
Przewodnik APA Style po zapisie liczb i statystyk (American Psychological Association, 2024) zaleca:
- podawać dokładną wartość p z dwoma albo trzema miejscami po przecinku – na metodolog.pl używamy trzech: p = .032, p = .016;
- wartości mniejsze niż .001 zapisywać jako p < .001;
- pomijać zero przed kropką, bo p nie może przekroczyć 1;
- zapisywać symbol p kursywą.
Nigdy nie pisz „p = .000”. Wartość p nie bywa równa zeru: nawet dla z = 3.99 prawy ogon wynosi około .00003, a program po prostu zaokrągla wynik do trzech miejsc. Taki wynik zapisz jako p < .001. Obok p podaj statystykę (z albo t ze stopniami swobody), wielkość efektu i przedział ufności, a przy teście z – także źródło wartości σ. Test jednostronny oznacz wprost.
Wzór do uzupełnienia (przy znanym σ wpisz statystykę z, przy σ szacowanym z próby – t ze stopniami swobody):
Gotowe zdania dla innych testów znajdziesz w części „Zasady zapisu wyników w stylu APA” poradnika o opisie wyników, a typowe uwagi promotorów do zapisu p – w części „Zapis statystyk” poradnika o poprawkach w rozdziale wyników.
Najczęstsze błędy przy liczeniu p value
- SD zamiast SE w mianowniku. (53.4 − 50) / 10 = 0.34 to z dla jednej osoby, a nie dla średniej. Wartość p policzona z takiego z wyniosłaby .734 zamiast .032.
- Odczytanie Φ(z) jako wartości p. Z tablicy dla 2.15 odczytujesz .9842 – to pole na lewo od z, a nie wartość p. Wartością p jest ogon: .0158, a w teście dwustronnym .0316.
- Wybór ogona po obejrzeniu wyniku. Połowienie p, „bo wyszło .06”, to ukryte podwojenie α: jeśli zawsze wybierasz ogon zgodny z danymi, fałszywych alarmów jest 10%, a nie 5%. Kierunek testu ustalasz przed zebraniem danych.
- Test z z odchyleniem standardowym z próby. Gdy σ szacujesz z danych, użyj rozkładu t: przy 10 osobach statystyka 2.15 daje p = .032 z rozkładu normalnego, a poprawnie p = .060 z rozkładu t(9). Tak liczy też Z.TEST w Excelu bez argumentu sigma – z SD próby, ale z rozkładem normalnym.
- „Centralne twierdzenie graniczne działa od 30 osób”. Twierdzenie nie podaje progu – tempo zbliżania się do rozkładu normalnego zależy od skośności i ogonów. W naszej symulacji przy 40 osobach ogony rozkładu średnich wciąż były nierówne (2.10% i 1.01% zamiast po 1.58%).
- „p = .000”. Wartość p nigdy nie jest równa zeru – zapisz p < .001.
- Zaokrąglanie w trakcie obliczeń. Zaokrąglaj dopiero wynik końcowy. Tu zaokrąglenie z do 2.15 zmienia p z .0315 na .0316 – nieszkodliwie, ale kilka zaokrągleń po drodze potrafi się zsumować.
Jeśli chcesz, żeby ktoś sprawdził Twoje obliczenia i wyjaśnił, skąd biorą się liczby w wydruku, zobacz analizy statystyczne dla studentów. Wyniki musisz rozumieć i umieć obronić samodzielnie, a z pomocy możesz korzystać tylko zgodnie z zasadami uczelni.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 3 korzysta z obiektów z przepisów 1 i 2, a przepis 4 – z danych z przepisu 2. Wystarczy podstawowy R (funkcje pnorm(), qnorm(), pt() i t.test()); symulacja w przepisie 1 trwa około sekundy.
1. Rozkład z prób w świecie H0 (centralne twierdzenie graniczne)
R
# Świat H0: wyniki T w kwestionariuszu lęku mają w populacji średnią 50 i SD 10 (normy testu),
# ale rozkład jest prawostronnie skośny (wyniki T liniowe zachowują skośność wyników surowych).
# Losujemy 200 000 prób po 5 i po 40 osób i sprawdzamy, jak wyglądają rozkłady ich średnich.
populacja_T <- function(n, mu = 50, sigma = 10, k = 2) {
  mu + sigma * (rgamma(n, shape = k) - k) / sqrt(k)   # przesunięty rozkład gamma: średnia mu, SD sigma, skośność 2/√k ≈ 1.41
}
skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
B <- 200000
set.seed(2026)
osoby      <- populacja_T(B)                                     # 200 000 pojedynczych wyników T
srednie_5  <- rowMeans(matrix(populacja_T(B * 5),  ncol = 5))    # 200 000 średnich z prób po 5 osób
srednie_40 <- rowMeans(matrix(populacja_T(B * 40), ncol = 40))   # 200 000 średnich z prób po 40 osób

# Dla każdego rozkładu: średnia, SD, σ/√n, skośność oraz odsetki wyników poza granicami 50 ± 1.96·σ/√n
# (w rozkładzie normalnym byłoby po 2.5% z każdej strony)
opis <- function(x, n) {
  g <- qnorm(.975) * 10 / sqrt(n)
  c(n = n, M = mean(x), SD = sd(x), sigma_pierw_n = 10 / sqrt(n), skosnosc = skosnosc(x),
    proc_ponizej = 100 * mean(x < 50 - g), proc_powyzej = 100 * mean(x > 50 + g))
}
round(rbind(osoby = opis(osoby, 1), srednie_n5 = opis(srednie_5, 5), srednie_n40 = opis(srednie_40, 40)), 2)

# Błąd standardowy średniej (σ/√n) dla kilku liczebności próby
n_proby <- c(10, 40, 160)
setNames(round(10 / sqrt(n_proby), 3), paste0("n = ", n_proby))
Wynik w R
             n     M   SD sigma_pierw_n skosnosc proc_ponizej proc_powyzej
osoby        1 49.98 9.95         10.00     1.41         0.00         4.86
srednie_n5   5 50.00 4.46          4.47     0.63         0.57         3.86
srednie_n40 40 50.00 1.58          1.58     0.23         1.84         3.07
 n = 10  n = 40 n = 160
  3.162   1.581   0.791
2. Przykład: p value z rozkładu Z krok po kroku
R
# Przykład: lęk tuż przed egzaminem u 40 studentów (wyniki T, dane symulowane)
# a norma populacyjna testu: μ0 = 50, σ = 10 (σ znane z norm, więc liczymy statystykę Z).
set.seed(2569)
lek <- round(53.5 + 10 * (rgamma(40, shape = 2) - 2) / sqrt(2))   # wyniki T 40 osób
n <- length(lek); M <- mean(lek)
mu0   <- 50                                  # średnia w normach (wartość z H0)
sigma <- 10                                  # SD w normach (znane σ)
c(n = n, M = M, SD_proby = round(sd(lek), 2), mediana = median(lek))

SE <- sigma / sqrt(n)                        # błąd standardowy średniej
z  <- (M - mu0) / SE                         # statystyka Z (standaryzacja średniej)
round(c(SE = SE, z = z), 4)

# Pole pod krzywą standardowego rozkładu normalnego
round(c(Phi_z          = pnorm(z),                              # pole na lewo od z
        prawy_ogon     = pnorm(z, lower.tail = FALSE),          # = 1 − Φ(z): p jednostronne (H1: μ > 50)
        p_dwustronne   = 2 * pnorm(abs(z), lower.tail = FALSE), # oba ogony: p dwustronne (H1: μ ≠ 50)
        z_krytyczne    = qnorm(.975)), 4)                       # granica obszaru odrzucenia przy α = .05

# Gdzie leży środkowe 95% średnich w świecie H0? (50 ± 1.96 · SE)
round(mu0 + c(-1, 1) * qnorm(.975) * SE, 2)

# Wielkość efektu i 95% przedział ufności dla średniej (oraz dla d)
d  <- (M - mu0) / sigma
CI <- M + c(-1, 1) * qnorm(.975) * SE
round(c(d = d, CI_dolna = CI[1], CI_gorna = CI[2], d_dolna = (CI[1] - mu0) / sigma, d_gorna = (CI[2] - mu0) / sigma), 2)

# Tabela: wartości z i odpowiadające im pola (p jednostronne i dwustronne)
z_tab <- c(1.645, 1.96, 2.15, 2.33, 2.58, 3.29)
data.frame(z = z_tab, Phi_z = round(pnorm(z_tab), 4),
           p_jednostronne = round(pnorm(z_tab, lower.tail = FALSE), 4),
           p_dwustronne   = round(2 * pnorm(z_tab, lower.tail = FALSE), 4))

# Fragment klasycznej tablicy Φ(z): wiersz = z do jednego miejsca, kolumna = druga cyfra po kropce
wiersze <- c(1.9, 2.0, 2.1, 2.2); kolumny <- seq(0, 0.09, by = 0.01)
tablica <- outer(wiersze, kolumny, function(a, b) round(pnorm(a + b), 4))
dimnames(tablica) <- list(sprintf("%.1f", wiersze), sprintf(".%02d", 0:9))
tablica

# Częste błędy
z_blad <- (M - mu0) / sigma                  # SD zamiast SE w mianowniku: to z dla jednej osoby, nie dla średniej
round(c(z_blad = z_blad, p_dwustronne_blad = 2 * pnorm(abs(z_blad), lower.tail = FALSE)), 3)
2 * pnorm(qnorm(.95), lower.tail = FALSE)    # ogon wybierany po obejrzeniu danych: odsetek fałszywych alarmów przy prawdziwej H0
signif(pnorm(3.99, lower.tail = FALSE), 2)   # p nigdy nie jest zerem: prawy ogon nawet dla z = 3.99
Wynik w R
       n        M SD_proby  mediana
    40.0     53.4     10.0     51.5
    SE      z
1.5811 2.1503
       Phi_z   prawy_ogon p_dwustronne  z_krytyczne
      0.9842       0.0158       0.0315       1.9600
[1] 46.9 53.1
       d CI_dolna CI_gorna  d_dolna  d_gorna
    0.34    50.30    56.50     0.03     0.65
      z  Phi_z p_jednostronne p_dwustronne
1 1.645 0.9500         0.0500       0.1000
2 1.960 0.9750         0.0250       0.0500
3 2.150 0.9842         0.0158       0.0316
4 2.330 0.9901         0.0099       0.0198
5 2.580 0.9951         0.0049       0.0099
6 3.290 0.9995         0.0005       0.0010
       .00    .01    .02    .03    .04    .05    .06    .07    .08    .09
1.9 0.9713 0.9719 0.9726 0.9732 0.9738 0.9744 0.9750 0.9756 0.9761 0.9767
2.0 0.9772 0.9778 0.9783 0.9788 0.9793 0.9798 0.9803 0.9808 0.9812 0.9817
2.1 0.9821 0.9826 0.9830 0.9834 0.9838 0.9842 0.9846 0.9850 0.9854 0.9857
2.2 0.9861 0.9864 0.9868 0.9871 0.9875 0.9878 0.9881 0.9884 0.9887 0.9890
           z_blad p_dwustronne_blad
            0.340             0.734
[1] 0.1
[1] 3.3e-05
3. Sprawdzenie symulacją: odsetek prób co najmniej tak skrajnych
R
# Sprawdzenie symulacją: p value jako odsetek prób w świecie H0, które dają średnią co najmniej tak odległą
# od 50 jak średnia obserwowana. Korzysta z obiektu srednie_40 (przepis 1) oraz M i z (przepis 2).
roznica <- M - 50                                        # obserwowana różnica: 3.4 punktu T
B <- length(srednie_40)                                  # 200 000 prób po 40 osób ze skośnej populacji H0
symulacja <- c(prawy_ogon = mean(srednie_40 - 50 >= roznica),
               lewy_ogon  = mean(srednie_40 - 50 <= -roznica),
               oba_ogony  = mean(abs(srednie_40 - 50) >= roznica))
krzywa_Z  <- c(prawy_ogon = pnorm(z, lower.tail = FALSE),
               lewy_ogon  = pnorm(-z),
               oba_ogony  = 2 * pnorm(abs(z), lower.tail = FALSE))
blad_mc   <- sqrt(symulacja * (1 - symulacja) / B)      # błąd standardowy odsetka z symulacji (Monte Carlo)
round(cbind(symulacja, krzywa_Z, blad_mc), 4)
# Czy różnica dla obu ogonów mieści się w błędzie losowym symulacji?
round(c(roznica = unname(krzywa_Z["oba_ogony"] - symulacja["oba_ogony"]), dwa_bledy_mc = unname(2 * blad_mc["oba_ogony"])), 4)

# Ile prób z 200 000 było co najmniej tak skrajnych?
c(prawy_ogon = sum(srednie_40 - 50 >= roznica), oba_ogony = sum(abs(srednie_40 - 50) >= roznica), wszystkie = B)
Wynik w R
           symulacja krzywa_Z blad_mc
prawy_ogon    0.0210   0.0158   3e-04
lewy_ogon     0.0101   0.0158   2e-04
oba_ogony     0.0311   0.0315   4e-04
     roznica dwa_bledy_mc
       4e-04        8e-04
prawy_ogon  oba_ogony  wszystkie
      4198       6219     200000
4. Gdy σ nie jest znane: test t dla jednej próby
R
# Gdy σ nie jest znane: test t dla jednej próby na tych samych danych (obiekt lek z przepisu 2).
# SD szacujemy z próby, a statystykę porównujemy z rozkładem t o n − 1 stopniach swobody.
wynik_t <- t.test(lek, mu = 50)
wynik_t
round(c(SD = sd(lek), SE_z_proby = sd(lek) / sqrt(length(lek)), t = unname(wynik_t$statistic),
        d = (mean(lek) - 50) / sd(lek)), 3)

# Ta sama wartość statystyki (2.15) i różne rozkłady odniesienia: t z df stopniami swobody albo Z (df = Inf)
df <- c(9, 19, 39, 99, Inf)
data.frame(df = df, p_dwustronne = round(2 * pt(-2.15, df), 4), t_krytyczne = round(qt(.975, df), 3))
Wynik w R
	One Sample t-test

data:  lek
t = 2.1499, df = 39, p-value = 0.03782
alternative hypothesis: true mean is not equal to 50
95 percent confidence interval:
 50.20119 56.59881
sample estimates:
mean of x
     53.4

        SD SE_z_proby          t          d
    10.002      1.581      2.150      0.340
   df p_dwustronne t_krytyczne
1   9       0.0600       2.262
2  19       0.0446       2.093
3  39       0.0378       2.023
4  99       0.0340       1.984
5 Inf       0.0316       1.960
5. Ta sama różnica przy różnej liczebności próby
R
# Ta sama różnica (M − 50 = 3.4 punktu T, d = 0.34) przy różnej liczebności próby; σ = 10 jak w normach.
roznica <- 3.4
n_proby <- c(10, 20, 40, 80, 160, 320)
SE <- 10 / sqrt(n_proby)
z  <- roznica / SE
data.frame(n = n_proby, SE = round(SE, 2), z = round(z, 2),
           p_dwustronne = signif(2 * pnorm(z, lower.tail = FALSE), 3),
           CI_dolna = round(50 + roznica - qnorm(.975) * SE, 2),
           CI_gorna = round(50 + roznica + qnorm(.975) * SE, 2),
           d = roznica / 10)
Wynik w R
    n   SE    z p_dwustronne CI_dolna CI_gorna    d
1  10 3.16 1.08     2.82e-01    47.20    59.60 0.34
2  20 2.24 1.52     1.28e-01    49.02    57.78 0.34
3  40 1.58 2.15     3.15e-02    50.30    56.50 0.34
4  80 1.12 3.04     2.36e-03    51.21    55.59 0.34
5 160 0.79 4.30     1.70e-05    51.85    54.95 0.34
6 320 0.56 6.08     1.19e-09    52.30    54.50 0.34
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork, a plik z tablicą rozkładu normalnego zapisano pakietem openxlsx i sprawdzono ponownym odczytem w pakiecie readxl. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files [R package]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
Najczęstsze pytania
Jak obliczyć p value z wartości z?
Policz pole pod krzywą standardowego rozkładu normalnego za wartością z. W teście jednostronnym to 1 − Φ(z), a w dwustronnym 2 × [1 − Φ(|z|)]. Dla z = 2.15 pole na lewo wynosi Φ = .9842, więc jednostronne p = .016, a dwustronne p = .032. W R: 2 * pnorm(-abs(z)).
Jak odczytać p value z tablic rozkładu normalnego?
Najczęstsza tablica podaje Φ(z), czyli pole na lewo od z. Znajdź wiersz z pierwszą cyfrą po przecinku i kolumnę z drugą: dla z = 2.15 wiersz 2.1 i kolumna .05 dają .9842. Jednostronne p to 1 − .9842 = .0158, a dwustronne – dwa razy więcej, .0316. Sprawdź nagłówek tablicy: niektóre podają pole między 0 a z albo sam ogon.
Dlaczego program podaje test t, a nie test z?
Test z wymaga znanego odchylenia standardowego w populacji (σ), a w badaniach zwykle szacujesz je z próby. Rozkład t uwzględnia niepewność tego oszacowania: ma grubsze ogony, więc przy tej samej wartości statystyki daje większe p. W przykładzie statystyka 2.15 daje p = .032 z rozkładu normalnego i p = .038 z rozkładu t(39); przy dużych próbach różnica znika.
Czy p value zależy od liczebności próby?
Tak. Przy tej samej różnicy średnich błąd standardowy maleje jak 1/√n, więc z rośnie, a p maleje. W przykładzie różnica 3.4 punktu T (d = 0.34) daje p = .282 przy 10 osobach, p = .032 przy 40 i p < .001 przy 160, choć wielkość efektu się nie zmienia. Dlatego obok p podawaj wielkość efektu z przedziałem ufności.
Po co centralne twierdzenie graniczne przy liczeniu p value?
Wartość p dla średniej odczytujesz z rozkładu normalnego, bo według centralnego twierdzenia granicznego rozkład średnich z prób zbliża się do normalnego także wtedy, gdy same wyniki są skośne. W naszej symulacji ze skośnej populacji 3.11% prób po 40 osób dało średnią co najmniej tak skrajną jak w przykładzie, a pole pod krzywą Z wynosiło 3.15%. Przy małych próbach i silnej skośności przybliżenie jest gorsze, zwłaszcza dla p jednostronnego.
Jak policzyć p value w Excelu?
Gdy masz już z (np. w komórce B3), dwustronne p policzysz formułą =2*(1-ROZKŁ.NORMALNY.S(MODUŁ.LICZBY(B3);PRAWDA)), a jednostronne – =1-ROZKŁ.NORMALNY.S(B3;PRAWDA). Funkcja Z.TEST zwraca prawdopodobieństwo jednostronne, więc nie przepisuj jej wyniku jako p dwustronnego. Gdy σ szacujesz z próby, użyj rozkładu t: =ROZKŁ.T.DS(MODUŁ.LICZBY(t);df) zwraca od razu p dwustronne.
Powiązane hasła
Przeczytaj też
Wartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikCzym jest centralne twierdzenie graniczne?
Intuicja, warunki i interaktywna symulacja pokazująca, dlaczego rozkład średnich może zbliżać się do normalnego, choć surowe dane są skośne.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →Nie wiesz, skąd w Twoich wynikach taka wartość p?
Sprawdzimy, czy test i rozkład odniesienia pasują do Twoich danych, policzymy wielkość efektu z przedziałem ufności i wyjaśnimy wynik tak, żebyś umiał(a) go opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Andrade, C. (2021). Z scores, standard scores, and composite test scores explained. Indian Journal of Psychological Medicine, 43(6), 555–557. https://doi.org/10.1177/02537176211046525 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1994). Statistics notes: One and two sided tests of significance. BMJ, 309(6949), 248. https://doi.org/10.1136/bmj.309.6949.248 ● Otwarty dostęp
- Cumming, G. (2008). Replication and p intervals: p values predict the future only vaguely, but confidence intervals do much better. Perspectives on Psychological Science, 3(4), 286–300. https://doi.org/10.1111/j.1745-6924.2008.00079.x
- Goodman, S. (2008). A dirty dozen: Twelve p-value misconceptions. Seminars in Hematology, 45(3), 135–140. https://doi.org/10.1053/j.seminhematol.2008.04.003
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Kwak, S. G., & Kim, J. H. (2017). Central limit theorem: The cornerstone of modern statistics. Korean Journal of Anesthesiology, 70(2), 144–156. https://doi.org/10.4097/kjae.2017.70.2.144 ● Otwarty dostęp
- Lakens, D. (2021). The practical alternative to the p value is the correctly used p value. Perspectives on Psychological Science, 16(3), 639–648. https://doi.org/10.1177/1745691620958012 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Microsoft. (b.d.). Funkcje statystyczne (informacje). Microsoft Support. Pobrano 19 października 2026 z https://support.microsoft.com/pl-pl/excel/statistical-functions-reference ● Otwarty dostęp
- Murdoch, D. J., Tsai, Y.-L., & Adcock, J. (2008). P-values are random variables. The American Statistician, 62(3), 242–245. https://doi.org/10.1198/000313008X332421
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{andrade2021z, author={Andrade, Chittaranjan}, title={{Z scores, standard scores, and composite test scores explained}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={6}, pages={555--557}, doi={10.1177/02537176211046525}}@article{bland1994statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: One and two sided tests of significance}}, journal={BMJ}, year={1994}, volume={309}, number={6949}, pages={248}, doi={10.1136/bmj.309.6949.248}}@article{cumming2008replication, author={Cumming, Geoff}, title={{Replication and p intervals: p values predict the future only vaguely, but confidence intervals do much better}}, journal={Perspectives on Psychological Science}, year={2008}, volume={3}, number={4}, pages={286--300}, doi={10.1111/j.1745-6924.2008.00079.x}}@article{goodman2008dirty, author={Goodman, Steven}, title={{A dirty dozen: Twelve p-value misconceptions}}, journal={Seminars in Hematology}, year={2008}, volume={45}, number={3}, pages={135--140}, doi={10.1053/j.seminhematol.2008.04.003}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{kwak2017central, author={Kwak, Sang Gyu and Kim, Jong Hae}, title={{Central limit theorem: The cornerstone of modern statistics}}, journal={Korean Journal of Anesthesiology}, year={2017}, volume={70}, number={2}, pages={144--156}, doi={10.4097/kjae.2017.70.2.144}}@article{lakens2021practical, author={Lakens, Daniël}, title={{The practical alternative to the p value is the correctly used p value}}, journal={Perspectives on Psychological Science}, year={2021}, volume={16}, number={3}, pages={639--648}, doi={10.1177/1745691620958012}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@misc{microsoftndfunkcjestatystyczne, author={{Microsoft}}, title={{Funkcje statystyczne (informacje)}}, howpublished={Microsoft Support}, publisher={Microsoft}, url={https://support.microsoft.com/pl-pl/excel/statistical-functions-reference}}@article{murdoch2008pvalues, author={Murdoch, Duncan J. and Tsai, Yu-Ling and Adcock, James}, title={{P-values are random variables}}, journal={The American Statistician}, year={2008}, volume={62}, number={3}, pages={242--245}, doi={10.1198/000313008x332421}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}