Co to jest skala tenowa?
Skala tenowa, czyli skala wyników T (ang. T score, T scale), to skala wyników standardowych o średniej 50 i odchyleniu standardowym 10. Wynik T = 60 leży o jedno odchylenie standardowe powyżej średniej grupy odniesienia, a T = 35 – półtora odchylenia poniżej. W praktyce wyniki mieszczą się zwykle między 20 a 80 (od −3 do +3 SD).
Wynik T to po prostu wynik z przesunięty i rozciągnięty tak, by uniknąć liczb ujemnych i ułamków (Andrade, 2021). W odróżnieniu od stenów i staninów nie dzieli wyników na kilka szerokich kategorii, tylko zachowuje ich ciągłość: jeden sten odpowiada pięciu punktom T. Dlatego skala T dobrze nadaje się zarówno do opisu wyników indywidualnych, jak i do analiz grupowych. Na wynikach T podaje się normy wielu kwestionariuszy klinicznych i osobowości.
Trzy odmiany wyników T
| Odmiana | Jak powstaje | Co zachowuje, a co traci |
|---|---|---|
| Liniowe T | Wzór 50 + 10z z M i SD norm | Zachowuje kształt rozkładu; przy skośności T = 70 nie musi oznaczać 97.7. centyla |
| Znormalizowane T | Ranga centylowa → z z rozkładu normalnego → T | Stała zależność T i centyla; zmienia odległości między osobami (zob. wynik znormalizowany) |
| Jednolite T (UT) | Wspólny docelowy rozkład dla wszystkich skal testu | Porównywalne centyle między skalami przy zachowanej skośności |
Problem, który rozwiązują dwie ostatnie odmiany, opisali Tellegen i Ben-Porath (1992) na przykładzie MMPI-2. Rozkłady norm skal klinicznych są prawoskośne, i to w różnym stopniu, więc liniowe T o tej samej wartości ma w różnych skalach różną rangę centylową. Utrudnia to interpretację profilu. Jednolite wyniki T są porównywalne pod względem centyli, a jednocześnie niewiele odbiegają od liniowych. Zanim porównasz wyniki T z dwóch skal, sprawdź w podręczniku, którą odmianę zastosowano.
Wyniki T a inne skale standardowe
Wszystkie skale standardowe opisują to samo położenie wyniku względem norm, tylko w innych jednostkach. Wynik T = 70 to z = 2, IQ = 130 i sten 9.5, czyli granica stenów 9 i 10. Wynik T = 40 to z = −1, IQ = 85 i granica stenów 3 i 4. Przy rozkładzie normalnym każdej wartości T odpowiada stała ranga centylowa: T = 60 to około 84. centyl, a T = 30 – około 2. centyl. Przy liniowych T i skośnych normach te rangi trzeba odczytać z tabeli norm, a nie z krzywej normalnej. Pamiętaj też, że przeliczenie skali nie zmienia dokładności pomiaru: jeśli wynik surowy ma szeroki przedział ufności, wynik T ma go również, tylko wyrażonego w innych jednostkach.
Przykład: grupa kliniczna na tle norm populacyjnych
Wynik T przydaje się nie tylko w diagnozie indywidualnej. Pozwala też pokazać, jak bardzo grupa badana odbiega od populacji. Dziewięćdziesięciu pacjentów poradni zdrowia psychicznego (dane symulowane) wypełniło skalę objawów depresji (0–60 punktów) i skalę objawów lęku (0–40 punktów). W podręczniku podano normy populacyjne: dla depresji M = 12.4, SD = 7.1, dla lęku M = 9.8, SD = 5.2 (dane przykładowe).
Krok 1. Przeliczenie. Wynik 20 punktów w skali depresji to T = 50 + 10 × (20 − 12.4) / 7.1 = 60.7, a wynik 30 punktów – T = 74.8. W drugą stronę: progi T = 60, 65 i 70 odpowiadają w tej skali wynikom surowym 19.5, 23.0 i 26.6 punktu.
Krok 2. Opis grupy. Średni wynik pacjentów w skali depresji wyniósł M = 63.19 punktu T (SD = 11.79), a w skali lęku M = 55.96 (SD = 10.57). Ponieważ SD skali T wynosi 10, różnicę średniej od 50 można czytać wprost w odchyleniach standardowych populacji: grupa kliniczna leży o 1.32 SD wyżej w depresji (to rodzaj standaryzowanej różnicy średnich względem norm) i o 0.60 SD wyżej w lęku. Wyniki surowe obu skal mają różne zakresy i nie dałoby się ich tak porównać. Różnica od średniej populacji była istotna, t(89) = 10.62, p < .001, 95% CI [60.72, 65.66] (zob. test t dla jednej próby).
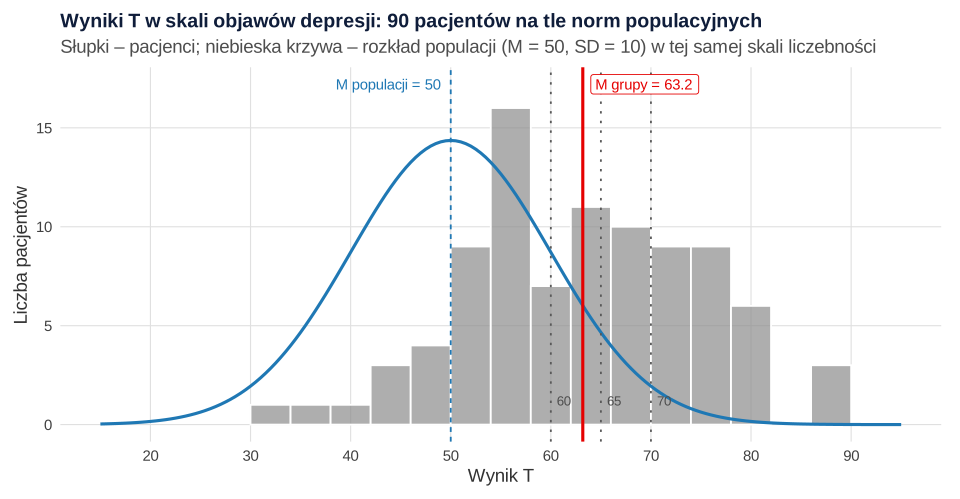
Krok 3. Odsetki wyników podwyższonych. W skali depresji wynik T ≥ 70 miało 30.0% pacjentów, a w populacji o rozkładzie normalnym spodziewalibyśmy się 2.3%. Podobne porównanie dla innych progów pokazuje tabela.
| Grupa | T ≥ 60 | T ≥ 65 | T ≥ 70 |
|---|---|---|---|
| Pacjenci – depresja | 55.6% | 41.1% | 30.0% |
| Pacjenci – lęk | 38.9% | 20.0% | 6.7% |
| Populacja (rozkład normalny) | 15.9% | 6.7% | 2.3% |
Wartości w wierszu „populacja” zakładają normalny rozkład wyników w populacji. Przy liniowych T i skośnych normach rzeczywiste odsetki mogą być inne – dlatego Crawford i Garthwaite (2009) zalecają podawać przy wynikach standardowych także rangi centylowe z norm. Progi T = 60, 65 czy 70 to umowne punkty odcięcia: każde narzędzie ma własne, ustalone w badaniach walidacyjnych. Nie przenoś ich z jednego kwestionariusza na inny.
Jak opisać wyniki T w pracy
Napisz, według jakich norm przeliczono wyniki (populacja, rok, płeć i wiek), którą odmianę T zastosowano i jakie progi przyjęto za podręcznikiem. Standardy testowe wymagają, by wyniki przeliczone odnosić do jasno opisanej grupy normalizacyjnej (American Educational Research Association i in., 2014). Średnie wyników T możesz podawać i analizować jak każdą zmienną ilościową.
Gotowe zdania do opisu innych wyników znajdziesz w poradniku jak opisać wyniki w stylu APA.
Wyniki T w R
Kod tworzy wyniki grupy klinicznej, przelicza je na wyniki T według norm populacyjnych, przelicza progi T z powrotem na punkty surowe, opisuje grupę w jednostkach T, porównuje jej średnią z wartością 50 i zestawia odsetki wyników podwyższonych z oczekiwanymi w populacji. Liczby w tekście, tabeli i na rysunku pochodzą z tego kodu.
Przeliczenie na T i porównanie z normami
R
# Skala tenowa (wyniki T): przeliczenie wyników grupy klinicznej względem norm populacyjnych (dane symulowane)
set.seed(156)
n <- 90                                                  # pacjenci poradni zdrowia psychicznego
depresja <- pmin(pmax(round(rnorm(n, 22, 9)), 0), 60)   # skala objawów depresji, 0–60 pkt
lek      <- pmin(pmax(round(rnorm(n, 13, 5.5)), 0), 40) # skala objawów lęku, 0–40 pkt
# Normy populacyjne z podręcznika (dane przykładowe): M i SD wyników surowych
norm <- list(depresja = c(M = 12.4, SD = 7.1), lek = c(M = 9.8, SD = 5.2))
T_wynik <- function(x, n) 50 + 10 * (x - n["M"]) / n["SD"]
T_dep <- T_wynik(depresja, norm$depresja); T_lek <- T_wynik(lek, norm$lek)

# 1. Przykładowe przeliczenia i powrót z T do wyniku surowego
round(T_wynik(c(5, 12.4, 20, 30), norm$depresja), 1)
round(norm$depresja["M"] + norm$depresja["SD"] * (c(60, 65, 70) - 50) / 10, 1)

# Wynik T na innych skalach (z, IQ, sten przed zaokrągleniem) i ranga centylowa przy rozkładzie normalnym
T <- c(30, 40, 60, 70)
round(data.frame(T, z = (T - 50) / 10, IQ = 100 + 15 * (T - 50) / 10, sten = 5.5 + 2 * (T - 50) / 10,
                 ranga_centylowa = 100 * pnorm(T, 50, 10)), 1)

# 2. Opis grupy w jednostkach T: średnia, SD i odległość od średniej populacji w SD
opis <- function(t) c(M_T = mean(t), SD_T = sd(t), d_wzgl_normy = (mean(t) - 50) / 10)
round(rbind(depresja = opis(T_dep), lek = opis(T_lek)), 2)
t.test(T_dep, mu = 50)

# 3. Odsetek wyników podwyższonych: w grupie i oczekiwany w populacji (rozkład normalny)
progi <- c(60, 65, 70)
odsetki <- rbind(grupa_depresja = sapply(progi, function(p) 100 * mean(T_dep >= p)),
                 grupa_lek = sapply(progi, function(p) 100 * mean(T_lek >= p)),
                 populacja = 100 * (1 - pnorm(progi, 50, 10)))
colnames(odsetki) <- paste0("T >= ", progi)
round(odsetki, 1)
Wynik w R
[1] 39.6 50.0 60.7 74.8
[1] 19.5 23.0 26.6
   T  z  IQ sten ranga_centylowa
1 30 -2  70  1.5             2.3
2 40 -1  85  3.5            15.9
3 60  1 115  7.5            84.1
4 70  2 130  9.5            97.7
           M_T  SD_T d_wzgl_normy
depresja 63.19 11.79         1.32
lek      55.96 10.57         0.60

	One Sample t-test

data:  T_dep
t = 10.617, df = 89, p-value < 2.2e-16
alternative hypothesis: true mean is not equal to 50
95 percent confidence interval:
 60.72358 65.66140
sample estimates:
mean of x
 63.19249

               T >= 60 T >= 65 T >= 70
grupa_depresja    55.6    41.1    30.0
grupa_lek         38.9    20.0     6.7
populacja         15.9     6.7     2.3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczenie T ze średniej i SD własnej próby – otrzymujesz wtedy zawsze średnią 50 i tracisz informację, czy grupa odbiega od populacji.
- Mylenie wyniku T ze statystyką t – wynik T (wielka litera) to skala standardowa, a t (kursywa, mała litera) – statystyka testu.
- Utożsamianie T = 70 z 98. centylem przy liniowych T i skośnych normach – sprawdź rangę centylową w tabeli norm.
- Przenoszenie progów klinicznych między narzędziami – próg T = 65 w jednym kwestionariuszu nie musi nic znaczyć w innym.
- Porównywanie wyników T z różnych testów opartych na normach z innych populacji – wspólna skala nie oznacza wspólnej grupy odniesienia.
- Zaokrąglanie T do kategorii przed analizą – skala T jest ciągła, korzystaj z tego.
Najczęstsze pytania
Co to jest wynik T?
To wynik na skali standardowej o średniej 50 i odchyleniu standardowym 10. Mówi, gdzie leży wynik osoby względem grupy normalizacyjnej: T = 50 to wynik przeciętny, T = 60 – o jedno odchylenie standardowe wyższy, T = 30 – o dwa niższy.
Jak obliczyć wynik T z wyniku surowego?
Odejmij od wyniku surowego średnią z norm, podziel przez odchylenie standardowe z norm i zastosuj wzór T = 50 + 10z. Przy normach M = 12.4 i SD = 7.1 wynik 20 punktów daje T = 60.7. Gdy podręcznik podaje tabelę norm, korzystaj z niej, bo może zawierać wyniki znormalizowane.
Co oznacza wynik T powyżej 65 lub 70?
Przy rozkładzie normalnym T ≥ 65 ma około 6.7% populacji, a T ≥ 70 – około 2.3%. W wielu kwestionariuszach klinicznych takie wartości są progami wyników podwyższonych, ale dokładne progi i ich znaczenie ustala podręcznik konkretnego narzędzia.
Czym różnią się liniowe i znormalizowane wyniki T?
Liniowe T powstają ze wzoru 50 + 10z i zachowują kształt rozkładu wyników surowych. Znormalizowane T powstają przez rangę centylową i rozkład normalny, więc każda wartość T odpowiada zawsze tej samej randze centylowej. Przy skośnych normach obie wersje dają różne liczby.
Czy na wynikach T można liczyć średnie i testy statystyczne?
Tak, skala T jest ciągła i liniowo związana z wynikiem surowym, więc wyniki analiz są takie same jak na wynikach surowych. Zaletą T jest to, że średnią grupy można od razu odnieść do populacji: M = 63 oznacza grupę o 1.3 SD powyżej średniej norm.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Psychometria – zadania z rozwiązaniami
Dziesięć zadań: alfa Cronbacha, analiza pozycji, KR-20, omega, błąd standardowy pomiaru, RCI, normy, Spearman–Brown i korekta na atenuację.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka dla psychologa
Analizy w pracy dyplomowej z psychologii: typowe projekty, wynik kwestionariusza, alfa i omega, normy i steny, eksperyment i raport APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Andrade, C. (2021). Z scores, standard scores, and composite test scores explained. Indian Journal of Psychological Medicine, 43(6), 555–557. https://doi.org/10.1177/02537176211046525 ● Otwarty dostęp
- Crawford, J. R., & Garthwaite, P. H. (2009). Percentiles please: The case for expressing neuropsychological test scores and accompanying confidence limits as percentile ranks. The Clinical Neuropsychologist, 23(2), 193–204. https://doi.org/10.1080/13854040801968450
- Tellegen, A., & Ben-Porath, Y. S. (1992). The new uniform T scores for the MMPI-2: Rationale, derivation, and appraisal. Psychological Assessment, 4(2), 145–155. https://doi.org/10.1037/1040-3590.4.2.145
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{andrade2021z, author={Andrade, Chittaranjan}, title={{Z scores, standard scores, and composite test scores explained}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={6}, pages={555--557}, doi={10.1177/02537176211046525}}@article{crawford2009percentiles, author={Crawford, John R. and Garthwaite, Paul H.}, title={{Percentiles please: The case for expressing neuropsychological test scores and accompanying confidence limits as percentile ranks}}, journal={The Clinical Neuropsychologist}, year={2009}, volume={23}, number={2}, pages={193--204}, doi={10.1080/13854040801968450}}@article{tellegen1992new, author={Tellegen, Auke and Ben-Porath, Yossef S.}, title={{The new uniform T scores for the MMPI-2: Rationale, derivation, and appraisal}}, journal={Psychological Assessment}, year={1992}, volume={4}, number={2}, pages={145--155}, doi={10.1037/1040-3590.4.2.145}}