Co to jest skala staninowa?
Skala staninowa (ang. stanine, od standard nine – „standardowa dziewiątka”) to skala wyników standardowych, która dzieli wyniki grupy odniesienia na dziewięć kategorii oznaczonych liczbami od 1 do 9. Ma średnią 5 i odchylenie standardowe 2. Każdy stanin poza skrajnymi obejmuje przedział o szerokości pół odchylenia standardowego, a stanin 5 leży symetrycznie wokół średniej – od z = −0.25 do 0.25. Staniny stosuje się zwłaszcza w testach szkolnych i osiągnięć, gdzie liczy się szybka, zgrubna informacja o pozycji ucznia.
Rodzina skal standardowych jest szersza: steny mają dziesięć kategorii, wyniki T – średnią 50 i SD 10, a skala IQ – średnią 100 i SD 15. Wszystkie są przekształceniami wyniku z (Andrade, 2021). Staniny różnią się od nich tym, że mają nieparzystą liczbę kategorii z jedną kategorią środkową i najmniej szczegółową rozdzielczość: cały rozkład mieści się w dziewięciu liczbach.
Odsetki w staninach i ich interpretacja
Przy rozkładzie normalnym granice staninów leżą w punktach z = ±0.25, ±0.75, ±1.25 i ±1.75, a odsetki osób w kolejnych staninach wynoszą:
| Stanin | Przedział z | % osób | % skumulowany |
|---|---|---|---|
| 1 | poniżej −1.75 | 4.0 | 4.0 |
| 2 | −1.75 do −1.25 | 6.6 | 10.6 |
| 3 | −1.25 do −0.75 | 12.1 | 22.7 |
| 4 | −0.75 do −0.25 | 17.5 | 40.1 |
| 5 | −0.25 do 0.25 | 19.7 | 59.9 |
| 6 | 0.25 do 0.75 | 17.5 | 77.3 |
| 7 | 0.75 do 1.25 | 12.1 | 89.4 |
| 8 | 1.25 do 1.75 | 6.6 | 96.0 |
| 9 | powyżej 1.75 | 4.0 | 100 |
Skumulowane odsetki zaokrągla się zwykle do łatwej do zapamiętania sekwencji 4, 11, 23, 40, 60, 77, 89, 96. Podział na trzy grupy (1–3, 4–6, 7–9) to częsta, ale umowna konwencja – w raporcie posługuj się opisem z podręcznika testu. Staniny nie są przedziałowo równe rangom centylowym: przejście ze staninu 5 do 6 to przesunięcie o kilkanaście centyli, a ze staninu 8 do 9 – o kilka. Crawford i Garthwaite (2009) zalecają, by obok wyników standardowych podawać rangę centylową, bo bezpośrednio mówi, jak rzadki jest wynik.
Dwie metody przypisywania staninów
- Metoda liniowa – policz z z średniej i SD grupy odniesienia i zastosuj wzór 5 + 2z. Zachowuje kształt rozkładu wyników surowych.
- Metoda procentowa – uszereguj wyniki, policz rangi centylowe i przypisz staniny według skumulowanych odsetków (4%, 11%, 23%…). Daje to staniny znormalizowane: rozkład staninów zbliża się do teoretycznego bez względu na kształt rozkładu wyników.
Przy rozkładzie normalnym obie metody dają to samo. Rozkłady wyników testów rzadko są jednak normalne: Micceri (1989) nie znalazł normalnego rozkładu wśród setek dużych zbiorów wyników testów osiągnięć i miar psychometrycznych. Przy teście zbyt łatwym albo zbyt trudnym różnica między metodami bywa duża, co pokazuje przykład.
Przykład: łatwy test w klasach czwartych
Test rozumienia czytanego (30 zadań, wynik 0–30) rozwiązało 240 uczniów klas czwartych (dane symulowane). Test okazał się łatwy: M = 21.50, SD = 5.15, mediana 22.5, wyniki od 7 do 30, skośność −0.60 (zob. efekt sufitu). Wyniki przeliczono na staniny obiema metodami.
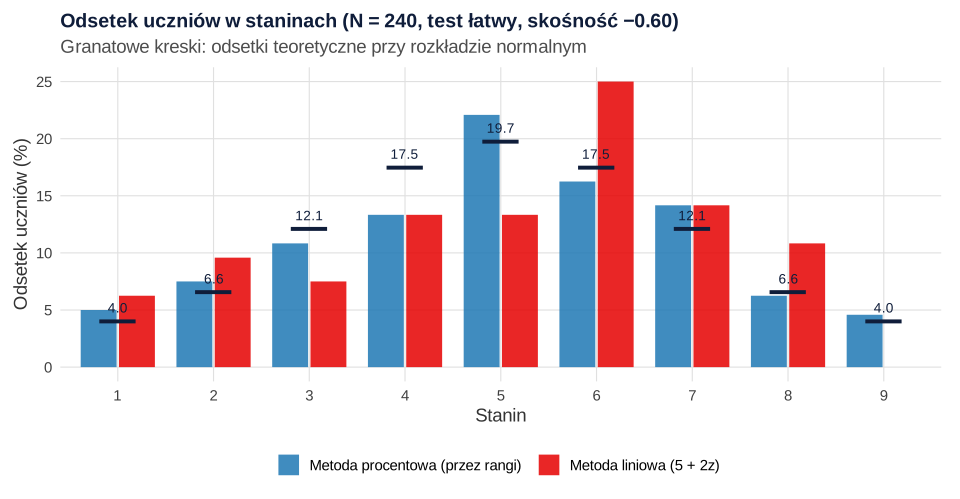
Metoda liniowa nie przypisała nikomu staninu 9. Najwyższy możliwy wynik, 30 punktów, leży zaledwie 1.65 SD nad średnią, więc 5 + 2 × 1.65 zaokrągla się do 8. W staninie 6 znalazło się za to 25.0% uczniów zamiast 17.5%. Metoda procentowa dała odsetki bliższe teoretycznym, choć nie identyczne (np. 22.1% zamiast 19.7% w staninie 5). Przyczyną są wyniki wiązane: 53 uczniów miało wyniki 21–23, a wszystkich z tym samym wynikiem trzeba umieścić w tym samym staninie. Obie metody przypisały różne staniny 43 uczniom.
Tabela norm z metody procentowej wygląda tak:
| Stanin | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| Wynik surowy | 7–11 | 12–14 | 15–17 | 18–20 | 21–23 | 24–25 | 26–27 | 28 | 29–30 |
| n | 12 | 18 | 26 | 32 | 53 | 39 | 34 | 15 | 11 |
Zauważ, jak wąskie są górne staniny: stanin 8 to jeden wynik surowy (28 punktów), a różnica dwóch punktów dzieli stanin 7 od 9. Na dole skali do staninu 1 trafia za to aż pięć wyników (7–11). Przy łatwym teście staniny dobrze różnicują słabszych uczniów, a słabo – najlepszych. Takich norm nie twórz zresztą na jednej szkole: o liczebności i doborze próby normalizacyjnej mówi hasło normalizacja.
Kiedy staniny są dobrym wyborem
Staniny sprawdzają się w komunikacji wyników – uczniom, rodzicom, nauczycielom – i tam, gdzie test nie jest na tyle dokładny, by różnice kilku punktów miały znaczenie. Jedna kategoria to pół odchylenia standardowego, więc stanin „ukrywa” drobne, zwykle przypadkowe różnice. Do analiz statystycznych lepiej nadają się wyniki ciągłe – wynik surowy albo wynik T – bo zamiana na dziewięć kategorii traci informację, a odległości między staninami w ogonach i w środku rozkładu odpowiadają różnym różnicom wyników surowych. Standardy testowe wymagają też, by wyniki przeliczone zawsze odnosić do opisanej grupy normalizacyjnej (American Educational Research Association i in., 2014).
Szerokie kategorie nie usuwają jednak błędu pomiaru. Standardowy błąd pomiaru wyrażony w staninach to 2 × √(1 − rzetelność): przy rzetelności .90 wynosi 0.63 stanina, przy .80 – 0.89, a przy .70 – 1.10. Nawet przy dobrej rzetelności uczeń z wynikiem przy granicy dwóch staninów może w powtórnym badaniu trafić do sąsiedniej kategorii. Dlatego decyzje o uczniu (np. o dodatkowych zajęciach) opieraj na kilku źródłach informacji, a różnicę jednego staninu między dwoma uczniami traktuj jako niepewną.
Jak opisać staniny w pracy
Podaj, z jakich norm pochodzą staniny (populacja, liczebność, rok), którą metodą je przypisano i do czego ich użyto. Jeśli staniny liczysz sam na danych z własnego badania, napisz wprost, że są to normy lokalne dla tej próby, a nie normy populacyjne.
Staniny w R
Kod tworzy wyniki z przykładu, liczy teoretyczne odsetki staninów, przypisuje staniny metodą procentową i liniową, porównuje uzyskane rozkłady, buduje tabelę norm i zlicza uczniów z różnymi staninami. Liczby w tekście, tabelach i na rysunku pochodzą z tego kodu.
Metoda procentowa i liniowa
R
# Skala staninowa: przypisanie staninów metodą procentową i z wyniku z (dane symulowane)
set.seed(154)
n <- 240                                          # uczniowie klas 4 z kilku szkół
p_i <- rbeta(n, 5.5, 2.2)                          # łatwy test: rozkład lewostronnie skośny
wynik <- rbinom(n, 30, p_i)                        # test rozumienia czytanego, 0–30 pkt
round(c(M = mean(wynik), SD = sd(wynik), Mdn = median(wynik), min = min(wynik), max = max(wynik),
        skosnosc = mean((wynik - mean(wynik))^3) / sd(wynik)^3), 2)

# Teoretyczne odsetki staninów: granice co pół SD, od z = −1.75 do 1.75
granice_z <- c(-Inf, seq(-1.75, 1.75, 0.5), Inf)
teor <- 100 * diff(pnorm(granice_z))
round(teor, 1)
round(100 * cumsum(diff(pnorm(granice_z)))[1:8], 1)     # skumulowane: 4, 11, 23, 40, 60, 77, 89, 96

# 1. Metoda procentowa: ranga centylowa (punkt środkowy) → stanin wg skumulowanych odsetków
PR <- sapply(wynik, function(x) 100 * (mean(wynik < x) + 0.5 * mean(wynik == x)))
stanin_proc <- findInterval(PR, 100 * pnorm(seq(-1.75, 1.75, 0.5))) + 1
# 2. Metoda liniowa: stanin = 5 + 2z, zaokrąglony i ograniczony do 1–9
z <- (wynik - mean(wynik)) / sd(wynik)
stanin_z <- pmin(pmax(round(5 + 2 * z), 1), 9)
round(c(z_max = max(z), stanin_dla_z_max = 5 + 2 * max(z)), 2)   # najwyższy wynik (30 pkt) nie sięga staninu 9

round(rbind(teoretyczny = teor,
            procentowa = 100 * tabulate(stanin_proc, 9) / n,
            liniowa = 100 * tabulate(stanin_z, 9) / n), 1)

# Tabela norm: zakres wyników surowych w każdym staninie (metoda procentowa)
tab <- aggregate(wynik ~ stanin_proc, FUN = function(x) if (min(x) == max(x)) as.character(min(x)) else paste(min(x), max(x), sep = "-"))
tab$n <- as.vector(table(stanin_proc))
tab
# Uczniowie, którym obie metody przypisały różne staniny
table(procentowa = stanin_proc, liniowa = stanin_z)
sum(stanin_proc != stanin_z)

# Standardowy błąd pomiaru wyrażony w staninach (SD skali = 2) przy różnej rzetelności testu
rzet <- c(0.70, 0.80, 0.90)
round(setNames(2 * sqrt(1 - rzet), rzet), 2)
Wynik w R
       M       SD      Mdn      min      max skosnosc
   21.50     5.15    22.50     7.00    30.00    -0.60
[1]  4.0  6.6 12.1 17.5 19.7 17.5 12.1  6.6  4.0
[1]  4.0 10.6 22.7 40.1 59.9 77.3 89.4 96.0
           z_max stanin_dla_z_max
            1.65             8.30
            [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
teoretyczny  4.0  6.6 12.1 17.5 19.7 17.5 12.1  6.6  4.0
procentowa   5.0  7.5 10.8 13.3 22.1 16.2 14.2  6.2  4.6
liniowa      6.2  9.6  7.5 13.3 13.3 25.0 14.2 10.8  0.0
  stanin_proc wynik  n
1           1  7-11 12
2           2 12-14 18
3           3 15-17 26
4           4 18-20 32
5           5 21-23 53
6           6 24-25 39
7           7 26-27 34
8           8    28 15
9           9 29-30 11
          liniowa
procentowa  1  2  3  4  5  6  7  8
         1 12  0  0  0  0  0  0  0
         2  3 15  0  0  0  0  0  0
         3  0  8 18  0  0  0  0  0
         4  0  0  0 32  0  0  0  0
         5  0  0  0  0 32 21  0  0
         6  0  0  0  0  0 39  0  0
         7  0  0  0  0  0  0 34  0
         8  0  0  0  0  0  0  0 15
         9  0  0  0  0  0  0  0 11
[1] 43
 0.7  0.8  0.9
1.10 0.89 0.63
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie staninów ze stenami – stanin 5 to środek skali, a sten 5 leży tuż poniżej średniej. Wynik „5” znaczy co innego na obu skalach.
- Przeliczanie liniowe przy skośnym rozkładzie – kategorie skrajne mogą zostać puste albo przepełnione.
- Liczenie średnich i testów t na staninach zamiast na wynikach ciągłych – tracisz informację i moc.
- Interpretowanie różnicy jednego staninu jako istotnej – przy typowej rzetelności wynik osoby może się przesunąć o stanin przy powtórnym badaniu.
- Staniny bez podania grupy odniesienia – „stanin 7” bez informacji, czyje to normy, nic nie znaczy.
- Normy staninowe z jednej klasy – mała i jednorodna grupa daje kategorie, które nie przeniosą się na inne szkoły.
Najczęstsze pytania
Co to są staniny?
To wyniki na dziewięciostopniowej skali standardowej o średniej 5 i SD 2. Stanin 5 oznacza wynik przeciętny, staniny 1–3 – wyniki poniżej przeciętnej, a 7–9 – powyżej. Nazwa pochodzi od angielskiego standard nine.
Jaki odsetek osób jest w poszczególnych staninach?
Przy rozkładzie normalnym w staninach od 1 do 9 jest kolejno około 4, 7, 12, 17, 20, 17, 12, 7 i 4% osób. Skumulowane odsetki, według których przypisuje się staniny metodą procentową, to 4, 11, 23, 40, 60, 77, 89 i 96%.
Jak przeliczyć wynik surowy na stanin?
Przy rozkładzie zbliżonym do normalnego: policz z względem norm, oblicz 5 + 2z, zaokrąglij i ogranicz do 1–9. Przy rozkładzie skośnym lepiej uszeregować wyniki, policzyć rangi centylowe i przypisać staniny według skumulowanych odsetków.
Czym różnią się staniny od stenów?
Staniny mają dziewięć kategorii, średnią 5 i jedną kategorię środkową, a steny – dziesięć kategorii, średnią 5.5 i dwie kategorie przy średniej (5 i 6). W obu skalach jedna kategoria to pół odchylenia standardowego, ale te same liczby oznaczają na nich inne wyniki.
Czy staniny można używać w analizach statystycznych?
Lepiej nie. Zamiana wyniku na dziewięć kategorii traci informację i obniża moc testów. Staniny służą do komunikowania wyników indywidualnych; w analizach używaj wyników surowych albo ciągłych wyników standardowych, np. T.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikStatystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →PoradnikKonwerter wyników na normy
Wynik surowy na z, T, sten, stanin i centyl oraz w drugą stronę – z granicami stenów i staninów, kodem R i opisem do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Andrade, C. (2021). Z scores, standard scores, and composite test scores explained. Indian Journal of Psychological Medicine, 43(6), 555–557. https://doi.org/10.1177/02537176211046525 ● Otwarty dostęp
- Crawford, J. R., & Garthwaite, P. H. (2009). Percentiles please: The case for expressing neuropsychological test scores and accompanying confidence limits as percentile ranks. The Clinical Neuropsychologist, 23(2), 193–204. https://doi.org/10.1080/13854040801968450
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{andrade2021z, author={Andrade, Chittaranjan}, title={{Z scores, standard scores, and composite test scores explained}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={6}, pages={555--557}, doi={10.1177/02537176211046525}}@article{crawford2009percentiles, author={Crawford, John R. and Garthwaite, Paul H.}, title={{Percentiles please: The case for expressing neuropsychological test scores and accompanying confidence limits as percentile ranks}}, journal={The Clinical Neuropsychologist}, year={2009}, volume={23}, number={2}, pages={193--204}, doi={10.1080/13854040801968450}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}