Co to jest obiektywność testu?
Obiektywność (ang. objectivity) w psychometrii to niezależność wyniku testu od osoby, która test przeprowadza, punktuje i interpretuje. Test jest obiektywny, jeśli dwie różne osoby badające, pracujące niezależnie z tym samym protokołem, dojdą do tego samego wyniku i tego samego wniosku. W polskiej tradycji psychometrycznej obiektywność wymienia się obok standaryzacji, rzetelności, trafności i normalizacji jako jedną z podstawowych właściwości testu psychometrycznego.
W literaturze anglojęzycznej słowo objectivity pojawia się rzadziej. To samo zagadnienie opisuje się najczęściej jako zgodność oceniających (inter-rater agreement) albo rzetelność międzysędziowską (inter-rater reliability). Obiektywność jest więc warunkiem rzetelności: błąd wynikający z tego, kto punktuje, staje się częścią błędu pomiaru.
Trzy etapy obiektywności
| Etap | Co może zależeć od osoby badającej | Jak ją zapewnić i sprawdzić |
|---|---|---|
| Przeprowadzanie | Sposób czytania instrukcji, podpowiedzi, pilnowanie czasu, dopytywanie | Dosłowna instrukcja, protokół, szkolenie; zob. standaryzacja |
| Punktowanie | Uznanie odpowiedzi granicznej za poprawną, częściowe punkty, błędy rachunkowe | Klucz z przykładami odpowiedzi, podwójne punktowanie części protokołów, miary zgodności |
| Interpretacja | Wybór norm, progów, słów opisujących wynik („przeciętny”, „obniżony”) | Jedna tabela norm, ustalone przedziały opisowe, reguły łączenia wyników |
Testy z odpowiedziami zamkniętymi i kluczem (np. kwestionariusze samoopisowe na skali Likerta) mają wysoką obiektywność punktowania, bo błędy ogranicza się do pomyłek przy przepisywaniu. Najtrudniejsze są zadania otwarte: definicje słów, opowiadania do obrazków, rysunki, odpowiedzi w wywiadzie. Tam o liczbie punktów decyduje ocena człowieka, więc obiektywność trzeba sprawdzić empirycznie.
Obiektywność nie oznacza trafności. W pełni automatycznie punktowany test może mierzyć coś innego, niż zapowiada, albo mieć normy niepasujące do badanej osoby (American Educational Research Association i in., 2014). Obiektywność gwarantuje tylko tyle, że wynik nie zależy od tego, kto go policzył.
W pracy dyplomowej obiektywność planuje się jeszcze przed zebraniem danych. Ustal, kto będzie punktował protokoły, i przygotuj klucz z przykładami odpowiedzi granicznych. Przed właściwym punktowaniem zrób próbę na kilku protokołach spoza badania i omów rozbieżności. Potem niech druga osoba niezależnie oceni wszystkie protokoły, a przy dużej próbie – co najmniej ich losową część, wybraną przed rozpoczęciem oceniania. Zapisz też, kto prowadził badanie, jeśli robiło to kilka osób. Pozwoli to później sprawdzić, czy wyniki różnią się między badającymi.
Jak mierzy się obiektywność punktowania
Gdy co najmniej dwie osoby niezależnie punktują te same protokoły, zgodność można opisać na dwóch poziomach (Hallgren, 2012):
- pojedyncze odpowiedzi – procent zgodnych ocen i kappa Cohena. McHugh (2012) przypomina, że kappa koryguje procent zgodności o zgodność przypadkową. Dla punktów uporządkowanych (0–1–2) stosuj kappę ważoną, która mniej karze rozbieżność o jeden punkt niż o dwa;
- wynik całego testu – współczynnik korelacji wewnątrzklasowej (ICC). Koo i Li (2016) wymagają, by podawać model, typ i definicję ICC. Dla obiektywności liczy się zwykle zgodność bezwzględna – ICC(A,1) – bo stała różnica między oceniającymi również zmienia wynik osoby.
Te miary nie wystarczą jednak, gdy wynik ma służyć diagnozie. Trzeba jeszcze sprawdzić, czy rozbieżności zmieniają wynik przeliczony na normy – i to pokazuje przykład.
Przykład: dwóch oceniających i 60 protokołów
Dwoje studentów psychologii (A i B) niezależnie punktowało 60 protokołów podtestu słownikowego dla dzieci (dane symulowane). Podtest ma 20 słów; za definicję przyznaje się 0, 1 albo 2 punkty, więc wynik surowy wynosi od 0 do 40. Wynik przelicza się na steny według norm podręcznika (M = 22, SD = 7). Punktowanie zrobiono dwa razy: najpierw z ogólnym kluczem, potem po szkoleniu z kluczem, który zawierał przykłady odpowiedzi za 0, 1 i 2 punkty.
| Miara | Przed szkoleniem | Po szkoleniu |
|---|---|---|
| Zgodne oceny pojedynczych definicji | 81.3% | 92.1% |
| Kappa ważona (1200 ocen) | .87 | .95 |
| ICC(A,1) dla sumy punktów | .95 | .99 |
| M sumy: oceniający A / B | 20.03 / 22.05 | 19.97 / 20.28 |
| Największa różnica sum dla jednego dziecka | 8 pkt | 4 pkt |
| Protokoły, którym A i B przypisali inny sten | 53.3% | 18.3% |
Przed szkoleniem wszystkie miary zgodności wyglądały dobrze – ICC(A,1) = .95 mieści się według kryteriów Koo i Li (2016) w przedziale rzetelności doskonałej. Mimo to co drugie dziecko dostałoby inny sten w zależności od tego, kto sprawdził protokół. Przyczyną była systematyczna łagodność oceniającego B przy odpowiedziach granicznych: w tabeli zgodności ocen B przyznał wyższą ocenę niż A 171 razy, a niższą – tylko 53 razy. Średnia różnica sum wyniosła 2.02 punktu, czyli prawie 0.3 SD normy, co wystarcza, żeby wiele wyników przekroczyło granicę stenu (rysunek 1).
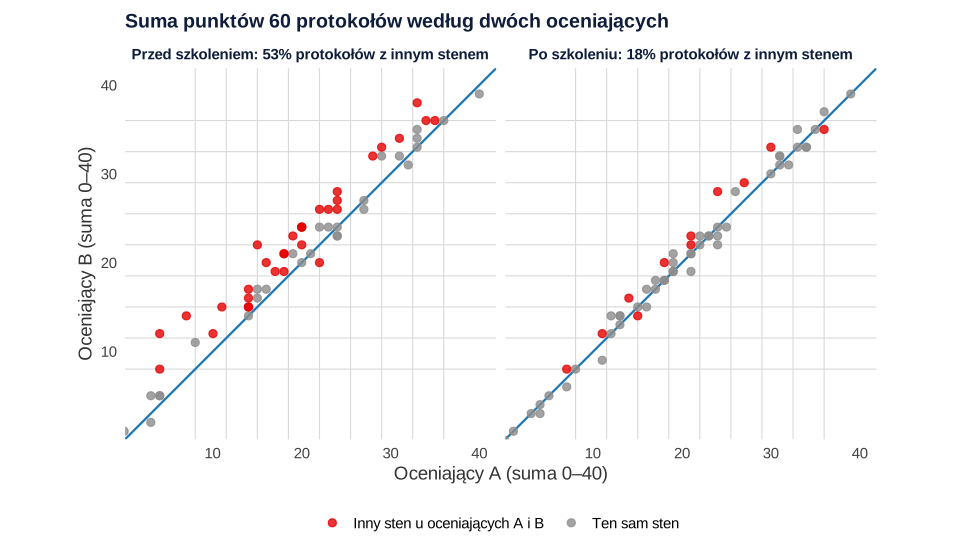
Po szkoleniu średnia różnica spadła do 0.32 punktu, a ICC(A,1) wzrósł do .99. Wciąż jednak 18.3% protokołów zmieniało sten. Steny dzielą skalę na przedziały szerokie na pół odchylenia standardowego (tu 3.5 punktu), więc nawet różnica jednego punktu przesuwa wynik leżący przy granicy do sąsiedniej kategorii. Wniosek praktyczny: w zadaniach otwartych sprawdzaj zgodność na poziomie wyniku, którego używasz do decyzji, a protokoły z wynikiem przy granicy normy lub progu diagnostycznego punktuj podwójnie.
Jak opisać obiektywność w pracy
Podaj, kto punktował protokoły i czy był przeszkolony, jaka część protokołów była punktowana podwójnie i niezależnie, jakie miary zgodności policzono (z modelem i typem ICC) oraz jak rozstrzygano rozbieżności. Gdy wyniki przeliczasz na normy, dodaj odsetek osób, u których rozbieżność zmieniała kategorię wyniku.
Gotowy układ tabeli z miarami zgodności i rzetelności znajdziesz w haśle tabela rzetelności skal w APA, a szersze zasady opisu narzędzi – w poradniku jak zbudować i zwalidować skalę psychometryczną.
Zgodność oceniających w R
Kod tworzy oceny dwóch oceniających przed szkoleniem i po nim, liczy procent zgodnych ocen, kappę ważoną, ICC dla sum punktów i odsetek protokołów, którym oceniający przypisali różne steny. Liczby w tekście, tabeli i na rysunku pochodzą z tego kodu.
Obiektywność punktowania: od pojedynczej odpowiedzi do stenu
R
# Obiektywność punktowania: dwóch oceniających punktuje te same protokoły (dane symulowane)
library(psych)   # cohen.kappa(), ICC()
set.seed(150)
n_os <- 60; n_poz <- 20                       # 60 protokołów, 20 definicji słów punktowanych 0–1–2
zdolnosc <- rnorm(n_os)
trudnosc <- seq(-1.8, 1.8, length.out = n_poz)
# Jakość odpowiedzi na ciągłym kontinuum; klucz wyznacza progi 0/1 i 1/2
jakosc <- outer(zdolnosc, trudnosc, "-") + matrix(rnorm(n_os * n_poz, 0, 0.6), n_os)
punktuj <- function(j, przesuniecie, szum) {
  jj <- j + przesuniecie + matrix(rnorm(length(j), 0, szum), nrow(j))
  (jj > -0.6) + (jj > 0.6)
}
# Etap 1: ogólny klucz bez przykładów; oceniający B jest łagodniejszy przy odpowiedziach granicznych
A1 <- punktuj(jakosc, 0, 0.30); B1 <- punktuj(jakosc, 0.25, 0.45)
# Etap 2: po szkoleniu i z kluczem zawierającym przykłady odpowiedzi za 0, 1 i 2 punkty
A2 <- punktuj(jakosc, 0, 0.15); B2 <- punktuj(jakosc, 0.05, 0.18)

# Normy (z podręcznika testu): M = 22, SD = 7 punktów; sten = 5.5 + 2z, ograniczony do 1–10
sten <- function(x) pmin(pmax(round(5.5 + 2 * (x - 22) / 7), 1), 10)

ocena <- function(A, B) {
  sA <- rowSums(A); sB <- rowSums(B)
  kw <- cohen.kappa(cbind(as.vector(A), as.vector(B)))           # kappa ważona dla punktów 0–1–2
  icc <- ICC(cbind(sA, sB), lmer = FALSE)$results
  c(zgodnosc_poz = mean(A == B), kappa_wazona = kw$weighted.kappa,
    ICC_A1 = icc["Single_random_raters", "ICC"], ICC_C1 = icc["Single_fixed_raters", "ICC"],
    M_A = mean(sA), M_B = mean(sB), sr_roznica = mean(sB - sA), max_roznica = max(abs(sB - sA)),
    inny_sten = mean(sten(sA) != sten(sB)))
}
round(rbind(przed_szkoleniem = ocena(A1, B1), po_szkoleniu = ocena(A2, B2)), 3)

# Tabela zgodności ocen pozycji przed szkoleniem (wiersze: A, kolumny: B)
table(A = as.vector(A1), B = as.vector(B1))
# Ile protokołów zmieniło sten i o ile
table(roznica_stenow = sten(rowSums(B1)) - sten(rowSums(A1)))
Wynik w R
                 zgodnosc_poz kappa_wazona ICC_A1 ICC_C1    M_A    M_B
przed_szkoleniem        0.813        0.870  0.954  0.975 20.033 22.050
po_szkoleniu            0.921        0.946  0.992  0.993 19.967 20.283
                 sr_roznica max_roznica inny_sten
przed_szkoleniem      2.017           8     0.533
po_szkoleniu          0.317           4     0.183
   B
A     0   1   2
  0 364  77   3
  1  24 195  91
  2   0  29 417
roznica_stenow
-1  0  1  2
 1 28 27  4
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Uznanie testu za obiektywny, bo „ma klucz” – klucz bez przykładów odpowiedzi granicznych zostawia dużo miejsca na interpretację.
- Raportowanie tylko korelacji Pearsona między oceniającymi – nie wykrywa ona stałej różnicy w surowości; potrzebna jest zgodność bezwzględna.
- Ocena zgodności wyłącznie na pozycjach – wysoka kappa nie gwarantuje, że osoba dostanie ten sam sten lub tę samą diagnozę.
- Brak niezależności – drugi oceniający widzi punkty pierwszego i „sprawdza”, zamiast oceniać od nowa.
- Szkolenie po zebraniu danych do analizy zgodności – zgodność badaj na protokołach ocenianych w takich warunkach, w jakich powstały wyniki używane w pracy.
- Jeden badający na jedną grupę – gdy grupę eksperymentalną bada i punktuje jedna osoba, a kontrolną druga, różnica w surowości oceniających miesza się z efektem, który chcesz zbadać. Przydziel badających do obu grup albo punktuj protokoły bez wiedzy o przynależności do grupy.
- Pomijanie obiektywności interpretacji – dwa różne zestawy norm albo różne słowne etykiety tych samych stenów dają różne wnioski z identycznych wyników.
Najczęstsze pytania
Co to jest obiektywność testu psychologicznego?
To niezależność wyniku od osoby badającej: dwie osoby, które niezależnie przeprowadzą, policzą i zinterpretują ten sam test, powinny dojść do tego samego wyniku i wniosku. Wyróżnia się obiektywność przeprowadzania, punktowania i interpretacji.
Czym różni się obiektywność od rzetelności?
Obiektywność dotyczy wpływu osoby badającej, a rzetelność – wszystkich źródeł błędu pomiaru, także tych po stronie osoby badanej i samych pozycji. Niska obiektywność obniża rzetelność, bo różnice między oceniającymi stają się częścią błędu.
Jak sprawdzić obiektywność punktowania?
Niech co najmniej dwie przeszkolone osoby niezależnie przepunktują te same protokoły. Dla pojedynczych odpowiedzi policz procent zgodności i kappę (ważoną przy punktach 0–1–2), dla sumy punktów – ICC w wersji zgodności bezwzględnej, a przy wynikach przeliczanych na normy – odsetek osób, którym rozbieżność zmienia sten.
Czy kwestionariusze samoopisowe są obiektywne?
Pod względem punktowania zwykle tak, bo odpowiedzi zamknięte liczy się według klucza i ryzyko ogranicza się do pomyłek przy wprowadzaniu danych. Obiektywność interpretacji zależy jednak od tego, czy wszyscy korzystają z tych samych norm i progów.
Jaka zgodność oceniających jest wystarczająca?
Nie ma jednej granicy. Według często przywoływanych kryteriów ICC powyżej .90 oznacza doskonałą rzetelność, ale przy diagnozie indywidualnej liczy się też, jak często rozbieżność zmienia kategorię wyniku. W przykładzie z tego hasła ICC = .95 współwystępował ze zmianą stenu u 53% dzieci.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- McHugh, M. L. (2012). Interrater reliability: The kappa statistic. Biochemia Medica, 22(3), 276–282. https://doi.org/10.11613/BM.2012.031 ● Otwarty dostęp
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{mchugh2012interrater, author={McHugh, Mary L.}, title={{Interrater reliability: The kappa statistic}}, journal={Biochemia Medica}, year={2012}, volume={22}, number={3}, pages={276--282}, doi={10.11613/bm.2012.031}}