Jak korzystać z tego poradnika
Rozdział z wynikami sprawia studentom najwięcej kłopotów nie dlatego, że analizy są trudne, ale dlatego, że trzeba je opisać zwięźle, poprawnie i w ustalonym formacie. Ten poradnik zbiera gotowe zdania w stylu APA dla analiz, które najczęściej pojawiają się w pracach z psychologii: od statystyk opisowych, przez testy t, ANOVA i testy nieparametryczne, po regresję, mediację, moderację i rzetelność skal.
Wszystkie liczby pochodzą z jednego zbioru danych przeanalizowanego w R – kod i pełne wydruki znajdziesz w sekcji Kod R. Dzięki temu widzisz, skąd bierze się każda wartość w zdaniu. Każdy wzór możesz skopiować przyciskiem „Kopiuj opis” i podmienić liczby na własne. Jeśli dopiero planujesz badanie, zacznij od poradnika jak napisać rozdział metodologiczny – opisuje on to samo przykładowe badanie od strony metody.
Przykładowe badanie i dane
Sto osiemdziesiąt osób studiujących losowo przydzielono do trzech warunków po 60 osób: grupy kontrolnej, czterotygodniowego treningu relaksacji i czterotygodniowego treningu uważności. Przed treningiem i po nim mierzono stres oraz jakość snu, a dodatkowo wsparcie społeczne, samoskuteczność, dobrostan i to, czy osoba zdała egzamin w pierwszym terminie. Dane są symulowane – wartości są realistyczne, ale nie opisują prawdziwych osób.
| Zmienna | Co mierzy | Skala | Analizy |
|---|---|---|---|
| warunek | kontrola, relaksacja, uważność (po 60 osób) | nominalna | ANOVA, Kruskal–Wallis, chi-kwadrat |
| płeć | kobieta, mężczyzna | nominalna | test Welcha, ANOVA dwuczynnikowa, Mann–Whitney |
| stres przed i po | średnia z 6 pozycji (1–5); pozycje 4 i 5 odwrócone | ilościowa | testy t, ANOVA, korelacje, regresja, mediacja |
| jakość snu przed i po | jedno pytanie (1 = bardzo zła, 5 = bardzo dobra) | porządkowa | Mann–Whitney, Wilcoxon, Kruskal–Wallis, Spearman |
| wsparcie społeczne | średnia pozycji (1–7) | ilościowa | korelacja, regresja, mediacja, moderacja |
| samoskuteczność | suma punktów (10–40) | ilościowa | regresja liniowa i logistyczna, mediacja |
| egzamin | zdany lub niezdany w pierwszym terminie | dychotomiczna | chi-kwadrat, regresja logistyczna |
| dobrostan | średnia pozycji (1–7) | ilościowa | moderacja |
Te same analizy wykonasz w SPSS, jamovi czy JASP. Wyniki będą takie same albo bardzo zbliżone – drobne różnice mogą wynikać z ustawień domyślnych programów (np. poprawki na ciągłość w testach nieparametrycznych) i z losowania w bootstrapie.
Zasady zapisu wyników w stylu APA
Zasady zapisu liczb i statystyk zawiera rozdział 6 podręcznika APA (American Psychological Association, 2020), a w skrócie – bezpłatny przewodnik APA Style po liczbach i statystykach (American Psychological Association, 2024). Najważniejsze reguły zebraliśmy w tabeli:
| Element | Zasada | Przykład |
|---|---|---|
| Symbole statystyczne | Litery łacińskie kursywą (M, SD, t, F, p, r, N, b), greckie bez kursywy (χ², η², α, β, ω) | M = 3.14, SD = 0.82; η² = .10 |
| Zero przed kropką | Pomijamy przy wartościach, które nie mogą przekroczyć 1 (p, r, R², η², α, ω, V); zostawiamy przy pozostałych | p = .027; r = −.38; d = 0.45; β = −0.45 |
| Wartość p | Dokładnie, z dwoma lub trzema miejscami po kropce; poniżej .001 zapis p < .001 | p = .003; p < .001 |
| Zaokrąglenia | Zwykle dwa miejsca po kropce; więcej tylko wtedy, gdy wartość jest bardzo mała | t(179) = 2.23; b = −0.086 |
| Stopnie swobody | W nawiasie po symbolu statystyki | F(2, 177) = 10.09; χ²(2, N = 180) = 3.38 |
| Przedział ufności | Poziom i granice w nawiasie kwadratowym | 95% CI [0.12, 0.60] |
| Wielkość efektu | Przy każdym teście, w miarę możliwości z przedziałem ufności | d = 0.45, 95% CI [0.15, 0.75] |
| Liczby ujemne | Znak minus (−), nie łącznik | r = −.38 |
Kropka czy przecinek? Na metodolog.pl stosujemy kropkę dziesiętną, jak w oryginalnym stylu APA. Wiele polskich wydziałów wymaga jednak przecinka. Obie konwencje są poprawne, jeśli stosujesz je konsekwentnie w całej pracy – w tekście, tabelach i na rysunkach. Przy przecinku sprawdź też, czy uczelnia oczekuje zera przed przecinkiem w wartościach p i r (więcej w części tabel APA o polskich pracach).
Dlaczego wielkość efektu i przedział ufności? Już raport grupy roboczej APA ds. wnioskowania statystycznego – Wilkinson i Task Force on Statistical Inference (1999) – sformułował wytyczne stosowania i raportowania metod statystycznych w czasopismach psychologicznych. Obecne standardy JARS-Quant zalecają podawać dokładne wartości p oraz wielkości efektu z przedziałami ufności dla każdego testu i odróżniać hipotezy główne, poboczne i eksploracyjne (Appelbaum i in., 2018). Cumming (2014) idzie dalej i proponuje, by zamiast samego testowania istotności opierać wnioski na estymacji – wielkościach efektów, przedziałach ufności i metaanalizie. Lakens (2013) pokazuje, jak obliczać i raportować wielkości efektu dla testów t i ANOVA tak, by inni mogli ich użyć w analizie mocy i metaanalizie. Więcej w poradnikach wartość p – interpretacja i wielkość efektu – interpretacja.
Jak zbudować akapit z wynikiem
Każdy wynik, który odpowiada na hipotezę, opisz w tej samej kolejności:
- Cel – jedno zdanie przypominające hipotezę albo pytanie („Aby sprawdzić, czy…”).
- Analiza – nazwa testu i ważne ustawienia (np. test Welcha, sumy kwadratów typu III, korekta Holma).
- Statystyki opisowe porównywanych grup lub zmiennych (M i SD albo mediana i kwartyle).
- Wynik testu – statystyka, stopnie swobody, dokładne p.
- Wielkość efektu z 95% CI.
- Znaczenie – kierunek wyniku w języku badania, bez przesady i bez słów przyczynowych w badaniu korelacyjnym.
Gernsbacher (2018) zaleca pisanie krótkimi akapitami złożonymi z krótkich zdań oraz wyraźne oddzielanie analiz konfirmacyjnych od eksploracyjnych. Analizy, których nie planowałeś, opisz w osobnym podrozdziale (zob. HARKing). Interpretację i porównanie z literaturą zostaw na dyskusję.
Statystyki opisowe i korelacje
Rozdział z wynikami zaczyna się zwykle od opisu próby i statystyk opisowych głównych zmiennych. Przy wielu zmiennych wygodniej podać je w tabeli i w tekście omówić tylko najważniejsze liczby – wzór znajdziesz w haśle tabela statystyk opisowych w APA, a tabelę korelacji w haśle tabela korelacji w APA.
Tabela 1
Statystyki opisowe i korelacje Pearsona między zmiennymi
| Zmienna | M | SD | 1 | 2 | 3 |
|---|---|---|---|---|---|
| 1. Stres przed treningiem | 3.14 | 0.82 | — | ||
| 2. Wsparcie społeczne | 5.13 | 0.98 | −.38 | — | |
| 3. Samoskuteczność | 28.74 | 4.32 | −.53 | .40 | — |
| 4. Dobrostan | 4.34 | 1.04 | −.52 | .38 | .39 |
Uwaga. N = 180. Zakresy skal: stres 1–5, wsparcie społeczne i dobrostan 1–7, samoskuteczność 10–40. Wszystkie korelacje są istotne statystycznie, p < .001.
Testy t
Test t dla jednej próby
Porównuje średnią z wartością odniesienia, np. normą albo środkiem skali (zob. test t dla jednej próby). Podaj średnią z SD, wartość odniesienia, wynik testu i d.
Test t dla prób niezależnych (test Welcha)
Do porównania dwóch grup R domyślnie stosuje test Welcha, który nie zakłada równych wariancji. Delacre i in. (2017) zalecają go jako wybór domyślny w psychologii, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe. Stopnie swobody testu Welcha są ułamkowe – podaj je z dwoma miejscami po kropce. Szczegóły: test t dla prób niezależnych i tabela testu t w APA.
Test t dla prób zależnych
Przy pomiarze przed i po (zob. test t dla prób zależnych) podaj średnie z obu pomiarów, średnią różnicę z przedziałem ufności i wielkość efektu. Napisz, której miary efektu użyłeś: dz (różnica podzielona przez SD różnic) bywa znacznie większe niż d liczone z SD pomiarów, a różne wersje d dla schematów wewnątrzosobowych porównuje Lakens (2013).
ANOVA jednoczynnikowa i dwuczynnikowa
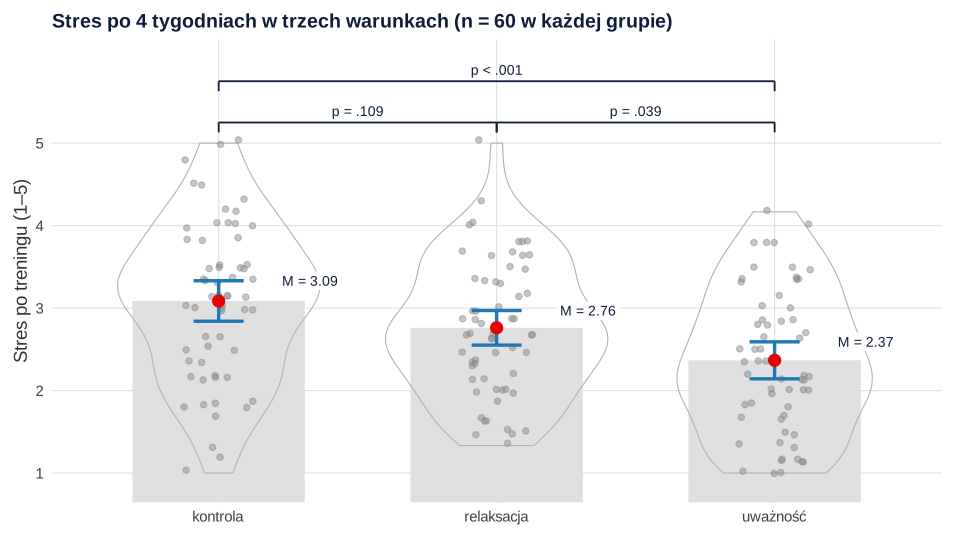
ANOVA jednoczynnikowa z testami post hoc
W jednoczynnikowej analizie wariancji podaj test F z dwiema liczbami stopni swobody, η², wynik sprawdzenia założeń (np. test Levene’a) i porównania post hoc ze średnimi grup. Rysunek 1 pokazuje dane, które opisuje wzór poniżej. W badaniu z pomiarem przed i po często stosuje się też ANCOVA z pomiarem wstępnym jako kowariantem; tu dla prostoty porównujemy wyniki po treningu.
ANOVA dwuczynnikowa: efekty główne i interakcja
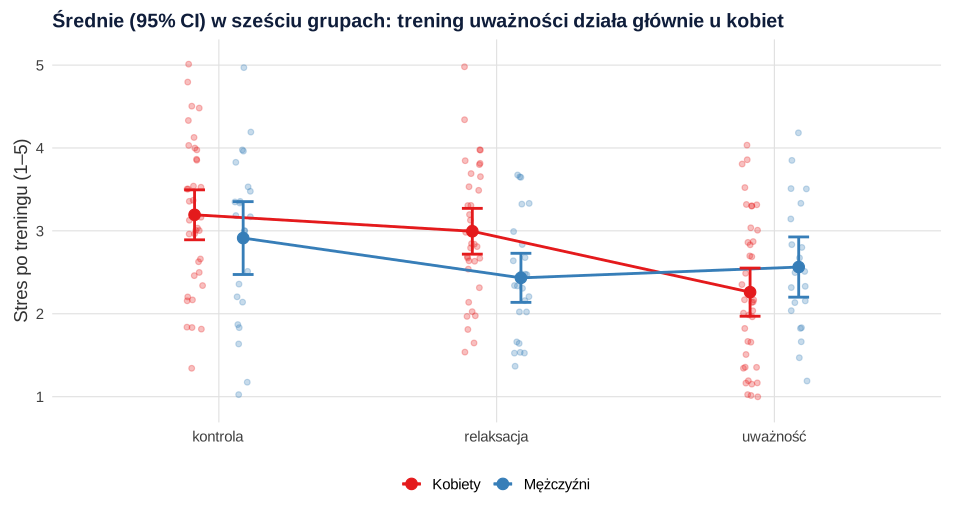
W analizie dwuczynnikowej opisz kolejno oba efekty główne i interakcję, a przy istotnej interakcji – efekty proste, czyli wpływ jednego czynnika na poziomach drugiego. Napisz, jakich sum kwadratów użyłeś (SPSS domyślnie stosuje typ III). Wykres średnich w komórkach (rysunek 2) ułatwia czytelnikowi zrozumienie interakcji. Więcej przykładów w poradniku ANOVA krok po kroku i w haśle tabela ANOVA w APA.
Testy nieparametryczne
Przy zmiennych porządkowych (np. jedno pytanie w skali 1–5) albo przy silnie skośnych rozkładach stosuje się testy nieparametryczne. Zamiast średnich podaj medianę z kwartylami (Q1–Q3). Jako wielkość efektu użyliśmy korelacji rangowo-dwuseryjnej rrb i ε². SPSS zamiast statystyki W lub V podaje często U i Z – wtedy przepisz te wartości.
Test Manna–Whitneya
Porównanie dwóch grup niezależnych (zob. test Manna–Whitneya). Statystyka W z R to U dla pierwszej grupy.
Test Wilcoxona dla prób zależnych
Porównanie dwóch pomiarów tych samych osób (zob. test Wilcoxona).
Test Kruskala–Wallisa
Porównanie trzech lub więcej grup (zob. test Kruskala–Wallisa). Przy istotnym wyniku dodaj porównania post hoc, np. test Dunna z korektą Holma.
Test chi-kwadrat niezależności
Przy dwóch zmiennych jakościowych podaj odsetki w grupach, statystykę χ² ze stopniami swobody i liczebnością próby oraz V Craméra. Sprawdź, czy liczebności oczekiwane są wystarczające – w naszym przykładzie wynosiły 15 i 45 w każdej komórce. Zasady i kalkulator znajdziesz w hasłach test chi-kwadrat niezależności i tabela krzyżowa. Ten przykład pokazuje też, jak opisać wynik nieistotny.
Korelacja Pearsona i Spearmana
Przy korelacji podaj współczynnik ze stopniami swobody (N − 2), przedział ufności i p, a potem jednym zdaniem opisz kierunek związku. Korelację Pearsona stosuj przy zmiennych ilościowych, korelację Spearmana – przy porządkowych.
Regresja liniowa i logistyczna
Regresja liniowa
W regresji liniowej opisz najpierw cały model (F, p, R²), a potem każdy predyktor: współczynnik niestandaryzowany b z błędem standardowym i 95% CI, współczynnik standaryzowany β, t i p. Przy wielu predyktorach przygotuj tabelę regresji w APA.
Regresja logistyczna
W regresji logistycznej podaj test całego modelu (χ² względem modelu bez predyktorów), pseudo-R² i dla każdego predyktora iloraz szans z 95% CI. Interpretuj szanse, a nie prawdopodobieństwo. Wzór tabeli: tabela regresji logistycznej w APA.
Mediacja i moderacja
Mediacja
W analizie mediacji najważniejszy jest efekt pośredni (ab) z przedziałem ufności z bootstrapu. Rucker i in. (2011) przekonują, że ocenianie mediacji po tym, czy związek X–Y przestaje być istotny po dodaniu mediatora, jest nieuzasadnione – uwagę należy skupić na wielkości i istotności efektu pośredniego. Dlatego nie piszemy o mediacji „pełnej” czy „częściowej”. Pamiętaj też, że w badaniu przekrojowym mediacja opisuje układ związków, a nie dowiedziony mechanizm przyczynowy. Wzór tabeli: tabela mediacji w APA.
Moderacja
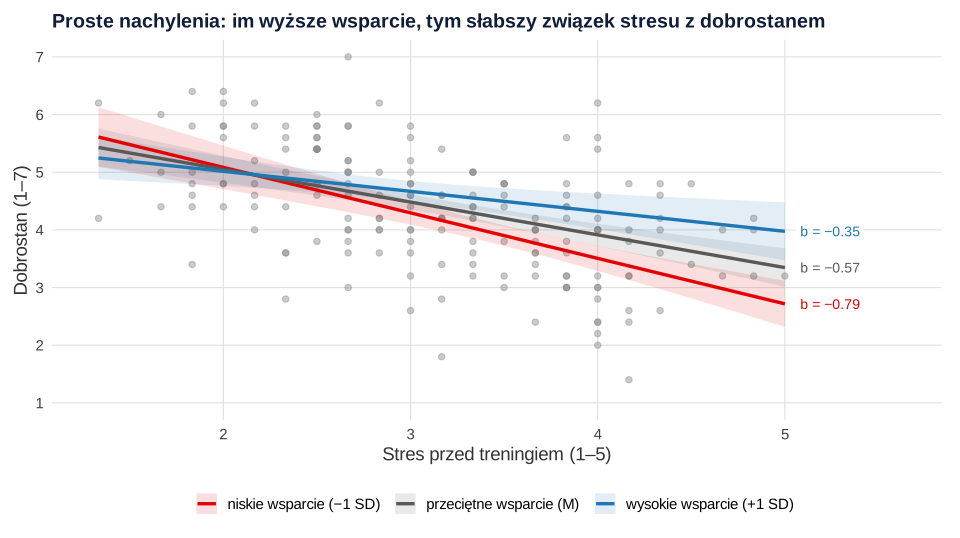
W analizie moderacji podaj model z interakcją (predyktory wycentrowane), współczynnik interakcji z 95% CI, przyrost ΔR² oraz proste nachylenia na wybranych poziomach moderatora (zwykle −1 SD, średnia, +1 SD). Rysunek 3 pokazuje te nachylenia. Krok po kroku – z wykresem Johnsona–Neymana – opisuje to poradnik analiza moderacji krok po kroku.
Rzetelność skal: alfa i omega
Rzetelność podaje się zwykle w podrozdziale o narzędziach albo na początku wyników – dla wyników uzyskanych w Twojej próbie. Oprócz alfy Cronbacha coraz częściej raportuje się omegę McDonalda. Flora (2020) pokazuje, że istnieje kilka wersji omegi, a właściwą wybiera się na podstawie modelu CFA mierzonego konstruktu – w przykładzie użyliśmy modelu jednoczynnikowego. Więcej: tabela rzetelności skal w APA i wzór raportowania alfy Cronbacha.
Jak opisać wynik nieistotny
Wynik nieistotny opisz tak samo dokładnie jak istotny: z opisowymi, statystyką testu, p, wielkością efektu i przedziałem ufności. Wasserstein i Lazar (2016) przypominają, że wartość p nie mierzy prawdopodobieństwa prawdziwości hipotezy ani wielkości efektu, a wnioski nie powinny zależeć wyłącznie od przekroczenia progu istotności. Brak istotności nie oznacza więc, że efektu nie ma – to jeden z błędów interpretacyjnych opisanych przez Greenlanda i in. (2016). Przedział ufności pokazuje, jakie wartości efektu są zgodne z danymi:
Jeśli chcesz wykazać brak efektu, potrzebujesz innego narzędzia – testu równoważności albo czynnika Bayesa.
Czego nie pisać
Poniższe sformułowania często pojawiają się w pracach dyplomowych, ale są błędne albo mylące:
| Nie pisz | Dlaczego | Napisz zamiast tego |
|---|---|---|
| „Wynik był prawie istotny” / „wykazywał tendencję do istotności” (p = .06) | Wynik jest istotny albo nie; nieistotny wynik nie „zmierza” do istotności | „Różnica nie była istotna statystycznie, p = .06; przedział ufności obejmuje zarówno brak różnicy, jak i efekt umiarkowany” |
| „Udowodniono, że trening obniża stres” | Jedno badanie nie dowodzi; statystyka opisuje niepewność | „Osoby po treningu miały niższy stres”; „wynik jest zgodny z hipotezą” |
| „p = .000” | Program zaokrąglił bardzo małą wartość; p nie jest równe zeru | „p < .001” |
| „p < .05” przy każdym wyniku | APA zaleca dokładne wartości p (American Psychological Association, 2024) | „p = .027” |
| „Wynik wysoce istotny, więc efekt jest silny” | Wartość p nie mierzy wielkości efektu (Wasserstein i Lazar, 2016) | Podaj d, η² albo r z 95% CI i oceń ich znaczenie |
| „Brak istotnej różnicy dowodzi, że grupy są takie same” | Brak dowodu różnicy to nie dowód braku różnicy (Greenland i in., 2016) | „Nie wykazano różnicy”; jeśli to cel badania – test równoważności |
| „Z prawdopodobieństwem 95% prawdziwa średnia leży w przedziale [3.02, 3.26]” | Częsta, ale błędna interpretacja przedziału ufności (Hoekstra i in., 2014) | „M = 3.14, 95% CI [3.02, 3.26]” – przedział pokazuje wartości zgodne z danymi przy przyjętej procedurze |
| „Wsparcie powoduje spadek stresu” w badaniu korelacyjnym | Korelacja nie pokazuje kierunku przyczynowego | „Wsparcie wiązało się z niższym stresem” |
| Zero przed kropką przy p, r, α, η² albo kilka konwencji w jednej pracy | Niezgodne z APA; niespójność wygląda niechlujnie | „p = .027, r = −.38” – jedna konwencja w całej pracy |
| Nazwy z wydruku: „Sig.”, „Asymp. Sig. (2-tailed)”, „Std. Error” | To etykiety programu, nie symbole APA | p, SE, a w tekście pełne nazwy testów |
Hoekstra i in. (2014) pokazali, że zarówno badacze (120 osób), jak i studenci psychologii (442 osoby) akceptowali średnio ponad trzy z sześciu fałszywych interpretacji przedziału ufności, a deklarowane doświadczenie statystyczne badaczy nie wiązało się z lepszymi odpowiedziami. Warto więc pisać o przedziałach ostrożnie.
Kod R
Wszystkie analizy z poradnika pochodzą z poniższego kodu. Kroki korzystają z obiektów utworzonych wcześniej, więc uruchamiaj je po kolei. Wydruki są schowane – rozwiń „Wynik w R”, aby porównać liczby z gotowymi zdaniami.
Krok 1. Dane
R
# Badanie (dane symulowane): 180 studentów losowo przydzielonych do trzech warunków
# (kontrola, trening relaksacji, trening uważności); pomiar stresu przed i po 4 tygodniach.
set.seed(443)
N <- 180
dane <- data.frame(
  id      = 1:N,
  warunek = factor(rep(c("kontrola", "relaksacja", "uważność"), each = 60),
                   levels = c("kontrola", "relaksacja", "uważność")),
  plec    = factor(sample(c("kobieta", "mężczyzna"), N, replace = TRUE, prob = c(.6, .4))),
  wiek    = pmin(pmax(round(rnorm(N, 21.5, 1.7)), 19), 27))
# wsparcie społeczne (średnia pozycji, 1–7) i samoskuteczność (suma, 10–40)
dane$wsparcie <- round(pmin(pmax(rnorm(N, 5.2, 1), 1), 7) * 12) / 12
dane$samoskutecznosc <- pmin(pmax(round(29 + 1.6 * (dane$wsparcie - 5.2) + rnorm(N, 0, 4)), 10), 40)
# sześć pozycji skali stresu (1–5); pozycje s4 i s5 są w kwestionariuszu sformułowane odwrotnie
eta <- -0.25 * scale(dane$wsparcie)[, 1] - 0.35 * scale(dane$samoskutecznosc)[, 1] +
  0.35 * (dane$plec == "kobieta") + rnorm(N, 0, 0.75)
lam <- c(0.9, 0.8, 0.85, 0.7, 0.75, 0.9)
for (j in 1:6) dane[[paste0("s", j)]] <- pmin(pmax(round(3 + lam[j] * eta + rnorm(N, 0, 0.75)), 1), 5)
dane$s4 <- 6 - dane$s4; dane$s5 <- 6 - dane$s5      # tak wyglądają surowe odpowiedzi w arkuszu
# wynik skali przed treningiem (po rekodowaniu pozycji odwróconych)
dane$stres_pre <- rowMeans(cbind(dane[, c("s1", "s2", "s3", "s6")], 6 - dane$s4, 6 - dane$s5))
# stres po 4 tygodniach: efekt treningu zależy od warunku (i w grupie uważności – od płci)
efekt <- with(dane, ifelse(warunek == "kontrola", -0.05, ifelse(warunek == "relaksacja", -0.30,
                                                             ifelse(plec == "kobieta", -0.90, -0.30))))
dane$stres_post <- pmin(pmax(round((dane$stres_pre + efekt + rnorm(N, 0, 0.4)) * 6) / 6, 1), 5)
# jakość snu (1 = bardzo zła … 5 = bardzo dobra) przed i po treningu
sen <- -0.55 * scale(dane$stres_pre)[, 1] + rnorm(N, 0, 0.85)
progi <- c(-Inf, -1.3, -0.45, 0.45, 1.3, Inf)
dane$sen_pre  <- as.integer(cut(sen, progi))
dane$sen_post <- as.integer(cut(sen + c(0, 0.3, 0.9)[dane$warunek] + rnorm(N, 0, 1.1), progi))
# zdany egzamin w pierwszym terminie i dobrostan (średnia, 1–7)
dane$egzamin <- factor(rbinom(N, 1, plogis(1.25 - 1.1 * (dane$stres_post - mean(dane$stres_post)) +
                                             0.07 * (dane$samoskutecznosc - 29))),
                       levels = 0:1, labels = c("niezdany", "zdany"))
sc <- dane$stres_pre - mean(dane$stres_pre); wc <- dane$wsparcie - mean(dane$wsparcie)
dane$dobrostan <- pmin(pmax(round((4.5 - 0.65 * sc + 0.30 * wc + 0.30 * sc * wc + rnorm(N, 0, 0.8)) * 5) / 5, 1), 7)
str(dane[, c("warunek", "plec", "wiek", "stres_pre", "stres_post", "sen_pre", "egzamin", "dobrostan")])
Wynik w R
'data.frame':	180 obs. of  8 variables:
 $ warunek   : Factor w/ 3 levels "kontrola","relaksacja",..: 1 1 1 1 1 1 1 1 1 1 ...
 $ plec      : Factor w/ 2 levels "kobieta","mężczyzna": 2 2 2 2 1 1 1 2 2 2 ...
 $ wiek      : num  22 22 21 24 21 23 21 22 20 22 ...
 $ stres_pre : num  4.17 2.33 1.83 2.17 4 ...
 $ stres_post: num  3.5 1.17 1.83 2.33 3.83 ...
 $ sen_pre   : int  2 4 4 4 3 2 2 2 2 3 ...
 $ egzamin   : Factor w/ 2 levels "niezdany","zdany": 2 2 1 2 1 2 1 2 2 2 ...
 $ dobrostan : num  3.2 5 5.8 4.8 4.2 2.4 4.6 4.4 3.8 3 ...
Krok 2. Statystyki opisowe i korelacje
R
library(psych)
table(dane$plec)
round(prop.table(table(dane$plec)) * 100, 1)
round(c(M_wiek = mean(dane$wiek), SD_wiek = sd(dane$wiek), min = min(dane$wiek), max = max(dane$wiek)), 2)
zmienne <- c("stres_pre", "wsparcie", "samoskutecznosc", "dobrostan")
round(describe(dane[, zmienne])[, c("n", "mean", "sd", "min", "max", "skew", "kurtosis")], 2)
kor <- corr.test(dane[, zmienne])
round(kor$r, 2)
max(kor$p)                       # największa wartość p spośród wszystkich par
Wynik w R
  kobieta mężczyzna
      111        69

  kobieta mężczyzna
     61.7      38.3
 M_wiek SD_wiek     min     max
  21.49    1.60   19.00   26.00
                  n  mean   sd   min max  skew kurtosis
stres_pre       180  3.14 0.82  1.33   5  0.00    -0.81
wsparcie        180  5.13 0.98  2.42   7 -0.20    -0.25
samoskutecznosc 180 28.74 4.32 19.00  40 -0.01    -0.37
dobrostan       180  4.34 1.04  1.40   7 -0.11    -0.30
                stres_pre wsparcie samoskutecznosc dobrostan
stres_pre            1.00    -0.38           -0.53     -0.52
wsparcie            -0.38     1.00            0.40      0.38
samoskutecznosc     -0.53     0.40            1.00      0.39
dobrostan           -0.52     0.38            0.39      1.00
[1] 2.72186e-07
Krok 3. Testy t
R
library(effectsize)
# (a) czy stres przed treningiem różni się od środka skali (3)?
t.test(dane$stres_pre, mu = 3)
cohens_d(dane$stres_pre, mu = 3)
# (b) kobiety i mężczyźni – test t Welcha (domyślny w R)
aggregate(stres_pre ~ plec, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
t.test(stres_pre ~ plec, data = dane)
cohens_d(stres_pre ~ plec, data = dane)
# (c) stres przed i po treningu w grupie uważności – test t dla prób zależnych
u <- subset(dane, warunek == "uważność")
round(c(M_pre = mean(u$stres_pre), SD_pre = sd(u$stres_pre),
        M_post = mean(u$stres_post), SD_post = sd(u$stres_post)), 2)
t.test(u$stres_pre, u$stres_post, paired = TRUE)
repeated_measures_d(u$stres_pre, u$stres_post, method = "z", adjust = FALSE)   # d_z
Wynik w R
	One Sample t-test

data:  dane$stres_pre
t = 2.2301, df = 179, p-value = 0.02699
alternative hypothesis: true mean is not equal to 3
95 percent confidence interval:
 3.015671 3.256551
sample estimates:
mean of x
 3.136111

Cohen's d |       95% CI
------------------------
0.17      | [0.02, 0.31]

- Deviation from a difference of 3.
       plec stres_pre.M stres_pre.SD stres_pre.n
1   kobieta        3.27         0.82      111.00
2 mężczyzna        2.91         0.77       69.00

	Welch Two Sample t-test

data:  stres_pre by plec
t = 2.9931, df = 152.27, p-value = 0.003223
alternative hypothesis: true difference in means between group kobieta and group mężczyzna is not equal to 0
95 percent confidence interval:
 0.1229626 0.6005000
sample estimates:
  mean in group kobieta mean in group mężczyzna
               3.274775                2.913043

Cohen's d |       95% CI
------------------------
0.45      | [0.15, 0.75]

- Estimated using pooled SD.
  M_pre  SD_pre  M_post SD_post
   3.12    0.85    2.37    0.87

	Paired t-test

data:  u$stres_pre and u$stres_post
t = 11.796, df = 59, p-value < 2.2e-16
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.6250839 0.8804716
sample estimates:
mean difference
      0.7527778

d (z) |       95% CI
--------------------
1.52  | [1.15, 1.89]
Krok 4. ANOVA
R
library(car)
library(emmeans)
aggregate(stres_post ~ warunek, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
leveneTest(stres_post ~ warunek, data = dane, center = mean)
anova1 <- aov(stres_post ~ warunek, data = dane)
summary(anova1)
eta_squared(anova1, ci = NULL)
TukeyHSD(anova1)
# ANOVA dwuczynnikowa: warunek × płeć (sumy kwadratów typu III, jak w SPSS)
options(contrasts = c("contr.sum", "contr.poly"))
aggregate(stres_post ~ warunek + plec, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
model2 <- lm(stres_post ~ warunek * plec, data = dane)
Anova(model2, type = 3)
eta_squared(Anova(model2, type = 3), partial = TRUE, ci = NULL)
joint_tests(model2, by = "plec")                       # efekty proste warunku w każdej płci
pairs(emmeans(model2, ~ warunek | plec), adjust = "tukey")
Wynik w R
     warunek stres_post.M stres_post.SD
1   kontrola         3.09          0.95
2 relaksacja         2.76          0.81
3   uważność         2.37          0.87
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   2  0.6423 0.5273
      177
             Df Sum Sq Mean Sq F value  Pr(>F)
warunek       2  15.58   7.788   10.09 7.1e-05 ***
Residuals   177 136.65   0.772
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA

Parameter | Eta2
----------------
warunek   | 0.10
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = stres_post ~ warunek, data = dane)

$warunek
                          diff        lwr         upr     p adj
relaksacja-kontrola -0.3250000 -0.7041643  0.05416435 0.1089813
uważność-kontrola   -0.7194444 -1.0986088 -0.34028010 0.0000388
uważność-relaksacja -0.3944444 -0.7736088 -0.01528010 0.0393566

     warunek      plec stres_post.M stres_post.SD stres_post.n
1   kontrola   kobieta         3.19          0.90        37.00
2 relaksacja   kobieta         3.00          0.80        35.00
3   uważność   kobieta         2.26          0.90        39.00
4   kontrola mężczyzna         2.91          1.02        23.00
5 relaksacja mężczyzna         2.43          0.72        25.00
6   uważność mężczyzna         2.56          0.80        21.00
Anova Table (Type III tests)

Response: stres_post
              Sum Sq  Df   F value    Pr(>F)
(Intercept)  1260.42   1 1691.2541 < 2.2e-16 ***
warunek        11.47   2    7.6921 0.0006293 ***
plec            1.37   1    1.8410 0.1765935
warunek:plec    5.45   2    3.6556 0.0278521 *
Residuals     129.67 174
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type III)

Parameter    | Eta2 (partial)
-----------------------------
warunek      |           0.08
plec         |           0.01
warunek:plec |           0.04
plec = kobieta:
 model term df1 df2 F.ratio p.value
 warunek      2 174  12.352 <0.0001

plec = mężczyzna:
 model term df1 df2 F.ratio p.value
 warunek      2 174   1.947  0.1458

plec = kobieta:
 contrast              estimate    SE  df t.ratio p.value
 kontrola - relaksacja    0.198 0.204 174   0.975  0.5937
 kontrola - uważność      0.933 0.198 174   4.709 <0.0001
 relaksacja - uważność    0.735 0.201 174   3.654  0.0010

plec = mężczyzna:
 contrast              estimate    SE  df t.ratio p.value
 kontrola - relaksacja    0.480 0.249 174   1.923  0.1352
 kontrola - uważność      0.350 0.261 174   1.342  0.3742
 relaksacja - uważność   -0.130 0.256 174  -0.509  0.8669

P value adjustment: tukey method for comparing a family of 3 estimates
Krok 5. Testy nieparametryczne
R
mediana_iqr <- function(x) c(Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)))
# (a) Mann–Whitney: jakość snu przed treningiem u kobiet i mężczyzn
aggregate(sen_pre ~ plec, data = dane, FUN = mediana_iqr)
wilcox.test(sen_pre ~ plec, data = dane, exact = FALSE)
rank_biserial(sen_pre ~ plec, data = dane)
# (b) Wilcoxon: jakość snu przed i po treningu w grupie uważności
rbind(przed = mediana_iqr(u$sen_pre), po = mediana_iqr(u$sen_post))
wilcox.test(u$sen_post, u$sen_pre, paired = TRUE, exact = FALSE)
rank_biserial(u$sen_post, u$sen_pre, paired = TRUE)
# (c) Kruskal–Wallis: jakość snu po treningu w trzech warunkach
aggregate(sen_post ~ warunek, data = dane, FUN = mediana_iqr)
kruskal.test(sen_post ~ warunek, data = dane)
rank_epsilon_squared(sen_post ~ warunek, data = dane, ci = NULL)
rstatix::dunn_test(dane, sen_post ~ warunek, p.adjust.method = "holm")[, c("group1", "group2", "statistic", "p", "p.adj")]
Wynik w R
       plec sen_pre.Me sen_pre.Q1 sen_pre.Q3
1   kobieta          3          2          4
2 mężczyzna          3          2          4

	Wilcoxon rank sum test with continuity correction

data:  sen_pre by plec
W = 3345.5, p-value = 0.1406
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |        95% CI
---------------------------------
-0.13             | [-0.29, 0.05]
      Me Q1 Q3
przed  3  2  4
po     4  3  5

	Wilcoxon signed rank test with continuity correction

data:  u$sen_post and u$sen_pre
V = 743, p-value = 4.904e-06
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.81              | [0.69, 0.89]
     warunek sen_post.Me sen_post.Q1 sen_post.Q3
1   kontrola        3.00        2.00        4.25
2 relaksacja        3.00        2.00        4.00
3   uważność        4.00        3.00        5.00

	Kruskal-Wallis rank sum test

data:  sen_post by warunek
Kruskal-Wallis chi-squared = 11.14, df = 2, p-value = 0.00381

Epsilon2 (rank)
---------------
0.06
# A tibble: 3 × 5
  group1     group2     statistic       p   p.adj
  <chr>      <chr>          <dbl>   <dbl>   <dbl>
1 kontrola   relaksacja    -0.343 0.732   0.732
2 kontrola   uważność       2.70  0.00686 0.0137
3 relaksacja uważność       3.05  0.00231 0.00694
Krok 6. Chi-kwadrat
R
tab <- table(dane$warunek, dane$egzamin)
tab
round(prop.table(tab, margin = 1) * 100, 1)
chi <- chisq.test(tab)
chi
round(chi$expected, 1)
unname(sqrt(chi$statistic / (sum(tab) * (min(dim(tab)) - 1))))   # V Craméra
Wynik w R
             niezdany zdany
  kontrola         17    43
  relaksacja       18    42
  uważność         10    50

             niezdany zdany
  kontrola       28.3  71.7
  relaksacja     30.0  70.0
  uważność       16.7  83.3

	Pearson's Chi-squared test

data:  tab
X-squared = 3.3778, df = 2, p-value = 0.1847


             niezdany zdany
  kontrola         15    45
  relaksacja       15    45
  uważność         15    45
[1] 0.136987
Krok 7. Korelacje
R
cor.test(dane$wsparcie, dane$stres_pre)
cor.test(dane$sen_pre, dane$stres_pre, method = "spearman", exact = FALSE)
Wynik w R
	Pearson's product-moment correlation

data:  dane$wsparcie and dane$stres_pre
t = -5.4071, df = 178, p-value = 2.04e-07
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.4946897 -0.2426714
sample estimates:
       cor
-0.3756031


	Spearman's rank correlation rho

data:  dane$sen_pre and dane$stres_pre
S = 1481727, p-value = 4.143e-14
alternative hypothesis: true rho is not equal to 0
sample estimates:
       rho
-0.5244581
Krok 8. Regresja liniowa i logistyczna
R
model_r <- lm(stres_pre ~ wsparcie + samoskutecznosc, data = dane)
summary(model_r)
round(confint(model_r), 3)
standardize_parameters(model_r)
# regresja logistyczna: zdany egzamin w pierwszym terminie
model_l <- glm(egzamin ~ stres_post + samoskutecznosc, data = dane, family = binomial)
summary(model_l)
round(exp(cbind(OR = coef(model_l), confint(model_l))), 2)
anova(update(model_l, . ~ 1), model_l, test = "Chisq")
performance::r2_nagelkerke(model_l)
mean(dane$egzamin == "zdany")
Wynik w R
Call:
lm(formula = stres_pre ~ wsparcie + samoskutecznosc, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-1.73478 -0.50957 -0.00514  0.50974  1.61328

Coefficients:
                Estimate Std. Error t value Pr(>|t|)
(Intercept)      6.44067    0.37093  17.364  < 2e-16 ***
wsparcie        -0.16195    0.05658  -2.862  0.00471 **
samoskutecznosc -0.08610    0.01285  -6.701 2.66e-10 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.6816 on 177 degrees of freedom
Multiple R-squared:  0.3149,	Adjusted R-squared:  0.3071
F-statistic: 40.68 on 2 and 177 DF,  p-value: 2.917e-15

                 2.5 % 97.5 %
(Intercept)      5.709  7.173
wsparcie        -0.274 -0.050
samoskutecznosc -0.111 -0.061
# Standardization method: refit

Parameter       | Std. Coef. |         95% CI
---------------------------------------------
(Intercept)     |   2.87e-16 | [-0.12,  0.12]
wsparcie        |      -0.19 | [-0.33, -0.06]
samoskutecznosc |      -0.45 | [-0.59, -0.32]

Call:
glm(formula = egzamin ~ stres_post + samoskutecznosc, family = binomial,
    data = dane)

Coefficients:
                Estimate Std. Error z value Pr(>|z|)
(Intercept)      0.72875    1.92515   0.379 0.705029
stres_post      -0.99182    0.26596  -3.729 0.000192 ***
samoskutecznosc  0.11885    0.05325   2.232 0.025623 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 202.44  on 179  degrees of freedom
Residual deviance: 163.46  on 177  degrees of freedom
AIC: 169.46

Number of Fisher Scoring iterations: 5

                  OR 2.5 % 97.5 %
(Intercept)     2.07  0.05  94.94
stres_post      0.37  0.21   0.61
samoskutecznosc 1.13  1.02   1.25
Analysis of Deviance Table

Model 1: egzamin ~ 1
Model 2: egzamin ~ stres_post + samoskutecznosc
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       179     202.44
2       177     163.47  2   38.976 3.439e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Nagelkerke's R2
      0.2883341
[1] 0.75
Krok 9. Mediacja i moderacja
R
# mediacja: wsparcie → samoskuteczność → stres (regresje MNK i bootstrap percentylowy, jak w PROCESS, model 4)
m_a <- lm(samoskutecznosc ~ wsparcie, data = dane)               # ścieżka a
m_b <- lm(stres_pre ~ samoskutecznosc + wsparcie, data = dane)   # ścieżki b i c' (efekt bezpośredni)
m_c <- lm(stres_pre ~ wsparcie, data = dane)                     # efekt całkowity c
round(rbind(a      = summary(m_a)$coefficients["wsparcie", ],
            b      = summary(m_b)$coefficients["samoskutecznosc", ],
            c_prim = summary(m_b)$coefficients["wsparcie", ],
            c      = summary(m_c)$coefficients["wsparcie", ]), 3)
library(boot)
efekt_ab <- function(d, i) coef(lm(samoskutecznosc ~ wsparcie, data = d[i, ]))[["wsparcie"]] *
  coef(lm(stres_pre ~ samoskutecznosc + wsparcie, data = d[i, ]))[["samoskutecznosc"]]
set.seed(2026)
bt <- boot(dane, efekt_ab, R = 5000)
bt$t0                                   # efekt pośredni a × b
boot.ci(bt, type = "perc")              # 95% przedział bootstrapowy (percentylowy)
# moderacja: czy wsparcie łagodzi związek stresu z dobrostanem?
library(interactions)
dane$stres_c    <- dane$stres_pre - mean(dane$stres_pre)
dane$wsparcie_c <- dane$wsparcie - mean(dane$wsparcie)
model_0   <- lm(dobrostan ~ stres_c + wsparcie_c, data = dane)
model_mod <- lm(dobrostan ~ stres_c * wsparcie_c, data = dane)
summary(model_mod)
anova(model_0, model_mod)
summary(model_mod)$r.squared - summary(model_0)$r.squared      # ΔR² dla interakcji
round(confint(model_mod), 3)
sim_slopes(model_mod, pred = stres_c, modx = wsparcie_c, johnson_neyman = FALSE, digits = 3)
Wynik w R
       Estimate Std. Error t value Pr(>|t|)
a         1.757      0.303   5.805    0.000
b        -0.086      0.013  -6.701    0.000
c_prim   -0.162      0.057  -2.862    0.005
c        -0.313      0.058  -5.407    0.000
[1] -0.1512763
BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
Based on 5000 bootstrap replicates

CALL :
boot.ci(boot.out = bt, type = "perc")

Intervals :
Level     Percentile
95%   (-0.2179, -0.0925 )
Calculations and Intervals on Original Scale

Call:
lm(formula = dobrostan ~ stres_c * wsparcie_c, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-2.71016 -0.56532  0.03564  0.61755  2.11333

Coefficients:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)         4.40429    0.06740  65.349  < 2e-16 ***
stres_c            -0.56800    0.08364  -6.791 1.65e-10 ***
wsparcie_c          0.22079    0.06966   3.169  0.00180 **
stres_c:wsparcie_c  0.22517    0.07811   2.883  0.00443 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.8477 on 176 degrees of freedom
Multiple R-squared:  0.3406,	Adjusted R-squared:  0.3294
F-statistic: 30.31 on 3 and 176 DF,  p-value: 7.586e-16

Analysis of Variance Table

Model 1: dobrostan ~ stres_c + wsparcie_c
Model 2: dobrostan ~ stres_c * wsparcie_c
  Res.Df    RSS Df Sum of Sq      F   Pr(>F)
1    177 132.44
2    176 126.46  1    5.9714 8.3104 0.004433 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 0.03113373
                    2.5 % 97.5 %
(Intercept)         4.271  4.537
stres_c            -0.733 -0.403
wsparcie_c          0.083  0.358
stres_c:wsparcie_c  0.071  0.379
SIMPLE SLOPES ANALYSIS

Slope of stres_c when wsparcie_c = -9.819324e-01 (- 1 SD):

    Est.    S.E.   t val.       p
-------- ------- -------- -------
  -0.789   0.117   -6.754   0.000

Slope of stres_c when wsparcie_c = -3.602057e-16 (Mean):

    Est.    S.E.   t val.       p
-------- ------- -------- -------
  -0.568   0.084   -6.791   0.000

Slope of stres_c when wsparcie_c =  9.819324e-01 (+ 1 SD):

    Est.    S.E.   t val.       p
-------- ------- -------- -------
  -0.347   0.110   -3.153   0.002
Krok 10. Rzetelność
R
library(lavaan)
library(semTools)
pozycje <- dane[, paste0("s", 1:6)]
pozycje$s4 <- 6 - pozycje$s4; pozycje$s5 <- 6 - pozycje$s5   # rekodowanie pozycji odwróconych
round(alpha(pozycje)$total, 3)
fit_cfa <- cfa("stres =~ s1 + s2 + s3 + s4 + s5 + s6", data = pozycje)
compRelSEM(fit_cfa)                                          # omega
Wynik w R
 raw_alpha std.alpha G6(smc) average_r   S/N   ase  mean    sd median_r
     0.854     0.853   0.832     0.491 5.798 0.017 3.136 0.819    0.486
$stres

Composite `stres` is composed of observed variables:
	s1, s2, s3, s4, s5, s6
True-score variance is represented by common factor(s):
	stres
Total variance of composite `stres` determined from the unrestricted model.
The proportion attributable to "true" scores is its model-based estimate of reliability ("omega"):

[1] 0.856
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.3) [Computer software]. https://doi.org/10.32614/CRAN.package.rstatix
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- interactions (wersja 1.2.0): Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions (R package version 1.2.0) [Computer software]. https://doi.org/10.32614/CRAN.package.interactions
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Lista kontrolna przed oddaniem rozdziału
- Każda hipoteza ma własny akapit: cel, analiza, statystyki opisowe, wynik testu, wielkość efektu z 95% CI i jedno zdanie interpretacji.
- Wartości p są dokładne; zapis p < .001 tylko dla mniejszych wartości; nigdzie nie ma „p = .000”.
- W całej pracy jedna konwencja: kropka albo przecinek, ta sama liczba miejsc po przecinku, zero wiodące zgodnie z zasadami.
- Symbole statystyczne są zapisane kursywą (w Wordzie), a minus to znak „−”.
- Opisano sprawdzenie założeń i ewentualne odstępstwa od planu analiz.
- Wyniki nieistotne opisano równie dokładnie jak istotne.
- Analizy nieplanowane są w osobnym podrozdziale i oznaczone jako eksploracyjne.
- Tabele i rysunki są ponumerowane, przywołane w tekście i nie powtarzają tych samych liczb co tekst (zob. tabele APA – wzory i przykłady).
- W badaniu korelacyjnym nie ma słów „wpływa”, „powoduje”, „determinuje”.
- Program i wersję (R, SPSS, JASP) podano w rozdziale metodologicznym, a pakiety – w bibliografii oprogramowania.
Ogólne zasady APA dla metody i wyników omawiamy we wpisie wytyczne APA dla metodologii i raportowania statystyki. Jeśli potrzebujesz kogoś, kto sprawdzi analizy i opis wyników przed oddaniem pracy, zobacz analizy statystyczne dla studentów.
Najczęstsze pytania
Jak opisać wyniki w pracy magisterskiej?
Dla każdej hipotezy napisz osobny akapit: cel analizy, nazwę testu, statystyki opisowe grup, wynik testu (statystyka, stopnie swobody, dokładne p), wielkość efektu z 95% przedziałem ufności i jedno zdanie interpretacji. Interpretację w świetle literatury zostaw na dyskusję.
Jak zapisać wynik testu t w APA?
Podaj średnie i odchylenia standardowe grup, a potem wynik testu, np. „t(152.27) = 2.99, p = .003, d = 0.45, 95% CI [0.15, 0.75]”. Symbole t, p i d zapisz kursywą, a stopnie swobody umieść w nawiasie.
Czy w APA pisze się zero przed przecinkiem?
Zero pomija się przy wartościach, które nie mogą przekroczyć 1, np. p = .027, r = −.38, α = .85. Przy pozostałych zostaje: M = 3.14, d = 0.45. Jeśli uczelnia wymaga przecinka dziesiętnego, stosuj go konsekwentnie i sprawdź jej wytyczne dotyczące zera.
Jak zapisać p = 0,000 z SPSS?
Wartość p nie może wynosić zero – program tylko zaokrąglił bardzo małą liczbę. Zapisz „p < .001”. Pozostałe wartości podawaj dokładnie, z dwoma lub trzema miejscami po przecinku (np. p = .027).
Jak opisać wynik nieistotny statystycznie?
Tak samo dokładnie jak istotny: podaj statystyki opisowe, wynik testu, dokładne p, wielkość efektu i 95% CI. Napisz „nie stwierdzono istotnej różnicy”, a nie „grupy są takie same” – brak istotności nie dowodzi braku efektu. Unikaj określeń „prawie istotny” i „tendencja do istotności”.
Czy w opisie wyników trzeba podawać wielkość efektu?
Tak. Standardy APA (JARS-Quant) zalecają podawanie wielkości efektu z przedziałem ufności przy każdym teście, bo wartość p nie mówi, jak duży jest efekt. Dla testów t podaj d, dla ANOVA η² lub cząstkowe η², dla korelacji współczynnik r, a dla regresji logistycznej iloraz szans.
Powiązane hasła
Przeczytaj też
Tabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikWielkość efektu: jak ocenić znaczenie wyniku poza wartością p
Wielkość efektu wyjaśniona praktycznie: Cohen d, Hedges g, r, R², iloraz szans, eta², przedziały ufności i znaczenie praktyczne.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Gernsbacher, M. A. (2018). Writing empirical articles: Transparency, reproducibility, clarity, and memorability. Advances in Methods and Practices in Psychological Science, 1(3), 403–414. https://doi.org/10.1177/2515245918754485 ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3 ● Otwarty dostęp: pełny tekst
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Rucker, D. D., Preacher, K. J., Tormala, Z. L., & Petty, R. E. (2011). Mediation analysis in social psychology: Current practices and new recommendations. Social and Personality Psychology Compass, 5(6), 359–371. https://doi.org/10.1111/j.1751-9004.2011.00355.x
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{gernsbacher2018writing, author={Gernsbacher, Morton Ann}, title={{Writing empirical articles: Transparency, reproducibility, clarity, and memorability}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={3}, pages={403--414}, doi={10.1177/2515245918754485}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{hoekstra2014robust, author={Hoekstra, Rink and Morey, Richard D. and Rouder, Jeffrey N. and Wagenmakers, Eric-Jan}, title={{Robust misinterpretation of confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2014}, volume={21}, number={5}, pages={1157--1164}, doi={10.3758/s13423-013-0572-3}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{rucker2011mediation, author={Rucker, Derek D. and Preacher, Kristopher J. and Tormala, Zakary L. and Petty, Richard E.}, title={{Mediation analysis in social psychology: Current practices and new recommendations}}, journal={Social and Personality Psychology Compass}, year={2011}, volume={5}, number={6}, pages={359--371}, doi={10.1111/j.1751-9004.2011.00355.x}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}@article{wilkinson1999statistical, author={Wilkinson, Leland and {Task Force on Statistical Inference}}, title={{Statistical methods in psychology journals: Guidelines and explanations}}, journal={American Psychologist}, year={1999}, volume={54}, number={8}, pages={594--604}, doi={10.1037/0003-066x.54.8.594}}