Co to jest test U Manna–Whitneya?
Test U Manna–Whitneya (ang. Mann–Whitney U test) to test nieparametryczny do porównania dwóch niezależnych grup. Zamiast na surowych wynikach pracuje na ich rangach, dlatego pojedyncze skrajne wartości mają na niego niewielki wpływ. Stosuje się go, gdy zmienna jest porządkowa albo ilościowa, ale o rozkładzie wyraźnie odbiegającym od normalnego – zwłaszcza w małych próbach i przy zmiennych takich jak czasy reakcji, liczba objawów czy czas zasypiania.
Mann i Whitney (1947) zaproponowali opartą na rangach statystykę U do testowania hipotezy, że dwie zmienne mają jednakowe rozkłady, i podali tablice prawdopodobieństw dla małych prób. Nawiązywali przy tym do wcześniejszego testu rangowego Wilcoxona, dlatego ten sam test bywa nazywany testem sumy rang Wilcoxona (ang. Wilcoxon rank-sum test) albo testem WMW. Nie myl go z testem Wilcoxona dla par, który służy do prób zależnych. Parametrycznym odpowiednikiem jest test t dla prób niezależnych.
Co naprawdę testuje test Manna–Whitneya?
W podręcznikach często pada zdanie, że test Manna–Whitneya „porównuje mediany”. To uproszczenie. Divine i in. (2018) pokazują na kontrprzykładach, że procedura WMW nie jest testem median: dotyczy wielkości P(X1 < X2) + ½P(X1 = X2), czyli prawdopodobieństwa, że losowo wybrany wynik z jednej grupy jest mniejszy niż losowo wybrany wynik z drugiej (remisy liczą się po połowie). Hart (2001) dodaje, że test wykrywa także różnice kształtu i rozproszenia rozkładów, więc istotny wynik może się pojawić nawet przy równych medianach.
Ten sam wynik testu można czytać na kilka sposobów, zależnie od przyjętych założeń – Fay i Proschan (2010) nazywają je „perspektywami”. W praktyce wystarczą dwie:
- bez dodatkowych założeń – test sprawdza, czy wyniki jednej grupy są stochastycznie większe, czyli czy prawdopodobieństwo przewagi różni się od 50% (tak pytanie postawili już Mann i Whitney, 1947);
- gdy rozkłady mają ten sam kształt i rozproszenie, a różnią się tylko położeniem – dopiero wtedy różnica dotyczy także median (i średnich).
Wniosek dla pracy dyplomowej: opisuj wynik jako przewagę jednej grupy („wyniki w grupie A były zwykle wyższe”), a nie jako „różnicę median”, chyba że wykres pokazuje rozkłady o podobnym kształcie. I zawsze pokaż dane, a nie tylko wartość p (Hart, 2001).
Rangi i statystyka U
- Połącz wyniki obu grup i nadaj im rangi od najmniejszego (ranga 1) do największego. Równym wynikom (wiązaniom) przypisz średnią z należnych im rang.
- Policz sumę rang w każdej grupie: R1 i R2.
- Oblicz statystykę U dla obu grup:
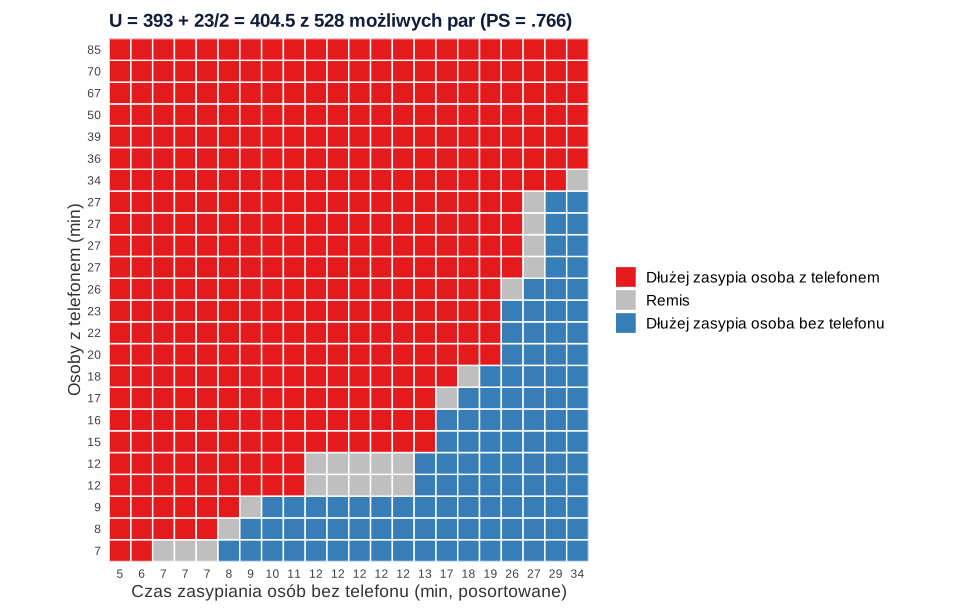
U ma prostą interpretację: U1 to liczba par (osoba z grupy 1, osoba z grupy 2), w których wyższy wynik ma osoba z grupy 1, przy czym remisy liczą się po połowie. Wszystkich par jest n1 × n2. Gdy grupy się nie różnią, U1 jest bliskie połowie liczby par. Programy podają różne wersje tej statystyki: SPSS – mniejszą z wartości U, a R – U pierwszej grupy, oznaczone jako W.
Przykład: telefon w łóżku a czas zasypiania
Czterdzieści sześć osób przez tydzień prowadziło dzienniczek snu. Porównano średni czas zasypiania u osób, które przed snem korzystają z telefonu w łóżku (n = 24), i u osób, które tego nie robią (n = 22). Czas zasypiania ma typowy rozkład prawoskośny: większość osób zasypia w kilkanaście–kilkadziesiąt minut, ale kilka potrzebuje ponad godziny (dane symulowane).
| Grupa | n | Me (min) | Q1–Q3 | M (SD) | Średnia ranga |
|---|---|---|---|---|---|
| Telefon w łóżku | 24 | 24.5 | 15.75–34.50 | 28.92 (20.43) | 29.35 |
| Bez telefonu | 22 | 12.0 | 8.25–17.75 | 14.23 (8.12) | 17.11 |
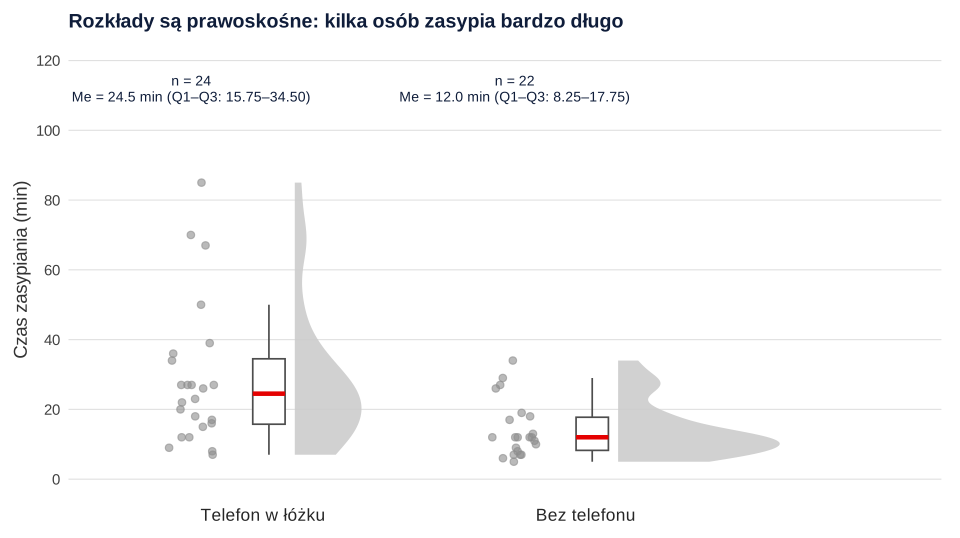
Suma rang w grupie z telefonem wynosi R1 = 704.5, więc U1 = 704.5 − 24 × 25 / 2 = 404.5, a U2 = 24 × 22 − 404.5 = 123.5. Spośród 528 możliwych par w 393 dłużej zasypiała osoba z telefonem, w 112 – osoba bez telefonu, a 23 pary miały identyczny wynik (rysunek 2).
Test wykazał istotną różnicę (zob. wartość p): U = 123.5 (w R: W = 404.5), Z = 3.10, p = .002. Losowo wybrana osoba korzystająca z telefonu zasypiała dłużej niż losowo wybrana osoba bez telefonu z prawdopodobieństwem .77 (remisy liczone po połowie). Pamiętaj, że to wynik korelacyjny: nie wiemy, czy telefon wydłuża zasypianie, czy osoby, które długo nie mogą zasnąć, częściej sięgają po telefon.
Wielkość efektu dla testu Manna–Whitneya
- Prawdopodobieństwo przewagi (ang. probability of superiority): PS = U1 / (n1n2) = 404.5 / 528 = .77. Divine i in. (2018) zalecają właśnie tę wielkość jako podsumowanie wyniku testu.
- Korelacja rangowo-dwuseryjna: rrb = 2PS − 1 = .53, 95% CI [.25, .73]. Kerby (2014) pokazuje, że to różnica między odsetkiem par „zgodnych” i „niezgodnych” z hipotezą (wzór prostej różnicy r = f − u): 393/528 − 112/528 = .744 − .212 = .53. Miara przyjmuje wartości od −1 do 1, a 0 oznacza brak przewagi którejkolwiek grupy.
- r = Z / √N = 3.10 / √46 = .46 – popularne w podręcznikach, ale zależne od sposobu liczenia Z (poprawka na ciągłość, wiązania).
Wybierz jedną miarę i stosuj ją konsekwentnie – najlepiej rrb z przedziałem ufności – i napisz, przewagę której grupy oznacza znak dodatni. Ogólnie o miarach efektu przeczytasz w haśle wielkość efektu.
Dokładne czy asymptotyczne p?
Wartość p można policzyć dokładnie – z rozkładu wszystkich możliwych układów rang – albo z przybliżenia rozkładem normalnym. Mann i Whitney (1947) dowiedli, że przy rosnących próbach statystyka U ma w przybliżeniu rozkład normalny. Przybliżenie wystarcza w średnich i dużych próbach; w małych (kilka–kilkanaście osób w grupie) podaj p dokładne. W przykładzie oba sposoby dają p = .002: dokładne – z pakietu coin, który uwzględnia wiązania, asymptotyczne – z funkcji wilcox.test() z poprawką na ciągłość. Przy wiązaniach wilcox.test() nie policzy dokładnego p i wyświetli ostrzeżenie cannot compute exact p-value with ties – to informacja, a nie błąd analizy.
Wielkość próby ma też drugą stronę. Fagerland (2012) pokazał, że przy dużych próbach i skośnych rozkładach test WMW daje znacznie mniejsze wartości p niż test t nawet przy równych średnich i medianach, gdy grupy różnią się nieco rozproszeniem. Dlatego w dużych próbach nie zastępuj testu t testem Manna–Whitneya tylko dlatego, że rozkład nie jest normalny – wybierz test, który odpowiada na twoje pytanie.
Jak opisać wynik w pracy (APA)
Podaj mediany z kwartylami (a nie same średnie), statystykę U, Z, wartość p z informacją, czy jest dokładna, i wielkość efektu. Zaznacz, którą wersję U podajesz – niektóre programy raportują większą z dwóch wartości. Więcej wzorów zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R i SPSS
Kod generuje dane z przykładu, liczy mediany i średnie rangi, wykonuje test Manna–Whitneya w wersji asymptotycznej i dokładnej oraz liczy korelację rangowo-dwuseryjną. Liczby w tekście pochodzą z tego kodu.
Test U Manna–Whitneya i rrb
R
library(coin); library(effectsize)
set.seed(2018)
tel <- pmax(2, round(exp(rnorm(24, log(23), 0.62))))   # czas zasypiania (min): telefon w łóżku
bez <- pmax(2, round(exp(rnorm(22, log(14), 0.62))))   # bez telefonu
dane <- data.frame(czas = c(tel, bez),
                   grupa = factor(rep(c("Telefon", "Bez"), c(24, 22)), levels = c("Telefon", "Bez")))
tapply(dane$czas, dane$grupa, median)
tapply(rank(dane$czas), dane$grupa, mean)               # średnie rangi
wilcox.test(czas ~ grupa, data = dane, conf.int = TRUE) # W = U pierwszej grupy
coin::wilcox_test(czas ~ grupa, data = dane, distribution = "exact")   # dokładne p
rank_biserial(czas ~ grupa, data = dane)                # korelacja rangowo-dwuseryjna
Wynik w R
Loading required package: survival
Telefon     Bez
   24.5    12.0
 Telefon      Bez
29.35417 17.11364

	Wilcoxon rank sum test with continuity correction

data:  czas by grupa
W = 404.5, p-value = 0.002019
alternative hypothesis: true location shift is not equal to 0
95 percent confidence interval:
  3.999962 17.000007
sample estimates:
difference in location
              10.00004

Warning messages:
1: In wilcox.test.default(x = DATA[[1L]], y = DATA[[2L]], ...) :
  cannot compute exact p-value with ties
2: In wilcox.test.default(x = DATA[[1L]], y = DATA[[2L]], ...) :
  cannot compute exact confidence intervals with ties

	Exact Wilcoxon-Mann-Whitney Test

data:  czas by grupa (Telefon, Bez)
Z = 3.0984, p-value = 0.001529
alternative hypothesis: true mu is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.53              | [0.25, 0.73]
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i ggdist. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2024). ggdist: Visualizations of distributions and uncertainty in the grammar of graphics. IEEE Transactions on Visualization and Computer Graphics, 30(1), 414–424. https://doi.org/10.1109/TVCG.2023.3327195
Najczęstsze błędy
- „Mediany różniły się istotnie” – test nie jest testem median (Hart, 2001; Divine i in., 2018); opisuj przewagę jednej grupy i pokaż rozkłady.
- Automatyczny wybór testu rangowego w dużej próbie tylko dlatego, że test Shapiro–Wilka był istotny – jeśli interesuje cię różnica średnich, użyj testu Welcha (Fagerland, 2012).
- Test dla danych zależnych – dla dwóch pomiarów tych samych osób właściwy jest test Wilcoxona dla par.
- Średnie i SD zamiast median i kwartyli – statystyki opisowe powinny pasować do testu (zob. rozstęp ćwiartkowy).
- Brak wielkości efektu albo r bez informacji, jak je policzono.
- Seria testów Manna–Whitneya dla trzech i więcej grup – użyj testu Kruskala–Wallisa.
Najczęstsze pytania
Kiedy stosować test U Manna-Whitneya zamiast testu t?
Gdy porównujesz dwie niezależne grupy, a zmienna jest porządkowa albo ma rozkład wyraźnie skośny lub z obserwacjami odstającymi, zwłaszcza w małej próbie. Pamiętaj, że test odpowiada na inne pytanie niż test t: czy wyniki jednej grupy są zwykle wyższe, a nie czy różnią się średnie. Przy dużych próbach i pytaniu o średnie lepszy bywa test Welcha.
Czy test Manna-Whitneya porównuje mediany?
Nie wprost. Test dotyczy prawdopodobieństwa, że losowy wynik z jednej grupy jest wyższy niż losowy wynik z drugiej (Divine i in., 2018), i reaguje także na różnice kształtu i rozproszenia rozkładów (Hart, 2001). O medianach mówi tylko wtedy, gdy rozkłady w obu grupach mają ten sam kształt i różnią się jedynie położeniem.
Jak obliczyć wielkość efektu dla testu Manna-Whitneya?
Najprościej jako korelację rangowo-dwuseryjną: rrb = 2U1/(n1n2) − 1, czyli odsetek par „wygranych” minus odsetek par „przegranych” (Kerby, 2014). W przykładzie ze strony rrb = .53, 95% CI [.25, .73]. Popularne jest też r = Z/√N.
Co oznacza W w wyniku R i W Wilcoxona w SPSS?
W R funkcja wilcox.test() podaje jako W statystykę U pierwszej grupy (tu 404.5). SPSS pokazuje osobno U Manna-Whitneya (mniejszą z dwóch wartości, tu 123.5) i W Wilcoxona, czyli sumę rang jednej z grup. To ten sam test, tylko różne zapisy statystyki.
Kiedy podać dokładne p, a kiedy asymptotyczne?
W małych próbach (kilka–kilkanaście osób w grupie) podaj p dokładne, a w większych wystarczy przybliżenie normalne. Przy wiązaniach funkcja wilcox.test() nie liczy dokładnego p; zrobisz to pakietem coin: wilcox_test(y ~ grupa, distribution = "exact").
Jak opisać test Manna-Whitneya w APA?
Podaj mediany z kwartylami w obu grupach, statystykę U, Z, p i wielkość efektu, np. U = 123.5, Z = 3.10, p = .002, rrb = .53, 95% CI [.25, .73]. Opisz wynik jako przewagę jednej grupy, a nie „różnicę median”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test Manna–Whitneya w obrazkach
Rangi, wszystkie pary i P(X > Y), równe mediany a istotny wynik, mała próba i estymator Hodgesa–Lehmanna – pięć symulacji z kodem R.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikTesty nieparametryczne – zadania
Dziesięć zadań jak na kolokwium: Mann–Whitney, test znaków, Wilcoxon, Kruskal–Wallis z Dunnem, Friedman i Spearman – z rangami i rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies—a paradox of statistical practice? BMC Medical Research Methodology, 12(1), Article 78. https://doi.org/10.1186/1471-2288-12-78 ● Otwarty dostęp
- Fay, M. P., & Proschan, M. A. (2010). Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules. Statistics Surveys, 4, 1–39. https://doi.org/10.1214/09-SS051 ● Otwarty dostęp
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491 ● Otwarty dostęp
Cytowania BibTeX
@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{fagerland2012ttests, author={Fagerland, Morten W.}, title={{t-tests, non-parametric tests, and large studies—a paradox of statistical practice?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={78}, doi={10.1186/1471-2288-12-78}}@article{fay2010wilcoxon, author={Fay, Michael P. and Proschan, Michael A.}, title={{Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules}}, journal={Statistics Surveys}, year={2010}, volume={4}, pages={1--39}, doi={10.1214/09-ss051}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{mann1947test, author={Mann, H. B. and Whitney, D. R.}, title={{On a test of whether one of two random variables is stochastically larger than the other}}, journal={The Annals of Mathematical Statistics}, year={1947}, volume={18}, number={1}, pages={50--60}, doi={10.1214/aoms/1177730491}}