Co to jest test Friedmana?
Test Friedmana (ang. Friedman test, także Friedman’s two-way analysis of variance by ranks) to test nieparametryczny do porównania trzech lub więcej powiązanych pomiarów: tych samych osób w kilku warunkach eksperymentu albo w kilku momentach. Jest rangowym odpowiednikiem ANOVA z powtarzanymi pomiarami – zamiast surowych wyników analizuje rangi nadawane osobno w obrębie każdej osoby. Zaproponował go Milton Friedman (1937) jako sposób porównania warunków bez założenia normalności rozkładu.
W psychologii sięga się po niego najczęściej wtedy, gdy zmienną zależną jest pojedyncza pozycja skali Likerta albo inna ocena na skali porządkowej: trudność trzech wersji zadania, atrakcyjność czterech bodźców, nasilenie objawu w kolejnych tygodniach. Każda osoba stanowi „blok”, a porównywane warunki to poziomy czynnika wewnątrzobiektowego. Przy dwóch pomiarach zamiast testu Friedmana użyj testu Wilcoxona dla par, a dla grup niezależnych – testu Kruskala-Wallisa.
Jak działa: rangi w obrębie osób
- Dla każdej osoby uszereguj jej wyniki we wszystkich k warunkach od najniższego (ranga 1) do najwyższego (ranga k); równym wynikom przypisz średnią rangę.
- Dla każdego warunku zsumuj rangi wszystkich n osób (Rj).
- Porównaj sumy rang z sumą oczekiwaną przy braku różnic, czyli n(k + 1) / 2.
Rangowanie wewnątrz osób to sedno testu: znika poziom, na którym dana osoba używa skali, a zostaje kolejność warunków. Ktoś, kto wszystko ocenia na 2–3, i ktoś, kto odpowiada 5–7, wnoszą tę samą informację: który warunek jest u nich lepszy, a który gorszy. Gdy hipoteza zerowa jest prawdziwa (żaden warunek nie jest systematycznie oceniany wyżej), każda kolejność rang jest u każdej osoby jednakowo prawdopodobna, a χ²F ma w przybliżeniu rozkład χ² z k − 1 stopniami swobody. Przy wielu rangach wiązanych, częstych na krótkich skalach, program dzieli statystykę przez poprawkę na wiązania.
Wielkość efektu opisuje współczynnik zgodności W Kendalla, wywodzący się z pracy Kendalla i Babington Smitha (1939) o zgodności wielu uporządkowań:
W przyjmuje wartości od 0 (osoby porządkują warunki zupełnie różnie) do 1 (wszyscy ustawiają warunki w tej samej kolejności). Nie myl go z korelacją tau Kendalla, która opisuje związek dwóch zmiennych.
Kiedy stosować test Friedmana?
- Te same osoby we wszystkich warunkach (albo dobrane bloki, np. trójki osób dopasowane pod względem wieku). Osoba z brakiem w jednym warunku wypada z analizy.
- Co najmniej trzy warunki i zmienna co najmniej porządkowa.
- Niezależne osoby – wynik jednej osoby nie wpływa na wynik innej.
Test nie wymaga normalności ani założenia sferyczności, ale ma swoją cenę. Zimmerman i Zumbo (1993) przypominają, że test Friedmana jest uogólnieniem testu znaków, i pokazują w symulacjach, że ma podobnie skromną moc – wyraźnie mniejszą niż ANOVA z powtarzanymi pomiarami wykonana na rangach, która zachowywała się jak test Wilcoxona. Dlatego przy danych ilościowych o rozkładzie zbliżonym do normalnego wybierz ANOVA z powtarzanymi pomiarami, a test Friedmana zostaw dla danych porządkowych oraz małych prób z silnie skośnymi rozkładami lub obserwacjami odstającymi. Zdecyduj o tym przed analizą, a nie po porównaniu wartości p obu testów.
Przykład: skupienie w czterech warunkach dźwiękowych
Dwadzieścia osób (dane symulowane) czytało cztery teksty w czterech warunkach: w ciszy, przy szumie, przy muzyce instrumentalnej i przy muzyce z tekstem; kolejność warunków losowano. Po każdym tekście oceniały na skali 1–7, jak łatwo było im się skupić. Pojedyncza pozycja i mała próba to typowa sytuacja dla testu Friedmana.
| Warunek | Me [Q1, Q3] | Suma rang Rj | Średnia ranga |
|---|---|---|---|
| Cisza | 5.0 [4.75, 6.00] | 62.5 | 3.13 |
| Szum | 4.0 [4.00, 5.25] | 53.0 | 2.65 |
| Muzyka instrumentalna | 4.5 [4.00, 5.00] | 54.0 | 2.70 |
| Muzyka z tekstem | 3.0 [3.00, 4.00] | 30.5 | 1.53 |
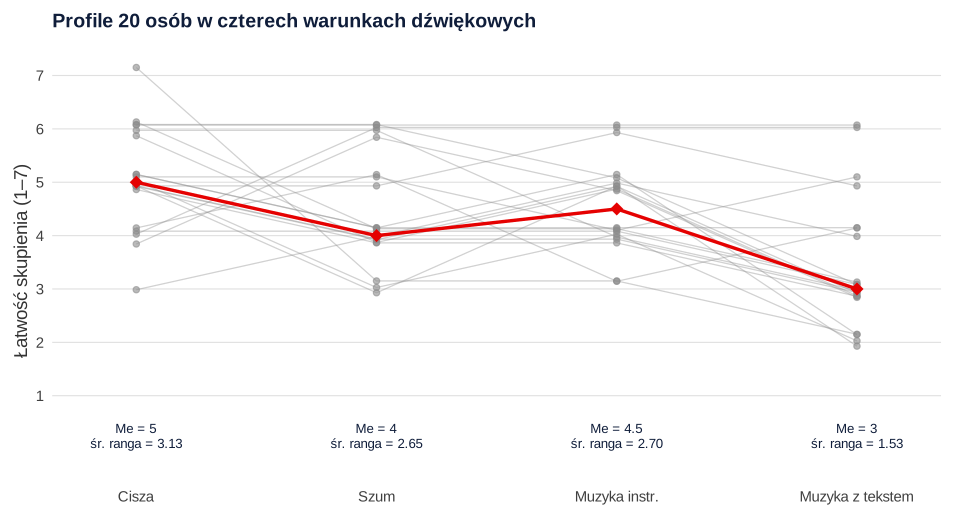
Rysunek 1 pokazuje, dlaczego warto rangować w obrębie osób. Osoba 7 oceniła wszystkie warunki na 6, a osoba 20 żadnego nie oceniła wyżej niż na 4 – różnice w używaniu skali są duże. Rysunek 2 pokazuje te same dane po zamianie na rangi: każdy wiersz to jedna osoba, a rangi 1–4 mówią tylko, który warunek był u niej najgorszy, a który najlepszy.
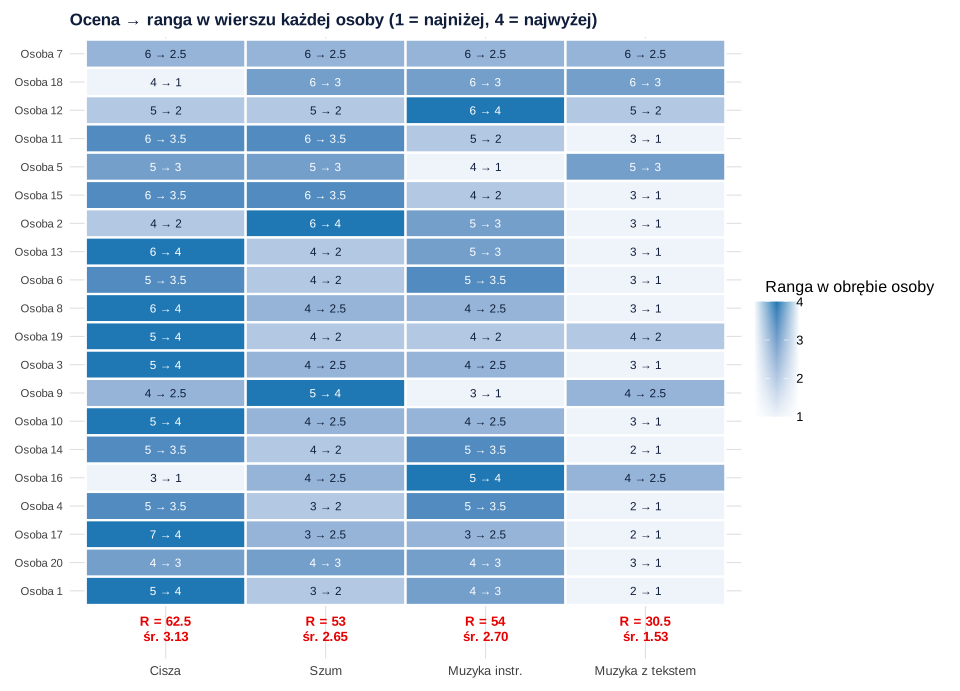
Krok 1. Statystyka testu. Przy braku różnic każda suma rang wynosiłaby 20 × 5 / 2 = 50. Podstawiamy obserwowane sumy:
Oceny na skali 1–7 dają wiele wiązań, więc poprawka jest tu wyraźna: C = 0.795, a χ²F = 16.85 / 0.795 = 21.19. Przy 3 stopniach swobody p < .001 – warunki dźwiękowe różnicowały łatwość skupienia.
Krok 2. Wielkość efektu. W = 21.19 / (20 × 3) = .35. Pakiet rstatix opisuje taką wartość jako umiarkowaną (progi .1, .3 i .5): osoby w dużej części zgadzały się co do kolejności warunków, ale daleko im do pełnej zgodności.
Porównania post hoc po teście Friedmana
Istotny wynik oznacza tylko, że co najmniej jeden warunek różni się od pozostałych. Który – sprawdzają testy post hoc. Cztery warunki to sześć par, więc wartości p trzeba skorygować, np. procedurą Holma (1979), mniej zachowawczą niż klasyczna korekta Bonferroniego. Do wyboru masz dwie rodziny procedur:
- test Wilcoxona dla par dla każdej pary warunków – porównanie zależy tylko od dwóch warunków, których dotyczy;
- testy na sumach lub średnich rangach z rangowania wszystkich warunków: Nemenyiego, Conovera albo test dokładny (Eisinga i in., 2017); jego autorzy pokazali, że przybliżenie χ² dla różnic sum rang wypada gorzej niż obliczenia dokładne.
Procedury różnią się konserwatywnością. W symulacji, którą przeprowadzili Pereira i in. (2015), test znaków był bardzo zachowawczy, a testy LSD Fishera i HSD Tukeya liczone na rangach – najbardziej liberalne. Wybierz procedurę przed analizą i podaj jej nazwę w pracy. W przykładzie użyliśmy testu Wilcoxona dla par z korektą Holma:
| Para warunków | Wyżej / niżej / równo | p (Wilcoxon, Holm) | p (Conover, Holm) |
|---|---|---|---|
| Cisza – muzyka z tekstem | 14 / 2 / 4 | .009 | < .001 |
| Szum – muzyka z tekstem | 14 / 0 / 6 | .004 | .002 |
| Muzyka instrumentalna – muzyka z tekstem | 15 / 2 / 3 | .008 | .001 |
| Cisza – szum | 10 / 4 / 6 | .419 | .358 |
| Cisza – muzyka instrumentalna | 11 / 4 / 5 | .419 | .358 |
| Szum – muzyka instrumentalna | 5 / 7 / 8 | .902 | .868 |
„Wyżej / niżej / równo” to liczba osób, które oceniły pierwszy warunek pary wyżej, niżej albo tak samo jak drugi. Wniosek: muzyka z tekstem utrudniała skupienie w porównaniu z każdym z trzech pozostałych warunków, a cisza, szum i muzyka instrumentalna nie różniły się istotnie. Test Conovera daje mniejsze wartości p, ale ten sam wzór wyników; to samo pokazują test Nemenyiego i test dokładny (pełny skrypt strony).
Jak opisać wynik w pracy (APA)
Podaj statystykę χ² ze stopniami swobody i liczebnością, wartość p, W Kendalla, mediany warunków oraz wyniki porównań parami z nazwą testu i korekty:
Przy kilku zmiennych zależnych wygodniej zebrać wyniki w tabeli:
Tabela 1
Łatwość skupienia (1–7) w czterech warunkach dźwiękowych
| Warunek | Me | [Q1, Q3] | Średnia ranga |
|---|---|---|---|
| Cisza | 5.0a | [4.75, 6.00] | 3.13 |
| Szum | 4.0a | [4.00, 5.25] | 2.65 |
| Muzyka instrumentalna | 4.5a | [4.00, 5.00] | 2.70 |
| Muzyka z tekstem | 3.0b | [3.00, 4.00] | 1.53 |
Uwaga. N = 20. Me – mediana; Q1, Q3 – pierwszy i trzeci kwartyl. Test Friedmana: χ²(3, N = 20) = 21.19, p < .001, W = .35. Warunki oznaczone różnymi literami różnią się istotnie (test Wilcoxona dla par z korektą Holma, p < .05).
Więcej wzorów zdań znajdziesz w poradniku jak opisać wyniki w stylu APA, a o wyborze między testem Friedmana a ANOVA – w tekście jak dobrać test statystyczny do hipotezy.
Test Friedmana w R i SPSS
Kod generuje dane z przykładu (wiersz = osoba, kolumna = warunek), liczy mediany i średnie rangi, wykonuje test Friedmana, oblicza W Kendalla i porównania parami. Liczby w tekście pochodzą z tego kodu; rysunki i pozostałe procedury post hoc – z pełnego skryptu strony.
Test Friedmana, W Kendalla i porównania post hoc
R
library(PMCMRplus)
set.seed(19)                                       # dane symulowane
n <- 20
osoba <- rnorm(n, 0, 0.9)                          # stałe różnice między osobami
efekt <- c(0.7, 0.15, 0.35, -0.7)                  # cisza, szum, muzyka instr., muzyka z tekstem
oceny <- pmin(pmax(round(4.2 + outer(osoba, efekt, "+") + rnorm(n * 4, 0, 0.75)), 1), 7)
warunki <- c("Cisza", "Szum", "Muzyka instr.", "Muzyka z tekstem")
colnames(oceny) <- warunki                         # wiersz = osoba, kolumna = warunek

apply(oceny, 2, median)                            # mediany ocen (1–7)
colMeans(t(apply(oceny, 1, rank)))                 # średnie rangi (rangi w obrębie osoby)

ft <- friedman.test(oceny)                         # test Friedmana (z poprawką na rangi wiązane)
ft
unname(ft$statistic) / (n * (ncol(oceny) - 1))     # W Kendalla = chi2 / (n(k - 1))

dl <- data.frame(id = factor(rep(1:n, 4)), ocena = c(oceny),
                 warunek = factor(rep(warunki, each = n), levels = warunki))
pairwise.wilcox.test(dl$ocena, dl$warunek, paired = TRUE,
                     p.adjust.method = "holm", exact = FALSE)   # pary: Wilcoxon + Holm
frdAllPairsConoverTest(dl$ocena, dl$warunek, dl$id, p.adjust.method = "holm")  # alternatywa
Wynik w R
           Cisza             Szum    Muzyka instr. Muzyka z tekstem
             5.0              4.0              4.5              3.0
           Cisza             Szum    Muzyka instr. Muzyka z tekstem
           3.125            2.650            2.700            1.525

	Friedman rank sum test

data:  oceny
Friedman chi-squared = 21.189, df = 3, p-value = 9.619e-05

[1] 0.3531447

	Pairwise comparisons using Wilcoxon signed rank test with continuity correction

data:  dl$ocena and dl$warunek

                 Cisza  Szum   Muzyka instr.
Szum             0.4187 -      -
Muzyka instr.    0.4187 0.9015 -
Muzyka z tekstem 0.0087 0.0039 0.0079

P value adjustment method: holm

	Pairwise comparisons using Conover's all-pairs test for a two-way balanced complete block design

data: y, groups and blocks

                 Cisza   Szum   Muzyka instr.
Szum             0.3580  -      -
Muzyka instr.    0.3580  0.8684 -
Muzyka z tekstem 1.1e-05 0.0017 0.0012

P value adjustment method: holm
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (W Kendalla sprawdzono dodatkowo w pakiecie rstatix); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended [R package]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Test Friedmana dla grup niezależnych (albo test Kruskala-Wallisa dla pomiarów powtarzanych) – sprawdź, czy te same osoby występują we wszystkich warunkach.
- Zdanie „mediany różniły się istotnie” – test dotyczy kolejności warunków w obrębie osób. Podaj mediany i średnie rangi jako opis, a wniosek sformułuj jako różnicę w ocenach warunków.
- Seria testów Wilcoxona bez korekty – przy sześciu parach ryzyko fałszywego alarmu wyraźnie rośnie; zastosuj korektę Holma.
- Automatyczne zastąpienie ANOVA testem Friedmana przy danych ilościowych zbliżonych do normalnych – tracisz moc (Zimmerman i Zumbo, 1993).
- Brak wielkości efektu – samo p nie mówi, jak zgodnie osoby porządkują warunki; podaj W Kendalla.
- Usuwanie osób z brakami bez informacji – test wymaga kompletu pomiarów; napisz, ile osób wykluczono i dlaczego.
Najczęstsze pytania
Kiedy stosować test Friedmana?
Gdy te same osoby mierzysz w co najmniej trzech warunkach lub momentach, a zmienna jest porządkowa (np. pojedyncza pozycja skali Likerta) albo ilościowa, ale silnie skośna w małej próbie. Przy dwóch pomiarach użyj testu Wilcoxona dla par, a dla grup niezależnych – testu Kruskala-Wallisa.
Czym test Friedmana różni się od ANOVA z powtarzanymi pomiarami?
ANOVA porównuje średnie i wymaga m.in. normalności oraz sferyczności. Test Friedmana analizuje rangi nadane w obrębie każdej osoby, więc tych założeń nie potrzebuje, ale ma mniejszą moc – w symulacjach zbliżoną do testu znaków (Zimmerman i Zumbo, 1993). Przy danych ilościowych o rozkładzie zbliżonym do normalnego zwykle lepsza jest ANOVA.
Jaki test post hoc po teście Friedmana?
Najprostszy wybór to test Wilcoxona dla par dla każdej pary warunków z korektą Holma. Alternatywą są testy na średnich rangach: Nemenyiego, Conovera albo test dokładny (w R pakiet PMCMRplus). Procedury różnią się konserwatywnością, dlatego w pracy podaj nazwę testu i korekty.
Jak obliczyć W Kendalla dla testu Friedmana?
Podziel statystykę testu przez n(k − 1), gdzie n to liczba osób, a k – liczba warunków. W przykładzie z tej strony W = 21.19 / (20 × 3) = .35. Wartość 0 oznacza brak zgodności osób co do kolejności warunków, a 1 – identyczną kolejność u wszystkich.
Czy test Friedmana porównuje mediany?
Nie wprost. Test sprawdza, czy rangi nadawane w obrębie osób układają się systematycznie, czyli czy któryś warunek jest u większości osób oceniany wyżej lub niżej. Mediany i kwartyle podawaj jako opis danych, a wniosek formułuj jako różnicę w ocenach warunków.
Jak zapisać wynik testu Friedmana w APA?
Podaj statystykę ze stopniami swobody i liczebnością, wartość p i W Kendalla, np. χ²(3, N = 20) = 21.19, p < .001, W = .35, a także mediany warunków. Następnie opisz porównania parami z nazwą testu i korekty, np. test Wilcoxona dla par z korektą Holma.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Pytania rankingowe i „wybierz 3 najważniejsze”
Od eksportu z Google Forms i LimeSurvey do rang: top-1 i top-3 z CI, średnia ranga, punkty Bordy, test Friedmana, porównanie grup i pułapka ipsatywności.
Czytaj →PoradnikStatystyka w pracy z informatyki
Test użyteczności, test A/B, algorytmy na wielu zbiorach danych, ankieta akceptacji technologii i benchmarki: testy, wielkość efektu, zdania APA i kod R.
Czytaj →PoradnikTesty nieparametryczne w jamovi
Mann–Whitney, Wilcoxon, Kruskal–Wallis z DSCF i Dunnem, Friedman z Durbinem–Conoverem i Spearman w jamovi: opcje, tabele, wielkość efektu, APA i kod jmv.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Eisinga, R., Heskes, T., Pelzer, B., & Te Grotenhuis, M. (2017). Exact p-values for pairwise comparison of Friedman rank sums, with application to comparing classifiers. BMC Bioinformatics, 18(1), Article 68. https://doi.org/10.1186/s12859-017-1486-2 ● Otwarty dostęp
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kendall, M. G., & Babington Smith, B. (1939). The problem of m rankings. The Annals of Mathematical Statistics, 10(3), 275–287. https://doi.org/10.1214/aoms/1177732186 ● Otwarty dostęp
- Pereira, D. G., Afonso, A., & Medeiros, F. M. (2015). Overview of Friedman’s test and post-hoc analysis. Communications in Statistics - Simulation and Computation, 44(10), 2636–2653. https://doi.org/10.1080/03610918.2014.931971
- Zimmerman, D. W., & Zumbo, B. D. (1993). Relative power of the Wilcoxon test, the Friedman test, and repeated-measures ANOVA on ranks. The Journal of Experimental Education, 62(1), 75–86. https://doi.org/10.1080/00220973.1993.9943832
Cytowania BibTeX
@article{eisinga2017exact, author={Eisinga, Rob and Heskes, Tom and Pelzer, Ben and Te Grotenhuis, Manfred}, title={{Exact p-values for pairwise comparison of Friedman rank sums, with application to comparing classifiers}}, journal={BMC Bioinformatics}, year={2017}, volume={18}, number={1}, eid={68}, doi={10.1186/s12859-017-1486-2}}@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kendall1939problem, author={Kendall, M. G. and Babington Smith, B.}, title={{The problem of m rankings}}, journal={The Annals of Mathematical Statistics}, year={1939}, volume={10}, number={3}, pages={275--287}, doi={10.1214/aoms/1177732186}}@article{pereira2015overview, author={Pereira, Dulce G. and Afonso, Anabela and Medeiros, Fátima Melo}, title={{Overview of Friedman’s test and post-hoc analysis}}, journal={Communications in Statistics - Simulation and Computation}, year={2015}, volume={44}, number={10}, pages={2636--2653}, doi={10.1080/03610918.2014.931971}}@article{zimmerman1993relative, author={Zimmerman, Donald W. and Zumbo, Bruno D.}, title={{Relative power of the Wilcoxon test, the Friedman test, and repeated-measures ANOVA on ranks}}, journal={The Journal of Experimental Education}, year={1993}, volume={62}, number={1}, pages={75--86}, doi={10.1080/00220973.1993.9943832}}