Co to jest test Kruskala-Wallisa?
Test Kruskala-Wallisa (ang. Kruskal–Wallis H test, także one-way ANOVA on ranks) to test nieparametryczny, który porównuje co najmniej trzy niezależne grupy pod względem zmiennej mierzonej co najmniej na skali porządkowej. Zamiast surowych wyników analizuje rangi: wszystkie obserwacje ze wszystkich grup porządkuje się razem, a potem sprawdza, czy średnie rangi w grupach różnią się bardziej, niż można by oczekiwać przy przypadkowym podziale. Kruskal i Wallis (1952) zaproponowali go jako rangowy odpowiednik jednoczynnikowej analizy wariancji (ANOVA).
W psychologii sięga się po niego, gdy zmienną zależną jest pojedyncza pozycja skali Likerta, liczba objawów, czas reakcji albo inna silnie skośna zmienna mierzona w niewielkich grupach. Jest uogólnieniem testu Manna-Whitneya na więcej niż dwie grupy – oba testy opierają się na łącznym rangowaniu wszystkich obserwacji (Nahm, 2016).
Klasyczna hipoteza zerowa mówi, że wyniki we wszystkich grupach pochodzą z tego samego rozkładu. Vargha i Delaney (1998) pokazują jednak, że test H wykrywa wyłącznie odstępstwa od tzw. stochastycznej jednorodności, czyli od równości średnich rang – a nie każdą różnicę między rozkładami. Dlatego test Kruskala-Wallisa nie jest automatycznie testem median; wracamy do tego przy założeniach.
Wzór na statystykę H
- N – liczba wszystkich obserwacji,
- nj – liczebność grupy j,
- Rj – suma rang w grupie j (rangi nadane łącznie wszystkim N obserwacjom),
- k – liczba grup; sumujemy po wszystkich k grupach.
Gdyby grupy się nie różniły, każda miałaby średnią rangę bliską ogólnej średniej rangi, czyli (N + 1) / 2. Statystyka H rośnie, gdy średnie rangi grup oddalają się od tej wartości. W istocie porównuje ona zmienność średnich rang między grupami z całkowitą zmiennością rang – stąd nazwa „analiza wariancji na rangach”. Gdy w danych są jednakowe wyniki (rangi wiązane), H dzieli się przez poprawkę:
gdzie t to liczba obserwacji w każdej grupie wiązań (programy stosują tę poprawkę automatycznie). Gdy hipoteza zerowa jest prawdziwa, H ma w przybliżeniu rozkład χ² z k − 1 stopniami swobody; dla małych prób autorzy testu podali przybliżenia i tablice dokładne (Kruskal i Wallis, 1952). Przy grupach liczących po kilka osób zamiast przybliżenia χ² policz więc dokładną albo permutacyjną wartość p.
Założenia: kiedy stosować test Kruskala-Wallisa
- Niezależne grupy. Każda osoba należy tylko do jednej grupy. Gdy te same osoby badasz kilka razy, użyj testu Friedmana, a przy dwóch pomiarach – testu Wilcoxona.
- Zmienna co najmniej porządkowa. Wyniki da się uporządkować od najniższego do najwyższego (np. odpowiedzi 1–5, czas, liczba błędów).
- Niezależne obserwacje. Jedna osoba to jeden wynik w analizie.
- Podobny kształt rozkładów – tylko wtedy, gdy chcesz mówić o medianach. Przy podobnym kształcie i rozproszeniu istotny wynik można opisać jako różnicę median. Przy wyraźnie różnych wariancjach Vargha i Delaney (1998) zalecają odporne alternatywy na rangach, a wynik opisuj ostrożniej – jako różnicę średnich rang.
Test nie wymaga normalności rozkładu, ale nie traktuj go jak automatycznego zamiennika ANOVA po każdym istotnym wyniku testu Shapiro-Wilka: oba testy odpowiadają na nieco inne pytania. Jeśli interesują Cię średnie zmiennej ilościowej, a wariancje w grupach są nierówne, rozważ test Welcha. Jeśli zmienna jest porządkowa albo bardzo skośna, z obserwacjami odstającymi w małych grupach – wybierz test Kruskala-Wallisa.
| Cecha | ANOVA jednoczynnikowa | Test Kruskala-Wallisa |
|---|---|---|
| Co porównuje | Średnie | Średnie rangi (stochastyczną jednorodność) |
| Zmienna zależna | Ilościowa | Co najmniej porządkowa |
| Statystyka | F(df1, df2) | H(df), w R: „Kruskal-Wallis chi-squared” |
| Opis grup | M (SD) | Mdn, kwartyle, średnie rangi |
| Wielkość efektu | η², ω² | ε², η²H |
| Post hoc | Tukey, Games-Howell | Test Dunna z korektą p |
Przykład: czas zasypiania w trzech grupach
Sześćdziesięciu studentów z problemami z zasypianiem przydzielono losowo do trzech grup po 20 osób: treningu relaksacyjnego, edukacji o higienie snu i grupy kontrolnej (lista oczekujących). Po czterech tygodniach każda osoba podała, ile minut zwykle zajmuje jej zaśnięcie (dane symulowane). Rozkłady są prawoskośne (skośność od 0.90 do 2.51), a w grupie kontrolnej jest wynik 108 minut – to typowy obraz dla czasów. Test Shapiro-Wilka odrzucił normalność we wszystkich grupach (p < .01), dlatego grupy opisujemy medianą i kwartylami.
| Grupa | n | Mdn [Q1, Q3] | Suma rang Rj | Średnia ranga |
|---|---|---|---|---|
| Kontrolna | 20 | 27.0 [20.75, 33.25] | 767.5 | 38.38 |
| Higiena snu | 20 | 24.0 [17.00, 34.50] | 674.5 | 33.73 |
| Relaksacja | 20 | 13.5 [10.75, 19.50] | 388.0 | 19.40 |
Wszystkie 60 wyników zamieniamy na rangi od 1 do 60 (jednakowym wynikom przypisujemy średnią z zajmowanych rang). Ogólna średnia ranga wynosi (60 + 1) / 2 = 30.5. Podstawiamy sumy rang do wzoru:
Po poprawce na rangi wiązane (C = 0.9987) H = 12.84. Przy k − 1 = 2 stopniach swobody daje to p = .002: średnie rangi różnią się bardziej, niż można by przypisać przypadkowi. Rysunek 1 pokazuje, co dzieje się z danymi przy rangowaniu.
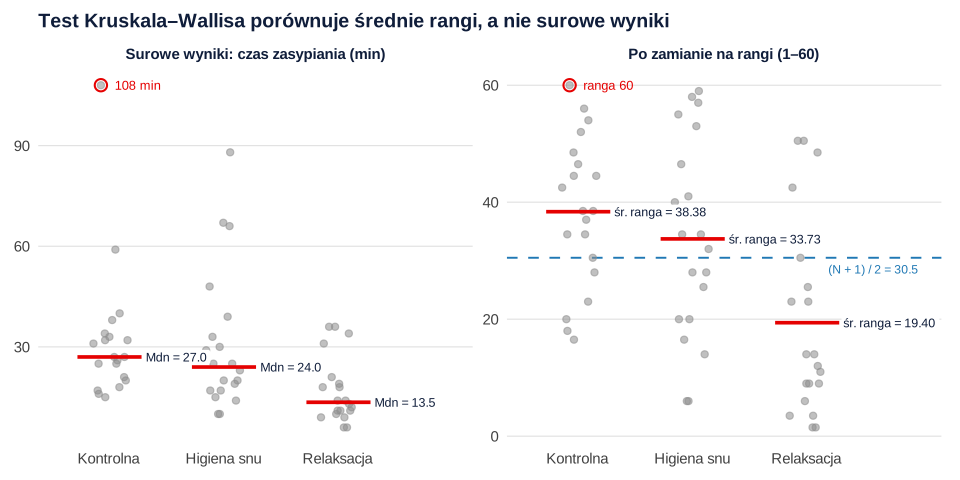
Po rangowaniu wynik 108 minut jest tylko o jedną rangę wyżej niż następny (88 minut), dlatego test rangowy jest odporny na pojedyncze skrajne wartości. Klasyczna ANOVA na minutach dała F(2, 57) = 4.41, p = .017 – duże rozproszenie w dwóch grupach osłabiło test F. Nie wybieraj jednak testu według tego, który da mniejsze p; zdecyduj przed analizą, na podstawie skali pomiaru i planu badania (zob. jak dobrać test statystyczny do hipotezy).
Wielkość efektu: ε² i η²H
Sama wartość p nie mówi, jak duża jest różnica. Wielkość efektu liczy się zwykle wprost ze statystyki H:
Obie miary opisują, jaką część zmienności rang wiąże się z przynależnością do grupy, i czyta się je podobnie jak eta kwadrat w ANOVA. Dają nieco inne wartości, więc w pracy zawsze napisz, którą z nich podajesz. Więcej o interpretacji miar w haśle wielkość efektu.
Dla pojedynczych par grup wygodna jest korelacja rangowa dwuseryjna r. Kerby (2014) pokazuje, że można ją policzyć prostym wzorem r = f − u: f to odsetek par obserwacji (po jednej z każdej grupy) zgodnych z kierunkiem efektu, a u – odsetek par niezgodnych. W naszych danych osoba z grupy kontrolnej zasypiała dłużej niż osoba z grupy relaksacji w 80.5% par, a krócej w 18.25% par, więc r = .805 − .1825 = .62.
Test Dunna: porównania post hoc z korektą
Istotny wynik H mówi tylko, że co najmniej jedna grupa różni się od pozostałych. Które to grupy, sprawdzają testy post hoc. Po teście Kruskala-Wallisa zwykle wykonuje się test Dunna (tej metody używa m.in. SPSS). Dunn (1964) zaproponował porównania oparte na sumach rang ze wspólnego rangowania wszystkich grup – zamiast rangowania każdej pary osobno – z przybliżeniem normalnym i uwzględnieniem rang wiązanych. Dla pary grup i i j:
Dla grupy kontrolnej i relaksacji: (38.38 − 19.40) / √(305 × 0.1) = 3.44 (program dodatkowo koryguje mianownik o rangi wiązane). Trzy porównania to trzy testy, więc wartości p trzeba skorygować – inaczej rośnie ryzyko błędu I rodzaju. Procedura Holma (1979) kontroluje to ryzyko dla dowolnej kombinacji prawdziwych hipotez zerowych i jest mniej zachowawcza niż klasyczna korekta Bonferroniego.
| Porównanie | |z| | p bez korekty | p (Holm) | r |
|---|---|---|---|---|
| Kontrolna – higiena snu | 0.84 | .400 | .400 | .17 |
| Kontrolna – relaksacja | 3.44 | < .001 | .002 | .62 |
| Higiena snu – relaksacja | 2.60 | .009 | .019 | .49 |
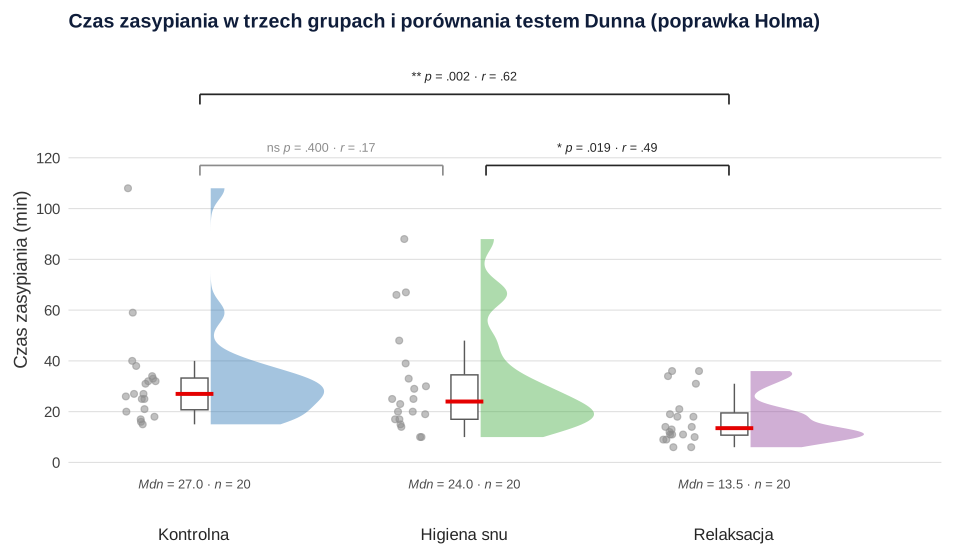
Wniosek: osoby po treningu relaksacyjnym zasypiały szybciej niż osoby z obu pozostałych grup, a edukacja o higienie snu nie różniła się istotnie od grupy kontrolnej. Ponieważ przydział do grup był losowy, różnicę można przypisać interwencji. Uwaga praktyczna: przy korekcie Bonferroniego porównanie higieny snu z relaksacją dałoby p = .028 zamiast .019 – w opisie metody zawsze podaj nazwę zastosowanej korekty.
Jak opisać wynik w pracy (APA)
W tekście podaj statystykę H ze stopniami swobody, wartość p, wielkość efektu, mediany grup oraz wyniki porównań post hoc z nazwą korekty. W R statystyka jest podpisana jako „Kruskal-Wallis chi-squared”, dlatego część autorów zapisuje ją jako χ²(2, N = 60) = 12.84 – to ta sama liczba. Przykładowy opis:
Przy kilku zmiennych zależnych wygodniej zebrać wyniki w tabeli. Tak może wyglądać tabela z przykładu:
Tabela 1
Czas zasypiania (w minutach) w trzech grupach po czterech tygodniach
| Grupa | n | Mdn | [Q1, Q3] | Średnia ranga |
|---|---|---|---|---|
| Kontrolna | 20 | 27.0a | [20.75, 33.25] | 38.38 |
| Higiena snu | 20 | 24.0a | [17.00, 34.50] | 33.73 |
| Relaksacja | 20 | 13.5b | [10.75, 19.50] | 19.40 |
Uwaga. N = 60. Mdn = mediana; Q1 i Q3 = pierwszy i trzeci kwartyl. Test Kruskala-Wallisa: H(2) = 12.84, p = .002, ε² = .22. Mediany z różnymi indeksami dolnymi różnią się istotnie w teście Dunna z korektą Holma (p < .05).
Więcej gotowych zdań do rozdziału z wynikami znajdziesz w poradniku jak opisać wyniki w stylu APA, a porównanie z parametryczną ścieżką analizy – w poradniku ANOVA krok po kroku.
Test Kruskala-Wallisa w R
Kod tworzy dane z przykładu, liczy kwartyle i średnie rangi, test H, dwie miary wielkości efektu i test Dunna z korektą Holma. Liczby w tekście, w tabeli i na rysunkach pochodzą z tego kodu. W SPSS ten sam test znajdziesz w menu Analiza → Testy nieparametryczne → Próby niezależne: w zakładce Ustawienia wybierz test Kruskala-Wallisa i porównania wielokrotne „Wszystkie parami” (SPSS poda porównania metodą Dunna z korektą Bonferroniego).
Test H, wielkość efektu i test Dunna
R
library(rstatix)
set.seed(66)
grupy <- c("Kontrolna", "Higiena snu", "Relaksacja")
d <- data.frame(grupa  = factor(rep(grupy, each = 20), levels = grupy),
                minuty = round(c(rlnorm(20, log(30), 0.55),     # czas zasypiania w minutach
                                 rlnorm(20, log(24), 0.55),
                                 rlnorm(20, log(15), 0.55))))
aggregate(minuty ~ grupa, data = d, FUN = quantile, probs = c(.25, .50, .75))
d$ranga <- rank(d$minuty)                     # wspólne rangowanie wszystkich 60 osób
tapply(d$ranga, d$grupa, mean)                # średnie rangi w grupach
kw <- kruskal.test(minuty ~ grupa, data = d)  # test H (z poprawką na rangi wiązane)
kw
unname(kw$statistic / (nrow(d) - 1))          # epsilon kwadrat
kruskal_effsize(d, minuty ~ grupa)            # eta kwadrat H
dunn_test(d, minuty ~ grupa, p.adjust.method = "holm")[, c("group1", "group2", "statistic", "p", "p.adj")]
Wynik w R
        grupa minuty.25% minuty.50% minuty.75%
1   Kontrolna      20.75      27.00      33.25
2 Higiena snu      17.00      24.00      34.50
3  Relaksacja      10.75      13.50      19.50
  Kontrolna Higiena snu  Relaksacja
     38.375      33.725      19.400

	Kruskal-Wallis rank sum test

data:  minuty by grupa
Kruskal-Wallis chi-squared = 12.844, df = 2, p-value = 0.001625

[1] 0.2176951
# A tibble: 1 × 5
  .y.        n effsize method  magnitude
* <chr>  <int>   <dbl> <chr>   <ord>
1 minuty    60   0.190 eta2[H] large
# A tibble: 3 × 5
  group1      group2      statistic        p   p.adj
  <chr>       <chr>           <dbl>    <dbl>   <dbl>
1 Kontrolna   Higiena snu    -0.843 0.400    0.400
2 Kontrolna   Relaksacja     -3.44  0.000586 0.00176
3 Higiena snu Relaksacja     -2.60  0.00945  0.0189
Znak z zależy tylko od kolejności grup w parze. Te same wartości p daje funkcja kwAllPairsDunnTest(minuty ~ grupa, data = d, p.adjust.method = "holm") z pakietu PMCMRplus, który zawiera też inne procedury porównań rangowych.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i ggdist. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended [R package]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2025). ggdist: Visualizations of distributions and uncertainty [R package]. https://doi.org/10.5281/zenodo.3879620
Najczęstsze błędy
- „Test Kruskala-Wallisa wykazał różnicę median” – bez sprawdzenia, czy rozkłady mają podobny kształt. Test reaguje na różnice średnich rang, a te mogą wynikać także z różnej skośności lub rozproszenia (Vargha i Delaney, 1998).
- Seria testów Manna-Whitneya bez korekty zamiast testu post hoc. Każda para jest wtedy rangowana osobno, a przy wielu testach rośnie ryzyko fałszywie istotnego wyniku. Użyj testu Dunna z korektą p.
- Test Kruskala-Wallisa dla pomiarów powtarzanych – gdy te same osoby badano kilka razy, właściwy jest test Friedmana.
- Raportowanie samego p bez median, kwartyli i wielkości efektu (ε² lub η²H, a dla par – r).
- Opis grup średnią i odchyleniem standardowym przy silnie skośnych danych – lepiej podać medianę i kwartyle albo rozstęp ćwiartkowy, a rozkład pokazać na wykresie pudełkowym.
- Porównania post hoc po nieistotnym H przedstawiane jako potwierdzenie hipotezy. Jeśli je wykonujesz, opisz je jako analizę eksploracyjną.
Najczęstsze pytania
Kiedy stosować test Kruskala-Wallisa?
Gdy porównujesz co najmniej trzy niezależne grupy, a zmienna zależna jest porządkowa (np. pojedyncza pozycja skali Likerta) albo ilościowa, ale silnie skośna, z wynikami odstającymi w małych grupach. Dla dwóch grup odpowiednikiem jest test Manna-Whitneya, a dla pomiarów powtarzanych – test Friedmana.
Czym różni się test Kruskala-Wallisa od ANOVA?
ANOVA porównuje średnie i zakłada m.in. normalność oraz podobne wariancje w grupach. Test Kruskala-Wallisa porównuje średnie rangi wszystkich obserwacji, dlatego jest odporny na wyniki odstające i nadaje się do danych porządkowych. Odpowiada jednak na inne pytanie: czy wyniki którejś grupy są systematycznie wyższe lub niższe, a nie czy różnią się średnie.
Jaki test post hoc po teście Kruskala-Wallisa?
Najczęściej test Dunna, który porównuje średnie rangi par grup ze wspólnego rangowania. Wartości p trzeba skorygować, np. metodą Holma lub Bonferroniego. W R: rstatix::dunn_test(dane, wynik ~ grupa, p.adjust.method = "holm"). Nie zastępuj go serią testów Manna-Whitneya bez korekty.
Jak obliczyć wielkość efektu dla testu Kruskala-Wallisa?
Najprościej jako ε² = H / (N − 1) albo η²H = (H − k + 1) / (N − k). Przy H = 12.84, N = 60 i k = 3 daje to ε² = .22 i η²H = .19. Dla porównań par grup podaj korelację rangową dwuseryjną r.
Czy test Kruskala-Wallisa porównuje mediany?
Nie wprost. Test wykrywa różnice średnich rang, które mogą wynikać z przesunięcia rozkładów, ale także z różnej skośności lub rozproszenia. O różnicy median możesz mówić wtedy, gdy rozkłady w grupach mają podobny kształt – dlatego zawsze pokaż je na wykresie.
Jak zapisać wynik testu Kruskala-Wallisa w APA?
Podaj statystykę z liczbą stopni swobody, wartość p i wielkość efektu, np. H(2) = 12.84, p = .002, ε² = .22, a także mediany grup. Następnie opisz porównania post hoc z nazwą korekty, np. „test Dunna z korektą Holma: z = 3.44, p = .002”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikTesty nieparametryczne – zadania
Dziesięć zadań jak na kolokwium: Mann–Whitney, test znaków, Wilcoxon, Kruskal–Wallis z Dunnem, Friedman i Spearman – z rangami i rozwiązaniami krok po kroku.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Nahm, F. S. (2016). Nonparametric statistical tests for the continuous data: The basic concept and the practical use. Korean Journal of Anesthesiology, 69(1), 8–14. https://doi.org/10.4097/kjae.2016.69.1.8 ● Otwarty dostęp
- Vargha, A., & Delaney, H. D. (1998). The Kruskal-Wallis test and stochastic homogeneity. Journal of Educational and Behavioral Statistics, 23(2), 170–192. https://doi.org/10.3102/10769986023002170
Cytowania BibTeX
@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{kruskal1952use, author={Kruskal, William H. and Wallis, W. Allen}, title={{Use of ranks in one-criterion variance analysis}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={583--621}, doi={10.1080/01621459.1952.10483441}}@article{nahm2016nonparametric, author={Nahm, Francis Sahngun}, title={{Nonparametric statistical tests for the continuous data: The basic concept and the practical use}}, journal={Korean Journal of Anesthesiology}, year={2016}, volume={69}, number={1}, pages={8--14}, doi={10.4097/kjae.2016.69.1.8}}@article{vargha1998kruskal, author={Vargha, András and Delaney, Harold D.}, title={{The Kruskal-Wallis test and stochastic homogeneity}}, journal={Journal of Educational and Behavioral Statistics}, year={1998}, volume={23}, number={2}, pages={170--192}, doi={10.3102/10769986023002170}}