Co to jest test Kołmogorowa-Smirnowa?
Test Kołmogorowa-Smirnowa (test K–S, ang. Kolmogorov–Smirnov test) porównuje rozkłady za pomocą dystrybuant, czyli krzywych, które dla każdej wartości x pokazują, jaki odsetek wyników leży poniżej niej. Statystyką testu jest D – największa pionowa odległość między dwiema dystrybuantami. Test ma dwie wersje:
- dla jednej próby – czy wyniki w próbie są zgodne z rozkładem teoretycznym, np. rozkładem normalnym o określonej średniej i odchyleniu standardowym;
- dla dwóch prób – czy dwie niezależne grupy pochodzą z tego samego rozkładu; test reaguje na różnice położenia, rozproszenia i kształtu.
Nazwa pochodzi od dwóch rosyjskich matematyków: Andrieja Kołmogorowa i Nikołaja Smirnowa, który w 1948 roku opublikował tablicę do oceny zgodności rozkładów empirycznych (Smirnov, 1948). Test należy do testów nieparametrycznych: rozkład statystyki D przy prawdziwej hipotezie zerowej nie zależy od tego, z jakim ciągłym rozkładem porównujemy dane. W psychologii spotkasz go najczęściej w wydrukach SPSS przy sprawdzaniu normalności – tam jednak działa w zmodyfikowanej wersji, z poprawką Lillieforsa, o której piszemy niżej.
Statystyka D i dystrybuanta empiryczna
Dystrybuanta empiryczna Fn(x) to odsetek wyników w próbie mniejszych lub równych x. Ma kształt schodków: przy każdym wyniku rośnie o 1/n. Dystrybuanta teoretyczna F0(x) mówi, jaki odsetek wyników powinien leżeć poniżej x, gdyby prawdziwa była hipoteza zerowa. Statystyka testu to największa bezwzględna różnica między nimi:
W teście dwóch prób w miejsce F0 wstawia się dystrybuantę empiryczną drugiej grupy: D = max |F1(x) − F2(x)|. Massey (1951) opisał test właśnie jako oparty na maksymalnej różnicy między dystrybuantą empiryczną a hipotetyczną, podał tablice wartości krytycznych i przytoczył przesłanki, że test K–S przewyższa test chi-kwadrat zgodności.
D przyjmuje wartości od 0 (dystrybuanty się pokrywają) do 1. Im większe D i im większa próba, tym mniejsza wartość p. W dużych próbach przybliżona wartość krytyczna przy α = .05 wynosi 1.36/√n w teście jednej próby oraz 1.36 × √[(n1 + n2) / (n1n2)] w teście dwóch prób. Test zakłada zmienną ciągłą: przy wielu powtarzających się wynikach (np. sumach punktów krótkiej skali) wartość p jest tylko przybliżona, a R wyświetla ostrzeżenie o wartościach wiązanych (ties).
Przykład 1: czy wyniki są zgodne z normą testu?
Psycholożka szkolna zbadała testem inteligencji 60 uczniów pierwszej klasy liceum (dane symulowane). Podręcznik testu podaje normy populacyjne: μ = 100, σ = 15 (zob. normy testowe i skala IQ). W klasie średnia wyniosła M = 107.02, a odchylenie standardowe SD = 12.18. Czy rozkład wyników w tej klasie jest zgodny z rozkładem w populacji?
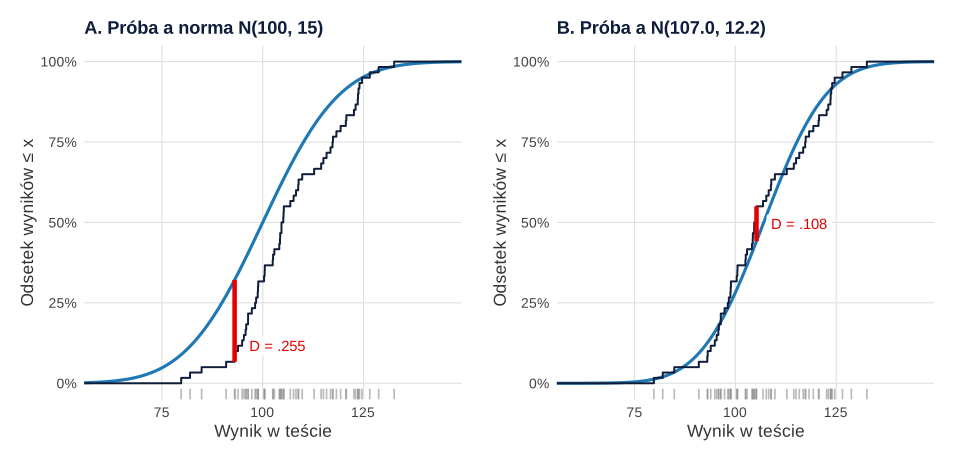
Test K–S dla jednej próby jest tu właściwym narzędziem, bo rozkład teoretyczny jest w pełni określony z góry: N(100, 15). Rysunek 1A pokazuje obie dystrybuanty. Największa różnica wypada przy wyniku 93: według normy niższy wynik ma 32.1% populacji, a w klasie – tylko 4 z 60 uczniów (6.7%). Stąd D = .255, p < .001. Rozkład w klasie różni się od normy: wyniki są przesunięte w górę i mniej zróżnicowane niż w populacji.
Zwróć uwagę, co zostało przetestowane: zgodność z konkretnym rozkładem, a nie sama normalność. Test K–S dla jednej próby reaguje na każdą różnicę – średniej, rozproszenia i kształtu – ale nie mówi, która z nich wystąpiła. Jeśli interesuje Cię tylko to, czy średnia klasy różni się od normy, użyj testu t dla jednej próby: ma większą moc dla tej jednej różnicy i daje oszacowanie jej wielkości.
Test normalności i poprawka Lillieforsa
Najczęściej pytanie brzmi jednak inaczej: czy wyniki mają rozkład normalny – o dowolnej średniej i dowolnym odchyleniu standardowym? Wtedy parametry rozkładu teoretycznego trzeba oszacować z tej samej próby. Na rysunku 1B krzywa normalna ma średnią 107.0 i odchylenie standardowe 12.2, więc „dopasowuje się” do danych, a odległość spada do D = .108.
Lilliefors (1967) zauważył, że standardowe tablice testu K–S są poprawne tylko wtedy, gdy rozkład jest w pełni określony. Gdy średnią i wariancję szacuje się z próby, potrzebne są inne wartości krytyczne – autor podał je w tablicy uzyskanej metodą Monte Carlo. Stąd nazwa test Lillieforsa albo test K–S z poprawką Lillieforsa. Różnica jest duża: w naszej symulacji 20 000 prób po 60 osób z rozkładu normalnego 95% wartości D nie przekraczało .173, gdy parametry były znane, ale tylko .115, gdy szacowano je z próby.
W przykładzie to samo D = .108 daje dwa różne wyniki:
- klasyczne p bez poprawki = .450 – błędne, bo obliczone tak, jakby parametry były znane z góry;
- p z poprawką Lillieforsa = .077 – poprawne; rozkład nie odbiega istotnie od normalnego, choć wynik jest bliski progu .05.
Test K–S bez poprawki jest więc w tej sytuacji bardzo zachowawczy. Steinskog i in. (2007) pokazali, że jego wartości p są wtedy silnie zawyżone – i że nie jest to problem wyłącznie małych prób – a poprawka Lillieforsa bywa mylona z oryginalnym testem. Ghasemi i Zahediasl (2012) odradzają test K–S, gdy parametry szacuje się z danych, niezależnie od liczebności próby. SPSS w procedurze Eksploracja podaje test K–S z poprawką Lillieforsa (przypis Lilliefors Significance Correction pod tabelą testów normalności). W R służy do tego funkcja lillie.test() z pakietu nortest, a nie ks.test().
Dlaczego do oceny normalności lepszy jest test Shapiro-Wilka?
Nawet z poprawką test K–S rzadziej niż test Shapiro-Wilka wykrywa rzeczywiste odstępstwa od normalności. Ghasemi i Zahediasl (2012) piszą, że test Shapiro-Wilka ma większą moc niż test K–S także po poprawce Lillieforsa, a samego testu K–S z powodu małej mocy nie warto poważnie brać pod uwagę przy ocenie normalności. Yap i Sim (2011) porównali w symulacjach osiem testów normalności: przy rozkładach asymetrycznych najmocniejszy był test Shapiro-Wilka, a po nim test Andersona–Darlinga. Sprawdziliśmy to w R dla prób po 30 i 100 osób:
| Rozkład w populacji | n | K–S bez poprawki | K–S z poprawką Lillieforsa | Shapiro-Wilk |
|---|---|---|---|---|
| Normalny (oczekiwane 5%) | 30 | 0.00% | 4.44% | 5.42% |
| Normalny (oczekiwane 5%) | 100 | 0.00% | 5.20% | 4.92% |
| Skośny (skośność = 1) | 30 | 0.50% | 24.80% | 45.02% |
| Skośny (skośność = 1) | 100 | 7.06% | 70.30% | 95.92% |
Test K–S bez poprawki ani razu na 5000 prób nie odrzucił normalności danych normalnych, ale też prawie nie wykrywał umiarkowanej skośności (7.06% prób przy 100 osobach). Poprawka Lillieforsa przywraca właściwy poziom błędu I rodzaju, jednak test Shapiro-Wilka wykrywał tę samą skośność wyraźnie częściej: przy 30 osobach w 45.02% prób wobec 24.80%.
Większa moc testu normalności to jednak miecz obosieczny. W dużych próbach każdy test – także Shapiro-Wilka – wykrywa odchylenia tak drobne, że nie wpływają na wyniki testów parametrycznych, a w małych próbach dane zwykle „przechodzą” test nawet przy wyraźnej skośności (Ghasemi i Zahediasl, 2012). Dlatego normalność oceniaj przede wszystkim na wykresie kwantylowym Q-Q i histogramie – w regresji i ANOVA dla reszt modelu, a nie surowej zmiennej. Całą procedurę opisujemy w poradniku jak sprawdzić normalność rozkładu.
Test Kołmogorowa-Smirnowa dla dwóch prób
Wersja dla dwóch prób odpowiada na pytanie, czy dwie niezależne grupy pochodzą z tego samego rozkładu. Przykład (dane symulowane): 40 osób obejrzało film neutralny, a 40 – film poruszający; mierzymy zmianę nastroju (po − przed). Średnie są zbliżone (0.33 i −0.35 punktu), ale film poruszający wywołał reakcje skrajne: u części osób nastrój wyraźnie się poprawił, u części – pogorszył (SD = 5.24 wobec 2.50 po filmie neutralnym).
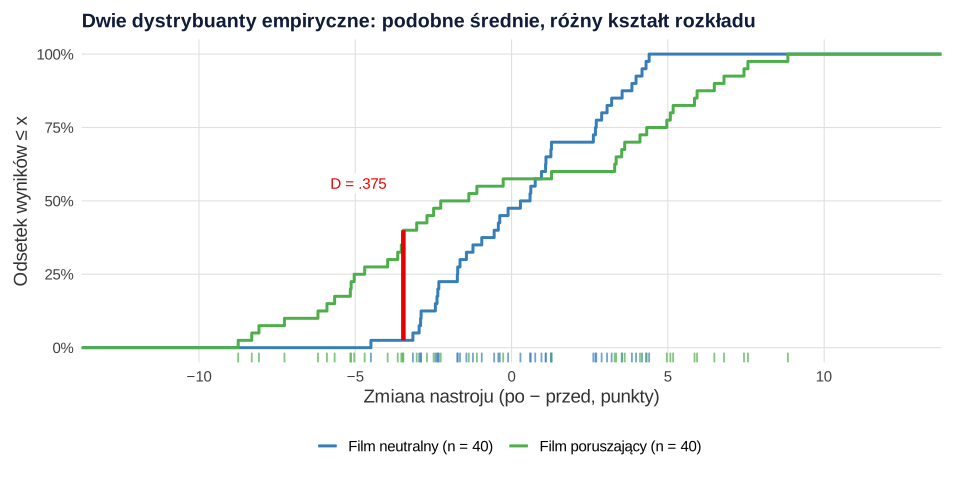
Największa różnica dystrybuant wypada przy zmianie o −3.46 punktu: pogorszenie nastroju o tyle lub więcej punktów wystąpiło u 40.0% osób po filmie poruszającym i tylko u 2.5% po filmie neutralnym. Test K–S daje D = .375, p = .007. Tymczasem test Welcha, t(55.86) = −0.74, p = .464, i test Manna-Whitneya, p = .402, nie wykazały różnicy – oba reagują przede wszystkim na przesunięcie wyników jednej grupy względem drugiej, a nie na różnicę kształtu.
To zaleta i ograniczenie zarazem. Istotny wynik testu K–S mówi tylko, że rozkłady się różnią, a nie jak – opis musisz oprzeć na wykresie i statystykach opisowych. Gdy pytanie dotyczy średnich, wybierz test Welcha; gdy tego, czy wyniki jednej grupy są zwykle wyższe – test Manna-Whitneya. Test K–S dla dwóch prób przydaje się wtedy, gdy hipoteza naprawdę dotyczy całego rozkładu, np. polaryzacji reakcji albo zmiany rozproszenia wyników.
Jak opisać wynik testu K–S w pracy (APA)
Podaj, z jakim rozkładem porównywano dane, wersję testu, statystykę D, liczebność i wartość p. Przy ocenie normalności zaznacz, że zastosowano poprawkę Lillieforsa – albo, lepiej, podaj wynik testu Shapiro-Wilka razem z opisem wykresu. Opis dla obu przykładów:
Przykład w R
Kod odtwarza oba przykłady: test zgodności z normą, test normalności bez poprawki i z poprawką Lillieforsa oraz test dwóch prób. Rysunki i symulację z tabeli przygotowano w osobnym skrypcie na tych samych danych. W SPSS test K–S z poprawką Lillieforsa znajdziesz w menu Analiza → Opis statystyczny → Eksploracja → Wykresy → Wykresy normalności z testami, a test dwóch prób w Analiza → Testy nieparametryczne → Próby niezależne.
Test K–S dla jednej i dwóch prób, test Lillieforsa
R
library(nortest)                               # lillie.test(): test K-S z poprawką Lillieforsa
# 1. Jedna próba: 60 uczniów, normy testu: mu = 100, sigma = 15 (dane symulowane)
set.seed(5)
iq <- rnorm(60, mean = 106, sd = 12)
round(c(M = mean(iq), SD = sd(iq)), 2)
ks.test(iq, "pnorm", mean = 100, sd = 15)      # zgodność z w pełni określonym rozkładem N(100, 15)

# 2. Normalność przy parametrach oszacowanych z próby
ks.test(iq, "pnorm", mean(iq), sd(iq))$p.value # BŁĄD: klasyczne p bez poprawki
lillie.test(iq)                                # poprawnie: poprawka Lillieforsa
shapiro.test(iq)                               # zwykle lepszy wybór do oceny normalności

# 3. Dwie próby: zmiana nastroju po filmie neutralnym i poruszającym
set.seed(3)
kontrolna <- rnorm(40, 0.5, 3)
film <- ifelse(rbinom(40, 1, 0.5) == 1, rnorm(40, 4.5, 2.5), rnorm(40, -4, 2.5))
ks.test(film, kontrolna)                       # czy rozkłady są takie same?
t.test(film, kontrolna)$p.value                # test Welcha: czy średnie są równe?
Wynik w R
     M     SD
107.02  12.18

	Exact one-sample Kolmogorov-Smirnov test

data:  iq
D = 0.25454, p-value = 0.0006484
alternative hypothesis: two-sided

[1] 0.4499915

	Lilliefors (Kolmogorov-Smirnov) normality test

data:  iq
D = 0.10838, p-value = 0.07679


	Shapiro-Wilk normality test

data:  iq
W = 0.97266, p-value = 0.1966


	Exact two-sample Kolmogorov-Smirnov test

data:  film and kontrolna
D = 0.375, p-value = 0.006761
alternative hypothesis: two-sided

[1] 0.4639669
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje ks.test(), shapiro.test() i t.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nortest (wersja 1.0.4): Gross, J., & Ligges, U. (2015). nortest: Tests for normality [R package]. https://doi.org/10.32614/CRAN.package.nortest
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Test K–S z parametrami z próby bez poprawki – w R
ks.test(x, "pnorm", mean(x), sd(x))daje zawyżone p (w przykładzie .450 zamiast .077), więc odstępstwa od normalności prawie nigdy nie są wykrywane. - Mylenie zgodności z normą z normalnością – porównanie z N(100, 15) sprawdza także średnią i rozproszenie, a nie tylko kształt rozkładu.
- „Rozkład jest normalny, bo p > .05” – nieistotny wynik oznacza jedynie brak podstaw do odrzucenia hipotezy zerowej; w małej próbie test często nie wykrywa wyraźnych odstępstw.
- Wybór analizy wyłącznie na podstawie testu normalności – w dużej próbie istotny wynik zwykle nie ma znaczenia praktycznego; decyduj na podstawie wykresu reszt i liczebności.
- Test K–S dla danych z wieloma powtórzeniami, np. odpowiedzi na jedno pytanie w skali 1–5 – test zakłada rozkład ciągły, więc jego p jest wtedy przybliżone.
- Odczytywanie istotnego testu dwóch prób jako różnicy średnich – test K–S wykrywa każdą różnicę rozkładów; opisz, na czym ona polega.
Najczęstsze pytania
Co sprawdza test Kołmogorowa-Smirnowa?
Sprawdza, czy rozkład wyników w próbie jest zgodny z rozkładem teoretycznym (wersja dla jednej próby) albo czy dwie grupy pochodzą z tego samego rozkładu (wersja dla dwóch prób). Statystyka D to największa odległość między dystrybuantami; istotny wynik oznacza, że rozkłady się różnią – położeniem, rozproszeniem albo kształtem.
Czym różni się test Kołmogorowa-Smirnowa od testu Shapiro-Wilka?
Oba mogą służyć do oceny normalności, ale test Shapiro-Wilka ma większą moc, czyli częściej wykrywa rzeczywiste odstępstwa – w symulacji na tej stronie przy 30 osobach wykrył umiarkowaną skośność w 45% prób, a test K–S z poprawką Lillieforsa w 25%. Test K–S jest za to ogólniejszy: porównuje dane z dowolnym rozkładem ciągłym i pozwala porównać dwie grupy.
Co to jest poprawka Lillieforsa?
To zestaw wartości krytycznych testu K–S dla sytuacji, gdy średnią i odchylenie standardowe rozkładu normalnego szacuje się z tej samej próby. Bez poprawki test jest bardzo zachowawczy: w przykładzie to samo D = .108 dało p = .450 bez poprawki i p = .077 z poprawką. W R test Lillieforsa wykonasz funkcją lillie.test() z pakietu nortest.
Jak interpretować test Kołmogorowa-Smirnowa w SPSS?
W tabeli Testy normalności z procedury Eksploracja odczytaj statystykę, df i istotność; przypis „Lilliefors Significance Correction” oznacza, że zastosowano poprawkę. Istotność < .05 wskazuje na odstępstwo od normalności, ale w dużej próbie bywa ono bez znaczenia praktycznego, a w małej test często go nie wykrywa – dlatego oceniaj też wykres Q-Q.
Kiedy użyć testu Kołmogorowa-Smirnowa dla dwóch prób?
Gdy hipoteza dotyczy całego rozkładu, a nie tylko średnich – np. tego, czy jedna grupa reaguje bardziej skrajnie albo jest bardziej zróżnicowana. W przykładzie grupy o zbliżonych średnich różniły się rozkładem (D = .375, p = .007), choć test Welcha i test Manna-Whitneya nie wykazały różnicy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505 ● Otwarty dostęp
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Massey, F. J., Jr. (1951). The Kolmogorov-Smirnov test for goodness of fit. Journal of the American Statistical Association, 46(253), 68–78. https://doi.org/10.1080/01621459.1951.10500769
- Smirnov, N. (1948). Table for estimating the goodness of fit of empirical distributions. The Annals of Mathematical Statistics, 19(2), 279–281. https://doi.org/10.1214/aoms/1177730256 ● Otwarty dostęp
- Steinskog, D. J., Tjøstheim, D. B., & Kvamstø, N. G. (2007). A cautionary note on the use of the Kolmogorov–Smirnov test for normality. Monthly Weather Review, 135(3), 1151–1157. https://doi.org/10.1175/mwr3326.1
- Yap, B. W., & Sim, C. H. (2011). Comparisons of various types of normality tests. Journal of Statistical Computation and Simulation, 81(12), 2141–2155. https://doi.org/10.1080/00949655.2010.520163 ● Otwarty dostęp
Cytowania BibTeX
@article{ghasemi2012normality, author={Ghasemi, Asghar and Zahediasl, Saleh}, title={{Normality tests for statistical analysis: A guide for non-statisticians}}, journal={International Journal of Endocrinology and Metabolism}, year={2012}, volume={10}, number={2}, pages={486--489}, doi={10.5812/ijem.3505}}@article{lilliefors1967kolmogorov, author={Lilliefors, Hubert W.}, title={{On the Kolmogorov-Smirnov test for normality with mean and variance unknown}}, journal={Journal of the American Statistical Association}, year={1967}, volume={62}, number={318}, pages={399--402}, doi={10.1080/01621459.1967.10482916}}@article{massey1951kolmogorov, author={Massey, Jr., Frank J.}, title={{The Kolmogorov-Smirnov test for goodness of fit}}, journal={Journal of the American Statistical Association}, year={1951}, volume={46}, number={253}, pages={68--78}, doi={10.1080/01621459.1951.10500769}}@article{smirnov1948table, author={Smirnov, N.}, title={{Table for estimating the goodness of fit of empirical distributions}}, journal={The Annals of Mathematical Statistics}, year={1948}, volume={19}, number={2}, pages={279--281}, doi={10.1214/aoms/1177730256}}@article{steinskog2007cautionary, author={Steinskog, Dag J. and Tjøstheim, Dag B. and Kvamstø, Nils G.}, title={{A cautionary note on the use of the Kolmogorov–Smirnov test for normality}}, journal={Monthly Weather Review}, year={2007}, volume={135}, number={3}, pages={1151--1157}, doi={10.1175/mwr3326.1}}@article{yap2011comparisons, author={Yap, B. W. and Sim, C. H.}, title={{Comparisons of various types of normality tests}}, journal={Journal of Statistical Computation and Simulation}, year={2011}, volume={81}, number={12}, pages={2141--2155}, doi={10.1080/00949655.2010.520163}}