Co to jest dystrybuanta empiryczna?
Dystrybuanta empiryczna (ang. empirical cumulative distribution function, ECDF) to funkcja, która dla każdej wartości x podaje odsetek obserwacji w próbie mniejszych lub równych x: Fn(x) = liczba(Xi ≤ x) / n. Jest próbkowym odpowiednikiem dystrybuanty teoretycznej. Na wykresie ma postać schodków: przy każdej obserwacji rośnie o 1/n, od 0 do 1.
Jak czytać wykres ECDF
Odczyt pionowy daje odsetek wyników do danego progu, a poziomy – percentyle, bo odwrotnością ECDF są kwantyle próby. W odróżnieniu od histogramu i estymatora jądrowego gęstości ECDF nie wymaga wyboru szerokości przedziałów ani pasma i pokazuje każdą obserwację. Dobrze porównuje kilka grup na jednym wykresie: krzywa przesunięta w prawo oznacza wyższe wyniki. Kształt rozkładu (skośność, dwa szczyty) widać jednak słabiej niż na histogramie, więc oba wykresy dobrze się uzupełniają.
Przykład
W symulowanej próbie 40 wyników testu (średnia 100, SD 15) Fn(100) = 0.425 i Fn(115) = 0.875, czyli 87.5% osób uzyskało najwyżej 115 punktów; dystrybuanta rozkładu normalnego daje w tym punkcie 0.841. Odwrotność ECDF daje medianę 102 (dolny i górny kwartyl: 92 i 107). Dvoretzky, Kiefer i Wolfowitz (1956) wykazali, że ECDF jest asymptotycznie minimaksowym estymatorem nieznanej dystrybuanty, a Massart (1990) podał najmniejszą stałą w ich nierówności. Daje to pasmo ufności 95% o szerokości ±0.215 przy n = 40 – przy małej próbie ECDF jest więc dość nieprecyzyjna.
ECDF a testy zgodności
Na ECDF opiera się test Kołmogorowa–Smirnowa (największa pionowa odległość od dystrybuanty teoretycznej) i pokrewne statystyki, które Stephens (1974) zestawił w przewodniku po testach zgodności, m.in. Cramér–von Mises i Anderson–Darling. Do oceny normalności czytelniejszy bywa wykres kwantylowy, bo odchylenia w ogonach są na nim lepiej widoczne.
Na rysunku
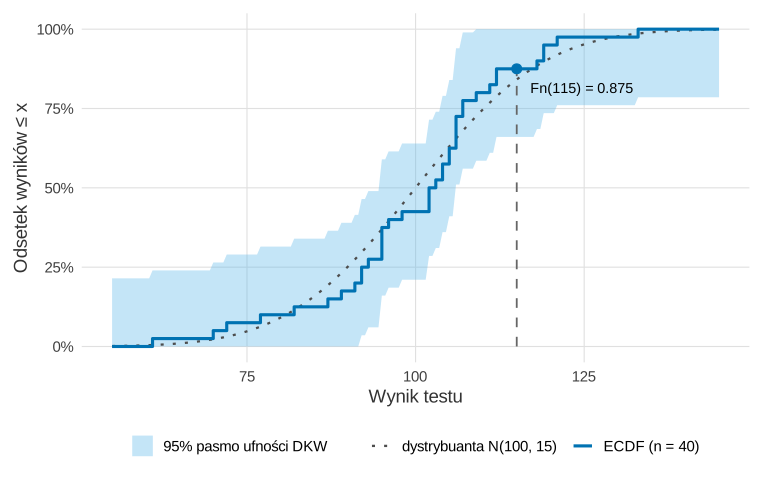
Co widać. Schodki ECDF rosną o 1/40 przy każdym wyniku (wyższe tam, gdzie wyniki się powtarzają). Dystrybuanta N(100, 15), z której losowano dane, mieści się w paśmie ±0.215 na całym zakresie. Zaznaczony punkt to Fn(115) = 0.875 z przykładu.
Na co uważać. Pasmo DKW obejmuje całą krzywą naraz, a nie każdy punkt osobno, i przy n = 40 jest szerokie: zmieściłoby się w nim wiele innych dystrybuant. Że krzywa teoretyczna nie wychodzi poza pasmo, nie dowodzi więc, że rozkład jest normalny.
Podpis do pracy:
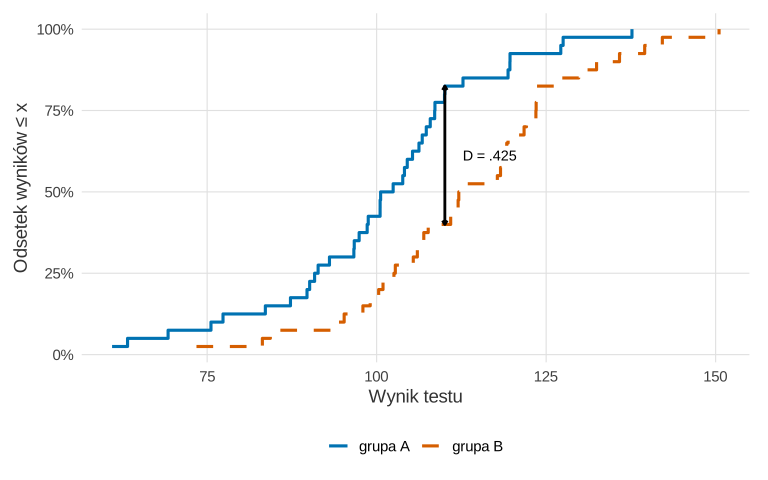
Co widać. Krzywa grupy B leży na prawo od krzywej A, czyli wyniki B są wyższe. Największa pionowa odległość przypada na wynik 110.1: najwyżej tyle uzyskało 82.5% osób z grupy A i 40% z grupy B. To statystyka testu Kołmogorowa–Smirnowa dla dwóch prób, D = .425, p = .0013. Średnie (100 i 110) i SD (15) ustalono ręcznie; ziarna nie zmieniano.
Na co uważać. D opisuje różnicę tylko w jednym miejscu osi i nie mówi, czy grupy różnią się położeniem, rozrzutem czy kształtem. Różnicę na całym zakresie kwantyli pokazuje funkcja przesunięcia, a odczyt median i odsetków poniżej progu z dwóch krzywych – wpis Rozkład zmiennej na wykresie.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: ECDF z pasmem ufności DKW oraz ECDF dwóch grup ze statystyką Kołmogorowa–Smirnowa
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(ecdf = "#0072B2", pasmo = "#56B4E9", teoria = "grey30", grupaB = "#D55E00", D = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: dane z przykładu (40 wyników), pasmo 95% DKW i dystrybuanta N(100, 15)
set.seed(56501)
wyniki <- round(rnorm(40, mean = 100, sd = 15))
Fn <- ecdf(wyniki)
eps <- sqrt(log(2 / 0.05) / (2 * length(wyniki)))      # połowa szerokości pasma DKW
siatka <- seq(55, 145, by = 0.5)
d1 <- data.frame(x = siatka, F = Fn(siatka), dol = pmax(0, Fn(siatka) - eps),
                 gor = pmin(1, Fn(siatka) + eps), teoria = pnorm(siatka, 100, 15))
round(c(eps = eps, poza_pasmem = mean(d1$teoria < d1$dol | d1$teoria > d1$gor)), 3)
p1 <- ggplot(d1, aes(x)) +
  geom_ribbon(aes(ymin = dol, ymax = gor, fill = "95% pasmo ufności DKW"), alpha = 0.35) +
  geom_line(aes(y = teoria, linetype = "dystrybuanta N(100, 15)"), colour = kol[["teoria"]], linewidth = 0.8) +
  geom_step(aes(y = F, linetype = "ECDF (n = 40)"), colour = kol[["ecdf"]], linewidth = 1.1) +
  annotate("segment", x = 115, xend = 115, y = 0, yend = Fn(115), colour = "grey40", linetype = "dashed") +
  annotate("point", x = 115, y = Fn(115), size = 3, colour = kol[["ecdf"]]) +
  annotate("text", x = 117, y = Fn(115) - 0.06, hjust = 0, size = 3.8,
           label = sprintf("Fn(115) = %.3f", Fn(115))) +
  scale_fill_manual(values = kol[["pasmo"]], name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid"), name = NULL,
                        guide = guide_legend(override.aes = list(colour = c(kol[["teoria"]], kol[["ecdf"]])))) +
  scale_y_continuous(labels = function(v) paste0(v * 100, "%")) +
  labs(x = "Wynik testu", y = "Odsetek wyników ≤ x") + motyw

# Rysunek 2: dwie grupy po 40 osób (średnie 100 i 110, SD 15 – ustalone ręcznie) i statystyka D
set.seed(56502)
a <- rnorm(40, 100, 15); b <- rnorm(40, 110, 15)
Fa <- ecdf(a); Fb <- ecdf(b)
punkty <- sort(c(a, b))
roznica <- Fa(punkty) - Fb(punkty)
x_D <- punkty[which.max(abs(roznica))]                  # miejsce największej pionowej odległości
ks <- ks.test(a, b)
round(c(D = unname(ks$statistic), x_D = x_D, Fa = Fa(x_D), Fb = Fb(x_D)), 3)
signif(c(p_KS = ks$p.value, p_t = t.test(a, b)$p.value), 2)   # dla porównania: test t
d2 <- rbind(data.frame(grupa = "grupa A", x = a), data.frame(grupa = "grupa B", x = b))
p2 <- ggplot(d2, aes(x, colour = grupa, linetype = grupa)) +
  stat_ecdf(linewidth = 1.1, pad = FALSE) +
  annotate("segment", x = x_D, xend = x_D, y = Fb(x_D), yend = Fa(x_D), colour = kol[["D"]],
           linewidth = 1, arrow = arrow(ends = "both", length = unit(0.12, "cm"))) +
  annotate("label", x = x_D + 2, y = (Fa(x_D) + Fb(x_D)) / 2, hjust = 0, size = 3.8,
           label = sub("0\\.", ".", sprintf("D = %.3f", unname(ks$statistic))), linewidth = 0, fill = "white") +
  scale_colour_manual(values = unname(kol[c("ecdf", "grupaB")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_y_continuous(labels = function(v) paste0(v * 100, "%")) +
  labs(x = "Wynik testu", y = "Odsetek wyników ≤ x") + motyw

p1   # zapis: ggsave("dystrybuanta-empiryczna-pasmo-dkw.svg", p1, width = 8, height = 5)
p2   # zapis: ggsave("dystrybuanta-empiryczna-dwie-grupy.svg", p2, width = 8, height = 5)
Wynik w R
        eps poza_pasmem
      0.215       0.000
      D     x_D      Fa      Fb
  0.425 110.060   0.825   0.400
   p_KS     p_t
0.00130 0.00064
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Jak opisać w pracy
Na co uważać
Nie myl osi: na pionowej są proporcje skumulowane, nie liczebności. Przy danych z wieloma powtórzeniami (np. skala 1–5) schodki są wysokie i należy pokazać je bez wygładzania. Gdy chcesz pokazać zarazem kształt rozkładu i pojedyncze punkty, rozważ wykres raincloud.
Dystrybuanta empiryczna w R
Kod tworzy ECDF funkcją ecdf(), odczytuje jej wartości i kwantyle oraz liczy szerokość pasma ufności 95% z nierówności DKW ze stałą Massarta.
Funkcja ecdf() i pasmo DKW
R
# Dystrybuanta empiryczna: odsetek wyników <= x
set.seed(56501)
wyniki <- round(rnorm(40, mean = 100, sd = 15))
Fn <- ecdf(wyniki)
round(c(Fn_100 = Fn(100), Fn_115 = Fn(115),
        teoretyczna_115 = pnorm(115, 100, 15)), 3)
quantile(wyniki, probs = c(0.25, 0.50, 0.75), type = 1)   # odwrotność ECDF
# pasmo ufności 95% z nierówności DKW (stała Massarta): Fn(x) +/- eps
n <- length(wyniki)
eps <- sqrt(log(2 / 0.05) / (2 * n))
round(c(n = n, eps = eps, dolna_115 = max(0, Fn(115) - eps),
        gorna_115 = min(1, Fn(115) + eps)), 3)
round(sqrt(log(2 / 0.05) / (2 * c(40, 100, 400))), 3)   # eps dla n = 40, 100, 400
# plot(Fn, main = "ECDF", xlab = "Wynik", ylab = "F(x)")
Wynik w R
         Fn_100          Fn_115 teoretyczna_115
          0.425           0.875           0.841
25% 50% 75%
 92 102 107
        n       eps dolna_115 gorna_115
   40.000     0.215     0.660     1.000
[1] 0.215 0.136 0.068
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów); rysunki wykonano w pakiecie ggplot2, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym wykres ECDF różni się od histogramu?
ECDF pokazuje skumulowany odsetek obserwacji do danej wartości i nie wymaga wyboru szerokości przedziałów. Histogram lepiej oddaje kształt rozkładu, ale jego wygląd zależy od podziału na przedziały.
Jak odczytać percentyl z dystrybuanty empirycznej?
Znajdź na osi pionowej żądany odsetek, np. 0.75, i odczytaj wartość na osi poziomej, przy której schodki go osiągają. To kwantyl próby, czyli odwrotność ECDF.
Jak szerokie jest pasmo ufności dla ECDF?
Z nierówności Dvoretzky’ego–Kiefera–Wolfowitza ze stałą Massarta pasmo 95% to ±√(ln(2/0.05)/(2n)), czyli ±0.215 przy n = 40 i ±0.068 przy n = 400.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikStatystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dvoretzky, A., Kiefer, J., & Wolfowitz, J. (1956). Asymptotic minimax character of the sample distribution function and of the classical multinomial estimator. The Annals of Mathematical Statistics, 27(3), 642–669. https://doi.org/10.1214/aoms/1177728174 ● Otwarty dostęp
- Massart, P. (1990). The tight constant in the Dvoretzky–Kiefer–Wolfowitz inequality. The Annals of Probability, 18(3), 1269–1283. https://doi.org/10.1214/aop/1176990746 ● Otwarty dostęp
- Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196
Cytowania BibTeX
@article{dvoretzky1956asymptotic, author={Dvoretzky, A. and Kiefer, J. and Wolfowitz, J.}, title={{Asymptotic minimax character of the sample distribution function and of the classical multinomial estimator}}, journal={The Annals of Mathematical Statistics}, year={1956}, volume={27}, number={3}, pages={642--669}, doi={10.1214/aoms/1177728174}}@article{massart1990tight, author={Massart, P.}, title={{The tight constant in the Dvoretzky–Kiefer–Wolfowitz inequality}}, journal={The Annals of Probability}, year={1990}, volume={18}, number={3}, pages={1269--1283}, doi={10.1214/aop/1176990746}}@article{stephens1974edf, author={Stephens, M. A.}, title={{EDF statistics for goodness of fit and some comparisons}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={347}, pages={730--737}, doi={10.1080/01621459.1974.10480196}}