Co to jest wykres łodygowo-liściowy?
Wykres łodygowo-liściowy (ang. stem-and-leaf plot) to tekstowy obraz rozkładu zmiennej ilościowej. Każdy wynik rozbija się na dwie części: łodygę, czyli cyfry wiodące, i liść, czyli następną cyfrę. Wyniki o tej samej łodydze trafiają do jednego wiersza, a ich liście zapisuje się po kolei, od najmniejszego. Upowszechnił go Tukey (1977) jako narzędzie eksploracyjnej analizy danych, choć sam pomysł jest znacznie starszy: Missiakoulis (2019) wskazuje taki zapis już u Flegona z Tralles w II wieku, w spisie osób, które dożyły ponad stu lat.
Długość wiersza liści działa jak słupek histogramu. Różnica polega na tym, że wykres nie gubi danych: z liści da się odtworzyć każdą wartość.
Jak czytać wykres
- Legenda jednostki. Zapis „1 | 5” znaczy 15, jeśli łodyga to dziesiątki. R podaje to zdaniem o położeniu przecinka nad wykresem.
- Kształt. Obróć wykres o 90° i patrz na długość wierszy: widać szczyt, skośność i luki.
- Położenie. Liczysz liście od góry do połowy próby i odczytujesz medianę, a tak samo kwartyle.
- Cyfry liści. Gdy jedne cyfry powtarzają się podejrzanie często, dane były zaokrąglane albo pochodzą z kilku źródeł.
Przykład
Czterdziestu studentów podało czas dojazdu na uczelnię w minutach (dane symulowane). Wyniki mieszczą się między 5 a 59 minut, mediana wynosi 29.5, a zawiasy Tukeya, odpowiednik kwartyli, to 17.5 i 40. W pięciu wierszach od 10 do 59 minut jest po 8–9 osób. Najciekawsze są jednak liście: 24 z 40 (60%) to zera i piątki, choć przy dokładnym pomiarze każda z dziesięciu cyfr pojawiałaby się mniej więcej w co dziesiątym wyniku, więc obie razem w około 20%. Ludzie podający czas „na oko” zaokrąglają go do pełnych pięciu minut. Parametry symulacji (rozkład czasu i 60% osób zaokrąglających) ustawiono ręcznie, żeby to zjawisko było wyraźne; ziarna (734) nie zmieniano.
Na rysunku
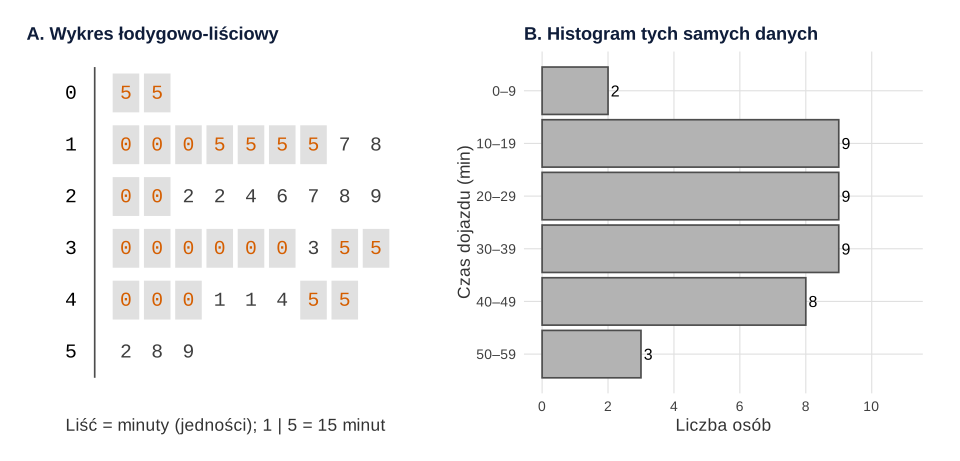
set.seed(734)).Co widać. Oba panele mają ten sam kształt: wiersze liści w panelu A są tak długie jak słupki w panelu B (2, 9, 9, 9, 8 i 3 osoby). Panel A pokazuje jednak coś, czego histogram nie zdradza – w każdym wierszu dominują liście 0 i 5. To ślad zaokrąglania, który zniknąłby w każdym histogramie o przedziałach szerszych niż kilka minut.
Na co uważać. Wykres łodygowo-liściowy nie pokazuje gęstości ani porównania kilku grup tak wygodnie jak wykres pudełkowy czy dystrybuanta empiryczna. Jego wygląd, podobnie jak wygląd histogramu, zależy od wyboru szerokości przedziału, czyli łodygi; Scott (1979) opisuje, jak tę szerokość dobierać w histogramie. Więcej rysunków jednego rozkładu zebrano we wpisie rozkład zmiennej na wykresie.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Zawsze podaj jednostkę. Bez legendy „3 | 5” może znaczyć 3.5, 35 albo 350.
- Argument
scalezmienia obraz. W przykładziescale = 0.5łączy po dwie łodygi i liść „5” z wiersza „0” oznacza zarówno 5, jak i 15 minut – wiersz traci informację o dziesiątkach. Z koleiscale = 2rozbija wiersze na połówki 0–4 i 5–9. - Tylko małe próby. Przy kilkuset obserwacjach wiersze robią się nieczytelne – wtedy wybierz histogram albo wykres punktowy.
- Liść to jedna cyfra. Dokładniejsze wartości
stem()zaokrągla do cyfry liścia (np. 2.97 pojawi się jako 3 | 0), więc z wykresu nie odczytasz pełnej dokładności pomiaru.
Jak zestawić statystyki opisowe z rysunkiem rozkładu, opisuje wpis statystyki opisowe w pracy.
Wykres łodygowo-liściowy w R
Kod symuluje 40 czasów dojazdu, wypisuje wykres łodygowo-liściowy funkcją stem() przy trzech ustawieniach scale, liczy pięć liczb Tukeya i odsetek liści 0 lub 5, a na końcu buduje rysunek 1 w ggplot2. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
stem() przy trzech skalach i rysunek 1
R
# Wykres łodygowo-liściowy: czas dojazdu 40 studentów (dane symulowane) – stem() i histogram tych samych danych
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(okragly = "#D55E00", inny = "grey25")          # Okabe–Ito; liście 0 i 5 także pogrubione i na szarym tle
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(734)
n <- 40
prawdziwy <- rgamma(n, shape = 4, rate = 0.12)          # „prawdziwy” czas dojazdu w minutach
zaokr <- runif(n) < 0.6                                # 60% osób podaje czas zaokrąglony do 5 minut
czas <- pmax(ifelse(zaokr, 5 * round(prawdziwy / 5), round(prawdziwy)), 3)
stem(czas)                                             # łodyga = dziesiątki minut, liść = jedności
stem(czas, scale = 2)                                  # każda łodyga rozbita na dwa wiersze (0–4, 5–9)
stem(czas, scale = 0.5)                                # łodyga co 20 minut – liście tracą dziesiątki
fivenum(czas)                                          # minimum, zawiasy (kwartyle Tukeya), mediana, maksimum
lisc <- czas %% 10
round(c(odsetek_lisci_0_lub_5 = mean(lisc %in% c(0, 5))), 2)

# Rysunek 1: ta sama próba jako wykres łodygowo-liściowy (A) i histogram o przedziałach 10 minut (B)
d <- data.frame(czas, lodyga = czas %/% 10, lisc)
d <- d[order(d$lodyga, d$lisc), ]
d$poz <- ave(d$lisc, d$lodyga, FUN = seq_along)        # miejsce liścia w wierszu
d$rodzaj <- ifelse(d$lisc %in% c(0, 5), "okragly", "inny")
lodygi <- 0:5
pA <- ggplot(d, aes(poz, lodyga)) +
  geom_tile(data = subset(d, rodzaj == "okragly"), width = 0.85, height = 0.75, fill = "grey88") +
  geom_text(aes(label = lisc, colour = rodzaj, fontface = ifelse(rodzaj == "okragly", "bold", "plain")),
            family = "mono", size = 5.2) +
  annotate("text", x = -0.6, y = lodygi, label = lodygi, family = "mono", size = 5.2, hjust = 1) +
  annotate("segment", x = 0, xend = 0, y = -0.5, yend = 5.5, colour = "grey30") +
  scale_colour_manual(values = kol, guide = "none") +
  scale_y_reverse(breaks = NULL) + scale_x_continuous(breaks = NULL, limits = c(-1.6, 10)) +
  labs(title = "A. Wykres łodygowo-liściowy", x = "Liść = minuty (jedności); 1 | 5 = 15 minut", y = NULL)
licz <- as.data.frame(table(lodyga = factor(d$lodyga, levels = lodygi)))
licz$lodyga <- as.numeric(as.character(licz$lodyga))
pB <- ggplot(licz, aes(Freq, lodyga)) +
  geom_col(orientation = "y", width = 0.9, fill = "grey70", colour = "grey30") +
  geom_text(aes(label = Freq), hjust = -0.3, size = 4.2) +
  scale_y_reverse(breaks = lodygi, labels = paste0(lodygi * 10, "–", lodygi * 10 + 9)) +
  scale_x_continuous(limits = c(0, 11), breaks = seq(0, 10, 2)) +
  labs(title = "B. Histogram tych samych danych", x = "Liczba osób", y = "Czas dojazdu (min)")
p1 <- (pA + pB) & motyw
p1
Wynik w R
  The decimal point is 1 digit(s) to the right of the |

  0 | 55
  1 | 000555578
  2 | 002246789
  3 | 000000355
  4 | 00011455
  5 | 289


  The decimal point is 1 digit(s) to the right of the |

  0 | 55
  1 | 000
  1 | 555578
  2 | 00224
  2 | 6789
  3 | 0000003
  3 | 55
  4 | 000114
  4 | 55
  5 | 2
  5 | 89


  The decimal point is 1 digit(s) to the right of the |

  0 | 55000555578
  2 | 002246789000000355
  4 | 00011455289

[1]  5.0 17.5 29.5 40.0 59.0
odsetek_lisci_0_lub_5
                  0.6
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje stem() i fivenum() z pakietów bazowych; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak czytać zapis 3 | 5 na wykresie łodygowo-liściowym?
Łodyga 3 to cyfra dziesiątek, a liść 5 to cyfra jedności, więc zapis oznacza wynik 35. Jednostkę zawsze sprawdź w legendzie wykresu, bo przy innej skali 3 | 5 może znaczyć 3.5 albo 350.
Kiedy wykres łodygowo-liściowy jest lepszy od histogramu?
Przy małych próbach, mniej więcej do 50–100 obserwacji, gdy chcesz widzieć konkretne wartości: zaokrąglanie do pełnych liczb, powtórzenia, luki lub pojedyncze odstające wyniki. Przy dużych próbach wiersze liści stają się za długie i lepszy jest histogram.
Jak zrobić wykres łodygowo-liściowy w R?
Wystarczy bazowa funkcja stem(x), która wypisuje wykres w konsoli. Argument scale zmienia długość łodyg: scale = 2 rozbija każdą łodygę na dwa wiersze, a scale = 0.5 łączy sąsiednie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikStatystyki opisowe w pracy
Co policzyć dla jakiej zmiennej, jak zbudować tabelę APA, ile miejsc po przecinku podać, jak pokazać braki danych i które wykresy wybrać – na jednym przykładzie z R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Missiakoulis, S. (2019). Phlegon's stem-and-leaf display. The American Statistician, 73(1), 89–93. https://doi.org/10.1080/00031305.2017.1328376
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Cytowania BibTeX
@article{missiakoulis2019phlegon, author={Missiakoulis, Spyros}, title={{Phlegon's stem-and-leaf display}}, journal={The American Statistician}, year={2019}, volume={73}, number={1}, pages={89--93}, doi={10.1080/00031305.2017.1328376}}@article{scott1979optimal, author={Scott, David W.}, title={{On optimal and data-based histograms}}, journal={Biometrika}, year={1979}, volume={66}, number={3}, pages={605--610}, doi={10.1093/biomet/66.3.605}}@book{tukey1977exploratory, author={Tukey, John W.}, title={{Exploratory data analysis}}, year={1977}, publisher={Addison-Wesley}}