Statystyki opisowe zmiennych badanych: po co i gdzie w pracy
Rozdział wyników prawie zawsze zaczyna się od statystyk opisowych. Zanim przetestujesz pierwszą hipotezę, czytelnik powinien zobaczyć, jak rozkładają się zmienne, o których piszesz: jaki wynik jest typowy, jak bardzo osoby się różnią, czy rozkład jest symetryczny i ilu odpowiedzi brakuje. Promotor i recenzent sprawdzają tę część uważnie z prostego powodu: to w niej widać błędy w danych, źle dobrane miary i rozkłady, przy których zaplanowane testy tracą sens.
Ten poradnik dotyczy zmiennych badanych – wyników kwestionariuszy, testów, czasów, ocen i odpowiedzi na pojedyncze pytania, które wchodzą do hipotez. Opis osób badanych (płeć, wiek, kierunek studiów) to osobny element pracy, zwykle w podrozdziale „Osoby badane”. Jak go przygotować, pokazują wpisy jak opisać charakterystykę próby i wzór przedstawienia charakterystyki próby. Tutaj przechodzimy przez jedno badanie od surowej bazy do gotowej tabeli, wykresów i akapitu w stylu APA.
Plan jest prosty i warto trzymać się kolejności:
- ustal poziom pomiaru każdej zmiennej;
- sprawdź zakres wartości, zanim policzysz cokolwiek innego;
- dla zmiennych ilościowych policz M i SD, a przy skośnych rozkładach także Me i IQR;
- dla zmiennych kategorialnych podaj liczebności i odsetki;
- oceń kształt rozkładu: skośność, kurtozę i wykres;
- zbierz wszystko w tabeli, opisz braki danych i ustal liczbę miejsc po przecinku.
Krok 1. Ustal poziom pomiaru każdej zmiennej
To, jakie statystyki mają sens, zależy najpierw od poziomu pomiaru. Stevens (1946) wyróżnił cztery skale i dla każdej wskazał statystyki dopuszczalne: dla skali nominalnej liczbę przypadków i dominantę, dla porządkowej medianę i percentyle, dla interwałowej średnią i odchylenie standardowe. W praktyce pracy dyplomowej skale interwałową i ilorazową łączy się w skalę ilościową, a ważniejsze od nazwy skali staje się to, jaki kształt ma rozkład.
| Rodzaj zmiennej | Przykład z psychologii | Co podać | Wykres |
|---|---|---|---|
| Nominalna | chronotyp, forma terapii, warunek eksperymentalny | n i % w każdej kategorii; ewentualnie dominanta | słupkowy |
| Porządkowa | pojedyncza pozycja 1–5, rok studiów, poziom wykształcenia | n i % w kategoriach; Me i kwartyle | słupkowy (kategorie w naturalnej kolejności) |
| Ilościowa, rozkład zbliżony do symetrycznego | wynik skali stresu, wynik testu wiedzy, liczba godzin snu | M, SD, zakres, skośność i kurtoza | histogram |
| Ilościowa, rozkład wyraźnie skośny | czas zasypiania, czas reakcji, liczba objawów | Me i IQR (obok M i SD), zakres, skośność i kurtoza | histogram, wykres pudełkowy |
Tabela porządkuje wybór, ale nie zastępuje myślenia. Velleman i Wilkinson (1993) pokazali, że typologia Stevensa użyta jako sztywny przepis wprowadza w błąd: poziom pomiaru nie jest stałą cechą liczb, tylko zależy od pytania badawczego i od tego, co wiesz o sposobie pomiaru. Najczęstszy przypadek w psychologii to skala Likerta. Odpowiedź na jedną pozycję jest porządkowa, więc opisuje się ją medianą i rozkładem odpowiedzi. Wynik całej skali złożonej z wielu pozycji można natomiast opisywać średnią i analizować metodami parametrycznymi, jeśli łączenie pozycji uzasadniają dowody rzetelności lub struktury (Sullivan i Artino, 2013). Czy wynik skali liczyć jako sumę, czy średnią pozycji, wyjaśniamy w haśle wynik skali: średnia czy suma.
Program policzy średnią z każdej kolumny liczb, także z kodów kategorii. Średnia chronotypu zakodowanego jako 1, 2 i 3 nic nie znaczy, więc w tabeli jej nie umieszczaj, nawet jeśli SPSS ją wydrukuje.
Przykład: sen i stres w grupie 236 osób studiujących
Wszystkie liczby w tym wpisie pochodzą z jednego zbioru danych symulowanych w R. Wyobraź sobie badanie do pracy magisterskiej o związku stresu ze snem. Ankietę wypełniło 236 osób studiujących, a do analiz weszło sześć zmiennych:
- stres – wynik Skali Odczuwanego Stresu PSS-10, od 0 do 40 punktów;
- samoocena – wynik skali samooceny, od 10 do 40 punktów;
- czas snu – deklarowana liczba godzin snu w dni nauki;
- czas zasypiania – deklarowana liczba minut od położenia się do zaśnięcia;
- jakość snu – odpowiedź na jedno pytanie od 1 („bardzo zła”) do 5 („bardzo dobra”);
- chronotyp – poranny, pośredni albo wieczorny.
Cztery pierwsze zmienne są ilościowe, jakość snu – porządkowa, chronotyp – nominalny. W bazie są braki danych: 4 osoby nie wypełniły skali samooceny, 9 nie podało czasu zasypiania, a 2 pominęły pytanie o jakość snu. Jest też jeden błąd wpisania, do którego wrócimy za chwilę. Surową bazę możesz pobrać i przećwiczyć na niej wszystkie kroki: statystyki-opisowe-dane-sen-stres.csv (plik CSV, 236 wierszy, puste komórki to braki danych). Jak przygotować taką bazę od początku, opisujemy we wpisie jak przygotować bazę danych do analizy.
Krok 2. Zacznij od zakresu: minimum i maksimum
Zakres, czyli najmniejsza i największa wartość, to najprostsza statystyka, a zarazem najlepszy test jakości danych. Porównaj go z zakresem możliwym: wynik PSS-10 nie może przekroczyć 40, odpowiedź na pozycję 1–5 nie może wynosić 6, a doba ma 24 godziny. W naszej bazie wszystkie zmienne mieszczą się w swoich granicach poza jedną: maksymalny czas snu wynosi 68 godzin. To oczywista literówka – ktoś wpisał 68 zamiast 6.8.
Taki błąd psuje średnią i odchylenie standardowe znacznie bardziej, niż mogłoby się wydawać. Z błędną wartością średni czas snu wynosi 6.94 h, a SD = 4.12 h. Po poprawce średnia spada do 6.68 h, a odchylenie standardowe do 1.01 h – czterokrotnie. Mediana w obu wersjach wynosi 6.75 h, bo jedna skrajna wartość jej nie przesuwa. Gdybyś pominął ten krok, opisałbyś próbę, w której sen „bardzo się różni”, a każdy test z udziałem tej zmiennej byłby obciążony.
Błąd popraw w danych źródłowych, a nie przez usunięcie osoby. Sprawdź oryginalną ankietę lub arkusz, a jeśli się nie da, ustaw wartość jako brak danych i opisz to w pracy. Literówki to co innego niż prawdziwe, choć nietypowe wyniki: tym drugim poświęciliśmy wpis wartości odstające – jak je wykryć. Zakres warto też podać w tabeli, bo pokazuje czytelnikowi, czy próba wykorzystała całą skalę. W naszych danych samoocena wynosi od 19 do 39 punktów: nikt nie zbliżył się do minimum skali, czyli 10.
Krok 3. Średnia i odchylenie standardowe
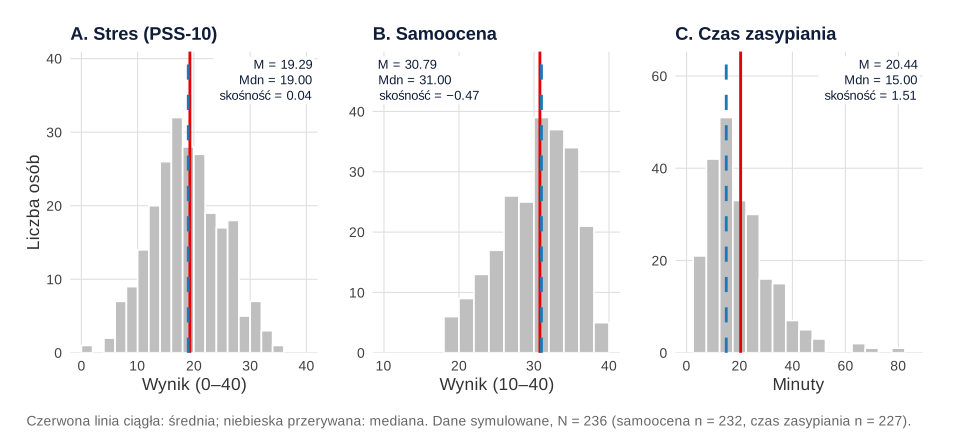
Dla zmiennej ilościowej o rozkładzie zbliżonym do symetrycznego podstawowa para to średnia (M) i odchylenie standardowe (SD). Średni wynik stresu wynosi 19.29 punktu (SD = 6.27), a mediana 19.00 – obie miary prawie się pokrywają, co już sugeruje symetrię. Podobnie jest z czasem snu: M = 6.68 h, SD = 1.01 h, Me = 6.75 h.
Częsty błąd to podawanie w tabeli błędu standardowego zamiast odchylenia standardowego. Altman i Bland (2005) wyjaśniają różnicę: SD opisuje zmienność wyników osób, a SE mówi o niepewności oszacowania średniej i służy wnioskowaniu. Dla stresu SD = 6.27, a SE = 0.41. Mniejsza liczba „ładniej” wygląda, ale w opisie danych potrzebujesz SD. Jeśli chcesz pokazać precyzję średniej, podaj 95% przedział ufności i nazwij go wprost.
Krok 4. Mediana i rozstęp ćwiartkowy przy skośnym rozkładzie
Czas zasypiania ma typowy dla czasów rozkład prawostronnie skośny: większość osób zasypia w kilkanaście minut, ale kilka potrzebuje godziny lub więcej. Średnia wynosi 20.44 min (SD = 12.38), a mediana tylko 15.00 min. Średnia leży powyżej wyniku 64.8% osób, więc trudno nazwać ją wynikiem typowym.
Jeszcze wyraźniej widać problem na przedziale „średnia ± odchylenie standardowe”. Przy rozkładzie normalnym obejmuje on środkowe dwie trzecie wyników. Tutaj wynosi od 8.06 do 32.82 min, a przedział M ± 2SD zaczynałby się od −4.33 min, czyli od wartości niemożliwej. Gdy M − 2SD wypada poza możliwy zakres, para M i SD źle streszcza rozkład. Lepiej opisuje go mediana z kwartylami: Me = 15 min, Q1 = 10 min, Q3 = 25 min, czyli połowa osób zasypia w czasie od 10 do 25 minut. Różnica Q3 − Q1 to rozstęp ćwiartkowy (IQR) i wynosi 15 min. W tabeli podawaj raczej same kwartyle (Q1–Q3) niż tylko IQR, bo z kwartyli czytelnik od razu odczyta asymetrię.
Zwróć uwagę na drobny, ale ważny szczegół techniczny. Kwartyle można liczyć na kilka sposobów, a różne programy wybierają różne definicje (Hyndman i Fan, 1996). Według dokumentacji funkcji quantile() w R typ 6 stosują SPSS i Minitab, a samo R domyślnie liczy typ 7. Przy dużych próbach różnice zwykle znikają, ale w mniejszych grupach bywają widoczne. W grupie 51 osób o chronotypie porannym pierwszy kwartyl czasu zasypiania wynosi 10.0 min według typu 6 i 12.5 min według typu 7. Jeśli liczysz w R, a promotor sprawdza w SPSS, ustaw type = 6 i napisz w nocie tabeli, jak liczono kwartyle.
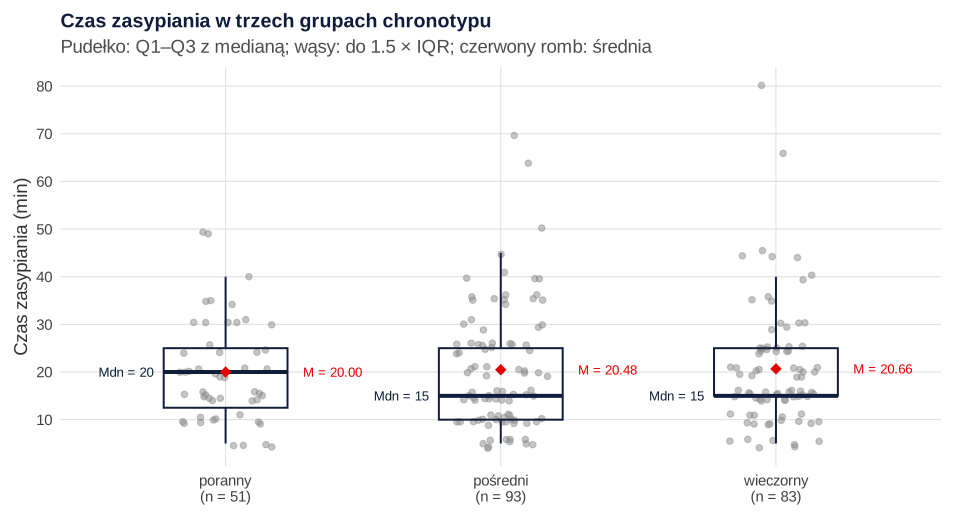
Wykres pudełkowy pokazuje to, czego nie widać w samej średniej. Średnie trzech grup są prawie równe (20.00, 20.48 i 20.66 min), ale mediany już nie: w grupie porannej wynosi 20 min, w dwóch pozostałych 15 min. Rozkłady w grupach pośredniej i wieczornej mają też dłuższe prawe ogony. Krzywinski i Altman (2014) przypominają, że nie ma jednej metody liczenia kwartyli, dlatego w podpisie wykresu pudełkowego trzeba opisać jego konstrukcję i podać liczebność grup. Więcej o czytaniu takich wykresów znajdziesz w haśle wykres pudełkowy.
Krok 5. Liczebności i odsetki dla zmiennych kategorialnych
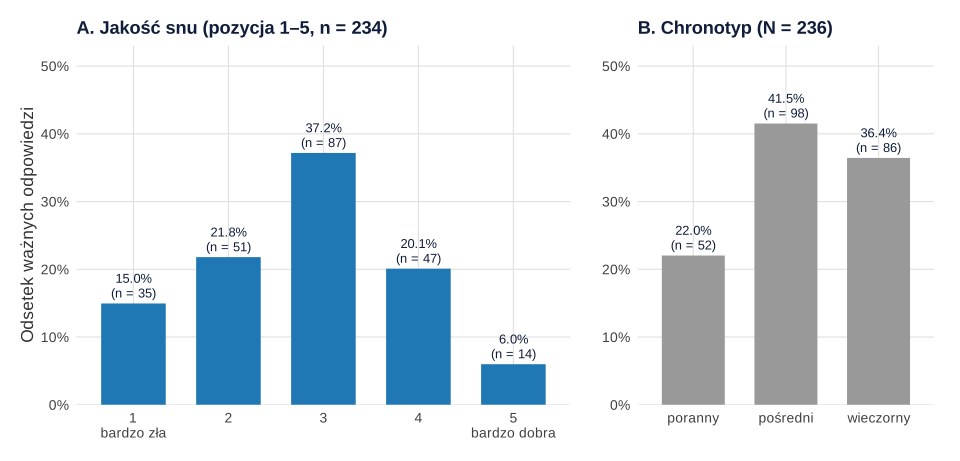
Dla chronotypu jedyną sensowną informacją jest rozkład kategorii: 52 osoby (22.0%) to typ poranny, 98 (41.5%) – pośredni, a 86 (36.4%) – wieczorny. Przy zmiennych kategorialnych zawsze podawaj liczebność obok odsetka. Sam odsetek ukrywa wielkość grupy, a z liczebności czytelnik sam przeliczy procenty.
Przy jakości snu pojawia się pytanie, od czego liczyć procenty. Dwie osoby nie odpowiedziały, więc są dwa mianowniki: wszyscy uczestnicy (N = 236) albo tylko osoby, które odpowiedziały (n = 234). Programy statystyczne zwykle pokazują oba warianty obok siebie. W pracy podawaj odsetki ważnych odpowiedzi i napisz, ile było braków.
| Jakość snu | n | % wszystkich | % ważnych | % skumulowany |
|---|---|---|---|---|
| 1 – bardzo zła | 35 | 14.8 | 15.0 | 15.0 |
| 2 | 51 | 21.6 | 21.8 | 36.8 |
| 3 | 87 | 36.9 | 37.2 | 73.9 |
| 4 | 47 | 19.9 | 20.1 | 94.0 |
| 5 – bardzo dobra | 14 | 5.9 | 6.0 | 100.0 |
| Brak odpowiedzi | 2 | 0.8 | – | – |
Ponieważ jakość snu to pozycja porządkowa, oprócz rozkładu odpowiedzi możesz podać medianę i kwartyle: Me = 3, Q1 = 2, Q3 = 4. Odsetek skumulowany przydaje się w opisie: 36.8% osób oceniło swój sen jako zły albo bardzo zły (odpowiedzi 1–2), a tylko 6.0% jako bardzo dobry. Średnia z takiej pozycji jest często spotykana, ale sugeruje równe odstępy między odpowiedziami, których nikt nie sprawdził. Jeśli promotor jej wymaga, podaj ją obok mediany, a nie zamiast niej.
Krok 6. Skośność i kurtoza: kształt rozkładu w dwóch liczbach
Skośność mówi o asymetrii rozkładu: wartość dodatnia oznacza dłuższy prawy ogon, ujemna – lewy. Kurtoza bywa opisywana jako „spiczastość”, ale Westfall (2014) pokazuje, że ta interpretacja jest myląca. Kurtoza mówi przede wszystkim o ogonach rozkładu, czyli o tym, jak często pojawiają się wyniki skrajne, a niewiele o kształcie szczytu. Programy zwykle podają kurtozę „nadwyżkową”, od której odjęto 3, tak by dla rozkładu normalnego wynosiła 0 (Kim, 2013).
W naszych danych stres i czas snu mają skośność i kurtozę bliskie zera (stres: 0.04 i −0.18; czas snu: −0.07 i −0.10). Samoocena jest lekko lewostronnie skośna (−0.47), bo wiele osób ocenia siebie dość wysoko. Czas zasypiania ma skośność 1.51 i kurtozę 3.57. Takie wartości nie są w psychologii wyjątkiem. Blanca i in. (2013) przeanalizowali 693 rozkłady zmiennych psychologicznych z małych prób i tylko 5.5% z nich było bliskich wartościom oczekiwanym przy normalności. Skośność wahała się od −2.49 do 2.33, a kurtoza od −1.92 do 7.41.
Który wzór policzył program?
Skośność i kurtozę można estymować kilkoma wzorami, a pakiety statystyczne używają różnych (Joanes i Gill, 1998). Według dokumentacji pakietu e1071 w R SPSS i SAS stosują wzór nazwany tam typem 2. Funkcja describe() z popularnego pakietu psych domyślnie liczy typ 3. Dla czasu zasypiania daje to skośność 1.51 (typ 2) albo 1.49 (typ 3) i kurtozę 3.57 albo 3.41. Przy 227 osobach różnice są małe, ale w małych grupach rosną, a promotor porównujący Twoje liczby z wydrukiem SPSS zobaczy rozbieżność. W tabeli z tego wpisu użyliśmy typu 2, czyli wartości zgodnych z SPSS, i napisaliśmy to w nocie.
Jak ocenić, czy odstępstwo jest duże?
Kim (2013) proponuje dzielić skośność i kurtozę przez ich błędy standardowe, a uzyskane wartości z oceniać zależnie od liczebności próby:
- poniżej 50 osób – odstępstwo, gdy |z| > 1.96;
- od 50 do 300 osób – gdy |z| > 3.29;
- powyżej 300 osób – wartości z pomija się, a o wyraźnym odstępstwie świadczy bezwzględna skośność powyżej 2 albo kurtoza powyżej 7 przed odjęciem 3 (czyli kurtoza nadwyżkowa powyżej 4); wtedy decyduje też histogram.
Przy 227–236 osobach błąd standardowy skośności wynosi 0.16, a kurtozy 0.32. Dla czasu zasypiania z = 9.37 dla skośności i 11.09 dla kurtozy – daleko powyżej progu 3.29. Samoocena (z = −2.91) mieści się poniżej progu, choć asymetria jest widoczna na rysunku 1. Sama kurtoza czasu zasypiania przed odjęciem 3 wynosi 6.57, czyli tuż poniżej granicy 7 stosowanej dla dużych prób. Widać tu, że progi są tylko konwencją, więc decyzję zawsze opieraj także na wykresie. W SPSS skośność i kurtozę z błędami standardowymi znajdziesz w oknie Analyze → Descriptive Statistics → Explore (Kim, 2013). Jak czytać pozostałe tabele tego wydruku, wyjaśniamy we wpisie jak czytać wyniki SPSS.
Pamiętaj, po co liczysz te statystyki. W rozdziale wyników skośność i kurtoza opisują dane. Nie są automatycznym testem, który rozstrzyga, czy wolno użyć testu parametrycznego, bo to założenie dotyczy zwykle reszt modelu, a nie surowej zmiennej. Szerzej piszemy o tym we wpisie jak sprawdzić normalność rozkładu.
Tabela statystyk opisowych w stylu APA
Gdy masz więcej niż dwie zmienne, zbierz statystyki w tabeli. W stylu APA tabela ma numer, tytuł kursywą, tylko poziome linie i notę pod spodem. Każda kolumna powinna mieć jednolitą liczbę miejsc po przecinku, a nota wyjaśnia skróty, liczebności i sposób obliczeń. Ogólne zasady formatowania i więcej wzorów zebraliśmy we wpisie tabele APA – wzory i przykłady oraz w haśle tabela statystyk opisowych w APA. Dla naszego badania tabela zmiennych ilościowych wygląda tak:
Tabela 1
Statystyki opisowe stresu, samooceny i zmiennych dotyczących snu
| Zmienna | n | M | SD | Me | Q1–Q3 | Min–Max | Skośność | Kurtoza |
|---|---|---|---|---|---|---|---|---|
| Stres (0–40) | 236 | 19.29 | 6.27 | 19.00 | 15.00–23.00 | 0–36 | 0.04 | −0.18 |
| Samoocena (10–40) | 232 | 30.79 | 4.83 | 31.00 | 27.00–35.00 | 19–39 | −0.47 | −0.51 |
| Czas snu (h) | 236 | 6.68 | 1.01 | 6.75 | 6.00–7.50 | 4.00–9.50 | −0.07 | −0.10 |
| Czas zasypiania (min) | 227 | 20.44 | 12.38 | 15.00 | 10.00–25.00 | 5–80 | 1.51 | 3.57 |
Uwaga. N = 236; liczebności mniejsze niż N wynikają z braków danych (samoocena: 4 osoby, 1.7%; czas zasypiania: 9 osób, 3.8%). W nawiasach podano możliwy zakres wyników. Me = mediana; Q1 i Q3 = pierwszy i trzeci kwartyl (definicja kwartyli jak w SPSS). Skośność i kurtozę (kurtoza nadwyżkowa, 0 dla rozkładu normalnego) obliczono według wzorów stosowanych w SPSS; błąd standardowy skośności wynosi 0.16, a kurtozy 0.32. Dane symulowane.
Zmienne kategorialne najlepiej zebrać w osobnej, krótszej tabeli. Nie wciskaj ich do tabeli z M i SD, bo większość komórek zostałaby pusta:
Tabela 2
Rozkład chronotypu i oceny jakości snu
| Zmienna i kategoria | n | % |
|---|---|---|
| Chronotyp | ||
| Poranny | 52 | 22.0 |
| Pośredni | 98 | 41.5 |
| Wieczorny | 86 | 36.4 |
| Jakość snua | ||
| 1 – bardzo zła | 35 | 15.0 |
| 2 | 51 | 21.8 |
| 3 | 87 | 37.2 |
| 4 | 47 | 20.1 |
| 5 – bardzo dobra | 14 | 6.0 |
Uwaga. N = 236. Z powodu zaokrągleń odsetki mogą nie sumować się do 100. a n = 234 (dwie osoby nie odpowiedziały); odsetki liczono od ważnych odpowiedzi; Me = 3, Q1 = 2, Q3 = 4. Dane symulowane.
Tabela 1 nie musi mieć wszystkich kolumn. Jeśli wszystkie zmienne mają rozkłady zbliżone do symetrycznych, często wystarczą n, M, SD, zakres, skośność i kurtoza. Gdy hipotezy dotyczą związków, statystyki opisowe łączy się czasem z macierzą korelacji w jednej tabeli (zob. korelacja Pearsona i Spearmana krok po kroku). Wartości α Cronbacha dla skal można dodać jako ostatnią kolumnę.
Ile miejsc po przecinku i jak zaokrąglać?
Rozdział 6 podręcznika APA zawiera zasady zapisu liczb i wyników statystycznych (American Psychological Association, 2020). W pracach dyplomowych przyjęło się podawać średnie, odchylenia standardowe, skośność i kurtozę z dwoma miejscami po przecinku, a odsetki z jednym. Cole (2015) zwraca jednak uwagę, że sztywna reguła „dwóch miejsc”, jaką stosuje m.in. APA Style, ignoruje liczbę cyfr znaczących i przy wynikach w dużych jednostkach daje fałszywą precyzję. Proponuje regułę Hopkinsa: średnia powinna mieć tyle miejsc po przecinku, by odchylenie standardowe miało dwie cyfry znaczące. Według tej reguły czas zasypiania można by podać w pełnych minutach (M = 20, SD = 12), a czas snu z jednym miejscem po przecinku (M = 6.7, SD = 1.0). Praktyczne zasady:
- Licz na pełnej precyzji, zaokrąglaj dopiero w tabeli. Cole (2015) podkreśla, że zaokrąglać należy dopiero przy raportowaniu. Nie licz średniej z liczb już zaokrąglonych.
- Trzymaj jedną konwencję w kolumnie i w całej pracy. Jeśli wybierasz dwa miejsca dla M i SD, stosuj je wszędzie, chyba że promotor albo czasopismo wymaga inaczej.
- Nie dodawaj cyfr, których nie ma w danych. Liczebności to liczby całkowite, a mediana wyniku całkowitoliczbowego może mieć co najwyżej końcówkę .5.
- Odsetki z jednym miejscem po przecinku mogą nie sumować się do 100. Odsetki chronotypu sumują się do 99.9%, a ważne odpowiedzi o jakości snu – do 100.1%. Nie „poprawiaj” ich ręcznie, tylko dodaj zdanie w nocie.
- Wiedz, jak zaokrągla Twój program. Funkcja
round()w R zaokrągla wartości kończące się na 5 do najbliższej cyfry parzystej, więc 0.5 daje 0, 1.5 i 2.5 dają 2. Na dodatek 2.675 jest w pamięci komputera zapisane jako 2.67499999…, więc zaokrąglone do dwóch miejsc daje 2.67, a nie 2.68. Przy formatowaniu tabel takie różnice w ostatniej cyfrze są normalne. Nie świadczą o błędzie w obliczeniach.
Pamiętaj też o konwencji zapisu. W stylu APA w języku angielskim stosuje się kropkę dziesiętną. W polskiej pracy dyplomowej regulamin uczelni może wymagać przecinka, więc sprawdź to i trzymaj się jednego zapisu. Wartości, które nie mogą przekroczyć 1 (np. p, r, α), zapisuje się w APA bez zera przed kropką, a średnie i odchylenia standardowe – z zerem. Szczegóły i przykłady całych zdań znajdziesz we wpisie jak opisać wyniki w stylu APA.
Braki danych w tabeli statystyk opisowych
Braki danych są w prawie każdej ankiecie i trzeba je pokazać, a nie ukryć. W naszym badaniu każda zmienna ma inną liczbę odpowiedzi: stres i czas snu – 236, samoocena – 232, czas zasypiania – 227, jakość snu – 234. Komplet danych we wszystkich zmiennych ma 221 osób, czyli 15 osób zostałoby wykluczonych z analizy, która wymaga wszystkich zmiennych naraz.
- Podaj n dla każdej zmiennej – w osobnej kolumnie albo w nocie, jak w tabeli 1. Kolumna n od razu pokazuje, gdzie są luki.
- Napisz, jak liczono statystyki. Zwykle statystyki opisowe liczy się dla dostępnych danych każdej zmiennej osobno. Jeśli liczysz je tylko dla 221 osób z kompletem danych, napisz to wprost, bo wtedy liczby w tabeli opisują inną próbę.
- Podaj liczbę i odsetek braków. W naszych danych braki wynoszą od 0.8% do 3.8%. To niewiele, ale nawet mały odsetek warto opisać, a przy większym sprawdzić, czy osoby z brakami różnią się od pozostałych.
- Nie zastępuj braków średnią tylko po to, żeby tabela wyglądała równo. Schafer i Graham (2002) odradzają doraźne metody uzupełniania danych i zalecają estymację metodą największej wiarygodności albo imputację wielokrotną.
Mechanizmy powstawania braków i ich konsekwencje dla analizy opisujemy w haśle braki danych: MCAR, MAR i MNAR, a samą procedurę – w haśle imputacja wielokrotna.
Wykresy: histogram, pudełkowy czy słupkowy?
Liczby w tabeli streszczają rozkład, ale go nie pokazują. Dwie zmienne mogą mieć tę samą średnią i odchylenie standardowe, a zupełnie inny kształt. Weissgerber i in. (2015) przejrzeli 703 artykuły z czołowych czasopism fizjologicznych. Dane ciągłe pokazywano w nich głównie na wykresach słupkowych i liniowych, które przy bardzo różnych rozkładach mogą wyglądać identycznie, a wykresy rozrzutu, pudełkowe i histogramy pojawiały się rzadko. Wybór wykresu jest więc prosty:
| Cel | Wykres | Na co uważać |
|---|---|---|
| Kształt rozkładu jednej zmiennej ilościowej | histogram (rysunek 1) | Szerokość przedziałów zmienia obraz. Przy danych zaokrąglanych (np. do 5 minut) przedziały dopasuj do kroku pomiaru. |
| Porównanie rozkładu w kilku grupach, wykrycie wyników skrajnych | wykres pudełkowy z punktami (rysunek 2) | Opisz w podpisie, do czego sięgają wąsy, i podaj n. Przy kilku osobach w grupie pokaż same punkty. |
| Rozkład zmiennej nominalnej lub porządkowej | wykres słupkowy (rysunek 3) | Oś od zera, kategorie porządkowe w naturalnej kolejności, nad słupkami odsetek i n. |
| Średnie zmiennej ilościowej w grupach | punkty z przedziałami ufności na tle danych zamiast samych słupków | Słupek ze średnią ukrywa rozkład i liczebność grup. |
Krzywinski i Altman (2014) zauważają, że wykres pudełkowy ma sens już przy około 5 obserwacjach, a histogram potrzebuje mniej więcej 30. Przy małych grupach lepiej więc pokazać wykres pudełkowy albo same punkty. Nie wstawiaj do pracy wykresu do każdej zmiennej, bo czytelnik się w nich zgubi. Wybierz te, które pokazują coś ważnego dla dalszej analizy: wyraźną skośność, wyniki skrajne, efekt sufitu albo nierówny rozkład kategorii. Pozostałe rozkłady możesz przenieść do aneksu.
Jak opisać statystyki opisowe w tekście pracy?
Akapit pod tabelą nie powinien powtarzać wszystkich liczb. Wskaż, gdzie jest tabela, i omów to, co ważne dla dalszych analiz: kształt rozkładów, nietypowe zmienne, braki danych i ewentualne poprawki w bazie. Wzór dla naszego badania:
Jeśli w kolejnym kroku sięgasz po test, który zakłada normalność, możesz tu dodać zdanie o tym, jak sprawdziłeś to założenie. Dalsze kroki analizy opisują wpisy test t Studenta krok po kroku i testy nieparametryczne krok po kroku. Jeśli nie masz pewności, które miary wybrać albo jak uzasadnić decyzje przed promotorem, możesz skorzystać z konsultacji i pomocy w analizie danych dla studentów. Wyniki i tak musisz rozumieć i umieć obronić samodzielnie.
Statystyki opisowe w R: kod i wynik
Skrypt generuje dane symulowane z tego wpisu, wykonuje wszystkie kroki od kontroli zakresu do sprawdzenia zaokrągleń i zapisuje plik CSV do pobrania. Liczby w tekście, tabelach i na rysunkach pochodzą z tego uruchomienia.
Zakres, M i SD, mediana i kwartyle, skośność i kurtoza, odsetki i braki danych
R
# B48 – statystyki opisowe zmiennych badanych: sen i stres studentów (dane symulowane)
library(psych)    # describe()
library(e1071)    # skewness(), kurtosis() z wyborem wzoru

# --- 1. Dane symulowane: 236 osób studiujących -------------------------------------------
set.seed(4848)
n <- 236
stres      <- pmin(pmax(round(rnorm(n, 19, 6.5)), 0), 40)              # PSS-10, 0–40
samoocena  <- round(10 + 30 * rbeta(n, 5, 2.2))                         # skala 10–40, skośna w lewo
sen_h      <- round(rnorm(n, 6.8, 1.0) * 4) / 4                         # godziny snu w dni nauki
latencja   <- pmin(round(rlnorm(n, log(17), 0.62) / 5) * 5, 120)        # czas zasypiania (min)
latencja[latencja == 0] <- 5
jakosc_snu <- cut(-0.05 * stres + 0.45 * sen_h + rnorm(n, 0, 0.8),      # pozycja 1–5
                  breaks = c(-Inf, 1.05, 1.85, 2.75, 3.6, Inf), labels = FALSE)
chronotyp  <- factor(sample(c("poranny", "pośredni", "wieczorny"), n, replace = TRUE,
                            prob = c(.22, .46, .32)),
                     levels = c("poranny", "pośredni", "wieczorny"))
dane_surowe <- data.frame(id = 1:n, stres, samoocena, sen_h, latencja, jakosc_snu, chronotyp)

# braki danych i jeden błąd wpisania (6.8 h wpisane jako 68)
dane_surowe$samoocena[c(12, 57, 140, 201)] <- NA
dane_surowe$latencja[c(5, 33, 71, 88, 102, 150, 177, 190, 222)] <- NA
dane_surowe$jakosc_snu[c(64, 199)] <- NA
dane_surowe$sen_h[17] <- 68

# --- 2. Zakres: kontrola danych przed liczeniem czegokolwiek --------------------------------
sapply(dane_surowe[, 2:6], range, na.rm = TRUE)
dane <- dane_surowe
dane$sen_h[dane$sen_h > 24] <- 6.8        # poprawka po sprawdzeniu w arkuszu źródłowym
c(M_przed = mean(dane_surowe$sen_h), SD_przed = sd(dane_surowe$sen_h),
  M_po = mean(dane$sen_h), SD_po = sd(dane$sen_h), Mdn_przed = median(dane_surowe$sen_h),
  Mdn_po = median(dane$sen_h))

# --- 3. Zmienne ilościowe: M, SD, Mdn, kwartyle, zakres, skośność i kurtoza --------------
ilosciowe <- dane[, c("stres", "samoocena", "sen_h", "latencja")]
opis <- t(sapply(ilosciowe, function(x) {
  x <- x[!is.na(x)]
  q <- quantile(x, c(.25, .75), type = 6)                     # kwartyle jak w SPSS (typ 6)
  c(n = length(x), M = mean(x), SD = sd(x), Mdn = median(x), Q1 = q[[1]], Q3 = q[[2]],
    Min = min(x), Max = max(x),
    Skosnosc = skewness(x, type = 2), Kurtoza = kurtosis(x, type = 2))   # wzory jak w SPSS
}))
round(opis, 2)

# błędy standardowe skośności i kurtozy oraz wartości z (Kim, 2013)
se_skos <- function(n) sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
se_kurt <- function(n) 2 * se_skos(n) * sqrt((n^2 - 1) / ((n - 3) * (n + 5)))
round(cbind(SE_skos = se_skos(opis[, "n"]), z_skos = opis[, "Skosnosc"] / se_skos(opis[, "n"]),
            SE_kurt = se_kurt(opis[, "n"]), z_kurt = opis[, "Kurtoza"] / se_kurt(opis[, "n"])), 2)

# czas zasypiania: co „obiecuje” M ± SD, a co jest w danych
x <- na.omit(dane$latencja)
round(c(M_minus_2SD = mean(x) - 2 * sd(x), M_minus_SD = mean(x) - sd(x), M_plus_SD = mean(x) + sd(x),
        proc_ponizej_M = 100 * mean(x < mean(x)), kurtoza_bez_odejmowania_3 = kurtosis(x, type = 2) + 3), 2)

# ten sam rozkład, trzy wzory skośności i kurtozy (Joanes i Gill, 1998)
round(sapply(1:3, function(t) c(skosnosc = skewness(x, type = t), kurtoza = kurtosis(x, type = t))), 3)

# kwartyle czasu zasypiania w grupie o chronotypie porannym według dwóch definicji
# (Hyndman i Fan, 1996): typ 6 – jak w SPSS, typ 7 – domyślny w R
x_ran <- na.omit(dane$latencja[dane$chronotyp == "poranny"])
round(sapply(c(typ6 = 6, typ7 = 7), function(t) quantile(x_ran, c(.25, .5, .75), type = t)), 2)

# czas zasypiania w grupach chronotypu: n, Mdn, Q1, Q3, M, SD
round(t(sapply(split(dane$latencja, dane$chronotyp), function(x) {
  x <- na.omit(x); q <- quantile(x, c(.25, .75), type = 6)
  c(n = length(x), Mdn = median(x), Q1 = q[[1]], Q3 = q[[2]], M = mean(x), SD = sd(x))
})), 2)

# psych::describe() – domyślnie typ 3 skośności i kurtozy
describe(ilosciowe)[, c("n", "mean", "sd", "median", "min", "max", "skew", "kurtosis", "se")]

# --- 4. Zmienne kategorialne: liczebności i odsetki ---------------------------------------
tab_chrono <- table(dane$chronotyp, useNA = "ifany")
cbind(n = tab_chrono, proc = round(100 * prop.table(tab_chrono), 1))

tab_jakosc <- table(factor(dane$jakosc_snu, levels = 1:5), useNA = "always")
cbind(n = tab_jakosc,
      proc_wszystkich = round(100 * tab_jakosc / n, 1),
      proc_waznych = c(round(100 * prop.table(tab_jakosc[1:5]), 1), NA),
      proc_skumulowany = c(round(100 * cumsum(prop.table(tab_jakosc[1:5])), 1), NA))
c(Mdn = median(dane$jakosc_snu, na.rm = TRUE),
  quantile(dane$jakosc_snu, c(.25, .75), type = 6, na.rm = TRUE))

# --- 5. Braki danych w każdej zmiennej i w analizie wszystkich zmiennych naraz -----------
sapply(dane[, 2:7], function(x) c(braki = sum(is.na(x)), proc = round(100 * mean(is.na(x)), 1)))
c(kompletne_przypadki = sum(complete.cases(dane)), wykluczone = sum(!complete.cases(dane)))

# --- 6. Zaokrąglanie ---------------------------------------------------------------------
round(c(0.5, 1.5, 2.5, 2.675), c(0, 0, 0, 2))      # R: zaokrąglanie do parzystej / reprezentacja binarna
sprintf("%.20f", 2.675)
odsetki <- round(100 * prop.table(table(dane$jakosc_snu)), 1)   # odsetki ważnych odpowiedzi
c(odsetki, suma = sum(odsetki))
c(suma_chronotyp = sum(round(100 * prop.table(table(dane$chronotyp)), 1)))

# --- 7. Plik do pobrania -----------------------------------------------------------------
write.csv(dane_surowe, "../statystyki-opisowe-dane-sen-stres.csv", row.names = FALSE, na = "")
Wynik w R
     stres samoocena sen_h latencja jakosc_snu
[1,]     0        19     4        5          1
[2,]    36        39    68       80          5
  M_przed  SD_przed      M_po     SD_po Mdn_przed    Mdn_po
 6.943856  4.116686  6.684534  1.008192  6.750000  6.750000
            n     M    SD   Mdn Q1   Q3 Min  Max Skosnosc Kurtoza
stres     236 19.29  6.27 19.00 15 23.0   0 36.0     0.04   -0.18
samoocena 232 30.79  4.83 31.00 27 35.0  19 39.0    -0.47   -0.51
sen_h     236  6.68  1.01  6.75  6  7.5   4  9.5    -0.07   -0.10
latencja  227 20.44 12.38 15.00 10 25.0   5 80.0     1.51    3.57
          SE_skos z_skos SE_kurt z_kurt
stres        0.16   0.27    0.32  -0.57
samoocena    0.16  -2.91    0.32  -1.61
sen_h        0.16  -0.44    0.32  -0.31
latencja     0.16   9.37    0.32  11.09
              M_minus_2SD                M_minus_SD                 M_plus_SD
                    -4.33                      8.06                     32.82
           proc_ponizej_M kurtoza_bez_odejmowania_3
                    64.76                      6.57
          [,1]  [,2]  [,3]
skosnosc 1.503 1.513 1.493
kurtoza  3.463 3.567 3.406
    typ6 typ7
25%   10 12.5
50%   20 20.0
75%   25 25.0
           n Mdn Q1 Q3     M    SD
poranny   51  20 10 25 20.00 10.68
pośredni  93  15 10 25 20.48 12.83
wieczorny 83  15 15 25 20.66 12.97
            n  mean    sd median min  max  skew kurtosis   se
stres     236 19.29  6.27  19.00   0 36.0  0.04    -0.22 0.41
samoocena 232 30.79  4.83  31.00  19 39.0 -0.46    -0.55 0.32
sen_h     236  6.68  1.01   6.75   4  9.5 -0.07    -0.14 0.07
latencja  227 20.44 12.38  15.00   5 80.0  1.49     3.41 0.82
           n proc
poranny   52 22.0
pośredni  98 41.5
wieczorny 86 36.4
      n proc_wszystkich proc_waznych proc_skumulowany
1    35            14.8         15.0             15.0
2    51            21.6         21.8             36.8
3    87            36.9         37.2             73.9
4    47            19.9         20.1             94.0
5    14             5.9          6.0            100.0
<NA>  2             0.8           NA               NA
Mdn 25% 75%
  3   2   4
      stres samoocena sen_h latencja jakosc_snu chronotyp
braki     0       4.0     0      9.0        2.0         0
proc      0       1.7     0      3.8        0.8         0
kompletne_przypadki          wykluczone
                221                  15
[1] 0.00 2.00 2.00 2.67
[1] "2.67499999999999982236"
    1     2     3     4     5  suma
 15.0  21.8  37.2  20.1   6.0 100.1
suma_chronotyp
          99.9
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; kwartyle, średnie i odchylenia standardowe policzono funkcjami podstawowego R, skośność i kurtozę – w pakiecie e1071, a porównanie z funkcją describe() – w pakiecie psych. Rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- e1071 (wersja 1.7-17): Meyer, D., Dimitriadou, E., Hornik, K., Weingessel, A., & Leisch, F. (2025). e1071: Misc functions of the Department of Statistics, Probability Theory Group (formerly: E1071), TU Wien [R package]. https://doi.org/10.32614/CRAN.package.e1071
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w statystykach opisowych
- Liczenie statystyk przed sprawdzeniem zakresu – jedna literówka (68 zamiast 6.8) zwiększyła odchylenie standardowe czasu snu czterokrotnie.
- Średnia z kodów zmiennej nominalnej – „średni chronotyp” policzony z kodów 1–3 nic nie znaczy; podaj n i %.
- Tylko M i SD przy silnie skośnym rozkładzie – gdy M − 2SD wypada poza możliwy zakres, dodaj medianę i kwartyle.
- Błąd standardowy podpisany jako odchylenie standardowe albo w ogóle niepodpisany „±” – zawsze napisz, którą miarę podajesz.
- Odsetki bez liczebności i bez informacji, czy liczono je od wszystkich osób, czy od ważnych odpowiedzi.
- Brak n przy zmiennych z brakami – czytelnik zakłada wtedy, że każda statystyka dotyczy całej próby.
- Nadmierna precyzja – czas w minutach z czterema miejscami po przecinku albo różna liczba miejsc w jednej kolumnie.
- Kwartyle, skośność i kurtoza z różnych programów bez informacji o wzorze – R i SPSS mogą dać różne wyniki dla tych samych danych.
- Skośność i kurtoza jako jedyne kryterium wyboru testu – służą do opisu danych; założenia testów sprawdza się zwykle na resztach modelu.
- Powtarzanie całej tabeli w tekście – w akapicie omów wnioski z tabeli, a nie wszystkie liczby po kolei.
Najczęstsze pytania
Jakie statystyki opisowe podać dla zmiennych w pracy magisterskiej?
Dla zmiennych ilościowych podaj n, średnią, odchylenie standardowe, zakres oraz skośność i kurtozę, a przy wyraźnie skośnym rozkładzie także medianę z kwartylami. Dla zmiennych nominalnych i porządkowych podaj liczebności i odsetki, a dla porządkowych dodatkowo medianę. Charakterystykę osób badanych (płeć, wiek) opisz osobno, w podrozdziale o próbie.
Kiedy w pracy podać medianę zamiast średniej?
Gdy rozkład jest wyraźnie skośny albo ma wyniki skrajne, a także dla pojedynczych pozycji porządkowych. Prosty sygnał ostrzegawczy: jeśli M − 2SD wypada poza możliwy zakres (np. poniżej zera minut), para M i SD źle streszcza dane. Wtedy podaj medianę z kwartylami, a średnią i SD możesz zostawić obok.
Ile miejsc po przecinku podawać w tabeli statystyk opisowych?
Najczęściej dwa miejsca dla M, SD, skośności i kurtozy oraz jedno dla odsetków, jednolicie w całej kolumnie. Cole (2015) proponuje regułę, według której SD powinno mieć dwie cyfry znaczące, co przy wynikach w dużych jednostkach oznacza mniej miejsc po przecinku. Licz zawsze na pełnej precyzji i zaokrąglaj dopiero w tabeli.
Jak pokazać braki danych w tabeli statystyk opisowych?
Podaj liczebność n dla każdej zmiennej w osobnej kolumnie albo w nocie tabeli, razem z liczbą i odsetkiem braków. Napisz też, czy statystyki liczono dla wszystkich dostępnych odpowiedzi, czy tylko dla osób z kompletem danych. Nie zastępuj braków średnią tylko po to, by wszystkie wiersze miały to samo n.
Dlaczego skośność i kurtoza w R różnią się od wyników SPSS?
Bo programy stosują różne wzory (Joanes i Gill, 1998). Według dokumentacji pakietu e1071 SPSS używa wzoru oznaczonego tam jako typ 2, a funkcja describe() z pakietu psych domyślnie liczy typ 3. Podobnie jest z kwartylami: R domyślnie liczy typ 7, SPSS – typ 6. W R ustaw type = 2 dla skośności i kurtozy oraz type = 6 dla kwartyli, a wybór opisz w nocie tabeli.
Powiązane hasła
Przeczytaj też
Jak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Nie wiesz, które statystyki opisowe pokazać w swojej pracy?
Sprawdzimy bazę, dobierzemy miary do Twoich zmiennych, policzymy statystyki i przygotujemy tabele zgodne z APA, a potem wyjaśnimy każdą liczbę tak, żebyś umiał(a) ją omówić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Blanca, M. J., Arnau, J., López-Montiel, D., Bono, R., & Bendayan, R. (2013). Skewness and kurtosis in real data samples. Methodology, 9(2), 78–84. https://doi.org/10.1027/1614-2241/a000057
- Cole, T. J. (2015). Too many digits: The presentation of numerical data. Archives of Disease in Childhood, 100(7), 608–609. https://doi.org/10.1136/archdischild-2014-307149 ● Otwarty dostęp
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52 ● Otwarty dostęp
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- Velleman, P. F., & Wilkinson, L. (1993). Nominal, ordinal, interval, and ratio typologies are misleading. The American Statistician, 47(1), 65–72. https://doi.org/10.1080/00031305.1993.10475938
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Westfall, P. H. (2014). Kurtosis as peakedness, 1905–2014. R.I.P. The American Statistician, 68(3), 191–195. https://doi.org/10.1080/00031305.2014.917055 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{blanca2013skewness, author={Blanca, María J. and Arnau, Jaume and López-Montiel, Dolores and Bono, Roser and Bendayan, Rebecca}, title={{Skewness and kurtosis in real data samples}}, journal={Methodology}, year={2013}, volume={9}, number={2}, pages={78--84}, doi={10.1027/1614-2241/a000057}}@article{cole2015too, author={Cole, T. J.}, title={{Too many digits: The presentation of numerical data}}, journal={Archives of Disease in Childhood}, year={2015}, volume={100}, number={7}, pages={608--609}, doi={10.1136/archdischild-2014-307149}}@article{hyndman1996sample, author={Hyndman, Rob J. and Fan, Yanan}, title={{Sample quantiles in statistical packages}}, journal={The American Statistician}, year={1996}, volume={50}, number={4}, pages={361--365}, doi={10.1080/00031305.1996.10473566}}@article{joanes1998comparing, author={Joanes, D. N. and Gill, C. A.}, title={{Comparing measures of sample skewness and kurtosis}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1998}, volume={47}, number={1}, pages={183--189}, doi={10.1111/1467-9884.00122}}@article{kim2013assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis}}, journal={Restorative Dentistry \& Endodontics}, year={2013}, volume={38}, number={1}, pages={52--54}, doi={10.5395/rde.2013.38.1.52}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{velleman1993nominal, author={Velleman, Paul F. and Wilkinson, Leland}, title={{Nominal, ordinal, interval, and ratio typologies are misleading}}, journal={The American Statistician}, year={1993}, volume={47}, number={1}, pages={65--72}, doi={10.1080/00031305.1993.10475938}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{westfall2014kurtosis, author={Westfall, Peter H.}, title={{Kurtosis as peakedness, 1905–2014. R.I.P.}}, journal={The American Statistician}, year={2014}, volume={68}, number={3}, pages={191--195}, doi={10.1080/00031305.2014.917055}}