Kiedy naprawdę potrzebujesz testu nieparametrycznego?
W wielu pracach dyplomowych powtarza się ten sam schemat: test Shapiro–Wilka daje p < .05, więc „rozkład jest nienormalny” i autor przechodzi na test Manna–Whitneya. To odruch, a nie decyzja analityczna. Testy nieparametryczne (rangowe) są dobrym narzędziem, ale tylko wtedy, gdy odpowiadają na Twoje pytanie lepiej niż test parametryczny.
Po pierwsze, test t i ANOVA nie wymagają normalności surowych wyników, tylko w przybliżeniu normalnego rozkładu średnich z prób. Lumley i in. (2002) pokazali symulacyjnie, że w dużych próbach test t i regresja liniowa są trafne nawet przy skrajnie nienormalnych danych. Po drugie, wstępne testowanie normalności samo psuje wnioskowanie. Rochon i in. (2012) sprawdzili procedurę „najpierw Shapiro–Wilk, potem test t albo Manna–Whitneya” i stwierdzili, że wyraźnie zmienia ona warunkowe poziomy błędu I rodzaju obu testów; uznali ją za formalnie niepoprawną. Po trzecie, w dużych badaniach z danymi skośnymi test Wilcoxona–Manna–Whitneya może dawać dużo mniejsze p niż test t nawet przy równych średnich i medianach, np. gdy grupy różnią się rozproszeniem (Fagerland, 2012). Jak oceniać rozkład bez testów-bramek, piszemy w poradniku jak sprawdzić normalność rozkładu.
Test rangowy wybierz z powodu merytorycznego, najlepiej zapisanego w planie analizy:
- zmienna jest porządkowa, np. pojedyncza pozycja na skali Likerta albo ranking, a różnice między punktami skali nie są równe;
- mała próba i wyraźna skośność, np. liczby zdarzeń, czas reakcji, liczba dni nieobecności – z wieloma zerami i długim ogonem;
- pojedyncze skrajne wartości, które są prawdziwe i nie chcesz ich usuwać (zob. obserwacja odstająca);
- efekt sufitu lub podłogi, przy którym duża część osób ma wynik minimalny albo maksymalny.
Gdy problemem są tylko nierówne wariancje przy rozkładach zbliżonych do normalnego, rozwiązaniem jest test t Welcha, a nie test rangowy (szczegóły w poradniku test t Studenta krok po kroku).
Ile się zyskuje, a ile traci? Rysunek 1 pokazuje symulację dla dwóch grup po 20 osób. Przy rozkładzie normalnym oba testy mają podobną moc (test Welcha .574, test Manna–Whitneya .556). Przy rozkładzie prawoskośnym test rangowy wykrywał tę samą różnicę ponad dwa razy częściej (.672 wobec .294), a przy ciężkich ogonach – wyraźnie częściej (.485 wobec .381). Oba testy trzymały błąd I rodzaju na poziomie α = .05 lub niżej (od .034 do .049).
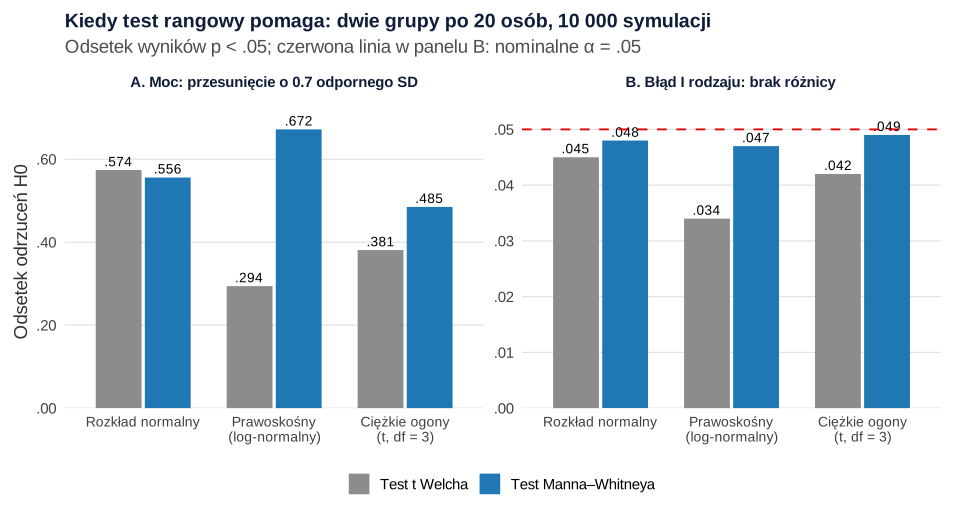
Wniosek: przy danych skośnych i małych próbach test rangowy bywa nie tylko „bezpieczniejszy”, ale po prostu mocniejszy. Przy danych zbliżonych do normalnych niczego nie zyskasz, a stracisz łatwą interpretację różnicy średnich.
Odpowiedniki parametryczne i nieparametryczne
Każdy podstawowy test parametryczny ma swój odpowiednik rangowy. Wybór zależy od dwóch pytań: ile jest grup lub pomiarów i czy to te same osoby.
| Schemat | Test parametryczny | Test nieparametryczny | Post hoc | Wielkość efektu |
|---|---|---|---|---|
| 2 grupy niezależne | test t dla prób niezależnych (Welch) | test U Manna–Whitneya | – | rrb, r = Z/√N |
| 2 pomiary tych samych osób | test t dla prób zależnych | test Wilcoxona dla par | – | rrb dla par, r = Z/√n |
| 3+ grupy niezależne | ANOVA (Welch) | test Kruskala–Wallisa | test Dunna | ε² |
| 3+ pomiary tych samych osób | ANOVA z powtarzanymi pomiarami | test Friedmana | Wilcoxon dla par z korektą | W Kendalla |
| związek dwóch zmiennych | korelacja Pearsona | korelacja Spearmana | – | ρ |
| dwie zmienne jakościowe | – | test χ² | reszty | V Craméra |
Ostatni wiersz omawiamy osobno w poradniku test chi-kwadrat krok po kroku, a korelacje – w poradniku korelacja Pearsona i Spearmana krok po kroku.
Co właściwie testują testy rangowe?
Testy rangowe zastępują wyniki ich pozycjami w uporządkowanym ciągu (rangowanie). Mann i Whitney (1947) zaproponowali statystykę U do sprawdzania, czy jedna z dwóch zmiennych jest stochastycznie większa od drugiej, czyli czy losowo wybrana osoba z jednej grupy ma zwykle wyższy wynik niż losowo wybrana osoba z drugiej. To nie jest test median. Divine i in. (2018) pokazali na kontrprzykładach, że procedura dotyczy wielkości P(X1 < X2) + ½P(X1 = X2), a Hart (2001) – że test reaguje także na różnice kształtu i rozproszenia. Dokumentacja SPSS ujmuje to tak: test Manna–Whitneya sprawdza równość dwóch rozkładów, a jako test położenia wymaga założenia, że rozkłady mają ten sam kształt (IBM Corp., b.d.). Podobnie test Kruskala–Wallisa wykrywa odstępstwa od stochastycznej jednorodności grup, czyli różnice średnich rang (Vargha i Delaney, 1998). Mediany i IQR raportujesz więc jako opis danych, a nie jako „to, co porównał test”.
Badanie przykładowe: aplikacja przeciw odkładaniu zadań
Wszystkie cztery testy policzymy na jednym badaniu (dane symulowane). Sześćdziesiąt osób studiujących losowo przydzielono do trzech warunków po 20 osób: aplikacja z przypomnieniami, ta sama aplikacja bez przypomnień i grupa kontrolna. Zmienna zależna to liczba zadań na studia odłożonych w ostatnim tygodniu według dzienniczka. Pomiary: przed rozpoczęciem (T0), po 2 tygodniach (T1) i po 4 tygodniach (T2).
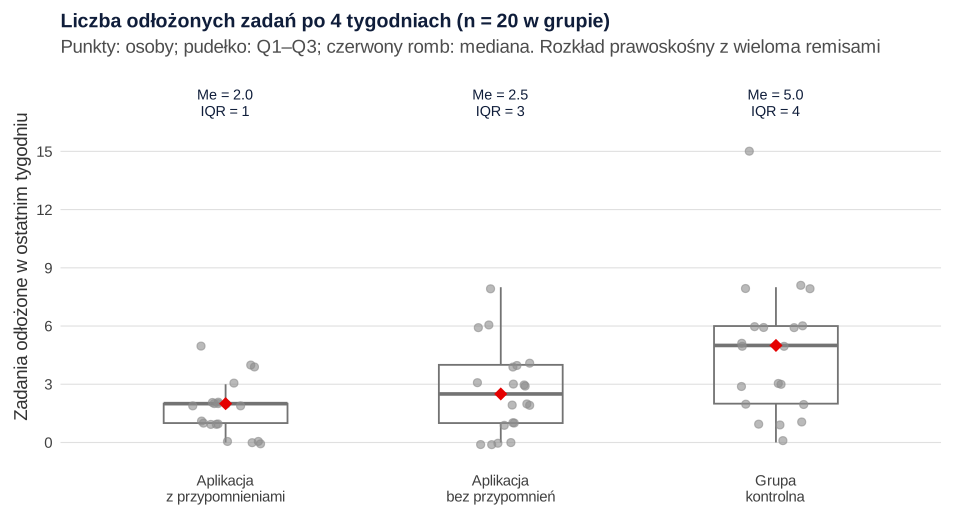
To typowy przypadek, w którym test rangowy ma sens. Wynik to liczba zdarzeń: nie może spaść poniżej zera, 15% osób w T2 nie odłożyło żadnego zadania, a rozkład jest prawoskośny (skośność 1.58). W grupie kontrolnej jedna osoba odłożyła 15 zadań, a reszta nie więcej niż 8. Grupy są małe. Dane możesz pobrać jako plik CSV (60 wierszy: id, grupa, T0, T1, T2).
Krok 1. Opisz dane: mediana i IQR
Przy testach rangowych podstawą opisu są mediana (Me) i rozstęp ćwiartkowy (IQR = Q3 − Q1). Mediana nie reaguje na pojedynczą wartość 15, a średnia tak. W tabeli podaj także kwartyle, bo sam IQR nie mówi, gdzie leży środek rozkładu. Średnią i SD możesz dodać, jeśli promotor ich oczekuje albo chcesz ułatwić przyszłe metaanalizy. Graficznie najlepiej sprawdza się wykres pudełkowy z naniesionymi punktami (rysunek 2).
Tabela 1
Liczba zadań odłożonych w ostatnim tygodniu po 4 tygodniach w trzech warunkach
| Warunek | n | Me | [Q1, Q3] | M (SD) | Zakres | Średnia ranga |
|---|---|---|---|---|---|---|
| Aplikacja z przypomnieniami | 20 | 2.0 | [1, 2] | 1.75 (1.41) | 0–5 | 22.5 |
| Aplikacja bez przypomnień | 20 | 2.5 | [1, 4] | 2.65 (2.23) | 0–8 | 29.1 |
| Grupa kontrolna | 20 | 5.0 | [2, 6] | 4.70 (3.50) | 0–15 | 39.9 |
Uwaga. N = 60. Me – mediana; Q1 i Q3 – pierwszy i trzeci kwartyl. Średnie rangi z łącznego rangowania 60 wyników (test Kruskala–Wallisa). Kruskal–Wallis: H(2) = 10.29, p = .006, ε² = .17, 95% CI [.05, .39]. Dane symulowane.
Wzory innych układów tabeli znajdziesz w haśle tabela statystyk opisowych w APA.
Krok 2. Dwie grupy niezależne: test U Manna–Whitneya
Pytanie: czy po 4 tygodniach osoby korzystające z aplikacji z przypomnieniami odkładają mniej zadań niż grupa kontrolna? Test łączy 40 wyników, nadaje im rangi (remisom – rangi średnie) i sprawdza, czy rangi jednej grupy są systematycznie niższe. Statystyka U to liczba par (osoba z grupy 1, osoba z grupy 2), w których osoba z grupy 1 ma wyższy wynik; remis liczy się jako ½.
- Mediany: 2.0 [1, 2] wobec 5.0 [2, 6].
- U = 85.5 (dla grupy kontrolnej 314.5; razem 20 × 20 = 400 par), Z = −3.14, p = .002.
- Przesunięcie Hodgesa–Lehmanna: −3.00 zadania, 95% CI [−4.00, −1.00].
Uwaga na oznaczenia: R podaje statystykę jako W, ale przy formule T2 ~ grupa to U dla pierwszej grupy (85.5). W SPSS ten sam wynik nazywa się Mann-Whitney U. Ponieważ w danych są remisy, R liczy p z przybliżenia normalnego z poprawką na ciągłość; przy małych próbach bez remisów możesz podać dokładne p. Szczegóły obliczeń są w haśle o teście Manna–Whitneya.
Dla porównania test t Welcha dał t(25.02) = −3.50, p = .002 – ten sam wniosek. Nie wybieraj jednak testu według tego, który daje mniejsze p. Test zapisz w planie analizy, zanim zobaczysz wyniki.
Krok 3. Trzy grupy: test Kruskala–Wallisa i test Dunna
Pytanie: czy trzy warunki różnią się liczbą odłożonych zadań po 4 tygodniach? Test Kruskala–Wallisa to rangowy odpowiednik jednoczynnikowej ANOVA. Kruskal i Wallis (1952) zaproponowali statystykę H opartą na łącznym rangowaniu obserwacji ze wszystkich prób; ma ona w przybliżeniu rozkład χ² z k − 1 stopniami swobody.
Średnie rangi wynoszą 22.5 (przypomnienia), 29.1 (bez przypomnień) i 39.9 (kontrola). Test: H(2) = 10.29, p = .006. R podpisuje tę statystykę jako Kruskal-Wallis chi-squared, dlatego część autorów zapisuje χ²(2) = 10.29 – to ta sama liczba.
Istotny wynik mówi tylko, że co najmniej jedna grupa różni się od innej. Które pary się różnią, sprawdzisz testem Dunna. Dunn (1964) zaproponował porównania wielokrotne oparte na sumach rang ze wspólnego rangowania wszystkich grup, zamiast osobnego rangowania każdej pary. To ważna różnica wobec serii testów Manna–Whitneya. Wartości p skoryguj na liczbę porównań, np. metodą Holma (zob. problem wielokrotnych porównań).
| Para | z | p | pHolm |
|---|---|---|---|
| Przypomnienia – kontrola | 3.18 | .001 | .004 |
| Bez przypomnień – kontrola | 1.97 | .049 | .097 |
| Przypomnienia – bez przypomnień | 1.20 | .229 | .229 |
Po korekcie istotna jest tylko różnica między aplikacją z przypomnieniami a grupą kontrolną. Para „bez przypomnień – kontrola” miała p = .049 bez korekty, ale po korekcie Holma już nie (pHolm = .097). To dobry przykład, dlaczego korektę wybiera się przed analizą.
Vargha i Delaney (1998) przypominają, że przy wyraźnie różnych wariancjach w grupach test Kruskala–Wallisa przestaje być czystym testem położenia; zalecają wtedy odporne alternatywy na rangach. W naszych danych rozproszenie rośnie razem z medianą (IQR 1, 3 i 4), co jest typowe dla liczby zdarzeń. Dlatego w opisie podaj mediany i kwartyle, a różnice interpretuj jako „wyniki w grupie kontrolnej są zwykle wyższe”, a nie „mediany się różnią”.
Krok 4. Dwa pomiary tych samych osób: test Wilcoxona dla par
Pytanie: czy w grupie z przypomnieniami liczba odłożonych zadań spadła między T0 a T2? Test znakowanych rang Wilcoxona liczy różnice T2 − T0 dla każdej osoby, ustawia ich wartości bezwzględne w rangi i porównuje sumę rang różnic dodatnich z sumą rang ujemnych. Dokumentacja SPSS zakłada przy tym, że rozkład różnic w populacji jest symetryczny (IBM Corp., b.d.).
- Spadek u 15 osób, wzrost u 1, bez zmiany u 4; mediana różnicy −2 (z 4 do 2 zadań).
- V = 3 (suma rang różnic dodatnich), Z = −3.38, p < .001; n = 16 osób z niezerową różnicą.
Cztery osoby bez zmiany wypadają z analizy. To domyślne zachowanie R i SPSS. Pratt (1959) pokazał, że usuwanie zer przed rangowaniem może prowadzić do paradoksalnych wyników, i zaproponował, by zera uwzględnić przy rangowaniu, a dopiero potem pominąć ich rangi. Metodą Pratta wynik jest podobny: Z = −3.50, p < .001. Przy krótkich skalach z wieloma zerami różnica bywa większa, więc napisz, którą metodę zastosowano. Nie myl tego testu z testem sumy rang Wilcoxona dla grup niezależnych, który jest równoważny testowi Manna–Whitneya (Mann i Whitney, 1947).
Krok 5. Trzy pomiary tych samych osób: test Friedmana
Pytanie: czy w grupie z przypomnieniami liczba odłożonych zadań zmieniała się w trzech pomiarach? Friedman (1937) zaproponował test oparty na rangach, który porównuje kilka warunków bez założenia normalności. Rangi nadaje się w obrębie każdej osoby (od 1 do 3), a potem porównuje średnie rangi pomiarów. Dzięki temu stały poziom „odkładania” danej osoby nie wpływa na wynik.
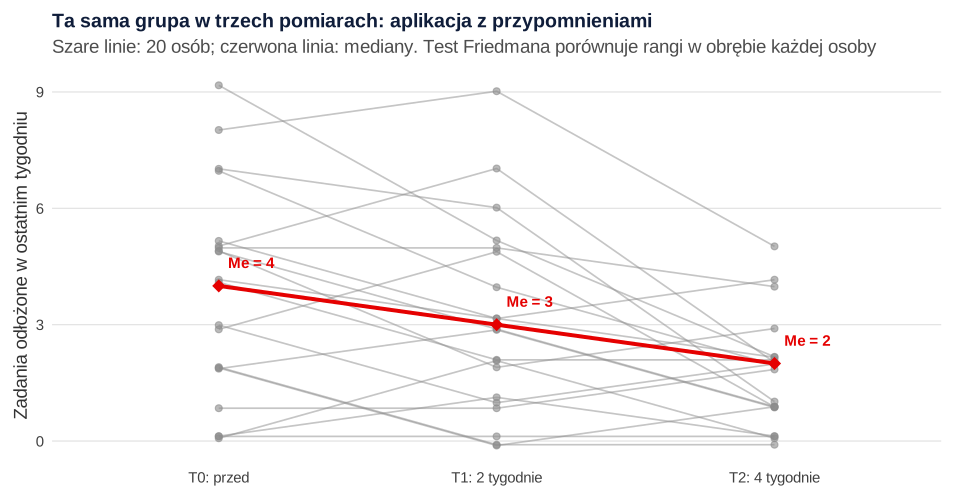
Mediany spadają z 4 [2, 5] przez 3 [1, 5] do 2 [1, 2], a średnie rangi z 2.48 przez 2.05 do 1.48. Test: χ²F(2, N = 20) = 11.68, p = .003. Porównania parami wykonano testem Wilcoxona dla par z korektą Holma:
- T0 – T1: pHolm = .074;
- T0 – T2: pHolm = .002;
- T1 – T2: pHolm = .020.
Spadek po dwóch tygodniach nie był więc jeszcze istotny, a po czterech – tak. Brak grupy kontrolnej w tej analizie oznacza jednak, że spadek mógł wynikać np. z końca semestru. Porównanie przebiegu w trzech grupach wymaga modelu z interakcją czas × grupa. Do takich danych lepiej pasuje model mieszany niż test rangowy (zob. pomiary powtarzane: ANOVA czy model mieszany).
Krok 6. Wielkość efektu dla testów rangowych
Sama wartość p nie wystarczy. Fritz i in. (2012) stwierdzili, że w artykułach z Journal of Experimental Psychology: General wielkość efektu podano dla mniej niż połowy analiz, i przygotowali przewodnik po jej wyborze i obliczaniu dla różnych rodzajów danych. Przy testach rangowych masz do wyboru kilka miar (ogólnie o wielkości efektu):
| Miara | Wzór | Test | Przykład |
|---|---|---|---|
| r z Z | |Z| / √N | Mann–Whitney, Wilcoxon | MW: 3.14/√40 = .50; Wilcoxon: 3.38/√16 = .85 |
| Korelacja rangowo-dwuseryjna rrb | 2U/(n1n2) − 1 | Mann–Whitney (też Wilcoxon dla par) | MW: −.57, 95% CI [−.77, −.28]; Wilcoxon: −.96, 95% CI [−.99, −.87] |
| Prawdopodobieństwo przewagi | P(Y > X) + ½P(Y = X) | Mann–Whitney | .786 |
| ε² | H / [(N² − 1)/(N + 1)] | Kruskal–Wallis | .17, 95% CI [.05, .39] |
| W Kendalla | χ²F / [N(k − 1)] | Friedman | .29, 95% CI [.13, .58] |
Najbardziej intuicyjna jest korelacja rangowo-dwuseryjna. Kerby (2014) opisuje ją wzorem prostej różnicy: odsetek par „zgodnych z hipotezą” minus odsetek par „niezgodnych”. W przykładzie w 78.6% par (osoba z kontroli, osoba z przypomnieniami) osoba z kontroli odkładała więcej zadań (remisy liczone po połowie). Ujemny znak rrb oznacza tylko, że pierwsza grupa w analizie (przypomnienia) ma niższe wyniki.
Przelicznik r = Z/√N jest popularny, ale ma dwie pułapki. Zależy od przyjętego N – przy teście Wilcoxona jedni dzielą przez liczbę par z niezerową różnicą (16, r = .85), inni przez wszystkie pary albo przez liczbę obserwacji. Poza tym nie ma prostego przedziału ufności. Napisz w pracy, jakie N przyjąłeś(-ęłaś), a jeśli możesz, podaj rrb z 95% CI.
Krok 7. Zapis wyników w stylu APA
Przy każdym teście rangowym podaj: nazwę testu, statystykę (U, Z, V lub T, H, χ²F) ze stopniami swobody, gdy istnieją, dokładne p, wielkość efektu z przedziałem ufności oraz mediany z kwartylami lub IQR w każdej grupie albo pomiarze. Przy porównaniach post hoc nazwij test i korektę. Gotowe opisy dla przykładu:
Zdania do innych analiz zebraliśmy w poradniku jak opisać wyniki w stylu APA.
Testy nieparametryczne w SPSS
W SPSS klasyczne okna testów rangowych są w menu Analyze → Nonparametric Tests → Legacy Dialogs (IBM Corp., b.d.):
- 2 Independent Samples... – test Mann-Whitney U; po wskazaniu zmiennej grupującej określasz dwie grupy przyciskiem Define Groups;
- K Independent Samples... – test Kruskal-Wallis H; zakres kodów grup podajesz w Define Range;
- 2 Related Samples... – test Wilcoxon (znakowanych rang) dla wybranej pary zmiennych;
- K Related Samples... – test Friedman, a w tym samym oknie także Kendall's W.
Według dokumentacji okna te podają wyniki testów oraz statystyki opisowe, w tym kwartyle. Korelację rangowo-dwuseryjną i ε² policzysz ze wzorów z tabeli w kroku 6, a test Dunna z korektą Holma – w R (przepis 3 poniżej). Jak czytać pozostałe tabele wydruku, pokazujemy w poradniku jak czytać wyniki z SPSS.
Testy nieparametryczne w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R: przepisy 2–5 korzystają z obiektu dane z przepisu 1. Zamiast losować dane, możesz wczytać plik CSV: dane <- read.csv("testy-nieparametryczne-dane-przyklad.csv") i ustawić kolejność grup: dane$grupa <- factor(dane$grupa, levels = c("przypomnienia", "bez przypomnień", "kontrola")).
1. Dane i statystyki opisowe
R
# Badanie przykładowe (dane symulowane): 60 osób studiujących losowo przydzielono do trzech warunków po 20 osób:
# aplikacja z przypomnieniami, aplikacja bez przypomnień i grupa kontrolna. Zmienna zależna: liczba zadań
# na studia odłożonych w ostatnim tygodniu (dzienniczek), mierzona przed (T0), po 2 tygodniach (T1) i po 4 tygodniach (T2).
set.seed(470)
n <- 20
grupa <- factor(rep(c("przypomnienia", "bez przypomnień", "kontrola"), each = n),
                levels = c("przypomnienia", "bez przypomnień", "kontrola"))
sklonnosc <- rgamma(3 * n, shape = 1.6, rate = 1.6)                 # skłonność do odkładania (różna u osób)
spadek <- c(przypomnienia = .45, `bez przypomnień` = .75, kontrola = .95)[as.character(grupa)]
mu0 <- 4.5 * sklonnosc
T0 <- rpois(3 * n, mu0)
T1 <- rpois(3 * n, mu0 * (1 + spadek) / 2)
T2 <- rpois(3 * n, mu0 * spadek)
dane <- data.frame(id = 1:(3 * n), grupa, T0, T1, T2)
head(dane)

# Statystyki opisowe: mediana i rozstęp ćwiartkowy (IQR) obok średniej i SD
opis <- function(x) c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75)),
                      IQR = IQR(x), M = round(mean(x), 2), SD = round(sd(x), 2), min = min(x), max = max(x))
t(sapply(split(dane$T2, dane$grupa), opis))                          # po 4 tygodniach (T2)
t(sapply(dane[dane$grupa == "przypomnienia", c("T0", "T1", "T2")], opis))  # grupa z przypomnieniami w czasie
# Skośność (T2, cała próba) i odsetek zer
round(c(skosnosc = mean((dane$T2 - mean(dane$T2))^3) / sd(dane$T2)^3, odsetek_zer = mean(dane$T2 == 0)), 2)
Wynik w R
  id         grupa T0 T1 T2
1  1 przypomnienia  5  3  1
2  2 przypomnienia  0  2  0
3  3 przypomnienia  5  7  2
4  4 przypomnienia  3  5  1
5  5 przypomnienia  5  3  2
6  6 przypomnienia  4  3  4
                 n  Me Q1 Q3 IQR    M   SD min max
przypomnienia   20 2.0  1  2   1 1.75 1.41   0   5
bez przypomnień 20 2.5  1  4   3 2.65 2.23   0   8
kontrola        20 5.0  2  6   4 4.70 3.50   0  15
    n Me Q1 Q3 IQR    M   SD min max
T0 20  4  2  5   3 3.85 2.66   0   9
T1 20  3  1  5   4 3.10 2.47   0   9
T2 20  2  1  2   1 1.75 1.41   0   5
   skosnosc odsetek_zer
       1.58        0.15
2. Test U Manna–Whitneya
R
# Krok 2. Test U Manna–Whitneya: przypomnienia a kontrola po 4 tygodniach (obiekt dane z b47-1-dane.R)
d2 <- droplevels(subset(dane, grupa %in% c("przypomnienia", "kontrola")))
mw <- wilcox.test(T2 ~ grupa, data = d2, exact = FALSE, conf.int = TRUE)   # są wiązania: przybliżenie normalne
mw
n1 <- sum(d2$grupa == "przypomnienia"); n2 <- sum(d2$grupa == "kontrola")
c(U_przypomnienia = unname(mw$statistic), U_kontrola = n1 * n2 - unname(mw$statistic))
# Z i r = Z / √N (pakiet coin; przybliżenie normalne z korektą na wiązania, bez poprawki na ciągłość)
suppressPackageStartupMessages(library(coin))
mw_coin <- wilcox_test(T2 ~ grupa, data = d2, distribution = "asymptotic")
Z <- statistic(mw_coin)
round(c(Z = Z, p = pvalue(mw_coin), r = abs(Z) / sqrt(nrow(d2))), 3)
# Korelacja rangowo-dwuseryjna z 95% CI: r_rb = 2U / (n1 × n2) − 1 (ujemna: niższe wartości w pierwszej grupie)
suppressPackageStartupMessages(library(effectsize))
rank_biserial(T2 ~ grupa, data = d2)
round(2 * unname(mw$statistic) / (n1 * n2) - 1, 3)
# Prawdopodobieństwo przewagi: P(osoba z kontroli odkłada więcej niż osoba z przypomnieniami) + ½ P(remis)
x <- d2$T2[d2$grupa == "przypomnienia"]; y <- d2$T2[d2$grupa == "kontrola"]
round(mean(outer(y, x, ">")) + .5 * mean(outer(y, x, "==")), 3)
# Dla porównania: test t Welcha na tych samych danych
t.test(T2 ~ grupa, data = d2)
Wynik w R
	Wilcoxon rank sum test with continuity correction

data:  T2 by grupa
W = 85.5, p-value = 0.001797
alternative hypothesis: true location shift is not equal to 0
95 percent confidence interval:
 -4.0000014 -0.9999351
sample estimates:
difference in location
             -2.999972

U_przypomnienia      U_kontrola
           85.5           314.5
     Z      p      r
-3.136  0.002  0.496
r (rank biserial) |         95% CI
----------------------------------
-0.57             | [-0.77, -0.28]
[1] -0.573
[1] 0.786

	Welch Two Sample t-test

data:  T2 by grupa
t = -3.5, df = 25.019, p-value = 0.001764
alternative hypothesis: true difference in means between group przypomnienia and group kontrola is not equal to 0
95 percent confidence interval:
 -4.685814 -1.214186
sample estimates:
mean in group przypomnienia      mean in group kontrola
                       1.75                        4.70
3. Test Kruskala–Wallisa i test Dunna
R
# Krok 3. Test Kruskala–Wallisa i test Dunna: trzy warunki po 4 tygodniach (obiekt dane z b47-1-dane.R)
kw <- kruskal.test(T2 ~ grupa, data = dane)
kw
# Wielkość efektu: ε² = H / ((N² − 1) / (N + 1)) z 95% CI (bootstrap w pakiecie effectsize)
suppressPackageStartupMessages(library(effectsize))
set.seed(47)
rank_epsilon_squared(T2 ~ grupa, data = dane, alternative = "two.sided")
N <- nrow(dane)
round(unname(kw$statistic) / ((N^2 - 1) / (N + 1)), 3)
# Średnie rangi w grupach
round(tapply(rank(dane$T2), dane$grupa, mean), 1)
# Test Dunna z korektą Holma (pakiet rstatix)
dunn <- rstatix::dunn_test(dane, T2 ~ grupa, p.adjust.method = "holm")
as.data.frame(dunn[, c("group1", "group2", "statistic", "p", "p.adj")]) |>
  transform(statistic = round(statistic, 2), p = round(p, 4), p.adj = round(p.adj, 4))
Wynik w R
	Kruskal-Wallis rank sum test

data:  T2 by grupa
Kruskal-Wallis chi-squared = 10.287, df = 2, p-value = 0.005838

Epsilon2 (rank) |       95% CI
------------------------------
0.17            | [0.05, 0.39]
[1] 0.174
  przypomnienia bez przypomnień        kontrola
           22.5            29.1            39.9
           group1          group2 statistic      p  p.adj
1   przypomnienia bez przypomnień      1.20 0.2287 0.2287
2   przypomnienia        kontrola      3.18 0.0015 0.0045
3 bez przypomnień        kontrola      1.97 0.0485 0.0971
4. Test Wilcoxona dla par
R
# Krok 4. Test Wilcoxona dla par: grupa z przypomnieniami przed (T0) i po 4 tygodniach (T2)
A <- subset(dane, grupa == "przypomnienia")
roznica <- A$T2 - A$T0
c(spadek = sum(roznica < 0), wzrost = sum(roznica > 0), bez_zmiany = sum(roznica == 0))
c(Me_T0 = median(A$T0), Me_T2 = median(A$T2), Me_roznicy = median(roznica))
wx <- wilcox.test(A$T2, A$T0, paired = TRUE, exact = FALSE)     # zera usuwane, wiązania: przybliżenie normalne
wx
# Z i r = Z / √n (coin; zera metodą Pratta albo usunięte jak w wilcox.test)
suppressPackageStartupMessages(library(coin))
wx_coin <- wilcoxsign_test(T2 ~ T0, data = A, distribution = "asymptotic", zero.method = "Wilcoxon")
Zw <- statistic(wx_coin); n_bez_zer <- sum(roznica != 0)
round(c(Z = Zw, p = pvalue(wx_coin), n = n_bez_zer, r = abs(Zw) / sqrt(n_bez_zer)), 3)
wx_pratt <- wilcoxsign_test(T2 ~ T0, data = A, distribution = "asymptotic", zero.method = "Pratt")
round(c(Z_Pratt = statistic(wx_pratt), p_Pratt = pvalue(wx_pratt)), 4)
# Korelacja rangowo-dwuseryjna dla par z 95% CI
library(effectsize)
rank_biserial(A$T2, A$T0, paired = TRUE)
Wynik w R
    spadek     wzrost bez_zmiany
        15          1          4
     Me_T0      Me_T2 Me_roznicy
         4          2         -2

	Wilcoxon signed rank test with continuity correction

data:  A$T2 and A$T0
V = 3, p-value = 0.0007956
alternative hypothesis: true location shift is not equal to 0

     Z      p      n      r
-3.380  0.001 16.000  0.845
Z_Pratt p_Pratt
-3.5007  0.0005
r (rank biserial) |         95% CI
----------------------------------
-0.96             | [-0.99, -0.87]
5. Test Friedmana i porównania parami
R
# Krok 5. Test Friedmana: grupa z przypomnieniami w trzech pomiarach (T0, T1, T2)
A <- subset(dane, grupa == "przypomnienia")
pomiary <- as.matrix(A[, c("T0", "T1", "T2")])
fr <- friedman.test(pomiary)
fr
# Średnie rangi pomiarów (rangowanie w obrębie osoby) i W Kendalla = χ²F / (n(k − 1))
round(colMeans(t(apply(pomiary, 1, rank))), 2)
library(effectsize)
kendalls_w(pomiary, alternative = "two.sided")
round(unname(fr$statistic) / (nrow(pomiary) * (ncol(pomiary) - 1)), 3)
# Porównania parami: test Wilcoxona dla par z korektą Holma
pary <- list(c("T0", "T1"), c("T0", "T2"), c("T1", "T2"))
p_par <- sapply(pary, function(p) suppressWarnings(wilcox.test(A[[p[1]]], A[[p[2]]], paired = TRUE, exact = FALSE)$p.value))
data.frame(para = sapply(pary, paste, collapse = "–"), p = round(p_par, 4), p_Holm = round(p.adjust(p_par, "holm"), 4))
Wynik w R
	Friedman rank sum test

data:  pomiary
Friedman chi-squared = 11.681, df = 2, p-value = 0.002907

  T0   T1   T2
2.48 2.05 1.48
Kendall's W |       95% CI
--------------------------
0.29        | [0.13, 0.58]
[1] 0.292
   para      p p_Holm
1 T0–T1 0.0739 0.0739
2 T0–T2 0.0008 0.0024
3 T1–T2 0.0102 0.0205
Warning message:
8 block(s) contain ties, some containing only 1 unique ranking.
6. Symulacja: test Welcha a test Manna–Whitneya
R
# Krok 1 (uzasadnienie): kiedy test rangowy naprawdę pomaga? Moc i błąd I rodzaju testu t Welcha
# i testu Manna–Whitneya, dwie grupy po 20 osób, 10 000 powtórzeń na scenariusz.
# Przesunięcie drugiej grupy = 0.7 × odporne SD (IQR / 1.349) rozkładu, więc efekt jest porównywalny między rozkładami.
set.seed(2047)
B <- 10000; n <- 20
rozklady <- list(
  "normalny"            = function(k) rnorm(k),
  "prawoskośny (log-normalny)" = function(k) rlnorm(k, 0, 1),
  "ciężkie ogony (t, df = 3)"  = function(k) rt(k, 3))
odporne_sd <- c(1.349 / 1.349, (qlnorm(.75) - qlnorm(.25)) / 1.349, (qt(.75, 3) - qt(.25, 3)) / 1.349)
wyniki <- do.call(rbind, lapply(seq_along(rozklady), function(i) {
  do.call(rbind, lapply(c(0, 0.7), function(efekt) {
    p <- replicate(B, {
      x <- rozklady[[i]](n); y <- rozklady[[i]](n) + efekt * odporne_sd[i]
      c(Welch = t.test(x, y)$p.value, MW = wilcox.test(x, y)$p.value)
    })
    data.frame(rozklad = names(rozklady)[i], scenariusz = ifelse(efekt == 0, "brak efektu (błąd I rodzaju)", "przesunięcie (moc)"),
               Welch = mean(p["Welch", ] < .05), Mann_Whitney = mean(p["MW", ] < .05))
  }))
}))
wyniki$Welch <- round(wyniki$Welch, 3); wyniki$Mann_Whitney <- round(wyniki$Mann_Whitney, 3)
wyniki
Wynik w R
                     rozklad                   scenariusz Welch Mann_Whitney
1                   normalny brak efektu (błąd I rodzaju) 0.045        0.048
2                   normalny           przesunięcie (moc) 0.574        0.556
3 prawoskośny (log-normalny) brak efektu (błąd I rodzaju) 0.034        0.047
4 prawoskośny (log-normalny)           przesunięcie (moc) 0.294        0.672
5  ciężkie ogony (t, df = 3) brak efektu (błąd I rodzaju) 0.042        0.049
6  ciężkie ogony (t, df = 3)           przesunięcie (moc) 0.381        0.485
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats: wilcox.test(), kruskal.test(), friedman.test(), t.test(), p.adjust()). Statystykę Z policzono w pakiecie coin, wielkości efektu z przedziałami ufności – w pakiecie effectsize, test Dunna – w pakiecie rstatix, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Test rangowy „bo Shapiro–Wilk wyszedł istotny”. Przy dużych próbach test Shapiro–Wilka wykrywa nieistotne praktycznie odstępstwa, a przy małych – nie wykrywa poważnych. Decyzję opieraj na rodzaju zmiennej, wykresach i planie analizy.
- „Test Manna–Whitneya wykazał różnicę median”. Test porównuje rozkłady (rangi), a nie mediany. W przykładzie mediany grup z przypomnieniami i bez przypomnień różnią się tylko o 0.5 zadania, a średnie rangi – o 6.6: test reaguje na całe rozkłady.
- Średnie i SD zamiast median przy teście rangowym albo mediany bez kwartyli.
- Seria testów Manna–Whitneya zamiast testu Dunna po teście Kruskala–Wallisa, bez korekty na liczbę porównań.
- Test Friedmana na grupach niezależnych albo test Kruskala–Wallisa na pomiarach powtarzanych. Najpierw ustal, czy to te same osoby.
- Pomijanie remisów i zer. Na krótkich skalach remisów jest dużo. Napisz, czy p jest dokładne czy asymptotyczne i jak potraktowano zera w teście Wilcoxona.
- Brak wielkości efektu albo r = Z/√N bez informacji, jakie N przyjęto.
- Test rangowy jako sposób na interakcję. Testy z tego wpisu nie sprawdzają interakcji czynników. Schemat czas × grupa analizuj modelem, który ją uwzględnia (zob. ANOVA krok po kroku).
Jeśli nie wiesz, czy Twoje dane wymagają testu rangowego, albo chcesz sprawdzić, czy dobrze opisujesz jego wynik, możemy przejrzeć analizę i wyjaśnić ją krok po kroku w ramach analiz statystycznych dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy nienormalny rozkład zawsze oznacza test nieparametryczny?
Nie. Test t i ANOVA wymagają w przybliżeniu normalnego rozkładu średnich z prób, a nie surowych wyników, i w większych próbach są odporne na odstępstwa. Wstępne testowanie normalności testem Shapiro–Wilka i wybór testu na tej podstawie zaburza poziom błędu I rodzaju (Rochon i in., 2012). Test rangowy wybierz przy zmiennej porządkowej, małej próbie z silną skośnością albo efekcie podłogi lub sufitu.
Jaki test zamiast testu t dla prób zależnych, gdy dane są skośne?
Test znakowanych rang Wilcoxona: porównuje rangi różnic między pomiarami tych samych osób. Podaj mediany obu pomiarów z kwartylami, liczbę osób ze spadkiem, wzrostem i bez zmiany, Z, p i korelację rangowo-dwuseryjną dla par. Osoby bez zmiany są domyślnie usuwane, więc napisz, jak je potraktowano.
Jak opisać wynik testu Kruskala-Wallisa i testu Dunna w pracy?
Podaj H ze stopniami swobody, p i ε² z przedziałem ufności, a potem porównania parami testem Dunna z nazwą korekty, np. z = 3.18, pHolm = .004. Przy każdej grupie podaj medianę i kwartyle. Nie zastępuj testu Dunna serią testów Manna–Whitneya bez korekty.
Jaka wielkość efektu dla testu Manna-Whitneya i Wilcoxona jest najlepsza?
Najprościej zinterpretować korelację rangowo-dwuseryjną: to odsetek par zgodnych z hipotezą minus odsetek par niezgodnych, a pakiet effectsize liczy ją z 95% CI. Popularne r = Z/√N zależy od przyjętego N, więc zawsze napisz, przez co dzielisz. Dla testu Kruskala–Wallisa użyj ε², a dla testu Friedmana – W Kendalla.
Czy przy testach nieparametrycznych podawać średnią czy medianę?
Podstawą opisu są mediany z kwartylami (Q1–Q3) albo z rozstępem ćwiartkowym, bo test działa na rangach, a mediana nie reaguje na pojedyncze skrajne wartości. Średnią i odchylenie standardowe możesz dodać w tabeli, jeśli promotor ich oczekuje albo chcesz ułatwić porównania z innymi badaniami. Pamiętaj, że test nie porównuje samych median.
Powiązane hasła
Przeczytaj też
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikTest t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →Nie wiesz, czy Twoje dane wymagają testu rangowego?
Ocenimy rozkłady i rodzaj zmiennych, dobierzemy test i wielkość efektu, a potem wyjaśnimy wyniki tak, żebyś umiał(a) je opisać w pracy i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies—a paradox of statistical practice? BMC Medical Research Methodology, 12(1), Article 78. https://doi.org/10.1186/1471-2288-12-78 ● Otwarty dostęp
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Fritz, C. O., Morris, P. E., & Richler, J. J. (2012). Effect size estimates: Current use, calculations, and interpretation. Journal of Experimental Psychology: General, 141(1), 2–18. https://doi.org/10.1037/a0024338
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- IBM Corp. (b.d.). Legacy dialogs (nonparametric tests). IBM SPSS Statistics 31.0.0 documentation. Pobrano 21 października 2026 z https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-legacy-dialogs-nonparametric ● Otwarty dostęp
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491 ● Otwarty dostęp
- Pratt, J. W. (1959). Remarks on zeros and ties in the Wilcoxon signed rank procedures. Journal of the American Statistical Association, 54(287), 655–667. https://doi.org/10.1080/01621459.1959.10501526
- Rochon, J., Gondan, M., & Kieser, M. (2012). To test or not to test: Preliminary assessment of normality when comparing two independent samples. BMC Medical Research Methodology, 12(1), Article 81. https://doi.org/10.1186/1471-2288-12-81 ● Otwarty dostęp
- Vargha, A., & Delaney, H. D. (1998). The Kruskal-Wallis test and stochastic homogeneity. Journal of Educational and Behavioral Statistics, 23(2), 170–192. https://doi.org/10.3102/10769986023002170
Cytowania BibTeX
@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{fagerland2012ttests, author={Fagerland, Morten W.}, title={{t-tests, non-parametric tests, and large studies—a paradox of statistical practice?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={78}, doi={10.1186/1471-2288-12-78}}@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@article{fritz2012effect, author={Fritz, Catherine O. and Morris, Peter E. and Richler, Jennifer J.}, title={{Effect size estimates: Current use, calculations, and interpretation}}, journal={Journal of Experimental Psychology: General}, year={2012}, volume={141}, number={1}, pages={2--18}, doi={10.1037/a0024338}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@misc{ibmndnonparlegacy, author={{IBM Corp.}}, title={{Legacy dialogs (nonparametric tests)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=tests-legacy-dialogs-nonparametric}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{kruskal1952use, author={Kruskal, William H. and Wallis, W. Allen}, title={{Use of ranks in one-criterion variance analysis}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={583--621}, doi={10.1080/01621459.1952.10483441}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{mann1947test, author={Mann, H. B. and Whitney, D. R.}, title={{On a test of whether one of two random variables is stochastically larger than the other}}, journal={The Annals of Mathematical Statistics}, year={1947}, volume={18}, number={1}, pages={50--60}, doi={10.1214/aoms/1177730491}}@article{pratt1959remarks, author={Pratt, John W.}, title={{Remarks on zeros and ties in the Wilcoxon signed rank procedures}}, journal={Journal of the American Statistical Association}, year={1959}, volume={54}, number={287}, pages={655--667}, doi={10.1080/01621459.1959.10501526}}@article{rochon2012test, author={Rochon, Justine and Gondan, Matthias and Kieser, Meinhard}, title={{To test or not to test: Preliminary assessment of normality when comparing two independent samples}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={81}, doi={10.1186/1471-2288-12-81}}@article{vargha1998kruskal, author={Vargha, András and Delaney, Harold D.}, title={{The Kruskal-Wallis test and stochastic homogeneity}}, journal={Journal of Educational and Behavioral Statistics}, year={1998}, volume={23}, number={2}, pages={170--192}, doi={10.3102/10769986023002170}}