Co to jest rangowanie?
Rangowanie (ang. ranking, rank transformation) to zastąpienie wyników ich miejscami w uporządkowanym szeregu: najmniejszy wynik dostaje rangę 1, kolejny 2 i tak dalej aż do n. Rangi zachowują kolejność osób, ale gubią odległości między wynikami. Po rangowaniu nie wiadomo już, czy pierwszą i drugą osobę dzieliło 5 ms, czy 500 ms. Zmienna rangowa jest więc zmienną porządkową.
Na rangach opiera się większość testów nieparametrycznych i korelacje rangowe, a także rangi centylowe używane w normach testowych. W ankietach spotkasz też pytania rankingowe („uszereguj od najważniejszego”). Wtedy rangi nadaje sam respondent, a suma rang każdej osoby jest stała – to dane ipsatywne, które wymagają osobnych metod analizy.
Jak nadać rangi krok po kroku
Osiem osób popełniło w teście uwagi kolejno 4, 7, 2, 7, 5, 9, 7 i 4 błędy. Aby nadać rangi:
- uporządkuj wyniki od najmniejszego: 2, 4, 4, 5, 7, 7, 7, 9;
- przypisz im kolejne miejsca: 1, 2, 3, 4, 5, 6, 7, 8;
- osobom z takim samym wynikiem nadaj średnią z zajmowanych miejsc: dwie czwórki zajmują miejsca 2 i 3, więc obie dostają rangę 2.5, a trzy siódemki zajmują miejsca 5–7, więc każda dostaje 6.
Kontrola rachunków: suma rang n osób zawsze wynosi n(n + 1)/2, tu 8 × 9 / 2 = 36, a średnia ranga to (n + 1)/2, czyli 4.5. Rangę 1 można też nadać największemu wynikowi (w R: rank(-x)). Wtedy przy interpretacji pamiętaj, że niska ranga oznacza wysoki wynik.
Rangi wiązane – którą metodę wybrać?
Równe wyniki tworzą rangi wiązane (ang. ties). Programy oferują kilka sposobów ich traktowania:
| Metoda | Rangi dla 2, 4, 4, 5, 7, 7, 7, 9 | R | SPSS (Ties) |
|---|---|---|---|
| Średnia | 1, 2.5, 2.5, 4, 6, 6, 6, 8 | rank(x) (domyślnie) | Mean |
| Najniższa („sportowa”) | 1, 2, 2, 4, 5, 5, 5, 8 | ties.method = "min" | Low |
| Najwyższa | 1, 3, 3, 4, 7, 7, 7, 8 | ties.method = "max" | High |
| Gęsta (bez luk) | 1, 2, 2, 3, 4, 4, 4, 5 | dplyr::dense_rank() | Sequential ranks to unique values |
| Kolejność w pliku | 1, 2, 3, 4, 5, 6, 7, 8 | ties.method = "first" | – |
Do testów statystycznych i korelacji rangowych używaj rang średnich. Tak traktował wartości wiązane Kendall (1945), analizując ich wpływ na współczynniki korelacji rang, i tak liczą je testy w R i SPSS. Tylko rangi średnie zachowują sumę 36 – przy metodzie najniższej spada ona do 32, co zaburzyłoby statystyki testowe. Rangi „sportowe” i gęste przydają się w zestawieniach i rankingach, a kolejność z pliku – wyłącznie do nadania unikalnych numerów.
Rangi jako podstawa testów nieparametrycznych
Conover i Iman (1981) pokazali, że wiele testów nieparametrycznych to zwykłe procedury parametryczne zastosowane do rang zamiast do surowych wyników. Dlatego:
- korelacja Spearmana to korelacja Pearsona policzona na rangach;
- test U Manna-Whitneya daje prawie ten sam wynik co test t na rangach;
- test Kruskala-Wallisa odpowiada jednoczynnikowej analizie wariancji na rangach;
- test Wilcoxona dla par ranguje wartości bezwzględne różnic między pomiarami.
Kluczowe jest wspólne rangowanie: w testach dla grup niezależnych rangi nadaje się wszystkim obserwacjom razem, a dopiero potem porównuje grupy. Na łącznym rangowaniu opierają się zarówno test Manna-Whitneya, jak i test Kruskala-Wallisa (Nahm, 2016). Rysunek 1 pokazuje, co to daje w praktyce.
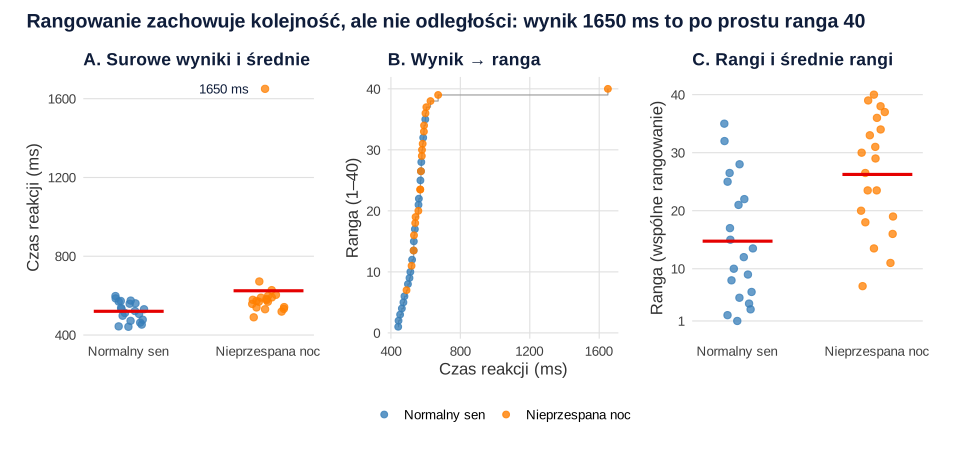
Dwudziestu studentów po normalnym śnie i dwudziestu po nieprzespanej nocy wykonało zadanie uwagi. Jedna osoba z drugiej grupy, wyraźnie rozkojarzona, miała czas reakcji 1650 ms. Ten jeden wynik podniósł odchylenie standardowe swojej grupy z 41.3 do 244.6 ms, więc test t Welcha nie wykazał istotnej różnicy (p = .076). Po wspólnym rangowaniu wynik 1650 ms to po prostu ranga 40 – najwyższa, ale tylko o 1 wyższa od kolejnej. Średnie rangi wyniosły 14.75 i 26.25, test Manna-Whitneya dał p = .002, a test t na rangach p = .001. Gdyby ta osoba miała 900 ms zamiast 1650 ms, jej ranga – i wynik testu Manna-Whitneya – byłyby identyczne.
Nie traktuj tego jako przepisu na „istotny wynik”. Test wybierz przed analizą, na podstawie rodzaju danych i hipotezy (zob. p-hacking), a wartość skrajną najpierw sprawdź (zob. obserwacja odstająca). Pamiętaj też, że test na rangach odpowiada na inne pytanie niż test t: dotyczy tego, czy wyniki jednej grupy mają tendencję do bycia wyższymi, a nie różnicy średnich.
Rangi centylowe i transformacja normalizująca
Rangę łatwo przeliczyć na rangę centylową, która pokazuje położenie osoby w grupie odniesienia. Jeden z popularnych wzorów to 100 × (R − 0.5) / n: osoba z czasem reakcji 444 ms (ranga 2) ma rangę centylową 3.8, a osoba z czasem 1650 ms (ranga 40) – 98.8. Na tej logice opierają się normy centylowe (zob. percentyl).
Po zamianie rangi centylowej na wartość standardowego rozkładu normalnego, z = Φ−1[(R − 0.5) / n], powstaje rangowa transformacja normalizująca (ang. rank-based inverse normal transformation; jedna z jej wersji nazywa się rankit). W przykładzie wyniki 444, 519 i 1650 ms zamieniają się w −1.78, −0.64 i 2.24. Literatura ocenia to narzędzie ostrożnie. Bishara i Hittner (2012) w symulacjach testowania istotności korelacji przy danych nienormalnych stwierdzili, że przy n ≥ 20 przekształcenie rankit przed obliczeniem r Pearsona najlepiej ograniczało błędy I i II rodzaju. Beasley i in. (2009) pokazali natomiast, że takie transformacje nie zawsze utrzymują poprawny poziom błędu I rodzaju i w niektórych sytuacjach obniżają moc, a ich użycie uznali za uzasadnione głównie w prostych schematach z umiarkowanymi i dużymi próbami. Stosuj ją więc tylko z konkretnego powodu, opisz w pracy i pamiętaj, że wyniki dotyczą rang, a nie surowych punktów (zob. też wynik znormalizowany).
Jak opisać rangowanie w pracy
W rozdziale z wynikami napisz, że rangi nadano łącznie wszystkim obserwacjom i jak potraktowano wartości wiązane, a przy teście podaj średnie rangi w grupach:
Jak dobrać test do rodzaju danych i hipotezy, wyjaśniamy w poradniku jak dobrać test statystyczny do hipotezy.
Przykład w R
Kod pokazuje metody rangowania wartości wiązanych, pułapkę braków danych i porównanie testów na danych z rysunku 1. W SPSS rangi utworzysz w menu Przekształcenia → Rangowanie obserwacji (Transform → Rank Cases): wybierz, czy rangę 1 ma dostać najmniejsza, czy największa wartość (Assign Rank 1 to), sposób traktowania wartości wiązanych (przycisk Ties) i rodzaj rang (Rank Types, m.in. rangi centylowe i wyniki normalne). SPSS zapisze rangi jako nową zmienną.
Rangi, rangi wiązane i testy na rangach
R
# Rangi i rangi wiązane: liczba błędów w teście uwagi u 8 osób
bledy <- c(4, 7, 2, 7, 5, 9, 7, 4)
data.frame(bledy,
           srednia   = rank(bledy),                        # domyślnie: rangi średnie
           min       = rank(bledy, ties.method = "min"),   # jak w sporcie: 1, 2, 2, 4…
           max       = rank(bledy, ties.method = "max"),
           gesta     = dplyr::dense_rank(bledy),           # bez luk: 1, 2, 2, 3…
           kolejnosc = rank(bledy, ties.method = "first"))
rank(-bledy)                                 # ranga 1 dla największej wartości
rank(c(310, NA, 280))                        # uwaga: brak danych dostaje rangę 3!
rank(c(310, NA, 280), na.last = "keep")

# Czas reakcji (ms): normalny sen vs nieprzespana noc, n = 20 w grupie (dane symulowane)
set.seed(124)
sen  <- round(rnorm(20, 520, 55))
brak <- round(rnorm(20, 580, 55)); brak[20] <- 1650   # jedna wartość skrajna
rt <- c(sen, brak)
grupa <- factor(rep(c("Normalny sen", "Nieprzespana noc"), each = 20),
                levels = c("Normalny sen", "Nieprzespana noc"))
ranga <- rank(rt)                            # wspólne rangowanie wszystkich 40 wyników
tapply(ranga, grupa, mean)                   # średnie rangi w grupach
t.test(rt ~ grupa)$p.value                   # test t Welcha na surowych wynikach
wilcox.test(rt ~ grupa, exact = FALSE)       # test U Manna-Whitneya (R podaje W)
t.test(ranga ~ grupa, var.equal = TRUE)$p.value   # test t na rangach – prawie to samo p
round(qnorm((ranga[c(1, 21, 40)] - 0.5) / 40), 2)   # transformacja rankit trzech wyników
Wynik w R
  bledy srednia min max gesta kolejnosc
1     4     2.5   2   3     2         2
2     7     6.0   5   7     4         5
3     2     1.0   1   1     1         1
4     7     6.0   5   7     4         6
5     5     4.0   4   4     3         4
6     9     8.0   8   8     5         8
7     7     6.0   5   7     4         7
8     4     2.5   2   3     2         3
[1] 6.5 3.0 8.0 3.0 5.0 1.0 3.0 6.5
[1] 2 3 1
[1]  2 NA  1
    Normalny sen Nieprzespana noc
           14.75            26.25
[1] 0.07622774

	Wilcoxon rank sum test with continuity correction

data:  rt by grupa
W = 85, p-value = 0.00195
alternative hypothesis: true location shift is not equal to 0

[1] 0.001070078
[1] -1.78 -0.64  2.24
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rangi gęste policzono w pakiecie dplyr, a rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Rangowanie osobno w każdej grupie – średnia ranga wynosi wtedy 10.5 w obu grupach i porównanie traci sens. Rangi nadaj wszystkim obserwacjom razem.
- Metoda najniższa albo „kolejność w pliku” w testach – zmienia sumę rang; do testów i korelacji używaj rang średnich.
- Braki danych z rangą –
rank()w R domyślnie nadaje brakom najwyższe rangi; użyjna.last = "keep". - Pomylony kierunek – zanim zinterpretujesz średnie rangi, sprawdź, czy ranga 1 oznacza najmniejszy, czy największy wynik.
- Średnia ranga jak wynik w punktach – „średnia ranga 26.25” nie oznacza 26.25 ms ani 26.25 punktu; to położenie w uporządkowanym szeregu.
- Pytania rankingowe analizowane jak niezależne pozycje – rangi nadane przez respondenta są od siebie zależne, bo ich suma jest stała.
Najczęstsze pytania
Co to jest rangowanie danych?
To zastąpienie każdego wyniku jego miejscem w uporządkowanym szeregu: najmniejszy wynik dostaje rangę 1, największy – rangę n. Rangi zachowują kolejność osób, ale nie odległości między wynikami, dlatego zmienna rangowa jest zmienną porządkową.
Jak nadać rangi przy takich samych wynikach?
Nadaj im średnią z miejsc, które razem zajmują. Jeśli dwie osoby zajmują miejsca 2 i 3, obie dostają rangę 2.5; jeśli trzy osoby zajmują miejsca 5–7, każda dostaje rangę 6. Tak liczą rangi testy nieparametryczne w R i SPSS (w R: rank(x)).
Czym różnią się rangi średnie, najniższe i gęste?
Przy wynikach 2, 4, 4, 5 rangi średnie to 1, 2.5, 2.5, 4, najniższe („sportowe”) – 1, 2, 2, 4, a gęste – 1, 2, 2, 3. Do testów i korelacji używaj rang średnich, bo tylko one zachowują sumę rang n(n + 1)/2; pozostałe przydają się w rankingach i zestawieniach.
Dlaczego testy nieparametryczne używają rang?
Bo rangi są odporne na wartości skrajne i nie wymagają rozkładu normalnego – liczy się tylko kolejność wyników. Wiele testów nieparametrycznych to zwykłe procedury parametryczne zastosowane do rang (Conover i Iman, 1981): korelacja Spearmana to korelacja Pearsona na rangach, a test Manna-Whitneya daje prawie ten sam wynik co test t na rangach.
Jak zrangować dane w SPSS?
Wybierz Przekształcenia → Rangowanie obserwacji (Transform → Rank Cases), przenieś zmienną, zdecyduj, czy ranga 1 ma oznaczać najmniejszą, czy największą wartość, a w oknie Ties wybierz Mean (rangi średnie). SPSS zapisze rangi jako nową zmienną.
Czy rangi nadaje się osobno w każdej grupie?
Nie – w testach dla grup niezależnych rangi nadaje się wszystkim obserwacjom razem, a dopiero potem porównuje średnie rangi w grupach. Przy rangowaniu osobno w każdej grupie średnie rangi są z definicji takie same (w przykładzie 10.5 w obu grupach) i porównanie traci sens.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Beasley, T. M., Erickson, S., & Allison, D. B. (2009). Rank-based inverse normal transformations are increasingly used, but are they merited? Behavior Genetics, 39(5), 580–595. https://doi.org/10.1007/s10519-009-9281-0 ● Otwarty dostęp
- Bishara, A. J., & Hittner, J. B. (2012). Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches. Psychological Methods, 17(3), 399–417. https://doi.org/10.1037/a0028087
- Conover, W. J., & Iman, R. L. (1981). Rank transformations as a bridge between parametric and nonparametric statistics. The American Statistician, 35(3), 124–129. https://doi.org/10.1080/00031305.1981.10479327
- Kendall, M. G. (1945). The treatment of ties in ranking problems. Biometrika, 33(3), 239–251. https://doi.org/10.1093/biomet/33.3.239
- Nahm, F. S. (2016). Nonparametric statistical tests for the continuous data: The basic concept and the practical use. Korean Journal of Anesthesiology, 69(1), 8–14. https://doi.org/10.4097/kjae.2016.69.1.8 ● Otwarty dostęp
Cytowania BibTeX
@article{beasley2009rank, author={Beasley, T. Mark and Erickson, Stephen and Allison, David B.}, title={{Rank-based inverse normal transformations are increasingly used, but are they merited?}}, journal={Behavior Genetics}, year={2009}, volume={39}, number={5}, pages={580--595}, doi={10.1007/s10519-009-9281-0}}@article{bishara2012testing, author={Bishara, Anthony J. and Hittner, James B.}, title={{Testing the significance of a correlation with nonnormal data: Comparison of Pearson, Spearman, transformation, and resampling approaches}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={399--417}, doi={10.1037/a0028087}}@article{conover1981rank, author={Conover, W. J. and Iman, Ronald L.}, title={{Rank transformations as a bridge between parametric and nonparametric statistics}}, journal={The American Statistician}, year={1981}, volume={35}, number={3}, pages={124--129}, doi={10.1080/00031305.1981.10479327}}@article{kendall1945treatment, author={Kendall, M. G.}, title={{The treatment of ties in ranking problems}}, journal={Biometrika}, year={1945}, volume={33}, number={3}, pages={239--251}, doi={10.1093/biomet/33.3.239}}@article{nahm2016nonparametric, author={Nahm, Francis Sahngun}, title={{Nonparametric statistical tests for the continuous data: The basic concept and the practical use}}, journal={Korean Journal of Anesthesiology}, year={2016}, volume={69}, number={1}, pages={8--14}, doi={10.4097/kjae.2016.69.1.8}}