Co to jest rekodowanie?
Rekodowanie (ang. recoding) to zmiana wartości zmiennej według ustalonej reguły: każdej starej wartości (kodowi) przypisuje się nową. Rekoduje się prawie każdy zbiór danych z ankiety: odpowiedzi słowne zamienia się na liczby, odwraca pozycje odwrócone, łączy rzadkie kategorie, tworzy zmienne zero-jedynkowe i zamienia umowne kody braków na puste wartości.
Informacja w danych pozostaje nienaruszona tylko wtedy, gdy reguła jest odwracalna – jak przy odwróceniu skali 1–5. Łączenie kategorii czy podział wyników na przedziały zawsze coś usuwa, dlatego takie decyzje trzeba uzasadnić i opisać w pracy. Cały proces przygotowania danych z formularza internetowego pokazujemy w poradniku dane z Google Forms i LimeSurvey do SPSS i R, a tu zbieramy najważniejsze reguły.
Najczęstsze rodzaje rekodowania
| Rodzaj | Przykład | Reguła | Na co uważać |
|---|---|---|---|
| Odwrócenie pozycji | „Zwykle łatwo się odprężam” w skali stresu 1–5 | nowa = (min + max) − stara, tu 6 − x | wzór zależy od zakresu: dla 1–7 to 8 − x, dla 0–4 to 4 − x |
| Łączenie kategorii | miejsce zamieszkania: 5 kategorii → 3 | 1 → wieś; 2–3 → miasto do 100 tys.; 4–5 → miasto powyżej 100 tys. | reguły ustal przed analizą, na podstawie treści i liczebności kategorii |
| Zmienne zero-jedynkowe | kierunek: psychologia, pedagogika, socjologia | k − 1 zmiennych 0/1 dla k kategorii (dummy coding) | jedna kategoria jest punktem odniesienia |
| Kody braków | 99 = odmowa odpowiedzi | 99 → brak danych | niezdefiniowany kod liczy się jak zwykła liczba |
| Przedziały | wiek → grupy wiekowe; wynik skali → „niski” i „wysoki” | granice przedziałów | podział zmiennej ilościowej osłabia związki (zob. niżej) |
| Tekst → liczby | „Raczej się zgadzam” → 4 | jawna mapa etykieta → kod | kody nadane alfabetycznie niszczą porządek skali Likerta |
Weijters i in. (2013) definiują pozycje odwrócone właśnie przez rekodowanie: to pozycje, których odpowiedzi trzeba przekodować, aby kierunek wszystkich pozycji skali był zgodny. Zwracają też uwagę, że takie pozycje często wywołują problematyczne odpowiedzi – z powodu potakiwania, nieuważności i efektu potwierdzania. Po rekodowaniu sprawdź więc, czy pozycje odwrócone korelują z resztą skali dodatnio.
Przykład: pięć przekształceń na małym zbiorze
Osiem osób (dane fikcyjne) podało wiek, miejsce zamieszkania (od 1 = wieś do 5 = miasto powyżej 500 tys. mieszkańców), kierunek studiów i odpowiedź na odwróconą pozycję skali stresu (1–5). Dwie osoby odmówiły podania wieku, co zakodowano jako 99. Fragment danych przed rekodowaniem i po nim:
| Osoba | Wiek → wiek_k | Miejsce → miejsce3 | Kierunek → ped, soc | z3 → z3_r |
|---|---|---|---|---|
| 1 | 21 → 21 | 1 → wieś | psychologia → 0, 0 | 2 → 4 |
| 2 | 23 → 23 | 4 → miasto powyżej 100 tys. | pedagogika → 1, 0 | 4 → 2 |
| 3 | 99 → brak danych | 2 → miasto do 100 tys. | psychologia → 0, 0 | 5 → 1 |
| 4 | 22 → 22 | 5 → miasto powyżej 100 tys. | socjologia → 0, 1 | 1 → 5 |
Najbardziej zdradliwy jest kod braku. Dopóki 99 zostaje w danych, średni wiek wynosi 41.25, a po zamianie kodu na brak danych – 22.00 (n = 6). Wilson i in. (2017) zalecają zastępowanie sztucznych kodów braków, takich jak −99, wartością NA; w SPSS taki kod trzeba zdefiniować jako brak danych (zob. braki danych). Drugą pułapką jest wzór odwrócenia: 5 − x zamiast 6 − x daje wartości od 0 do 4 zamiast od 1 do 5 i przesuwa średnią skali. Zmienne ped i soc to zmienne zero-jedynkowe dla zmiennej nominalnej z trzema kategoriami; psychologia, zakodowana jako 0 w obu, jest kategorią odniesienia.
Na te same czy na inne zmienne?
W SPSS są dwa polecenia: Przekształcenia → Rekoduj na te same zmienne (Transform → Recode into Same Variables) i Przekształcenia → Rekoduj na inne zmienne (Recode into Different Variables). Pierwsze nadpisuje oryginalne wartości, więc po zapisaniu pliku nie da się już sprawdzić, co odpowiedziała dana osoba. Rekoduj zawsze na inne zmienne, np. z3 → z3_r, a surowe dane trzymaj w osobnym, nienaruszonym pliku. Wilson i in. (2017) radzą zachować dane w postaci, w jakiej je zebrano, i zapisywać każdy krok przetwarzania w skrypcie, a Broman i Woo (2018) – nie wykonywać obliczeń w plikach z danymi surowymi.
W oknie Rekoduj na inne zmienne wpisz nazwę i etykietę nowej zmiennej, a w Wartości stare i nowe (Old and New Values) zdefiniuj reguły: pojedyncze wartości, zakresy (Range), braki danych (System-missing albo System- or user-missing) i pozostałe wartości (All other values). Ostatnią opcję łącz z Copy old values albo z brakiem danych, a nie z nową liczbą – inaczej nieprzewidziane kody, np. 99, po cichu dostaną zwykłą wartość. Automatyczne rekodowanie (Automatic Recode) nadaje kody alfabetycznie, więc nadaje się tylko do zmiennych nominalnych. Zamiast OK kliknij Wklej (Paste), aby zapisać polecenie w składni, np.: RECODE z3 (1=5) (2=4) (3=3) (4=2) (5=1) (ELSE=SYSMIS) INTO z3_r. EXECUTE.
Uwaga na podział zmiennej ilościowej na grupy
Częstym rekodowaniem jest podział wyników skali na „niskie” i „wysokie”, zwykle medianą. MacCallum i in. (2002) przeanalizowali tę praktykę i stwierdzili, że rzadko daje się ją obronić, a często prowadzi do mylących wyników. Rysunek 1 pokazuje dlaczego.
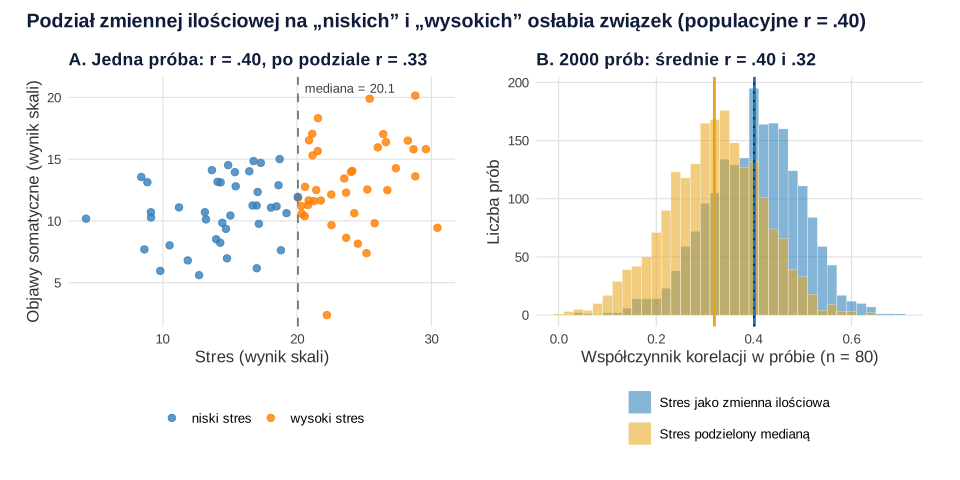
W 2000 symulowanych próbach po 80 osób, przy korelacji w populacji równej .40, średnia korelacja stresu z objawami wyniosła .401, gdy stres był zmienną ilościową, i .319 po podziale medianą – to strata około 20% siły związku. Istotną korelację (α = .05) wykryto w 96.6% prób dla pełnej skali i w 84.1% po podziale. Podział ma też dziwne skutki dla pojedynczych osób: w próbie z panelu A osoba z wynikiem 20.0 trafiła do grupy „niski stres” razem z osobą z wynikiem 4.3, a od osoby z wynikiem 20.1 oddziela ją granica grup. Jeśli grupy są potrzebne do opisu, utwórz je obok zmiennej ilościowej, a w analizach używaj pełnej skali, np. w korelacji Pearsona albo regresji liniowej.
Jak opisać rekodowanie w pracy
W części o analizie danych wymień przekształcenia, które zmieniają sens zmiennych, i podaj ich uzasadnienie. Przykład:
Po odwróceniu pozycji policz rzetelność skali – jak ją ocenić i opisać, piszemy w poradniku o alfie Cronbacha.
Przykład w R
Kod wykonuje pięć przekształceń z przykładu na nowych zmiennych, sprawdza je tabelami krzyżowymi starych i nowych wartości i powtarza symulację z rysunku 1. W pakiecie dplyr 1.2.0 funkcja case_match() jest wycofywana na rzecz recode_values(), a starsza recode() nadal działa, ale nie jest już rozwijana; case_when() sprawdza się przy regułach z warunkami i zakresami.
Rekodowanie zmiennych i koszt podziału medianą
R
library(dplyr)   # mutate(), na_if(), case_when(), recode_values() (dplyr >= 1.2.0)

# Dane fikcyjne: 8 osób z ankiety
dane <- data.frame(
  id       = 1:8,
  wiek     = c(21, 23, 99, 22, 20, 99, 24, 22),   # 99 = odmowa odpowiedzi
  miejsce  = c(1, 4, 2, 5, 3, 1, 4, 2),           # 1 = wieś … 5 = miasto powyżej 500 tys.
  kierunek = c("psychologia", "pedagogika", "psychologia", "socjologia",
               "pedagogika", "psychologia", "socjologia", "psychologia"),
  z3       = c(2, 4, 5, 1, 3, 2, 5, 4))           # pozycja odwrócona, skala 1–5
mean(dane$wiek)                                   # kod 99 policzony jak wiek!

# Rekodowanie na NOWE zmienne – oryginalne kolumny zostają bez zmian
dane <- dane |>
  mutate(
    wiek_k   = na_if(wiek, 99),                   # kod braku -> NA
    z3_r     = 6 - z3,                            # odwrócenie: (min + max) - x
    miejsce3 = case_when(miejsce == 1 ~ "wieś",
                         miejsce %in% 2:3 ~ "miasto do 100 tys.",
                         miejsce %in% 4:5 ~ "miasto powyżej 100 tys."),
    ped = as.integer(kierunek == "pedagogika"),   # zmienne zero-jedynkowe;
    soc = as.integer(kierunek == "socjologia"))   # psychologia = kategoria odniesienia
mean(dane$wiek_k, na.rm = TRUE)
dane

# Kontrola: każdej starej wartości odpowiada dokładnie jedna nowa
table(stara = dane$z3, nowa = dane$z3_r)
table(dane$miejsce, dane$miejsce3, useNA = "ifany")

# Ta sama mapa w recode_values(); unmatched = "error" zatrzyma kod przy nieprzewidzianej wartości
recode_values(dane$z3, 1 ~ 5, 2 ~ 4, 3 ~ 3, 4 ~ 2, 5 ~ 1, unmatched = "error")

# Koszt podziału zmiennej ilościowej medianą: 2000 prób po 80 osób, populacyjne r = .40
set.seed(90)
sym <- replicate(2000, {
  stres <- rnorm(80); objawy <- 0.4 * stres + sqrt(1 - 0.4^2) * rnorm(80)
  grupa <- as.integer(stres > median(stres))      # „niski” i „wysoki” stres
  c(r_ciagla = cor(stres, objawy), r_podzial = cor(grupa, objawy),
    p_ciagla = cor.test(stres, objawy)$p.value, p_podzial = cor.test(grupa, objawy)$p.value)
})
round(c(rowMeans(sym[1:2, ]), moc = rowMeans(sym[3:4, ] < .05)), 3)
Wynik w R
[1] 41.25
[1] 22
  id wiek miejsce    kierunek z3 wiek_k z3_r                miejsce3 ped soc
1  1   21       1 psychologia  2     21    4                    wieś   0   0
2  2   23       4  pedagogika  4     23    2 miasto powyżej 100 tys.   1   0
3  3   99       2 psychologia  5     NA    1      miasto do 100 tys.   0   0
4  4   22       5  socjologia  1     22    5 miasto powyżej 100 tys.   0   1
5  5   20       3  pedagogika  3     20    3      miasto do 100 tys.   1   0
6  6   99       1 psychologia  2     NA    4                    wieś   0   0
7  7   24       4  socjologia  5     24    1 miasto powyżej 100 tys.   0   1
8  8   22       2 psychologia  4     22    2      miasto do 100 tys.   0   0
     nowa
stara 1 2 3 4 5
    1 0 0 0 0 1
    2 0 0 0 2 0
    3 0 0 1 0 0
    4 0 2 0 0 0
    5 2 0 0 0 0

    miasto do 100 tys. miasto powyżej 100 tys. wieś
  1                  0                       0    2
  2                  2                       0    0
  3                  1                       0    0
  4                  0                       2    0
  5                  0                       1    0
[1] 4 2 1 5 3 4 1 2
     r_ciagla     r_podzial  moc.p_ciagla moc.p_podzial
        0.401         0.319         0.966         0.841
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; przekształcenia wykonano w pakiecie dplyr, a rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Nadpisywanie surowych danych – po „rekodowaniu na te same zmienne” nie da się sprawdzić ani powtórzyć przekształceń (Wilson i in., 2017).
- Kod braku policzony jak liczba – w przykładzie średni wiek wyniósł 41.25 zamiast 22.00.
- Zły wzór albo podwójne odwrócenie – 5 − x na skali 1–5 albo ponowne odwrócenie pozycji, którą odwrócono już w formularzu lub w pliku eksportu.
- „Wszystkie pozostałe wartości” zamienione na liczbę – braki i nieprzewidziane kody stają się zwykłymi wynikami.
- Łączenie kategorii po obejrzeniu wyników – dobieranie granic tak, by wynik był istotny, to odmiana p-hackingu.
- k zmiennych zero-jedynkowych zamiast k − 1 – w regresji z wyrazem wolnym zmienne są wtedy liniowo zależne i modelu nie da się oszacować.
- Brak kontroli – po każdym rekodowaniu zrób tabelę krzyżową starej i nowej zmiennej.
Najczęstsze pytania
Co to jest rekodowanie zmiennej?
To zmiana wartości zmiennej według ustalonej reguły: każdej starej wartości przypisuje się nową. Przykłady to odwrócenie pozycji skali (1 → 5, 2 → 4…), połączenie kategorii, zamiana odpowiedzi słownych na liczby, utworzenie zmiennych zero-jedynkowych i zamiana kodu 99 na brak danych.
Rekodować na te same czy na inne zmienne w SPSS?
Na inne. Rekoduj na te same zmienne nadpisuje oryginalne wartości, więc po zapisaniu pliku nie da się sprawdzić ani poprawić przekształcenia. Rekoduj na inne zmienne tworzy nową zmienną (np. z3_r), a oryginał zostaje bez zmian.
Jak odwrócić pozycję na skali 1–5?
Użyj wzoru (min + max) − x, czyli 6 − x: 1 zamienia się w 5, 2 w 4, a 3 zostaje 3. Dla skali 1–7 wzór to 8 − x, a dla 0–4 – 4 − x. Wzór 5 − x na skali 1–5 jest błędny, bo daje wartości od 0 do 4.
Jak zrekodować zmienną w R?
Przy prostych odwzorowaniach użyj arytmetyki (6 - x) albo funkcji recode_values() z pakietu dplyr (od wersji 1.2.0), przy warunkach i zakresach – case_when(), a kody braków zamień na NA funkcją na_if(). Wynik zapisz w nowej kolumnie i sprawdź tabelą table(stara, nowa).
Co zrobić z kodem 99 w danych?
Zamień go na brak danych przed jakąkolwiek analizą: w R na NA (na_if(x, 99)), w SPSS zdefiniuj 99 jako brak danych w kolumnie Braki danych. Niezdefiniowany kod liczy się jak zwykła liczba – w przykładzie z tej strony podniósł średni wiek z 22.00 do 41.25.
Czy można podzielić zmienną ilościową na grupy medianą?
Lepiej tego unikać. Podział medianą wyrzuca informację o różnicach w obrębie grup i osłabia związki: w symulacji średnia korelacja spadła z .40 do .32, a odsetek prób z istotnym wynikiem z 96.6% do 84.1% (MacCallum i in., 2002). Grupy możesz utworzyć do opisu, ale w analizach używaj pełnej skali.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Łączenie kategorii odpowiedzi – kiedy i jak
Likert 5 na 3, „nie wiem”, małe kategorie metryczki, łączenie pod wynik w symulacji i alternatywy: test Fishera, trend, regresja porządkowa – z kodem R.
Czytaj →PoradnikMetryczka: jak zakodować wiek, staż i wykształcenie
Liczba czy przedział, czyszczenie wpisów „50 lat” i „1988”, spójność wieku i stażu, kwartyle a progi, wykształcenie w analizie i Tabela 1.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19 ● Otwarty dostęp: pełny tekst
- Weijters, B., Baumgartner, H., & Schillewaert, N. (2013). Reversed item bias: An integrative model. Psychological Methods, 18(3), 320–334. https://doi.org/10.1037/a0032121 ● Otwarty dostęp: pełny tekst
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
Cytowania BibTeX
@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{weijters2013reversed, author={Weijters, Bert and Baumgartner, Hans and Schillewaert, Niels}, title={{Reversed item bias: An integrative model}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={320--334}, doi={10.1037/a0032121}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}