Co to jest dyferencjał semantyczny?
Skala dyferencjału semantycznego (ang. semantic differential) to technika, w której osoba badana ocenia pojęcie – np. „statystyka”, „ja”, „terapia online” – na kilku lub kilkunastu skalach dwubiegunowych. Na krańcach każdej skali stoją przeciwstawne przymiotniki, a między nimi zwykle siedem pól do zaznaczenia:
Technikę zaproponowali Osgood, Suci i Tannenbaum w książce The Measurement of Meaning z 1957 roku jako sposób pomiaru znaczenia pojęć: badani oceniali wiele obiektów na długiej liście skal dwubiegunowych, a oceny poddawano analizie czynnikowej (Kervyn i in., 2013). Dziś dyferencjał stosuje się w badaniach postaw, stereotypów, obrazu siebie czy wizerunku instytucji.
Od skali Likerta dyferencjał różni się formatem: w skali Likerta osoba określa, w jakim stopniu zgadza się z twierdzeniem, a tu – gdzie umieszcza pojęcie między dwoma biegunami. Etykiety odpowiedzi są więc dopasowane do treści. Ma to znaczenie, bo w badaniu Sarisa i in. (2010) pytania z kategoriami odpowiedzi dopasowanymi do treści dawały odpowiedzi znacznie lepszej jakości niż format „zgadzam się – nie zgadzam się”.
Ocena, siła i aktywność
Analizy czynnikowe Osgooda i współpracowników konsekwentnie ujawniały trzy wymiary znaczenia (Kervyn i in., 2013):
| Wymiar | Przykładowe pary przymiotników | Co opisuje |
|---|---|---|
| Ocena (evaluation) | dobry–zły, pozytywny–negatywny, prawdziwy–fałszywy | Ogólny stosunek do pojęcia |
| Siła (potency) | silny–słaby, twardy–miękki, ciężki–lekki | Moc, trudność, „ciężar” pojęcia |
| Aktywność (activity) | aktywny–bierny, szybki–wolny, gorący–zimny | Dynamikę, pobudzenie |
Ocena i siła pojawiały się stabilnie w różnych kulturach i dla różnych obiektów, natomiast aktywność okazywała się mniej stabilna. Przy ocenianiu obiektów społecznych siła i aktywność mogą się łączyć w jeden wymiar dynamizmu. Kervyn i in. (2013) pokazali też, że ocena i siła wiążą się z dwoma wymiarami spostrzegania grup – ciepłem i kompetencją – i przebiegają po przekątnych wyznaczonej przez nie przestrzeni. Trzech wymiarów nie zakładaj więc z góry: sprawdź je we własnych danych.
Jak zbudować skalę dyferencjału semantycznego?
- Nazwij pojęcie jednoznacznie – „statystyka jako przedmiot na studiach” zamiast samego „statystyka”, jeśli o to ci chodzi.
- Dobierz pary przymiotników, które są rzeczywistymi przeciwieństwami i pasują do pojęcia. Zaplanuj co najmniej trzy pary na każdy wymiar, który chcesz mierzyć.
- Ustal format skali – klasycznie siedem punktów z neutralnym środkiem i opisanymi biegunami. Cechy skali odpowiedzi, m.in. liczba punktów i sposób opisania kategorii, mogą wpływać na jakość danych; przegląd badań i zalecenia znajdziesz u DeCastellarnau (2018) oraz w wytycznych Menold i Bogner (2016).
- Zmieniaj kierunek par – w części wierszy biegun pozytywny umieść po prawej, by utrudnić zaznaczanie jednej kolumny (zob. straightlining). Przed analizą przekoduj te pary wzorem 8 − x (zob. pozycja odwrócona).
- Użyj tych samych par dla wszystkich porównywanych pojęć i przetestuj zrozumiałość przymiotników w badaniu pilotażowym lub wywiadzie poznawczym.
Przykład: profil pojęć „statystyka” i „psychologia”
Stu dwudziestu studentów psychologii (dane symulowane) oceniło dwa pojęcia na dziewięciu parach przymiotników: po trzy dla oceny, siły i aktywności. W arkuszu co druga para miała odwrócone bieguny; po przekodowaniu 7 oznacza zawsze biegun „dobry”, „silny” lub „aktywny”. Wynik wymiaru to średnia trzech par. Rzetelność wymiarów wyniosła od α = .70 do α = .81.
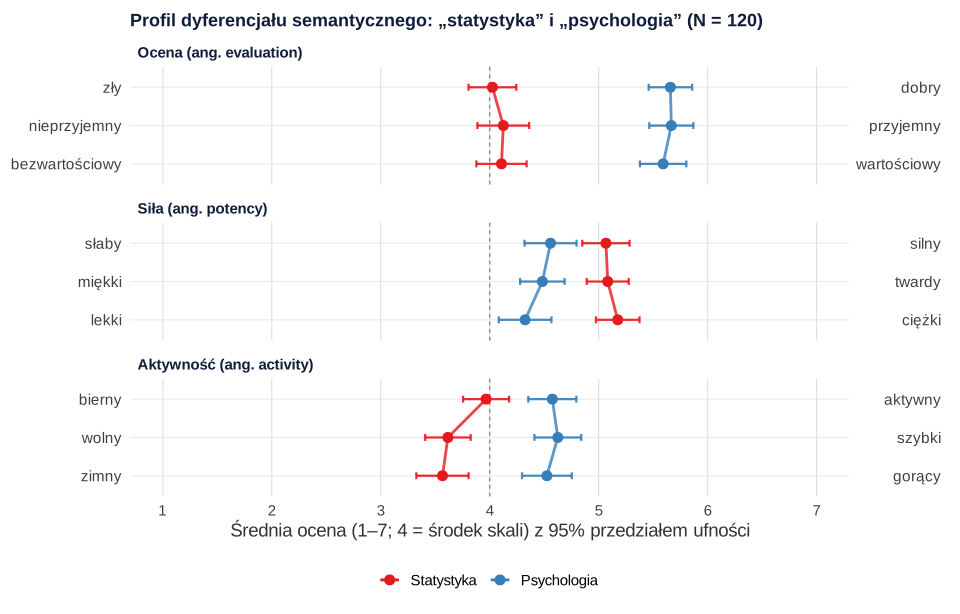
Statystyka została oceniona niemal neutralnie (ocena: M = 4.09, SD = 1.06), ale jako „silna”, czyli twarda i ciężka (M = 5.11, SD = 0.89), i raczej bierna (M = 3.72, SD = 0.99). Psychologię oceniono wyraźnie pozytywniej (M = 5.64, SD = 0.93), jako mniej „silną” (M = 4.46, SD = 1.08) i bardziej aktywną (M = 4.58, SD = 0.98). Ponieważ te same osoby oceniały oba pojęcia, porównano je testem t dla prób zależnych:
| Wymiar | Różnica (psychologia − statystyka) [95% CI] | t(119) | p | dz |
|---|---|---|---|---|
| Ocena | 1.55 [1.28, 1.83] | 11.23 | < .001 | 1.03 |
| Siła | −0.65 [−0.90, −0.40] | −5.13 | < .001 | −0.47 |
| Aktywność | 0.86 [0.60, 1.12] | 6.53 | < .001 | 0.60 |
Całościową różnicę między profilami można streścić odległością euklidesową między średnimi ocenami na wszystkich parach: D = √Σ(x1 − x2)². Tutaj D = 3.30; miara ta uwzględnia zarówno poziom, jak i kształt profilu, ale nie mówi, na którym wymiarze leży różnica.
Jak analizować dane z dyferencjału?
- Pojedyncza para ma charakter porządkowy – opisuj ją rozkładem i medianą (zob. skala porządkowa).
- Wynik wymiaru (średnia kilku par o dobrej spójności wewnętrznej) zwykle analizuje się jak zmienną ilościową.
- Strukturę wymiarów sprawdź analizą czynnikową, zwłaszcza gdy dobierasz własne pary (zob. analiza czynnikowa EFA i CFA).
- Porównania: dwa pojęcia oceniane przez te same osoby – test t dla prób zależnych; więcej pojęć – ANOVA z powtarzanymi pomiarami; różne grupy oceniające – test t dla prób niezależnych lub ANOVA.
- Prezentacja: wykres profilu, jak na rysunku 1, jest czytelniejszy niż tabela dziewięciu średnich.
Jak opisać wynik w pracy (APA)
Przykład w R
Kod tworzy dane z przykładu, przekodowuje pary z odwróconymi biegunami, liczy wyniki wymiarów i ich rzetelność, porównuje pojęcia testem t dla prób zależnych i oblicza odległość profili. Liczby w tekście i na rysunku 1 pochodzą z tego kodu (przedziały ufności różnic i odchylenia standardowe – w pełnym skrypcie strony).
Wyniki wymiarów, alfa, test t i odległość profili
R
# 9 par przymiotników: E = ocena, P = siła, A = aktywność; w arkuszu co druga para ma odwrócone bieguny
wymiar <- rep(c("E", "P", "A"), each = 3)
odwr <- c(FALSE, TRUE, FALSE, TRUE, FALSE, TRUE, FALSE, TRUE, FALSE)
set.seed(95)
n <- 120
arkusz <- function(mu) {                                   # mu: średnie pojęcia na wymiarach E, P, A (skala 1–7)
  F <- sapply(1:3, function(w) rnorm(n, mu[w] - 4, 0.95))
  x <- sapply(1:9, function(j) pmin(pmax(round(4 + F[, match(wymiar[j], c("E", "P", "A"))] + rnorm(n, 0, 0.8)), 1), 7))
  x[, odwr] <- 8 - x[, odwr]                               # odpowiedzi tak, jak zapisano je w arkuszu
  colnames(x) <- paste0(wymiar, rep(1:3, 3))
  as.data.frame(x)
}
stat <- arkusz(c(4.0, 5.3, 3.8))                           # pojęcie „statystyka”
psych <- arkusz(c(5.5, 4.4, 4.6))                          # pojęcie „psychologia”
# 1. Rekodowanie odwróconych par (8 − x), tak by 7 = dobry, silny, aktywny
rekoduj <- function(d) { d[, odwr] <- 8 - d[, odwr]; d }
stat <- rekoduj(stat); psych <- rekoduj(psych)
# 2. Wynik wymiaru = średnia trzech par; rzetelność (alfa) w każdym wymiarze
alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
wynik <- function(d) sapply(c("E", "P", "A"), function(w) rowMeans(d[, wymiar == w]))
round(rbind(M_stat = colMeans(wynik(stat)), M_psych = colMeans(wynik(psych)),
            alfa_stat = sapply(c("E", "P", "A"), function(w) alfa(stat[, wymiar == w])),
            alfa_psych = sapply(c("E", "P", "A"), function(w) alfa(psych[, wymiar == w]))), 2)
# 3. Porównanie pojęć na każdym wymiarze: test t dla prób zależnych i d_z
do.call(rbind, lapply(c("E", "P", "A"), function(w) {
  r <- wynik(psych)[, w] - wynik(stat)[, w]
  tt <- t.test(r)                                          # = t.test(psych, stat, paired = TRUE)
  data.frame(wymiar = w, roznica = round(mean(r), 2), t = round(unname(tt$statistic), 2), df = tt$parameter[[1]],
             p = signif(tt$p.value, 3), d_z = round(mean(r) / sd(r), 2))
}))
# 4. Odległość między średnimi profilami (9 par)
round(sqrt(sum((colMeans(psych) - colMeans(stat))^2)), 2)
Wynik w R
              E    P    A
M_stat     4.09 5.11 3.72
M_psych    5.64 4.46 4.58
alfa_stat  0.79 0.70 0.75
alfa_psych 0.75 0.81 0.73
  wymiar roznica     t  df        p   d_z
1      E    1.55 11.23 119 2.14e-20  1.03
2      P   -0.65 -5.13 119 1.13e-06 -0.47
3      A    0.86  6.53 119 1.68e-09  0.60
[1] 3.3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Pary, które nie są przeciwieństwami – „ciepły – nudny” mierzy dwie różne rzeczy naraz.
- Brak przekodowania par z odwróconymi biegunami – w przykładzie alfa wymiaru oceny statystyki spadłaby z .79 do −1.25.
- Jeden wynik ze wszystkich par – zsumowanie oceny, siły i aktywności miesza różne wymiary; licz wyniki osobno.
- Za mało par na wymiar – jedna lub dwie pary dają niską rzetelność i nie pozwalają sprawdzić struktury.
- Środek skali opisany jako „nie wiem” – środek oznacza położenie neutralne, a brak opinii to inna odpowiedź, którą lepiej zebrać osobno (zob. kafeteria odpowiedzi).
- Różne zestawy par dla porównywanych pojęć – profile przestają być porównywalne.
Najczęstsze pytania
Co to jest dyferencjał semantyczny?
To technika pomiaru znaczenia pojęć: osoba zaznacza, gdzie umieszcza pojęcie (np. „statystyka”) między dwoma przeciwstawnymi przymiotnikami, np. dobry–zły, silny–słaby, aktywny–bierny. Zwykle stosuje się siedmiopunktowe skale i kilka lub kilkanaście par przymiotników, które grupuje się w wymiary.
Czym różni się dyferencjał semantyczny od skali Likerta?
W skali Likerta osoba określa stopień zgody z twierdzeniem, a w dyferencjale – położenie pojęcia między dwoma biegunami opisanymi przymiotnikami. Etykiety odpowiedzi są więc dopasowane do treści, a nie takie same dla wszystkich pozycji.
Jakie są wymiary dyferencjału semantycznego?
Klasycznie trzy: ocena (np. dobry–zły), siła (silny–słaby, twardy–miękki, ciężki–lekki) i aktywność (aktywny–bierny, szybki–wolny). Ocena i siła okazują się najbardziej stabilne, aktywność – mniej. Strukturę wymiarów sprawdź analizą czynnikową we własnych danych.
Ile punktów powinna mieć skala dyferencjału semantycznego?
Klasycznie siedem, z neutralnym środkiem i opisanymi biegunami; spotyka się też skale pięciopunktowe. Ważniejsze od liczby punktów jest to, by pary były rzeczywistymi przeciwieństwami, pasowały do ocenianego pojęcia i by na każdy wymiar przypadały co najmniej trzy pary.
Jak analizować wyniki dyferencjału semantycznego?
Przekoduj pary z odwróconymi biegunami, policz wynik każdego wymiaru jako średnią jego par i sprawdź rzetelność. Profile pojęć pokaż na wykresie, a różnice między pojęciami ocenianymi przez te same osoby sprawdź testem t dla prób zależnych lub ANOVA z powtarzanymi pomiarami.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- DeCastellarnau, A. (2018). A classification of response scale characteristics that affect data quality: A literature review. Quality & Quantity, 52(4), 1523–1559. https://doi.org/10.1007/s11135-017-0533-4 ● Otwarty dostęp
- Kervyn, N., Fiske, S. T., & Yzerbyt, V. Y. (2013). Integrating the stereotype content model (warmth and competence) and the Osgood semantic differential (evaluation, potency, and activity). European Journal of Social Psychology, 43(7), 673–681. https://doi.org/10.1002/ejsp.1978 ● Otwarty dostęp: pełny tekst
- Menold, N., & Bogner, K. (2016). Design of rating scales in questionnaires. GESIS – Leibniz Institute for the Social Sciences. https://doi.org/10.15465/gesis-sg_en_015 ● Otwarty dostęp: pełny tekst
- Saris, W., Revilla, M., Krosnick, J. A., & Shaeffer, E. M. (2010). Comparing questions with agree/disagree response options to questions with item-specific response options. Survey Research Methods, 4(1), 61–79. https://doi.org/10.18148/srm/2010.v4i1.2682 ● Otwarty dostęp
Cytowania BibTeX
@article{decastellarnau2018classification, author={DeCastellarnau, Anna}, title={{A classification of response scale characteristics that affect data quality: A literature review}}, journal={Quality \& Quantity}, year={2018}, volume={52}, number={4}, pages={1523--1559}, doi={10.1007/s11135-017-0533-4}}@article{kervyn2013integrating, author={Kervyn, Nicolas and Fiske, Susan T. and Yzerbyt, Vincent Y.}, title={{Integrating the stereotype content model (warmth and competence) and the Osgood semantic differential (evaluation, potency, and activity)}}, journal={European Journal of Social Psychology}, year={2013}, volume={43}, number={7}, pages={673--681}, doi={10.1002/ejsp.1978}}@techreport{menold2016design, author={Menold, Natalja and Bogner, Kathrin}, title={{Design of rating scales in questionnaires}}, year={2016}, institution={GESIS – Leibniz Institute for the Social Sciences}, doi={10.15465/gesis-sg_en_015}}@article{saris2010comparing, author={Saris, Willem and Revilla, Melanie and Krosnick, Jon A. and Shaeffer, Eric M.}, title={{Comparing questions with agree/disagree response options to questions with item-specific response options}}, journal={Survey Research Methods}, year={2010}, volume={4}, number={1}, pages={61--79}, doi={10.18148/srm/2010.v4i1.2682}}