Co to jest skala ilościowa?
Skala ilościowa (ang. quantitative scale, w programach statystycznych także skala metryczna) to wspólna nazwa dwóch najwyższych poziomów pomiaru: skali interwałowej (przedziałowej) i skali ilorazowej (stosunkowej). Wyniki są tu liczbami w jednostkach: taka sama różnica na skali oznacza taką samą różnicę cechy, więc wyniki można odejmować, dodawać i uśredniać. W SPSS odpowiada jej poziom Scale w kolumnie Measure, a w jamovi i JASP – zmienna ciągła (continuous).
W klasyfikacji Stevensa (1946) skala interwałowa jest pierwszą skalą „ilościową” w potocznym sensie tego słowa, a skala ilorazowa dokłada do niej prawdziwe zero. Niższe poziomy to skala nominalna i skala porządkowa – kod województwa czy numer kategorii odpowiedzi to liczby, ale nie wartości ilościowe. Z drugiej strony „ilościowa” nie znaczy „ciągła”: liczba poprawnych odpowiedzi czy liczba sesji terapii przyjmuje tylko wartości całkowite, a mimo to jest mierzona na skali ilorazowej.
Skala interwałowa a ilorazowa
| Cecha | Skala interwałowa | Skala ilorazowa |
|---|---|---|
| Zero | Umowne – nie oznacza braku cechy | Prawdziwe – oznacza brak cechy |
| Dopuszczalna zmiana jednostki | x′ = ax + b (np. °C → °F) | x′ = ax (np. ms → s) |
| Sensowne porównania | Różnice: „o 10 punktów więcej” | Różnice i ilorazy: „1.5 raza dłużej”, „o 11% więcej” |
| Przykłady w psychologii | Wynik w skali IQ, wynik T, temperatura w °C, rok urodzenia | Czas reakcji, liczba poprawnych odpowiedzi, wiek, liczba sesji, tętno |
| Dodatkowe statystyki | – | Współczynnik zmienności, średnia geometryczna, logarytmowanie |
Wyniki testów i kwestionariuszy (np. suma wielu pozycji skali Likerta albo dyferencjału semantycznego) zwykle traktuje się jak interwałowe – Stevens pisał, że pomiar psychologiczny do tego aspiruje i czasem z powodzeniem. To założenie, do którego wracamy niżej.
Dlaczego „dwa razy więcej” wymaga prawdziwego zera?
Na skali interwałowej położenie zera jest umowne, więc iloraz dwóch wyników zależy od tego, gdzie je umieszczono. Stevens (1946) pokazywał to na skalach Celsjusza i Fahrenheita: nie ma sensu mówić, że jedna temperatura jest „dwa razy wyższa” od drugiej. 20 °C i 10 °C to w stopniach Fahrenheita 68 i 50 °F (iloraz 1.36 zamiast 2.00), a w kelwinach, czyli na skali z zerem bezwzględnym, 293.15 i 283.15 K (iloraz 1.04). Zachowuje się natomiast różnica: 10 °C to zawsze 18 °F i 10 K. Rysunek 1 zestawia ten przykład z wynikami testu i czasem reakcji.
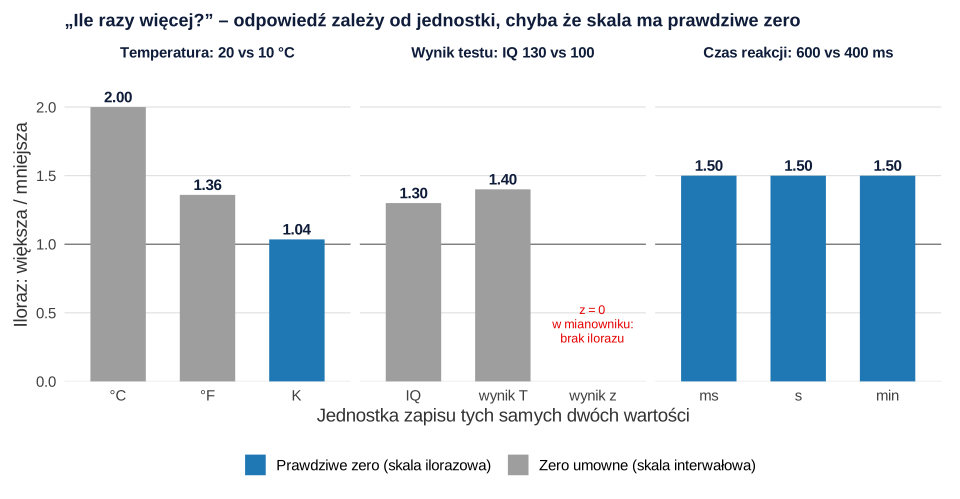
Tak samo jest z wynikami testów. IQ 130 to 1.30 raza więcej niż IQ 100, ale ci sami ludzie mają wyniki T równe 70 i 50 (iloraz 1.40), a wyniki z równe 2 i 0 – ilorazu nie da się wtedy policzyć. Od zapisu nie zależy natomiast stwierdzenie „o 2 odchylenia standardowe wyżej”. Czas reakcji ma prawdziwe zero, więc 600 ms to 1.5 raza dłużej niż 400 ms – w milisekundach, sekundach i minutach. Z tego samego powodu tylko na skali ilorazowej sens ma współczynnik zmienności (CV = SD / M): dla tych samych pięciu temperatur od 12 do 24 °C wynosi on .264 w °C, .133 w °F i .016 w kelwinach.
Jakie analizy są dozwolone?
Na skali ilościowej dostępne są wszystkie statystyki skal niższych i dodatkowo:
| Cel | Co policzyć |
|---|---|
| Opis | Średnia, odchylenie standardowe, wariancja; przy silnej skośności także mediana i rozstęp ćwiartkowy |
| Dwie grupy | Test t, domyślnie w wersji Welcha |
| Trzy grupy i więcej | ANOVA |
| Związek dwóch zmiennych | Korelacja Pearsona, regresja liniowa |
| Tylko skala ilorazowa | Iloraz średnich, procent zmiany, współczynnik zmienności, logarytmowanie |
Ilościowy poziom pomiaru to warunek konieczny testów parametrycznych, ale nie wystarczający. Liczą się też kształt rozkładu, wartości odstające i równość wariancji (zob. testy parametryczne i poradnik jak sprawdzić normalność rozkładu).
Przykład: czas reakcji z powiadomieniami na ekranie
Osiemdziesiąt osób (dane symulowane) wykonało proste zadanie na czas reakcji: 40 z wyskakującymi powiadomieniami na ekranie i 40 bez nich. Średni czas reakcji wyniósł 602.60 ms (SD = 94.96) z powiadomieniami i 543.88 ms (SD = 77.61) bez nich. Test t Welcha: t(75.03) = 3.03, p = .003, różnica 58.73 ms, 95% CI [20.10, 97.35], d = 0.68.
Ponieważ czas ma prawdziwe zero, wolno też powiedzieć, że średni czas reakcji był 1.108 raza dłuższy, czyli o 10.8% dłuższy. Względne rozproszenie wyników było podobne: CV = .158 z powiadomieniami i .143 bez nich. Po przeliczeniu na sekundy t, iloraz średnich i CV pozostają identyczne.
Typologia Stevensa i jej krytyka
Stevens (1946) zdefiniował pomiar jako przypisywanie liczb obiektom według reguł i uporządkował skale według przekształceń, które nie zmieniają ich sensu. Za dopuszczalne uznał statystyki odporne na te przekształcenia. Ten podział wszedł do podręczników i do wielu programów statystycznych, ale od początku był krytykowany z dwóch stron.
Velleman i Wilkinson (1993) dowodzą, że typ skali nie jest stałą cechą danych, lecz zależy od pytania, jakie im zadajemy, i od dodatkowej wiedzy. Numer losu na loterii jest nominalny, gdy sprawdzamy, kto wygrał, porządkowy, gdy pytamy, kto przyszedł wcześniej, a ilorazowy, gdy losy wydawano kolejno i chcemy oszacować liczbę gości. Część danych, np. odsetki ograniczone do przedziału 0–100, nie pasuje do żadnej kategorii, a sztywne stosowanie typologii prowadzi do zbędnego rangowania danych i sięgania po metody nieparametryczne. Autorzy przypominają też żartobliwą notkę Lorda o numerach na koszulkach piłkarzy, w której statystyk zauważa, że „liczby nie wiedzą, skąd pochodzą”.
Michell (1997) krytykuje Stevensa z przeciwnej strony: szeroka definicja pomiaru pozwoliła psychologom pominąć pytanie naukowe – czy mierzona cecha w ogóle ma strukturę ilościową. Wniosek praktyczny: traktuj skalę ilościową jako założenie, które uzasadniasz (wiele pozycji o dobrej rzetelności, sensowne rozkłady, liniowe związki), a gdy masz wątpliwości, porównaj wynik z analizą rangową lub porządkową.
Jak opisać wynik w pracy (APA)
Procentowe porównanie dodawaj tylko wtedy, gdy zmienna ma prawdziwe zero. Przy wynikach kwestionariuszy pozostań przy różnicy punktów i wielkości efektu.
Przykład w R
Kod tworzy dane z przykładu, porównuje czasy reakcji testem t Welcha, liczy iloraz średnich i współczynnik zmienności, a potem pokazuje, że na skali interwałowej iloraz i CV zależą od wyboru jednostki. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Czas reakcji: test t, iloraz średnich i CV
R
set.seed(93)
n <- 40
bez <- round(rlnorm(n, meanlog = log(520), sdlog = 0.15))     # czas reakcji (ms) bez powiadomień
z_pow <- round(rlnorm(n, meanlog = log(580), sdlog = 0.16))   # czas reakcji (ms) z powiadomieniami
# 1. Statystyki opisowe i współczynnik zmienności (CV ma sens tylko na skali ilorazowej)
opis <- function(x) c(M = mean(x), SD = sd(x), CV = sd(x) / mean(x))
round(rbind(bez = opis(bez), z_pow = opis(z_pow)), 3)
# 2. Test t Welcha, d Cohena i iloraz średnich („o ile procent dłużej”)
t.test(z_pow, bez)
sp <- sqrt((var(bez) + var(z_pow)) / 2)
round(c(d = (mean(z_pow) - mean(bez)) / sp, iloraz = mean(z_pow) / mean(bez)), 3)
# 3. Zmiana jednostki na sekundy niczego nie zmienia: ten sam t, iloraz i CV
round(c(t = unname(t.test(z_pow / 1000, bez / 1000)$statistic), iloraz = mean(z_pow) / mean(bez),
        CV_bez = sd(bez / 1000) / mean(bez / 1000)), 3)
# 4. Skala interwałowa: iloraz i CV zależą od położenia zera
C <- c(10, 20)
round(c(Celsjusz = C[2] / C[1], Fahrenheit = (C[2] * 1.8 + 32) / (C[1] * 1.8 + 32), Kelwin = (C[2] + 273.15) / (C[1] + 273.15)), 3)
temp <- c(12, 15, 18, 21, 24)
cv <- function(x) sd(x) / mean(x)
round(c(CV_C = cv(temp), CV_F = cv(temp * 1.8 + 32), CV_K = cv(temp + 273.15)), 3)
Wynik w R
            M     SD    CV
bez   543.875 77.613 0.143
z_pow 602.600 94.960 0.158

	Welch Two Sample t-test

data:  z_pow and bez
t = 3.0284, df = 75.028, p-value = 0.00337
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 20.09543 97.35457
sample estimates:
mean of x mean of y
  602.600   543.875

     d iloraz
 0.677  1.108
     t iloraz CV_bez
 3.028  1.108  0.143
  Celsjusz Fahrenheit     Kelwin
     2.000      1.360      1.035
 CV_C  CV_F  CV_K
0.264 0.133 0.016
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Procenty na skali z umownym zerem – „grupa A była o 20% bardziej zadowolona” (średnie 3.6 i 3.0 na skali 1–5) zależy od tego, czy skala zaczyna się od 1, czy od 0.
- „IQ 150 to półtora raza większa inteligencja niż IQ 100” – zero skali IQ jest umowne; poprawnie: wynik wyższy o 3.33 odchylenia standardowego.
- Współczynnik zmienności dla wyników T, IQ lub temperatury w °C – zmienia się razem z położeniem zera.
- Mylenie poziomu pomiaru z rozkładem – zmienna ilościowa nie musi mieć rozkładu normalnego, a skośność nie „obniża” poziomu pomiaru.
- Dzielenie zmiennej ilościowej na grupy – podział na „niskich” i „wysokich” traci informację i moc (zob. skala dychotomiczna).
Najczęstsze pytania
Co to jest skala ilościowa?
To wspólna nazwa dwóch najwyższych poziomów pomiaru: skali interwałowej i ilorazowej. Wyniki są liczbami w równych jednostkach, więc można je odejmować i uśredniać, np. czas reakcji w milisekundach albo wynik T w teście. Kody kategorii (np. numer kierunku studiów) nie są zmienną ilościową.
Czym różni się skala interwałowa od ilorazowej?
Na skali interwałowej zero jest umowne (0 °C, wynik T = 0), więc sens mają tylko różnice. Skala ilorazowa ma prawdziwe zero oznaczające brak cechy (0 ms, 0 poprawnych odpowiedzi), więc sens mają także ilorazy: 600 ms to 1.5 raza dłużej niż 400 ms, ale 20 °C nie jest „dwa razy cieplej” niż 10 °C.
Czy wynik kwestionariusza to skala ilościowa?
Wynik skali złożonej z wielu pozycji o dobrej rzetelności zwykle traktuje się jak zmienną interwałową i analizuje testem t, ANOVA czy korelacją Pearsona. To jednak założenie, które warto uzasadnić; pojedyncza pozycja skali Likerta jest porządkowa. Zero w wyniku kwestionariusza jest umowne, więc unikaj porównań procentowych.
Jakie testy stosować dla zmiennych ilościowych?
Dwie grupy porównasz testem t (domyślnie Welcha), trzy i więcej – ANOVA, a związek dwóch zmiennych opiszesz korelacją Pearsona lub regresją liniową. Sprawdź też kształt rozkładu i wartości odstające; przy silnej skośności rozważ metody odporne lub rangowe.
Czy wiek i czas reakcji są na skali ilorazowej?
Tak – mają prawdziwe zero, więc sens ma stwierdzenie, że ktoś jest dwa razy starszy albo reaguje o 10% wolniej. Na skali ilorazowej mierzy się też liczby zdarzeń, np. liczbę poprawnych odpowiedzi czy sesji terapii, choć przyjmują one tylko wartości całkowite.
Czy zmienna ilościowa musi mieć rozkład normalny?
Nie. Poziom pomiaru i rozkład to dwie różne sprawy: czas reakcji ma zwykle rozkład prawostronnie skośny, a mimo to jest mierzony na skali ilorazowej. Normalność (a ściślej – normalność reszt) jest założeniem niektórych testów, a nie warunkiem bycia zmienną ilościową.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikStatystyka do pracy licencjackiej: analiza krok po kroku
Jak zaplanować analizę statystyczną do pracy licencjackiej, przygotować ankietę i bazę danych oraz otrzymać wyniki, które da się obronić.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Michell, J. (1997). Quantitative science and the definition of measurement in psychology. British Journal of Psychology, 88(3), 355–383. https://doi.org/10.1111/j.2044-8295.1997.tb02641.x
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Velleman, P. F., & Wilkinson, L. (1993). Nominal, ordinal, interval, and ratio typologies are misleading. The American Statistician, 47(1), 65–72. https://doi.org/10.1080/00031305.1993.10475938
Cytowania BibTeX
@article{michell1997quantitative, author={Michell, Joel}, title={{Quantitative science and the definition of measurement in psychology}}, journal={British Journal of Psychology}, year={1997}, volume={88}, number={3}, pages={355--383}, doi={10.1111/j.2044-8295.1997.tb02641.x}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}@article{velleman1993nominal, author={Velleman, Paul F. and Wilkinson, Leland}, title={{Nominal, ordinal, interval, and ratio typologies are misleading}}, journal={The American Statistician}, year={1993}, volume={47}, number={1}, pages={65--72}, doi={10.1080/00031305.1993.10475938}}