Co to są testy parametryczne?
Testy parametryczne (ang. parametric tests) to testy statystyczne, które zakładają określony kształt rozkładu w populacji – najczęściej rozkład normalny – i sprawdzają hipotezy o jego parametrach: średnich, wariancjach, współczynnikach korelacji czy nachyleniach regresji. Nazwa pochodzi właśnie od parametrów: rozkład normalny jest w pełni opisany przez średnią μ i odchylenie standardowe σ, więc pytanie o różnicę grup można sprowadzić do pytania o różnicę μ1 − μ2.
Przykładem jest test t. Kim (2015) wyjaśnia, że gdy wariancja populacji jest nieznana, statystyka testowa ma rozkład t, a wnioskowanie opiera się na trzech założeniach: normalności, równości wariancji (w klasycznej wersji dla prób niezależnych) i niezależności obserwacji. Przeciwieństwem są testy nieparametryczne, które zamieniają wyniki na rangi i nie wymagają założenia o kształcie rozkładu – ale też odpowiadają na nieco inne pytania.
W praktyce psychologicznej do rodziny parametrycznej należy większość analiz z rozdziału wyników: testy t, ANOVA, korelacja Pearsona i regresja liniowa. Wszystkie są szczególnymi przypadkami ogólnego modelu liniowego i mają podobne założenia.
Najważniejsze testy parametryczne i ich założenia
| Test | Pytanie badawcze | Założenia (oprócz niezależności) | Gdy założenia zawodzą |
|---|---|---|---|
| Test t dla jednej próby | czy średnia różni się od wartości odniesienia | rozkład zbliżony do normalnego (ważny w małych próbach) | bootstrap, test znakowanych rang |
| Test t dla prób niezależnych | czy dwie grupy mają różne średnie | normalność w grupach; równe wariancje (tylko test Studenta) | test Welcha, test Manna-Whitneya |
| Test t dla prób zależnych | czy wynik zmienił się między dwoma pomiarami | normalność różnic między pomiarami | test Wilcoxona |
| Jednoczynnikowa ANOVA | czy średnie trzech i więcej grup się różnią | normalność reszt; homogeniczność wariancji | ANOVA Welcha, test Kruskala-Wallisa |
| ANOVA z powtarzanymi pomiarami | czy średnie zmieniają się w trzech i więcej pomiarach | normalność reszt; sferyczność | poprawka Greenhouse’a–Geissera, test Friedmana |
| Korelacja Pearsona | czy dwie zmienne są liniowo powiązane | liniowość związku; brak obserwacji wpływowych; normalność ważna dla testu w małych próbach | korelacja Spearmana |
| Regresja liniowa | jak predyktory wiążą się z wynikiem | liniowość; stała wariancja reszt; normalność reszt | odporne błędy standardowe (zob. heterogeniczność wariancji), transformacja, inny model |
Zmienna zależna powinna być ilościowa. W psychologii za taką uznaje się zwykle sumy lub średnie z wielopozycyjnych skal, ale już nie odpowiedź na jedno pytanie w skali Likerta – przy kilku kategoriach odpowiedzi lepiej sprawdzają się metody dla danych porządkowych.
Co naprawdę znaczą założenia testów parametrycznych?
- Niezależność obserwacji. Wynik jednej osoby nie mówi nic o wyniku innej. Wynika z planu badania, a nie z danych – żaden test tego nie „sprawdzi”. Łamią ją m.in. pomiary tych samych osób, rodzeństwa, uczniowie z tej samej klasy czy pary partnerów.
- Normalność – reszt, nie surowych danych. Założenie dotyczy rozkładu wyników wokół średnich grup albo wokół linii regresji. Williams i in. (2013) przypominają, że regresja wymaga – zwłaszcza w małych próbach – normalności błędów, a nie normalności zmiennej zależnej czy predyktorów. Idealnie normalnych danych i tak prawie nie ma: Micceri (1989) przeanalizował 440 dużych rozkładów wyników testów i miar psychometrycznych i wszystkie istotnie odbiegały od normalności. Jak to sprawdzić w praktyce, opisujemy w poradniku jak sprawdzić normalność rozkładu.
- Równość wariancji – w grupach (homogeniczność wariancji) albo wzdłuż linii regresji (homoskedastyczność). Wymaga jej klasyczny test Studenta i ANOVA, ale nie ich wersje Welcha.
- Poprawny model – w korelacji i regresji związek ma być liniowy, a w modelach z kowariantami trzeba uwzględnić ważne zmienne i interakcje.
Dlaczego normalność danych nie jest warunkiem koniecznym? Testy parametryczne wnioskują o średnich, a rozkład średnich z prób zbliża się do normalnego wraz ze wzrostem liczebności, nawet gdy same wyniki są skośne (zob. centralne twierdzenie graniczne). Lumley i in. (2002) pokazują, że w dużych próbach test t i regresja liniowa są trafne przy dowolnym rozkładzie zmiennej wynikowej.
Które założenia są naprawdę ważne? Symulacja
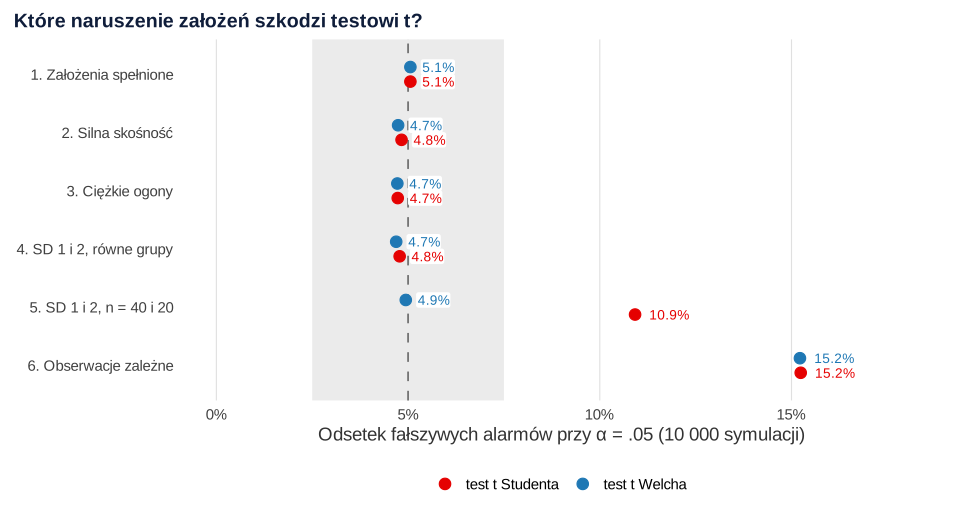
Odporność (ang. robustness) to zdolność testu do zachowania obiecanego poziomu błędu I rodzaju mimo naruszenia założeń. Sprawdziliśmy ją dla testu t w sześciu scenariuszach: dwie grupy o równych średnich w populacji, po 10 000 symulacji. Każdy istotny wynik jest więc fałszywym alarmem, a przy α = .05 powinno ich być około 5%.
Wnioski z symulacji:
- Nienormalność przy równych grupach prawie nie szkodzi – przy silnej skośności i przy ciężkich ogonach fałszywych alarmów było 4.7–4.8%. Podobne wyniki dla ANOVA uzyskali Blanca i in. (2017): w symulacji z trzema grupami i rozkładami typowymi dla nauk o zdrowiu i nauk społecznych test F zachował poprawny poziom błędu I rodzaju we wszystkich badanych warunkach.
- Różne wariancje szkodzą przy nierównych grupach – gdy większe SD miała mniejsza grupa, test Studenta dawał 10.9% fałszywych alarmów, a test Welcha 4.9%. Dlatego Delacre i in. (2017) zalecają domyślnie test Welcha: przy nierównych wariancjach lepiej kontroluje błąd I rodzaju, a przy równych niewiele traci.
- Zależność obserwacji szkodzi najbardziej – 15.2% fałszywych alarmów, trzy razy więcej niż powinno. Tego nie naprawi ani test Welcha, ani test nieparametryczny – potrzebny jest model uwzględniający strukturę danych, np. model wielopoziomowy.
Odporność na nienormalność nie oznacza jednak, że kształt rozkładu nie ma znaczenia. Przy ciężkich ogonach test t traci moc w porównaniu z testami rangowymi, a w bardzo małych próbach i przy silnej skośności przedziały ufności średniej bywają zbyt wąskie. Porównanie mocy pokazujemy w haśle o testach nieparametrycznych.
Dlaczego warto korzystać z testów parametrycznych?
- Odpowiadają na pytanie o średnie – a to zwykle o średnie pytają hipotezy, np. „o ile punktów spadł lęk po terapii?”.
- Dają oszacowanie efektu z przedziałem ufności w jednostkach skali: różnicę średnich, nachylenie, korelację – a nie tylko wartość p.
- Łatwo je rozbudować o kolejne czynniki, interakcje, kowarianty i pomiary powtarzane w ramach jednego modelu liniowego.
- Mają dużą moc, gdy założenia są w przybliżeniu spełnione.
Kiedy wybrać inną metodę?
| Sytuacja | Co zrobić |
|---|---|
| Nierówne wariancje lub nierówne grupy | test t lub ANOVA Welcha (najlepiej domyślnie); w regresji – błędy standardowe HC3 |
| Duża próba, umiarkowana skośność | zostań przy teście parametrycznym; normalność reszt oceń na wykresie |
| Mała próba i silna skośność albo obserwacje odstające | metody odporne (średnie przycięte, bootstrap) lub test nieparametryczny; najpierw sprawdź, czy skrajne wyniki nie są błędami – zob. wartości odstające |
| Zmienna porządkowa (jedno pytanie w skali Likerta, ranking) | test rangowy albo regresja porządkowa |
| Liczby zdarzeń, wynik zero-jedynkowy | regresja Poissona, regresja logistyczna |
| Obserwacje zagnieżdżone lub powtarzane | model wielopoziomowy, ANOVA z powtarzanymi pomiarami |
Wybór zaplanuj przed analizą, na podstawie pytania badawczego i charakteru danych, a nie po obejrzeniu wartości p kilku testów. Pomocną tabelę doboru testów znajdziesz w poradniku jak dobrać test statystyczny do hipotezy.
Jak opisać wybór testu parametrycznego w pracy (APA)
W części o analizie danych napisz, jak oceniono założenia i dlaczego wybrano daną wersję testu. Wzór do uzupełnienia:
Symulacja w R
Kod odtwarza liczby z rysunku 1. Możesz zmienić liczebności, rozkłady albo ICC i sprawdzić, jak zachowa się test w warunkach podobnych do Twojego badania. Obliczenia trwają kilka sekund.
Odporność testu t na naruszenia założeń
R
# Które założenie testu t naprawdę ma znaczenie? Symulacja błędu I rodzaju (średnie w populacjach równe)
set.seed(53)
R <- 10000                                       # liczba symulacji w każdym scenariuszu
p_dwa <- function(x, y) c(student = t.test(x, y, var.equal = TRUE)$p.value,
                          welch   = t.test(x, y)$p.value)
klasy <- function(n_klas, w_klasie, icc) {       # osoby w klasach: wyniki z tej samej klasy są podobne
  rep(rnorm(n_klas, 0, sqrt(icc)), each = w_klasie) + rnorm(n_klas * w_klasie, 0, sqrt(1 - icc))
}
scenariusze <- list(                             # po 30 osób w grupie, chyba że zaznaczono inaczej
  "1. Założenia spełnione"   = function() p_dwa(rnorm(30), rnorm(30)),
  "2. Silna skośność"        = function() p_dwa(rexp(30), rexp(30)),         # rozkład wykładniczy
  "3. Ciężkie ogony"         = function() p_dwa(rt(30, 3), rt(30, 3)),       # rozkład t z 3 df
  "4. SD 1 i 2, równe grupy" = function() p_dwa(rnorm(30, 0, 1), rnorm(30, 0, 2)),
  "5. SD 1 i 2, n = 40 i 20" = function() p_dwa(rnorm(40, 0, 1), rnorm(20, 0, 2)),  # większe SD w mniejszej grupie
  "6. Obserwacje zależne"    = function() p_dwa(klasy(6, 5, .2), klasy(6, 5, .2)))   # 6 klas po 5 osób, ICC = .20
wyniki <- t(sapply(scenariusze, function(f) rowMeans(replicate(R, f()) < .05)))
round(100 * wyniki, 1)                           # % fałszywych alarmów (powinno być około 5%)
Wynik w R
                         student welch
1. Założenia spełnione       5.1   5.1
2. Silna skośność            4.8   4.7
3. Ciężkie ogony             4.7   4.7
4. SD 1 i 2, równe grupy     4.8   4.7
5. SD 1 i 2, n = 40 i 20    10.9   4.9
6. Obserwacje zależne       15.2  15.2
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Sprawdzanie normalności surowej zmiennej zamiast reszt – w ANOVA różnice między grupami same „psują” rozkład całej próby (Williams i in., 2013).
- Odruchowa zamiana na test nieparametryczny po istotnym teście Shapiro-Wilka w dużej próbie – test parametryczny jest wtedy zwykle odporny, a test rangowy odpowiada na inne pytanie.
- Klasyczny test Studenta przy nierównych grupach – zamiast tego używaj domyślnie testu Welcha.
- Pomijanie niezależności obserwacji – to najpoważniejsze naruszenie (15.2% fałszywych alarmów w symulacji), a nie poprawi go zmiana testu na nieparametryczny.
- Przekonanie, że testy parametryczne „wymagają” dużej próby, a nieparametryczne nie – oba rodzaje testów mają w małych próbach małą moc; liczebność zaplanuj analizą mocy a priori.
Najczęstsze pytania
Co to są testy parametryczne?
To testy, które zakładają, że dane pochodzą z populacji o określonym rozkładzie – najczęściej normalnym – i wnioskują o jego parametrach, np. średnich. Należą do nich m.in. testy t, ANOVA, korelacja Pearsona i regresja liniowa. Ich przeciwieństwem są testy nieparametryczne, oparte zwykle na rangach.
Jakie są założenia testów parametrycznych?
Niezależność obserwacji, rozkład reszt zbliżony do normalnego (w teście dla prób zależnych – rozkład różnic) i – w klasycznym teście Studenta oraz ANOVA – równość wariancji w grupach. Zmienna zależna powinna być ilościowa, a w korelacji i regresji związek powinien być liniowy.
Kiedy można użyć testu parametrycznego mimo braku normalności?
Zwykle wtedy, gdy grupy liczą kilkadziesiąt osób, a odstępstwo od normalności jest umiarkowane – rozkład średnich zbliża się wtedy do normalnego. W symulacji na tej stronie test t przy silnej skośności i 30 osobach w grupie dawał 4.8% fałszywych alarmów, czyli tyle, ile powinien. Ostrożność potrzebna jest przy małych grupach, silnej skośności i obserwacjach odstających.
Czym różnią się testy parametryczne od nieparametrycznych?
Testy parametryczne zakładają kształt rozkładu i porównują parametry, np. średnie, a ich wynik daje się wyrazić w jednostkach skali z przedziałem ufności. Testy nieparametryczne pracują na rangach i mają mniej założeń o rozkładzie, ale odpowiadają na nieco inne pytanie – np. czy wyniki jednej grupy są zwykle wyższe niż drugiej.
Które założenie testu parametrycznego jest najważniejsze?
Niezależność obserwacji. W symulacji na tej stronie zależność wyników uczniów z tych samych klas dała 15.2% fałszywych alarmów zamiast 5%, a nie naprawia tego ani test Welcha, ani test nieparametryczny. Drugim groźnym problemem są nierówne wariancje przy nierównych grupach – rozwiązuje go test Welcha.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikCentralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2017). Non-normal data: Is ANOVA still a valid option? Psicothema, 29(4), 552–557. https://doi.org/10.7334/psicothema2016.383 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Kim, T. K. (2015). T test as a parametric statistic. Korean Journal of Anesthesiology, 68(6), 540–546. https://doi.org/10.4097/kjae.2015.68.6.540 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{blanca2017nonnormal, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Non-normal data: Is ANOVA still a valid option?}}, journal={Psicothema}, year={2017}, volume={29}, number={4}, pages={552--557}, doi={10.7334/psicothema2016.383}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{kim2015ttest, author={Kim, Tae Kyun}, title={{T test as a parametric statistic}}, journal={Korean Journal of Anesthesiology}, year={2015}, volume={68}, number={6}, pages={540--546}, doi={10.4097/kjae.2015.68.6.540}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{micceri1989unicorn, author={Micceri, Theodore}, title={{The unicorn, the normal curve, and other improbable creatures}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={156--166}, doi={10.1037/0033-2909.105.1.156}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}