Co to są testy nieparametryczne?
Testy nieparametryczne (ang. nonparametric tests, także testy wolne od rozkładu) to testy, które nie zakładają określonego kształtu rozkładu w populacji, np. rozkładu normalnego. Najpopularniejsze z nich zamieniają wyniki na rangi, czyli kolejne miejsca w uporządkowanym zbiorze (zob. rangowanie), i porównują rangi zamiast surowych wartości. Dzięki temu skrajny wynik waży tyle samo co każdy inny wysoki wynik – staje się po prostu najwyższą rangą.
Conover i Iman (1981) pokazali, że wiele testów nieparametrycznych można przedstawić jako zwykłe procedury parametryczne zastosowane do rang zamiast do danych. To dobry klucz do zrozumienia, co te testy porównują: rozkłady rang, a nie średnie ani – wbrew obiegowej opinii – mediany.
„Nieparametryczny” nie znaczy „bez założeń”. Testy rangowe zakładają niezależność obserwacji (albo par), a ich wynik da się prosto zinterpretować tylko w określonych warunkach, o których piszemy niżej. Do tej rodziny zalicza się też testy dla danych nominalnych, np. test chi-kwadrat niezależności. Ich parametryczne odpowiedniki omawiamy w haśle testy parametryczne.
Zamiast którego testu? Tabela odpowiedników
| Pytanie | Test parametryczny | Odpowiednik nieparametryczny | Co porównuje | Wielkość efektu |
|---|---|---|---|---|
| Dwie niezależne grupy | test t Studenta lub Welcha | test U Manna-Whitneya | czy wynik losowej osoby z jednej grupy jest zwykle wyższy niż z drugiej | korelacja rangowa dwuseryjna, prawdopodobieństwo przewagi |
| Dwa pomiary tych samych osób | test t dla prób zależnych | test Wilcoxona dla par | czy dodatnie różnice przeważają nad ujemnymi (z uwzględnieniem ich wielkości) | korelacja rangowa dla par |
| Trzy i więcej niezależnych grup | jednoczynnikowa ANOVA | test Kruskala-Wallisa i test Dunna | czy średnie rangi grup są równe | ε², η²H |
| Trzy i więcej pomiarów tych samych osób | ANOVA z powtarzanymi pomiarami | test Friedmana | czy rangi wyników wewnątrz osób układają się systematycznie | W Kendalla |
| Związek dwóch zmiennych | korelacja Pearsona | korelacja Spearmana, tau Kendalla | związek monotoniczny (niekoniecznie liniowy) | ρ, τ |
| Dwie zmienne nominalne | – | test chi-kwadrat niezależności | niezależność kategorii | V Craméra |
| Dwa pomiary zero-jedynkowe | – | test McNemara | zmianę odsetka odpowiedzi | iloraz szans dla par |
| Całe rozkłady dwóch grup | – | test Kołmogorowa-Smirnowa | dowolną różnicę rozkładów | statystyka D |
Nie myl dwóch testów Wilcoxona: test sumy rang Wilcoxona to inna nazwa testu Manna-Whitneya (grupy niezależne), a test znakowanych rang Wilcoxona służy do par pomiarów.
Co naprawdę testują testy rangowe? Trzy mity
Mit 1: „Test Manna-Whitneya porównuje mediany”
Hart (2001) pokazuje, że test Manna-Whitneya nie jest testem median: wykrywa także różnice kształtu i rozproszenia rozkładów, dlatego trzeba opisywać istotne cechy danych, a nie tylko podawać p. Divine i in. (2018) wykazują na kontrprzykładach, że procedura Wilcoxona–Manna–Whitneya testuje wielkość P(X1 < X2) + ½P(X1 = X2) – prawdopodobieństwo, że losowa osoba z jednej grupy ma wyższy wynik niż losowa osoba z drugiej, z remisami liczonymi po połowie – i zalecają podawanie tej wielkości jako miary efektu. O medianach test mówi tylko wtedy, gdy rozkłady w grupach mają ten sam kształt i różnią się wyłącznie położeniem. Przykład niżej pokazuje grupy o równych medianach i istotnym wyniku testu.
Mit 2: „Testy nieparametryczne nie mają założeń”
Zakładają niezależność obserwacji, a interpretacja wyniku jako przesunięcia jednej grupy względem drugiej wymaga podobnego kształtu i rozproszenia rozkładów. Zimmerman i Zumbo (1993) pokazali w symulacji, że test t na rangach – równoważny testowi Manna–Whitneya–Wilcoxona – miał przy kilku rozkładach nienormalnych większą moc niż test Studenta, ale wyraźnie tracił moc przy nierównych wariancjach. Testy rangowe nie są więc lekarstwem na nierówne wariancje.
Mit 3: „Testy nieparametryczne zawsze mają mniejszą moc”
To zależy od rozkładu. Blair i Higgins (1980) porównali moc testu sumy rang Wilcoxona i testu t przy sześciu rozkładach nienormalnych, m.in. wykładniczym, Laplace’a i mieszanych, i stwierdzili, że test rangowy miał na ogół bardzo dużą przewagę mocy. Ile kosztuje i ile daje test rangowy, pokazuje symulacja poniżej.
Moc: test t czy test Manna-Whitneya?
Porównaliśmy moc testu t Welcha i testu Manna-Whitneya dla dwóch grup po 30 osób, w których druga grupa była przesunięta o δ odchyleń standardowych typowych wyników (5000 symulacji w każdym punkcie). W panelu A dane pochodzą z rozkładu normalnego. W panelu B – z rozkładu o ciężkich ogonach: 90% osób ma wyniki z rozkładu normalnego, a 10% z rozkładu czterokrotnie szerszego, jak przy nietypowych lub nieuważnych odpowiedziach.
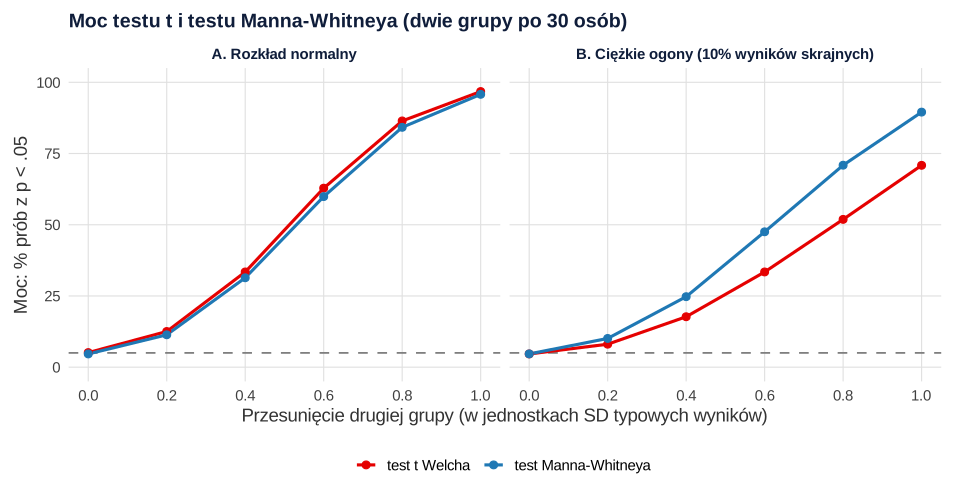
- Rozkład normalny: test t ma nieco większą moc, ale strata przy teście rangowym jest niewielka – przy przesunięciu o 0.6 SD 62.8% wobec 59.9%.
- Ciężkie ogony: przewaga się odwraca – przy przesunięciu o 0.6 SD test Manna-Whitneya wykrył różnicę w 47.5% prób, a test t w 33.4%; przy przesunięciu o 1 SD odpowiednio w 89.5% i 70.9%.
- Gdy różnicy nie było (δ = 0), oba testy dawały od 4.6% do 5.1% fałszywych alarmów.
Wniosek praktyczny: przy rozkładzie zbliżonym do normalnego test rangowy niewiele traci, a przy ciężkich ogonach może sporo zyskać. Wybór powinien jednak wynikać przede wszystkim z pytania badawczego: czy interesuje Cię różnica średnich w jednostkach skali, czy to, która grupa ma zwykle wyższe wyniki. Szerzej o decyzji „parametryczny czy nie” piszemy w poradniku jak sprawdzić normalność rozkładu i co zrobić, gdy jej nie ma.
Przykład: ocena zajęć na skali 1–7
Studenci ocenili przydatność zajęć na jednym pytaniu (1 = zdecydowanie nieprzydatne, 7 = zdecydowanie przydatne): 28 osób z grupy stacjonarnej i 26 z grupy online (dane symulowane). Pojedyncze pytanie w skali Likerta to zmienna porządkowa z wieloma powtarzającymi się wynikami – typowa sytuacja dla testu rangowego.
| Grupa | 1 | 2 | 3 | 4 | 5 | 6 | 7 | Mediana (Q1–Q3) |
|---|---|---|---|---|---|---|---|---|
| Stacjonarna (n = 28) | 0 | 1 | 0 | 4 | 14 | 5 | 4 | 5 (5–6) |
| Online (n = 26) | 2 | 4 | 2 | 4 | 9 | 3 | 2 | 5 (3–5) |
Mediany są równe (5), a mimo to test Manna-Whitneya jest istotny: U = 487.5, p = .026. To nie sprzeczność – test porównuje całe rozkłady rang. W grupie online częściej pojawiały się niskie oceny: poniżej 5 oceniło zajęcia 46.2% osób online i 17.9% osób z grupy stacjonarnej. Na 728 możliwych par (osoba stacjonarna, osoba online) w 55.4% wyżej oceniała osoba stacjonarna, a w 21.4% – osoba online. Prawdopodobieństwo przewagi z remisami liczonymi po połowie wynosi .67. Kerby (2014) proponuje prostszą miarę: różnicę odsetków par „zgodnych” i „niezgodnych” z kierunkiem efektu, czyli korelację rangową dwuseryjną: r = .554 − .214 = .34, 95% CI [.04, .58].
Jak opisać wynik testu nieparametrycznego (APA)
Podaj mediany z kwartylami (albo rozkład odpowiedzi), statystykę testu, p i wielkość efektu. Nie pisz, że „mediany różniły się istotnie”, jeśli test tego nie sprawdzał – w przykładzie mediany są wręcz równe.
Przykład w R
Kod odtwarza przykład: rozkład odpowiedzi, kwartyle, test Manna-Whitneya, korelację rangową dwuseryjną i prawdopodobieństwo przewagi. Symulację mocy z rysunku 1 przygotowano w osobnym skrypcie. W SPSS test znajdziesz w menu Analiza → Testy nieparametryczne → Próby niezależne (tam jest też test Kruskala-Wallisa), a testy Wilcoxona dla par i Friedmana – w oknie Próby zależne.
Test Manna-Whitneya z wielkością efektu
R
# Dane symulowane: ocena przydatności zajęć (1 = zdecydowanie nieprzydatne … 7 = zdecydowanie przydatne)
set.seed(12)
stacjonarne <- sample(1:7, 28, replace = TRUE, prob = c(.02, .05, .10, .20, .28, .22, .13))
online      <- sample(1:7, 26, replace = TRUE, prob = c(.06, .12, .18, .24, .20, .13, .07))
rbind(stacjonarne = table(factor(stacjonarne, 1:7)), online = table(factor(online, 1:7)))
sapply(list(stacjonarne = stacjonarne, online = online), quantile, probs = c(.25, .5, .75))

wilcox.test(stacjonarne, online, exact = FALSE)   # test Manna-Whitneya (wiązania: p asymptotyczne)
effectsize::rank_biserial(stacjonarne, online)    # wielkość efektu: korelacja rangowa dwuseryjna
# prawdopodobieństwo przewagi: P(X > Y) + 0.5 × P(X = Y)
mean(outer(stacjonarne, online, ">")) + 0.5 * mean(outer(stacjonarne, online, "=="))
Wynik w R
            1 2 3 4  5 6 7
stacjonarne 0 1 0 4 14 5 4
online      2 4 2 4  9 3 2
    stacjonarne online
25%           5      3
50%           5      5
75%           6      5

	Wilcoxon rank sum test with continuity correction

data:  stacjonarne and online
W = 487.5, p-value = 0.02595
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.34              | [0.04, 0.58]
[1] 0.6696429
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje wilcox.test() i t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Mediany różniły się istotnie” po teście Manna-Whitneya – test porównuje rozkłady rang, a nie mediany (Hart, 2001); w przykładzie mediany są równe, a wynik istotny.
- Test nieparametryczny jako odruch po istotnym teście normalności w dużej próbie – test parametryczny jest wtedy zwykle odporny, a zmiana testu zmienia pytanie badawcze.
- Brak wielkości efektu – podawaj korelację rangową dwuseryjną (Kerby, 2014) albo prawdopodobieństwo przewagi (Divine i in., 2018).
- Traktowanie testu rangowego jako ochrony przed nierównymi wariancjami – przy różnych rozproszeniach traci moc i zmienia sens wyniku (Zimmerman i Zumbo, 1993).
- Mylenie testów Wilcoxona – test sumy rang (grupy niezależne) to nie test znakowanych rang (pary pomiarów).
- Test dla grup niezależnych przy pomiarach powtarzanych – dla tych samych osób wybierz test Wilcoxona dla par albo test Friedmana.
Najczęstsze pytania
Co to są testy nieparametryczne?
To testy, które nie zakładają, że dane pochodzą z określonego rozkładu, np. normalnego. Większość z nich zamienia wyniki na rangi i porównuje rangi między grupami lub pomiarami. Do najpopularniejszych należą testy Manna-Whitneya, Wilcoxona, Kruskala-Wallisa i Friedmana oraz korelacja Spearmana.
Kiedy stosować testy nieparametryczne?
Gdy zmienna jest porządkowa (np. jedno pytanie w skali Likerta), gdy próba jest mała, a rozkład silnie skośny albo z obserwacjami odstającymi, oraz gdy pytanie dotyczy tego, która grupa ma zwykle wyższe wyniki, a nie różnicy średnich. W dużych próbach przy umiarkowanej nienormalności test parametryczny (najlepiej Welcha) jest zwykle odporny.
Czy test Manna-Whitneya i inne testy rangowe porównują mediany?
Nie. Test porównuje rozkłady rang, czyli sprawdza, czy losowa osoba z jednej grupy ma zwykle wyższy wynik niż losowa osoba z drugiej. O medianach mówi tylko wtedy, gdy rozkłady w grupach mają ten sam kształt. W przykładzie na tej stronie mediany obu grup wynoszą 5, a test jest istotny (p = .026).
Jaki test nieparametryczny zamiast ANOVA?
Dla trzech i więcej niezależnych grup – test Kruskala-Wallisa z porównaniami parami testem Dunna. Dla trzech i więcej pomiarów tych samych osób – test Friedmana. Pamiętaj, że oba porównują rangi, a nie średnie, więc wynik opisuj jako „wyższe” lub „niższe” wyniki w grupach.
Czy testy nieparametryczne mają mniejszą moc?
Nie zawsze. Przy rozkładzie normalnym tracą niewiele – w symulacji na tej stronie 59.9% wobec 62.8% dla testu t. Przy ciężkich ogonach bywają wyraźnie mocniejsze: przy tym samym przesunięciu grup test Manna-Whitneya wykrył różnicę w 47.5% prób, a test t w 33.4%.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blair, R. C., & Higgins, J. J. (1980). A comparison of the power of Wilcoxon’s rank-sum statistic to that of Student’s t statistic under various nonnormal distributions. Journal of Educational Statistics, 5(4), 309–335. https://doi.org/10.3102/10769986005004309
- Conover, W. J., & Iman, R. L. (1981). Rank transformations as a bridge between parametric and nonparametric statistics. The American Statistician, 35(3), 124–129. https://doi.org/10.1080/00031305.1981.10479327
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Zimmerman, D. W., & Zumbo, B. D. (1993). Rank transformations and the power of the Student t test and Welch t' test for non-normal populations with unequal variances. Canadian Journal of Experimental Psychology / Revue canadienne de psychologie expérimentale, 47(3), 523–539. https://doi.org/10.1037/h0078850
Cytowania BibTeX
@article{blair1980comparison, author={Blair, R. Clifford and Higgins, James J.}, title={{A comparison of the power of Wilcoxon’s rank-sum statistic to that of Student’s t statistic under various nonnormal distributions}}, journal={Journal of Educational Statistics}, year={1980}, volume={5}, number={4}, pages={309--335}, doi={10.3102/10769986005004309}}@article{conover1981rank, author={Conover, W. J. and Iman, Ronald L.}, title={{Rank transformations as a bridge between parametric and nonparametric statistics}}, journal={The American Statistician}, year={1981}, volume={35}, number={3}, pages={124--129}, doi={10.1080/00031305.1981.10479327}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{zimmerman1993rank, author={Zimmerman, Donald W. and Zumbo, Bruno D.}, title={{Rank transformations and the power of the Student t test and Welch t' test for non-normal populations with unequal variances}}, journal={Canadian Journal of Experimental Psychology / Revue canadienne de psychologie expérimentale}, year={1993}, volume={47}, number={3}, pages={523--539}, doi={10.1037/h0078850}}