Co to jest test chi-kwadrat niezależności?
Test chi-kwadrat niezależności (ang. Pearson's chi-squared test of independence) sprawdza, czy dwie zmienne jakościowe – mierzone na skali nominalnej lub porządkowej – są ze sobą powiązane. Porównuje liczebności obserwowane w tabeli krzyżowej z liczebnościami oczekiwanymi, czyli takimi, jakie pojawiłyby się, gdyby zmienne były niezależne. Typowe pytania z badań ankietowych: czy preferowana strategia radzenia sobie ze stresem zależy od roku studiów? Czy wybór formy pomocy psychologicznej różni się między mieszkańcami wsi i miast?
Test należy do rodziny testów χ² Pearsona, która obejmuje testy niezależności, jednorodności i zgodności. Franke, Ho i Christie (2012) podkreślają, że mimo niemal identycznego wzoru odpowiadają one na różne pytania, a ich wyniki często bywają nadinterpretowane. Test niezależności dotyczy jednej próby, w której mierzymy obie zmienne. Test jednorodności porównuje rozkład jednej zmiennej w kilku próbach o z góry ustalonych liczebnościach – liczy się go tak samo. Gdy porównujesz rozkład jednej zmiennej z rozkładem teoretycznym, potrzebujesz testu chi-kwadrat zgodności.
To hasło dotyczy tabel większych niż 2 × 2, oznaczanych r × c (wiersze × kolumny): liczebności oczekiwanych, reszt i wielkości efektu. Tabelę 2 × 2 z poprawką Yatesa, testem Fishera, współczynnikiem φ i ilorazem szans omawiamy w haśle tabela krzyżowa.
Wzór: liczebności oczekiwane i statystyka χ²
Hipoteza zerowa mówi, że zmienne są niezależne – np. że rozkład strategii jest taki sam na każdym roku studiów. Hipoteza alternatywna – że zmienne są powiązane (zob. hipoteza zerowa i alternatywna). Najpierw dla każdej komórki liczy się liczebność oczekiwaną przy niezależności:
Wynika to z reguły mnożenia prawdopodobieństw zdarzeń niezależnych: odsetek osób w komórce powinien być iloczynem odsetka w wierszu i odsetka w kolumnie. Następnie sumuje się znormalizowane odchylenia liczebności obserwowanych od oczekiwanych:
- Oij – liczebność obserwowana w komórce (wiersz i, kolumna j),
- Eij – liczebność oczekiwana przy niezależności,
- r, c – liczba wierszy i kolumn, N – liczebność próby.
Każda komórka wnosi do sumy tym więcej, im bardziej liczebność obserwowana odbiega od oczekiwanej – w relacji do wielkości tej oczekiwanej. Wynik porównuje się z rozkładem χ² o (r − 1)(c − 1) stopniach swobody i odczytuje wartość p.
Założenia i reguła liczebności oczekiwanych
- Liczebności, nie procenty. Test liczy się na surowych liczbach osób w komórkach.
- Niezależne obserwacje. Każda osoba trafia do dokładnie jednej komórki. Pytanie z kafeterią wielokrotnego wyboru albo pomiar tych samych osób dwa razy łamią to założenie (dla par pomiarów w tabeli 2 × 2 służy test McNemara).
- Kategorie rozłączne i wyczerpujące – każda odpowiedź pasuje do jednej kategorii.
- Wystarczające liczebności oczekiwane. Często stosowana reguła mówi, że najwyżej 20% komórek może mieć liczebność oczekiwaną mniejszą niż 5 i żadna nie może mieć mniejszej niż 1 (Kim, 2017).
Reguła „5” bywa zbyt ostrożna. Dla tabel 2 × 2 Campbell (2007) porównał siedem testów i wykazał, że optymalny jest wariant chi-kwadrat „N − 1”, gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1, a poniżej tej wartości – test Fishera–Irwina; takie postępowanie daje większą moc niż tradycyjne zalecenia Cochrana. Gdy w tabeli r × c liczebności oczekiwane są za małe:
- połącz kategorie, jeśli ma to sens merytoryczny (np. rok IV i V studiów) – i zdecyduj o tym przed analizą wyników;
- policz wartość p metodą Monte Carlo (
chisq.test(tab, simulate.p.value = TRUE)) albo test dokładny Fishera–Freemana–Haltona (fisher.test(tab)); - zaplanuj większą próbę – wymagania co do liczebności to jedno z ograniczeń testu (McHugh, 2013).
Przykład: rok studiów a strategia radzenia sobie ze stresem
W ankiecie 320 studentów psychologii wskazało strategię, po którą najczęściej sięgają w stresie: zadaniową (planowanie, rozwiązywanie problemu), emocjonalną (skupienie na przeżywanych emocjach) lub unikową (odwracanie uwagi, szukanie towarzystwa). Lata IV i V połączono, bo studentów piątego roku było niewielu (dane symulowane). Tabela pokazuje liczebności i procenty w wierszach:
| Rok studiów | Zadaniowa | Emocjonalna | Unikowa | Razem |
|---|---|---|---|---|
| I | 35 (36.8%) | 41 (43.2%) | 19 (20.0%) | 95 |
| II | 32 (40.0%) | 28 (35.0%) | 20 (25.0%) | 80 |
| III | 40 (53.3%) | 19 (25.3%) | 16 (21.3%) | 75 |
| IV–V | 46 (65.7%) | 13 (18.6%) | 11 (15.7%) | 70 |
| Razem | 153 (47.8%) | 101 (31.6%) | 66 (20.6%) | 320 |
Krok 1. Liczebności oczekiwane. Dla pierwszego roku i strategii emocjonalnej: E = 95 × 101 / 320 = 29.98, a zaobserwowano 41 osób. Najmniejsza liczebność oczekiwana wynosi 14.4 (lata IV–V, strategia unikowa), więc żadna komórka nie ma E < 5 i klasyczny test jest odpowiedni.
Krok 2. Statystyka i istotność. χ²(6) = 19.19, p = .004, gdzie df = (4 − 1)(3 − 1) = 6. Wartość p z symulacji Monte Carlo (10 000 powtórzeń) wyniosła .005, czyli prawie tyle samo. Rysunek 1 pokazuje, jak wygląda ten związek.
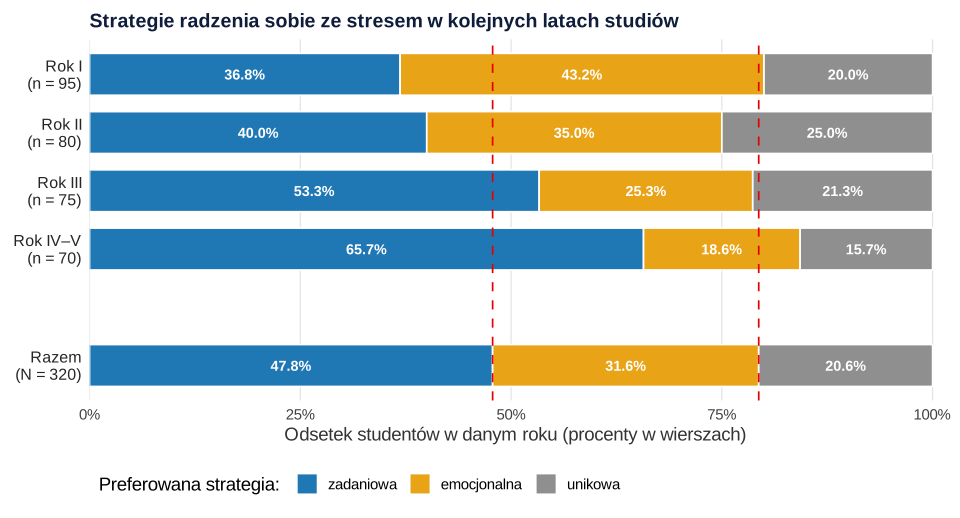
Odsetek osób wybierających strategię zadaniową rośnie od 36.8% na pierwszym roku do 65.7% na latach IV–V, a odsetek wybierających strategię emocjonalną maleje od 43.2% do 18.6%. To jednak badanie przekrojowe: różnice między rocznikami nie dowodzą, że ci sami studenci zmieniają strategie w trakcie studiów (mogą to być np. efekty selekcji – część osób rezygnuje ze studiów).
Gdzie leży związek? Skorygowane reszty standaryzowane
Istotny wynik dla tabeli 4 × 3 mówi tylko, że rozkład strategii nie jest taki sam we wszystkich latach – nie mówi, gdzie leży różnica. Sharpe (2015) omawia cztery sposoby ustalania źródła istotnego wyniku: analizę reszt, porównywanie komórek, „przeszukiwanie” tabeli (ransacking) i jej podział na mniejsze tabele. Pierwszym krokiem jest zwykle analiza skorygowanych reszt standaryzowanych:
Przy niezależności zmiennych taka reszta ma w przybliżeniu standardowy rozkład normalny, więc |z| > 1.96 sygnalizuje komórkę, w której liczebność istotnie odbiega od oczekiwanej (α = .05). Przy 12 komórkach wykonujemy jednak 12 porównań, dlatego ostrożniej jest użyć progu z korektą Bonferroniego: |z| > 2.87.
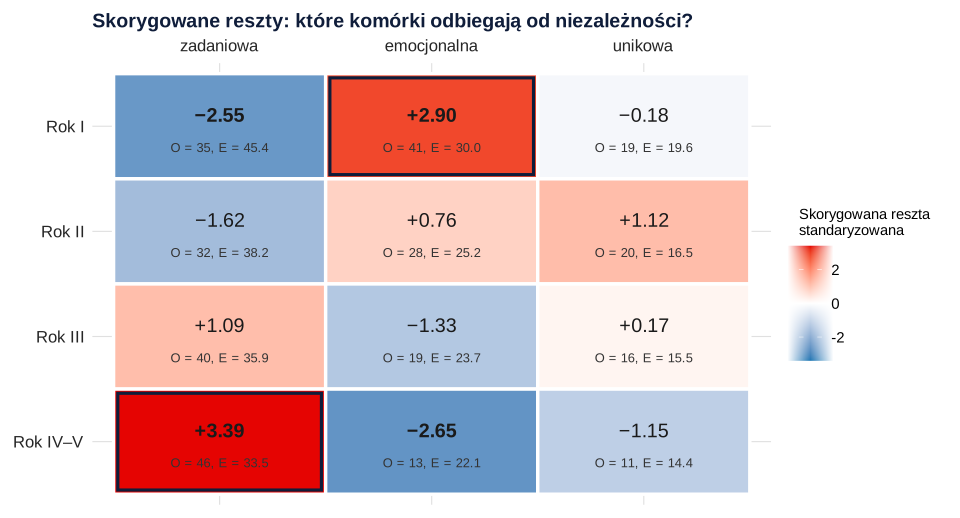
Studenci pierwszego roku częściej, niż wynikałoby z niezależności, wybierali strategię emocjonalną (41 zamiast 30.0 osób, z = 2.90), a rzadziej zadaniową (z = −2.55). Na latach IV–V było odwrotnie: więcej wyborów zadaniowych (z = 3.39) i mniej emocjonalnych (z = −2.65). Próg z korektą Bonferroniego przekraczają tylko reszty 2.90 i 3.39. W kolumnie strategii unikowej żadna reszta nie przekracza |1.96| – tę strategię wybierano podobnie często na każdym roku. Te cztery komórki z lat I i IV–V odpowiadają łącznie za 77.5% wartości χ².
Wielkość efektu: V Craméra
Przy stałych odsetkach χ² rośnie proporcjonalnie do liczebności próby. Gdyby te same procenty uzyskać na 640 osobach, χ² wyniósłby 38.38, a p < .001 – choć związek byłby tak samo silny. Dlatego McHugh (2013) podkreśla, że test χ² jest testem istotności, który trzeba uzupełnić miarą siły związku – najczęściej V Craméra. Kim (2017) przypomina, że φ i iloraz szans stosuje się tylko do tabel 2 × 2, a dla większych tabel – V Craméra:
gdzie k to mniejsza z liczb wierszy i kolumn (tu 3). V przyjmuje wartości od 0 do 1 i nie zmienia się, gdy próbę zwiększymy przy tych samych odsetkach. Związek roku studiów ze strategią jest więc istotny, ale słaby do umiarkowanego. Jak interpretować V w zależności od wielkości tabeli i dlaczego w małych próbach bywa zawyżone, wyjaśniamy w haśle V Craméra. Dla tabel 2 × 2 bardziej intuicyjny bywa iloraz szans; ogólnie o miarach efektu – w haśle wielkość efektu.
Jak opisać wynik w pracy (APA)
Zapis wyniku obejmuje liczbę stopni swobody, liczebność próby, wartość χ², p i wielkość efektu, a przy tabelach r × c – także opis kierunku związku na podstawie procentów i reszt:
Pełną tabelę liczebności przedstaw w formacie APA, z kierunkiem istotnych reszt zaznaczonym w notce:
Tabela 1
Preferowana strategia radzenia sobie ze stresem w zależności od roku studiów
| Rok studiów | Zadaniowa | Emocjonalna | Unikowa | Razem | |||
|---|---|---|---|---|---|---|---|
| n | % | n | % | n | % | ||
| I | 35− | 36.8 | 41+ | 43.2 | 19 | 20.0 | 95 |
| II | 32 | 40.0 | 28 | 35.0 | 20 | 25.0 | 80 |
| III | 40 | 53.3 | 19 | 25.3 | 16 | 21.3 | 75 |
| IV–V | 46+ | 65.7 | 13− | 18.6 | 11 | 15.7 | 70 |
| Razem | 153 | 47.8 | 101 | 31.6 | 66 | 20.6 | 320 |
Uwaga. N = 320. Procenty obliczono w wierszach. χ²(6, N = 320) = 19.19, p = .004, V = .17. Znak + (−) oznacza liczebność wyższą (niższą) od oczekiwanej przy niezależności zmiennych; skorygowana reszta standaryzowana |z| > 1.96.
Jeśli dane pochodzą z formularza online, przed analizą sprawdź kodowanie odpowiedzi (zob. dane z Google Forms i LimeSurvey w SPSS i R). Więcej przykładów zapisu znajdziesz w poradniku jak opisać wyniki w stylu APA.
Test chi-kwadrat niezależności w R
Kod wprowadza tabelę 4 × 3 z przykładu, liczy procenty w wierszach, test χ², liczebności oczekiwane, skorygowane reszty standaryzowane, próg Bonferroniego i V Craméra. W SPSS: Analiza → Opis statystyczny → Tabele krzyżowe; w oknie Statystyki zaznacz Chi-kwadrat oraz Phi i V Craméra, a w oknie Komórki – liczebności oczekiwane, procenty w wierszach i skorygowane reszty standaryzowane.
Tabela r × c: test, reszty i V Craméra
R
tab <- matrix(c(35, 41, 19,
                32, 28, 20,
                40, 19, 16,
                46, 13, 11), nrow = 4, byrow = TRUE,
              dimnames = list(rok = c("I", "II", "III", "IV-V"),
                              strategia = c("zadaniowa", "emocjonalna", "unikowa")))
round(100 * prop.table(tab, 1), 1)      # procenty w wierszach
test <- chisq.test(tab)                 # test chi-kwadrat Pearsona
test
round(test$expected, 1)                 # liczebności oczekiwane
mean(test$expected < 5)                 # odsetek komórek z E < 5
round(test$stdres, 2)                   # skorygowane reszty standaryzowane
qnorm(1 - 0.05 / (2 * length(tab)))     # próg Bonferroniego dla 12 reszt
unname(sqrt(test$statistic / (sum(tab) * (min(dim(tab)) - 1))))   # V Craméra
Wynik w R
      strategia
rok    zadaniowa emocjonalna unikowa
  I         36.8        43.2    20.0
  II        40.0        35.0    25.0
  III       53.3        25.3    21.3
  IV-V      65.7        18.6    15.7

	Pearson's Chi-squared test

data:  tab
X-squared = 19.191, df = 6, p-value = 0.003853

      strategia
rok    zadaniowa emocjonalna unikowa
  I         45.4        30.0    19.6
  II        38.2        25.2    16.5
  III       35.9        23.7    15.5
  IV-V      33.5        22.1    14.4
[1] 0
      strategia
rok    zadaniowa emocjonalna unikowa
  I        -2.55        2.90   -0.18
  II       -1.62        0.76    1.12
  III       1.09       -1.33    0.17
  IV-V      3.39       -2.65   -1.15
[1] 2.86526
[1] 0.1731647
Wartość p metodą Monte Carlo daje chisq.test(tab, simulate.p.value = TRUE, B = 10000) – przy set.seed(2026) otrzymaliśmy p = .005.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Test na procentach albo średnich zamiast na liczebnościach – wynik χ² jest wtedy bezwartościowy.
- Ta sama osoba w kilku komórkach (pytania wielokrotnego wyboru, pomiary powtarzane) – narusza niezależność obserwacji.
- „Wynik jest wysoce istotny, więc związek jest silny” – przy dużej próbie nawet słaby związek daje małe p; zawsze podaj V (McHugh, 2013).
- Opis pojedynczych komórek „na oko” – zamiast analizy reszt lub innej metody omawianej przez Sharpe’a (2015), z uwzględnieniem liczby porównań.
- Łączenie kategorii po obejrzeniu wyników, aż test stanie się istotny – to odmiana p-hackingu. O łączeniu decyduj z góry i z powodów merytorycznych.
- Wniosek przyczynowy z danych korelacyjnych – test pokazuje związek zmiennych, a nie to, że jedna wpływa na drugą.
Najczęstsze pytania
Co to jest test chi-kwadrat niezależności?
To test, który sprawdza, czy dwie zmienne jakościowe – np. rok studiów i preferowana strategia radzenia sobie ze stresem – są ze sobą powiązane. Porównuje liczebności obserwowane w tabeli krzyżowej z liczebnościami, jakich należałoby się spodziewać, gdyby zmienne były niezależne. Duże rozbieżności dają duże χ² i małą wartość p.
Jak obliczyć liczebności oczekiwane w teście chi-kwadrat?
Dla każdej komórki pomnóż sumę jej wiersza przez sumę jej kolumny i podziel przez liczebność próby: E = (suma wiersza × suma kolumny) / N. Na przykład przy 95 studentach pierwszego roku, 101 osobach wybierających strategię emocjonalną i N = 320: E = 95 × 101 / 320 = 29.98. W R: chisq.test(tab)$expected.
Co zrobić, gdy liczebności oczekiwane są mniejsze niż 5?
Sprawdź, ile komórek ma E < 5 – zwykle dopuszcza się najwyżej 20% takich komórek i żadnej z E < 1. Jeśli warunek nie jest spełniony, połącz kategorie (gdy ma to sens merytoryczny) albo policz wartość p metodą Monte Carlo lub testem dokładnym Fishera. Dla tabel 2 × 2 dobrym wyborem jest wariant chi-kwadrat „N − 1”, gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1.
Jak sprawdzić, które kategorie różnią się po teście chi-kwadrat?
Przeanalizuj skorygowane reszty standaryzowane (w R: chisq.test(tab)$stdres, w SPSS: reszty standaryzowane skorygowane). Reszta powyżej 1.96 oznacza, że w komórce jest istotnie więcej obserwacji, niż wynikałoby z niezależności, a poniżej −1.96 – że mniej. Przy wielu komórkach zastosuj próg z korektą Bonferroniego, np. 2.87 dla 12 komórek.
Jaka wielkość efektu dla testu chi-kwadrat?
Dla tabel większych niż 2 × 2 podaje się V Craméra: V = √[χ² / (N(k − 1))], gdzie k to mniejsza z liczb wierszy i kolumn. Dla tabel 2 × 2 stosuje się też φ i iloraz szans. Sama wartość χ² nie jest miarą siły związku, bo rośnie razem z liczebnością próby.
Jak zapisać wynik testu chi-kwadrat w APA?
Podaj stopnie swobody, liczebność próby, wartość statystyki, p i wielkość efektu, np. χ²(6, N = 320) = 19.19, p = .004, V = .17. Dodaj kierunek związku – procenty w grupach i komórki z istotnymi resztami – oraz tabelę liczebności z procentami.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Tabela krzyżowa na wykresie
Słupki 100% w wierszach i kolumnach, mozaika, mapa reszt χ² z korektą i odsetki z CI – jedna tabela 3 × 4, pięć rysunków z R, podpisy APA.
Czytaj →PoradnikPytanie wielokrotnego wyboru: porównanie grup
Dlaczego chi-kwadrat na tabeli zaznaczeń to błąd i co zamiast: testy dla opcji z korektą Holma, test łączny z permutacjami, GEE i Q Cochrana – z kodem R.
Czytaj →PoradnikChi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami
Dziesięć zadań z testu χ²: zgodność, tabele krzyżowe, reszty skorygowane, φ i V, Yates, małe liczności, test trendu i paradoks Simpsona – krok po kroku.
Czytaj →PoradnikTest chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Franke, T. M., Ho, T., & Christie, C. A. (2012). The chi-square test: Often used and more often misinterpreted. American Journal of Evaluation, 33(3), 448–458. https://doi.org/10.1177/1098214011426594
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- McHugh, M. L. (2013). The chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018 ● Otwarty dostęp
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what? Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{franke2012chi, author={Franke, Todd Michael and Ho, Timothy and Christie, Christina A.}, title={{The chi-square test: Often used and more often misinterpreted}}, journal={American Journal of Evaluation}, year={2012}, volume={33}, number={3}, pages={448--458}, doi={10.1177/1098214011426594}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{mchugh2013chi, author={McHugh, Mary L.}, title={{The chi-square test of independence}}, journal={Biochemia Medica}, year={2013}, volume={23}, number={2}, pages={143--149}, doi={10.11613/bm.2013.018}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={{Chi-square test is statistically significant: Now what?}}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}