Co to jest estymacja punktowa?
Estymacja punktowa (ang. point estimation) to szacowanie nieznanego parametru populacji jedną liczbą obliczoną z próby. Średnia z próby szacuje średnią w populacji, odsetek w próbie – odsetek w populacji, a współczynnik r – korelację ρ. Od tego zaczyna się prawie każda analiza: zanim zapytasz, czy efekt jest istotny, musisz wiedzieć, ile wynosi. Cumming (2014) postuluje zresztą, by to szacowanie wielkości efektów wraz z przedziałami ufności, a nie samo testowanie istotności, stało się podstawą wnioskowania w psychologii.
Warto rozróżniać trzy pojęcia:
- parametr (θ) – stała, nieznana wartość w populacji, np. średni poziom stresu wszystkich osób studiujących;
- estymator (θ̂) – reguła obliczania oszacowania z danych, np. „zsumuj wyniki i podziel przez n”; w każdej próbie daje inną wartość;
- oszacowanie (estymata) – konkretna liczba uzyskana z Twojej próby, np. M = 19.86.
Wartości estymatora w kolejnych hipotetycznych próbach tworzą rozkład z prób, a jego odchylenie standardowe to błąd standardowy. Estymacja punktowa odpowiada więc na pytanie „ile?”, a estymacja przedziałowa – „z jaką precyzją?”.
Najczęstsze estymatory punktowe
| Parametr w populacji | Estymator z próby | Uwagi |
|---|---|---|
| Średnia μ | średnia M = Σx / n | Nieobciążony; wrażliwy na wartości skrajne |
| Odsetek π | p̂ = k / n (k – liczba osób z daną cechą) | Nieobciążony; SE = √[p̂(1 − p̂) / n] |
| Korelacja ρ | r Pearsona | W małych próbach lekko obciążony w stronę zera; rozkład z prób asymetryczny |
| Wariancja σ² | s² = Σ(x − M)² / (n − 1) | Nieobciążony; ze wzoru z mianownikiem n – zaniżony |
| Odchylenie standardowe σ | s = √s² | Lekko zaniżony, ale zgodny |
| Standaryzowana różnica średnich δ | d Cohena, g Hedgesa | d w małych próbach zawyża efekt; g to wersja z poprawką |
| Udział wyjaśnionej wariancji | η², ω², ε² | η² zawyża efekt; ω² i ε² są mniej obciążone |
| Mediana populacji | mediana z próby | Odporna na wartości skrajne |
Uwagi w trzeciej kolumnie odwołują się do trzech cech, którymi ocenia się estymatory.
Cechy dobrego estymatora
- Nieobciążoność (ang. unbiasedness) – średnia oszacowań z wielu prób równa się parametrowi: E(θ̂) = θ. Różnica E(θ̂) − θ to obciążenie (ang. bias), czyli błąd systematyczny estymatora.
- Efektywność (ang. efficiency) – spośród estymatorów nieobciążonych lepszy jest ten, którego oszacowania mniej się rozrzucają, czyli który ma mniejszy błąd standardowy. Efektywność względna to iloraz wariancji dwóch estymatorów.
- Zgodność (ang. consistency) – wraz ze wzrostem liczebności próby oszacowania coraz ciaśniej skupiają się wokół parametru; zwykle dzieje się tak dlatego, że obciążenie i błąd standardowy maleją do zera.
Obciążenie i rozrzut łączy błąd średniokwadratowy (ang. mean squared error, MSE) – przeciętny kwadrat odległości oszacowania od prawdziwej wartości:
Symulacja: średnia czy mediana?
Gdy rozkład w populacji jest symetryczny, średnia i mediana populacji są równe, więc średnia i mediana z próby szacują ten sam parametr. Który estymator jest lepszy? Z populacji wyników testu o średniej 100 i odchyleniu standardowym 15 (rozkład normalny) wylosowaliśmy po 10 000 prób różnej wielkości i w każdej policzyliśmy oba estymatory (rysunek 1).
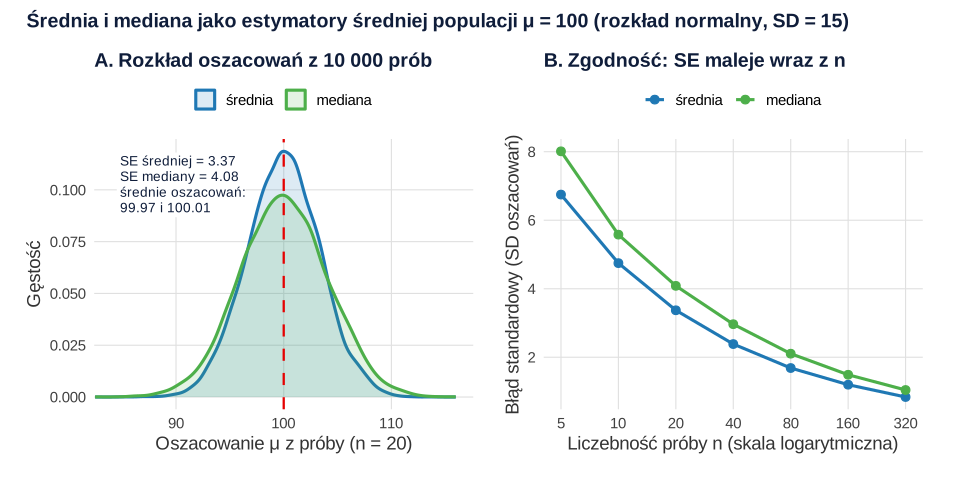
Rysunek pokazuje wszystkie trzy cechy naraz:
- nieobciążoność: średnia z 10 000 średnich wyniosła 99.97, a z 10 000 median – 100.01; oba estymatory „celują” w prawdziwą wartość;
- efektywność: przy n = 20 błąd standardowy średniej wyniósł 3.37, a mediany – 4.08; efektywność względna mediany to 0.681, więc by oszacować μ medianą równie precyzyjnie, potrzeba mniej więcej półtora raza większej próby;
- zgodność: błąd standardowy obu estymatorów maleje wraz z liczebnością – od 6.75 i 8.01 przy n = 5 do 0.84 i 1.04 przy n = 320. Dlaczego rozkład średnich zbliża się do normalnego także wtedy, gdy same wyniki nie mają rozkładu normalnego, wyjaśnia centralne twierdzenie graniczne.
Efektywność zależy jednak od rozkładu. Gdy dodaliśmy grube ogony – 10% wyników pochodziło z rozkładu o trzykrotnie większym odchyleniu standardowym – przy n = 40 błąd standardowy średniej wzrósł do 3.16, mediany do 3.11, a średniej obciętej 20% tylko do 2.74 (w rozkładzie normalnym: 2.36, 2.92 i 2.52). Przy takich danych, z częstymi obserwacjami odstającymi, średnia przestaje być najlepszym wyborem. Wilcox i Keselman (2003) pokazują, że metody oparte na odpornych miarach położenia mogą wtedy wyraźnie zwiększyć moc i trafność porównań.
Nieobciążony nie znaczy najdokładniejszy
Wariancję z próby liczy się z mianownikiem n − 1, bo wzór z mianownikiem n systematycznie ją zaniża – dlaczego, wyjaśniamy w haśle wariancja. Wzór z n − 1 nie musi jednak dawać oszacowań bliższych prawdy. Sprawdziliśmy to na 20 000 próbach po 10 osób z populacji o σ² = 225 (σ = 15):
| Estymator | Średnia oszacowań | Obciążenie | SD oszacowań | √MSE |
|---|---|---|---|---|
| s² z mianownikiem n − 1 | 225.58 | 0.58 | 107.22 | 107.22 |
| s² z mianownikiem n | 203.02 | −21.98 | 96.50 | 98.97 |
| s (dla σ = 15) | 14.60 | −0.40 | 3.51 | 3.53 |
Wzór z mianownikiem n jest obciążony – średnio zaniża wariancję o 21.98 – ale jego oszacowania mniej się rozrzucają, więc ich typowa odległość od prawdy (√MSE) jest mniejsza: 98.97 wobec 107.22. Wybór estymatora bywa więc kompromisem między obciążeniem a precyzją. Z kolei odchylenie standardowe s jest lekko zaniżone (14.60 przy σ = 15), choć liczy się je z nieobciążonej wariancji – obciążenie maleje jednak wraz z n, więc estymator jest zgodny.
W psychologii obciążenie ma największe znaczenie przy miarach wielkości efektu z małych prób. Lakens (2013) wyjaśnia, że η² jest nieskorygowanym estymatorem z próby, a ω² zmniejsza jego obciążenie – różnica jest zwykle niewielka i maleje wraz z liczebnością. Albers i Lakens (2018) odradzają η² jako podstawę analizy mocy na danych z pilotażu.
Przykład: pilotaż a badanie główne
W symulacji znamy całą populację: milion osób studiujących, w której średni wynik w skali stresu PSS-10 (0–40) wynosi μ = 20.00, odsetek osób śpiących krócej niż 6 godzin π = .285, a korelacja stresu z długością snu ρ = −.35. Z tej populacji wylosowaliśmy pilotaż (n = 15) i badanie główne (n = 150) i w obu policzyliśmy te same estymatory.
| Parametr | Wartość w populacji | Pilotaż (n = 15) | Badanie główne (n = 150) |
|---|---|---|---|
| Średni stres μ | 20.00 | 21.40 (SE = 1.38) | 19.86 (SE = 0.50) |
| Odsetek krótkiego snu π | .285 | .20 (SE = .10) | .26 (SE = .04) |
| Korelacja stresu ze snem ρ | −.35 | −.45 (SE ≈ .25) | −.38 (SE ≈ .08) |
Oszacowania z pilotażu odbiegają od prawdy: średnia jest o 1.4 punktu za wysoka, a korelacja wyraźnie silniejsza niż w populacji. To nie wada estymatorów, tylko skutek małej próby – błędy standardowe w pilotażu są około trzy razy większe niż w badaniu głównym. Pojedyncza liczba z małej próby może więc wyglądać przekonująco, a być daleko od parametru. Dlatego nie planuj liczebności badania głównego na podstawie samych oszacowań punktowych z badania pilotażowego (zob. dobór liczebności próby) i zawsze podawaj miarę precyzji.
Jak opisać oszacowania w pracy (APA)
Oszacowanie punktowe podawaj razem z miarą precyzji – najlepiej z 95% przedziałem ufności (jak go zbudować dla średniej, odsetka i korelacji, pokazujemy w haśle estymacja przedziałowa). Nazwij też estymator, jeśli nie jest oczywisty: „średnia obcięta 20%”, „g Hedgesa”, „ω²”. Opis badania głównego z przykładu:
Zwróć uwagę, że to opis próby i oszacowań, a nie twierdzenie o przyczynach: dane korelacyjne nie pokazują, czy stres skraca sen, czy krótki sen nasila stres.
Przykład w R
Kod odtwarza symulacje z tej strony: porównanie średniej i mediany, wpływ grubych ogonów, obciążenie i błąd średniokwadratowy estymatorów wariancji oraz oszacowania z pilotażu i badania głównego. Liczby w tekście i tabelach pochodzą z tego kodu (rysunek 1 – z wersji z pętlą po liczebnościach).
Właściwości estymatorów w symulacji
R
# 1. Średnia i mediana jako estymatory μ = 100 (populacja normalna, SD = 15), n = 20
set.seed(20)
x <- matrix(rnorm(10000 * 20, mean = 100, sd = 15), nrow = 10000)   # 10 000 prób po 20 osób
srednie <- rowMeans(x)
mediany <- apply(x, 1, median)
round(c(M_srednich = mean(srednie), M_median = mean(mediany),
        SE_sredniej = sd(srednie), SE_mediany = sd(mediany),
        efektywnosc = var(srednie) / var(mediany)), 3)

# 2. Grube ogony: 10% wyników z rozkładu o trzykrotnie większym SD (n = 40)
set.seed(41)
proby <- function(gruby) {
  x <- matrix(rnorm(10000 * 40, 100, 15), nrow = 10000)
  if (gruby) {
    zanieczysc <- matrix(runif(10000 * 40) < 0.10, nrow = 10000)
    x[zanieczysc] <- rnorm(sum(zanieczysc), 100, 45)
  }
  c(srednia = sd(rowMeans(x)), mediana = sd(apply(x, 1, median)),
    obcieta20 = sd(apply(x, 1, mean, trim = 0.2)))
}
round(rbind(normalny = proby(FALSE), grube_ogony = proby(TRUE)), 2)

# 3. Wariancja z mianownikiem n − 1 i n (n = 10, σ² = 225)
set.seed(7)
x <- matrix(rnorm(20000 * 10, 100, 15), nrow = 20000)
s2_n1 <- apply(x, 1, var)          # mianownik n − 1
s2_n <- s2_n1 * 9 / 10             # mianownik n
ocen <- function(est, prawda) c(srednia = mean(est), obciazenie = mean(est) - prawda,
                                 SD = sd(est), pierwiastek_MSE = sqrt(mean((est - prawda)^2)))
round(rbind(s2_n1 = ocen(s2_n1, 225), s2_n = ocen(s2_n, 225), s = ocen(sqrt(s2_n1), 15)), 2)

# 4. Pilotaż (n = 15) i badanie główne (n = 150) z tej samej populacji
set.seed(3)
N <- 1e6
z1 <- rnorm(N); z2 <- -0.35 * z1 + sqrt(1 - 0.35^2) * rnorm(N)
populacja <- data.frame(stres = pmin(pmax(round(20 + 6 * z1), 0), 40),   # PSS-10 (0–40)
                        sen = round(6.6 + 1.15 * z2, 1))                    # godziny snu
populacja$krotki_sen <- populacja$sen < 6                                  # sen krótszy niż 6 h
round(c(mu = mean(populacja$stres), pi = mean(populacja$krotki_sen),
        rho = cor(populacja$stres, populacja$sen)), 3)                       # prawdziwe parametry
oszacuj <- function(d) {
  n <- nrow(d); p <- mean(d$krotki_sen); r <- cor(d$stres, d$sen)
  c(M = mean(d$stres), SE_M = sd(d$stres) / sqrt(n), p = p, SE_p = sqrt(p * (1 - p) / n),
    r = r, SE_r = sqrt((1 - r^2) / (n - 2)))
}
set.seed(11)
pilotaz <- populacja[sample(N, 15), ]
glowne <- populacja[sample(N, 150), ]
round(rbind(pilotaz = oszacuj(pilotaz), badanie_glowne = oszacuj(glowne)), 3)

# Badanie główne: oszacowania z 95% przedziałami ufności (zob. estymacja przedziałowa)
round(sd(glowne$stres), 2)
przedzial <- function(test) round(test$conf.int[1:2], 3)
rbind(srednia = przedzial(t.test(glowne$stres)),
      odsetek = przedzial(prop.test(sum(glowne$krotki_sen), 150, correct = FALSE)),   # metoda Wilsona
      r = przedzial(cor.test(glowne$stres, glowne$sen)))
Wynik w R
 M_srednich    M_median SE_sredniej  SE_mediany efektywnosc
     99.973     100.008       3.371       4.084       0.681
            srednia mediana obcieta20
normalny       2.36    2.92      2.52
grube_ogony    3.16    3.11      2.74
      srednia obciazenie     SD pierwiastek_MSE
s2_n1  225.58       0.58 107.22          107.22
s2_n   203.02     -21.98  96.50           98.97
s       14.60      -0.40   3.51            3.53
    mu     pi    rho
20.002  0.285 -0.351
                   M  SE_M    p  SE_p      r  SE_r
pilotaz        21.40 1.383 0.20 0.103 -0.453 0.247
badanie_glowne 19.86 0.503 0.26 0.036 -0.376 0.076
[1] 6.16
          [,1]   [,2]
srednia 18.867 20.853
odsetek  0.196  0.336
r       -0.506 -0.229
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Oszacowanie bez miary precyzji – „korelacja wyniosła −.45” z pilotażu na 15 osobach wygląda tak samo jak wynik z 150 osób, choć jest kilka razy mniej precyzyjna. Podawaj SE albo przedział ufności.
- Mylenie oszacowania z parametrem – M = 19.86 to średnia w próbie, a nie „średni stres studentów”. Hipotezy i wnioski dotyczą parametrów, a oszacowanie jest tylko ich przybliżeniem.
- Planowanie badania na podstawie oszacowań z pilotażu – małe próby dają niepewne, a w przypadku η² także zawyżone oszacowania efektu (Albers i Lakens, 2018).
- η² i d z małych prób bez korekty – podawaj ω² lub ε² oraz g Hedgesa, a przynajmniej zaznacz, że oszacowanie może być zawyżone.
- Średnia jako jedyny wybór – przy grubych ogonach i wartościach odstających mediana lub średnia obcięta bywają efektywniejsze (Wilcox i Keselman, 2003). Pamiętaj jednak, że w rozkładzie skośnym szacują one inny parametr niż średnia.
Najczęstsze pytania
Co to jest estymacja punktowa?
Estymacja punktowa to szacowanie nieznanego parametru populacji jedną liczbą obliczoną z próby. Na przykład średnia z próby (M) szacuje średnią w populacji (μ), a współczynnik r – korelację ρ. Oszacowanie punktowe odpowiada na pytanie „ile?”, a przedział ufności – „z jaką precyzją?”.
Czym różni się estymator od parametru?
Parametr to stała, nieznana wartość w populacji, np. średni poziom stresu wszystkich osób studiujących. Estymator to reguła liczenia z próby (np. średnia arytmetyczna), a oszacowanie – liczba uzyskana z konkretnych danych. W kolejnych próbach estymator daje różne oszacowania, a ich rozrzut opisuje błąd standardowy.
Co to jest estymator nieobciążony?
To estymator, którego oszacowania są średnio równe parametrowi: E(θ̂) = θ. Nieobciążone są np. średnia z próby, odsetek i wariancja liczona z mianownikiem n − 1. W naszej symulacji średnia z 20 000 oszacowań wariancji (σ² = 225) wyniosła 225.58 przy mianowniku n − 1 i 203.02 przy mianowniku n.
Co oznacza, że estymator jest efektywny i zgodny?
Estymator efektywny ma mały błąd standardowy – jego oszacowania mało się rozrzucają; przy rozkładzie normalnym średnia jest efektywniejsza od mediany (SE 3.37 wobec 4.08 przy n = 20). Estymator zgodny zbliża się do parametru, gdy rośnie liczebność próby – jego obciążenie i błąd standardowy dążą do zera.
Co jest lepszym estymatorem: średnia czy mediana?
Przy rozkładzie normalnym średnia – mediana potrzebuje mniej więcej półtora raza większej próby, by osiągnąć tę samą precyzję. Przy grubych ogonach i wartościach odstających przewagę mogą mieć mediana i średnia obcięta. W rozkładach skośnych średnia i mediana opisują różne parametry, więc wybór zależy od pytania badawczego.
Jak raportować oszacowanie punktowe w pracy?
Podaj oszacowanie razem z miarą precyzji, najlepiej 95% przedziałem ufności, np. M = 19.86, 95% CI [18.87, 20.85]. Jeśli estymator nie jest oczywisty, nazwij go: średnia obcięta 20%, g Hedgesa, ω².
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Centralne twierdzenie graniczne
Co mówi CTG, dlaczego dotyczy średnich, a nie danych, ile osób naprawdę potrzeba i kiedy twierdzenie zawodzi – z symulacjami w R.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
Cytowania BibTeX
@article{albers2018power, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}