Co to jest efektywność estymatora?
Efektywność estymatora (ang. efficiency) opisuje, jak mało rozrzucają się jego oszacowania wokół parametru. Spośród dwóch estymatorów nieobciążonych efektywniejszy jest ten o mniejszej wariancji, czyli mniejszym błędzie standardowym. Efektywność względna T1 wobec T2 to iloraz Var(T2)/Var(T1): wartość 0.64 oznacza, że T1 potrzebuje około 1/0.64 ≈ 1.6 razy większej próby, by dorównać precyzji T2. Ogólne cechy dobrego estymatora omawia hasło estymacja punktowa.
Granica Craméra–Rao
Wariancja estymatora nieobciążonego nie może być mniejsza niż 1/[n·I(θ)], gdzie I(θ) to informacja Fishera z jednej obserwacji. Estymator, który osiąga tę granicę, nazywa się efektywnym. W rozkładzie normalnym średnia osiąga ją dla μ, a estymatory największej wiarygodności zbliżają się do niej przy dużym n. Dla estymatorów obciążonych porównuje się zamiast wariancji błąd średniokwadratowy (MSE).
Przykład w R
W 10 000 próbach po 100 obserwacji z rozkładu normalnego n·Var(M) wyniosło 0.989, czyli prawie dokładnie granicę 1. Efektywność mediany względem średniej wyniosła 0.657 (asymptotycznie 2/π = 0.637). W rozkładzie t z 3 stopniami swobody role się odwróciły: 1.612, mediana była więc efektywniejsza od średniej. W rozkładzie Cauchy’ego wariancja średnich wyniosła 3949.7, mediany 0.0254, a średniej ze środkowej ćwiartki próby 0.0238 – zgodnie z wynikiem Rothenberga i in. (1964).
Na rysunku
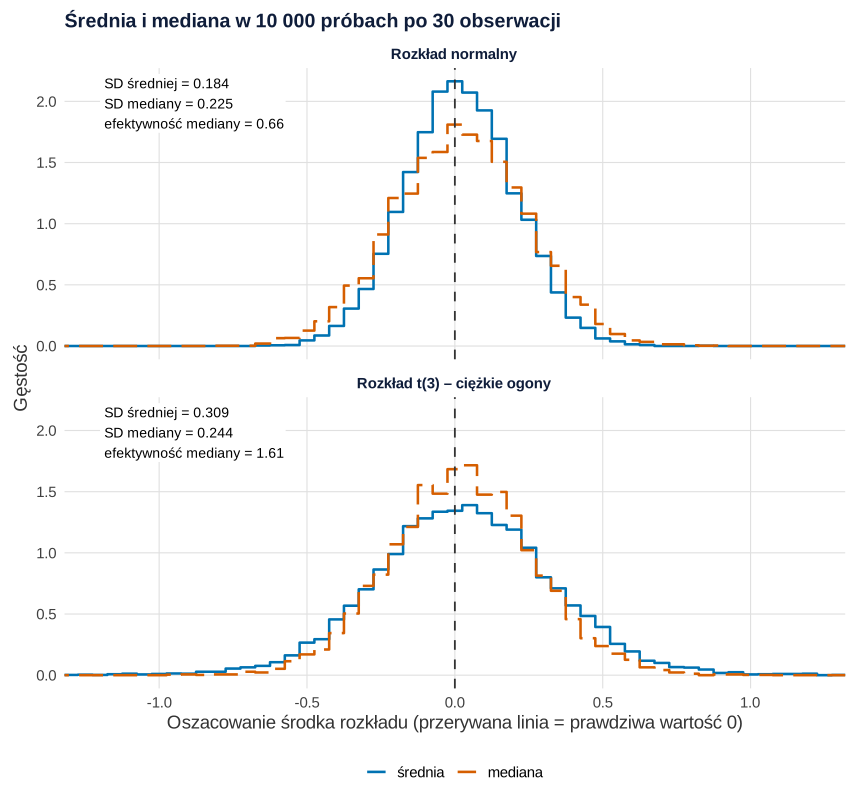
set.seed(5042)).Co widać. Rysunek powtarza porównanie z przykładu dla mniejszych prób: po 30 obserwacji, 10 000 powtórzeń w każdym rozkładzie. Przy rozkładzie normalnym (górny panel) rozkład średnich jest węższy niż rozkład median: SD wynosi 0.184 wobec 0.225, a efektywność względna mediany 0.66 (błąd Monte Carlo ±0.01; asymptotycznie 2/π ≈ 0.64). Mediana wykorzystuje więc informację z próby gorzej – potrzebuje około 1.5 raza więcej osób, by dorównać średniej. W rozkładzie t(3) (dolny panel) jest odwrotnie: rzadkie, bardzo odległe obserwacje rozciągają rozkład średnich (SD 0.309), a mediana prawie ich nie odczuwa (SD 0.244), więc jej efektywność względna wynosi 1.61 (±0.04). Oba estymatory są tu nieobciążone – oba rozkłady leżą wokół 0 – i różnią się tylko rozrzutem. Liczebność 30 i rozkład t(3) wybrano ręcznie jako typową wielkość grupy i umiarkowanie ciężkie ogony; ziarna nie zmieniano.
Na co uważać. Efektywność względna zależy od rozkładu w populacji, którego w badaniu nie znamy. Rysunek pokazuje dwa rozkłady symetryczne; przy rozkładzie skośnym średnia i mediana szacują różne parametry, więc samo porównanie ich wariancji nic nie rozstrzyga – najpierw trzeba wybrać, który parametr opisuje pytanie badawcze. Kształt rozkładu danych lepiej ocenić na wykresie kwantylowym niż na histogramie. Kompromisem między średnią a medianą jest średnia ucinana. Jak błąd standardowy obu estymatorów maleje z liczebnością próby przy rozkładzie normalnym, pokazuje hasło estymacja punktowa.
Podpis do pracy:
Kod rysunku losuje dane z ustalonym ziarnem set.seed(5042) i liczy się w kilka sekund. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Średnia i mediana w 10 000 próbach po n = 30: rozkład normalny i t(3)
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("średnia" = "#0072B2", "mediana" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

n <- 30; R <- 10000
rozklady <- list("Rozkład normalny" = function(n) rnorm(n),
                 "Rozkład t(3) – ciężkie ogony" = function(n) rt(n, df = 3))
set.seed(5042)
dl <- do.call(rbind, lapply(names(rozklady), function(r) {
  x <- matrix(rozklady[[r]](R * n), nrow = R)            # R prób po n obserwacji, środek = 0
  rbind(data.frame(rozklad = r, estymator = "średnia", wartosc = rowMeans(x)),
        data.frame(rozklad = r, estymator = "mediana", wartosc = apply(x, 1, median)))
}))

# SD oszacowań i efektywność względna mediany wobec średniej: Var(średnia) / Var(mediana);
# błąd Monte Carlo efektywności z 500 losowań bootstrap z 10 000 par oszacowań
ef <- do.call(rbind, lapply(names(rozklady), function(r) {
  m <- dl$wartosc[dl$rozklad == r & dl$estymator == "średnia"]
  me <- dl$wartosc[dl$rozklad == r & dl$estymator == "mediana"]
  boot <- replicate(500, { i <- sample(R, R, replace = TRUE); var(m[i]) / var(me[i]) })
  data.frame(rozklad = r, SD_srednia = sd(m), SD_mediana = sd(me),
             efektywnosc = var(m) / var(me), blad_MC = sd(boot))
}))
print(format(ef, digits = 3), row.names = FALSE)
c(teoria_normalny = 2 / pi)

# Rysunek: histogramy schodkowe (przedziały co 0.05); przerywana linia = prawdziwy środek 0
dl$estymator <- factor(dl$estymator, levels = names(kol))
ef$etykieta <- sprintf("SD średniej = %.3f\nSD mediany = %.3f\nefektywność mediany = %.2f",
                       ef$SD_srednia, ef$SD_mediana, ef$efektywnosc)
p <- ggplot(dl, aes(wartosc, colour = estymator, linetype = estymator)) +
  stat_bin(aes(y = after_stat(density)), geom = "step", position = "identity", binwidth = 0.05, boundary = 0, linewidth = 0.9) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey20") +
  geom_label(aes(x = -1.2, y = Inf, label = etykieta), data = ef, inherit.aes = FALSE,
             vjust = 1.1, hjust = 0, size = 3.7, linewidth = 0, fill = "white") +
  facet_wrap(~ rozklad, ncol = 1) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("średnia" = "solid", "mediana" = "longdash"), name = NULL) +
  coord_cartesian(xlim = c(-1.2, 1.2)) +
  labs(title = "Średnia i mediana w 10 000 próbach po 30 obserwacji",
       x = "Oszacowanie środka rozkładu (przerywana linia = prawdziwa wartość 0)", y = "Gęstość") +
  motyw
p
Wynik w R
                      rozklad SD_srednia SD_mediana efektywnosc blad_MC
             Rozkład normalny      0.184      0.225       0.665 0.00747
 Rozkład t(3) – ciężkie ogony      0.309      0.244       1.607 0.04130
teoria_normalny
      0.6366198
Jak opisać w pracy
Na co uważać
- Efektywność zależy od rozkładu. Najlepszy estymator dla danych normalnych bywa słaby przy ciężkich ogonach; kompromisem jest średnia ucinana.
- Testy też mają efektywność. Hodges i Lehmann (1956) wykazali, że asymptotyczna efektywność dwupróbkowego testu Wilcoxona (testu U Manna-Whitneya) względem testu t nigdy nie spada poniżej 0.864.
- Efektywność to nie zgodność. Estymator może być mało efektywny, a mimo to zgodny.
Efektywność estymatora w R
Kod porównuje wariancje średniej, mediany i średniej ze środkowej ćwiartki próby w rozkładzie normalnym, t(3) i Cauchy’ego oraz zestawia wariancję średniej z granicą Craméra–Rao.
Średnia, mediana i średnia ze środkowej ćwiartki
R
set.seed(5041)
n <- 100; R <- 10000
srodek <- function(x) mean(sort(x)[(3 * n / 8 + 1):(5 * n / 8)])  # średnia ze środkowej ćwiartki
sym <- function(los) {
  est <- replicate(R, { x <- los(n); c(M = mean(x), Me = median(x), C = srodek(x)) })
  apply(est, 1, var)
}
v_norm <- sym(rnorm); v_t3 <- sym(function(n) rt(n, 3))
round(c(nVar_M_norm = n * v_norm[["M"]], granica_CR = 1), 3)  # 1/I(mu) = sigma^2 = 1
round(c(norm = v_norm[["M"]] / v_norm[["Me"]], t3 = v_t3[["M"]] / v_t3[["Me"]],
        teoria_norm = 2 / pi), 3)             # efektywność mediany względem średniej
v_c <- sym(rcauchy)
round(v_c, 4)                                 # Cauchy: wariancje oszacowań
Wynik w R
nVar_M_norm  granica_CR
      0.989       1.000
       norm          t3 teoria_norm
      0.657       1.612       0.637
        M        Me         C
3949.7285    0.0254    0.0238
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć efektywność względną dwóch estymatorów?
Podziel wariancję jednego estymatora przez wariancję drugiego, np. Var(M)/Var(Me). Wynik 0.64 oznacza, że mediana potrzebuje około 1.6 razy większej próby, by dorównać średniej.
Co to jest granica Craméra–Rao?
To najmniejsza możliwa wariancja estymatora nieobciążonego: 1/[n·I(θ)], gdzie I(θ) to informacja Fishera. Estymator, który ją osiąga, nazywa się efektywnym.
Kiedy mediana jest efektywniejsza od średniej?
Gdy rozkład ma ciężkie ogony. W symulacji dla rozkładu t z 3 stopniami swobody efektywność mediany względem średniej wyniosła 1.612, a w rozkładzie Cauchy’ego średnia jest bezużyteczna.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hodges, J. L., & Lehmann, E. L. (1956). The efficiency of some nonparametric competitors of the t-test. The Annals of Mathematical Statistics, 27(2), 324–335. https://doi.org/10.1214/aoms/1177728261 ● Otwarty dostęp
- Rothenberg, T. J., Fisher, F. M., & Tilanus, C. B. (1964). A note on estimation from a Cauchy sample. Journal of the American Statistical Association, 59(306), 460–463. https://doi.org/10.1080/01621459.1964.10482170
Cytowania BibTeX
@article{hodges1956efficiency, author={Hodges, J. L. and Lehmann, E. L.}, title={{The efficiency of some nonparametric competitors of the t-test}}, journal={The Annals of Mathematical Statistics}, year={1956}, volume={27}, number={2}, pages={324--335}, doi={10.1214/aoms/1177728261}}@article{rothenberg1964note, author={Rothenberg, Thomas J. and Fisher, Franklin M. and Tilanus, C. B.}, title={{A note on estimation from a Cauchy sample}}, journal={Journal of the American Statistical Association}, year={1964}, volume={59}, number={306}, pages={460--463}, doi={10.1080/01621459.1964.10482170}}