Co to jest wykres kwantylowy (Q-Q)?
Wykres kwantylowy (wykres kwantyl–kwantyl, ang. Q-Q plot) porównuje kwantyle z próby z kwantylami rozkładu teoretycznego – najczęściej normalnego. Każdy punkt to jedna obserwacja: na osi poziomej jej wynik oczekiwany przy rozkładzie normalnym, na pionowej – wynik faktyczny. Jeśli dane pochodzą z rozkładu normalnego, punkty układają się wzdłuż prostej.
Wilk i Gnanadesikan (1968) opisali wykresy kwantyl–kwantyl (Q-Q) i procent–procent (P-P) jako techniki porównywania próby z rozkładem teoretycznym oraz prób między sobą. Dziś wykres Q-Q jest najczęściej stosowaną graficzną metodą oceny rozkładu, choć krytykuje się go za subiektywność odczytu (Loy i in., 2016). Ghasemi i Zahediasl (2012) zwracają uwagę, że wykres Q-Q łatwo interpretować zwłaszcza przy dużych próbach. W przeciwieństwie do testu normalności pokazuje on, w którym miejscu rozkładu i w jaki sposób dane odbiegają od normalności.
Jak powstaje wykres Q-Q – krok po kroku
Przykład (dane symulowane): dziesięć osób wypełniło skalę stresu PSS-10; średnia wynosi 19.8, a odchylenie standardowe 3.46.
- Uporządkuj wyniki od najmniejszego do największego: x(1) ≤ x(2) ≤ … ≤ x(n).
- Przypisz każdemu wynikowi poziom prawdopodobieństwa pi = (i − 0.5) / n. Funkcja
ppoints()w R (użyta w tabeli poniżej) przy n ≤ 10 stosuje wariant (i − 3/8) / (n + 1/4). - Znajdź kwantyle teoretyczne zi – wyniki standardowego rozkładu normalnego, poniżej których leży pi rozkładu.
- Nanieś punkty (zi, x(i)) i dodaj linię odniesienia przechodzącą przez pierwszy i trzeci kwartyl.
| i | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| Wynik x(i) | 14 | 17 | 18 | 18 | 19 | 20 | 20 | 23 | 23 | 26 |
| pi | .061 | .159 | .256 | .354 | .451 | .549 | .646 | .744 | .841 | .939 |
| zi | −1.55 | −1.00 | −0.66 | −0.38 | −0.12 | 0.12 | 0.38 | 0.66 | 1.00 | 1.55 |
Najmniejszy wynik (14) zestawiamy z kwantylem −1.55, a największy (26) z kwantylem 1.55. Linia odniesienia przechodzi przez kwartyle (18 i 22.25), więc jej nachylenie (3.15) przybliża odchylenie standardowe (3.46), a jej wysokość w punkcie z = 0 (20.12) – średnią (19.8). Dlatego wykres Q-Q ocenia kształt rozkładu niezależnie od średniej i rozproszenia: dane zawsze można porównać z prostą, a nie z konkretną skalą (zob. standaryzacja).
Jak czytać wykres Q-Q: cztery typowe wzorce
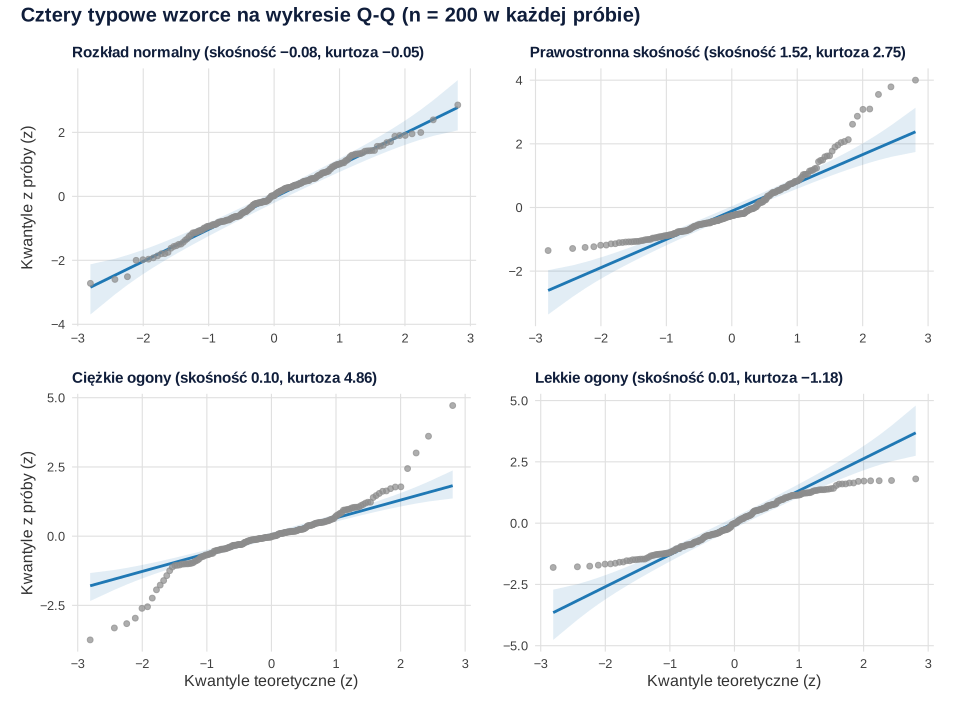
Rysunek 1 pokazuje wykresy Q-Q czterech prób po 200 osób. Środek rozkładu zwykle leży na linii – o kształcie mówią przede wszystkim końce wykresu, czyli ogony.
| Wzorzec | Co oznacza | Przykład w psychologii |
|---|---|---|
| Punkty wzdłuż linii, drobne wahania na końcach | rozkład zbliżony do normalnego | wyniki dobrze skonstruowanej skali |
| Łuk wygięty w górę (oba końce nad linią) | prawostronna skośność | czasy reakcji, liczba objawów |
| Łuk wygięty w dół (oba końce pod linią) | lewostronna skośność | wyniki zbyt łatwego testu |
| Kształt litery S: lewy koniec pod linią, prawy nad nią | ciężkie ogony, dodatnia kurtoza | zmiany wyników przed i po terapii |
| Odwrócone S: końce spłaszczone w stronę środka | lekkie ogony, ujemna kurtoza | suma wyników w kilku wyraźnie różnych grupach |
| Pojedynczy punkt daleko od linii | obserwacja odstająca | błąd wpisania danych |
| Poziome „schodki” | dane dyskretne, wiele powtórzonych wartości | pojedyncza pozycja skali Likerta |
Wykres Q-Q reszt w regresji i ANOVA
W regresji liniowej i ANOVA założenie normalności dotyczy reszt, a nie zmiennej zależnej. Williams i in. (2013) przypominają, że regresja metodą najmniejszych kwadratów wymaga – zwłaszcza w małych próbach – normalności błędów, a nie zmiennej zależnej czy predyktorów. To wciąż częsty błąd: Ernst i Albers (2017) w przeglądzie artykułów z 12 czasopism psychologii klinicznej stwierdzili, że w 4% z nich za założenie uznawano normalność samych zmiennych, a 92% prac z regresją liniową nie raportowało jasno sprawdzania założeń.
Przykład (dane symulowane): trzy grupy po 60 osób uczyły się listy słów bez powtórki, z jedną albo z trzema powtórkami (średnio 10.73, 20.50 i 29.08 zapamiętanych słów). Wspólny rozkład wyników składa się z trzech przesuniętych skupień, więc wykres Q-Q surowej zmiennej odchodzi od linii, a test Shapiro-Wilka daje W = .97, p < .001. Reszty modelu ANOVA (wyniki minus średnia grupy) leżą jednak na linii: W = .99, p = .603.
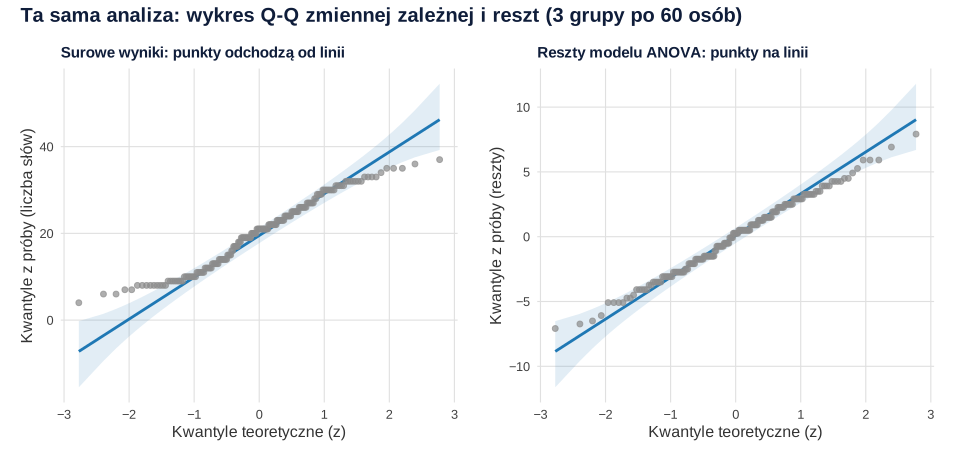
Wniosek: w modelu oglądaj wykres Q-Q reszt, najlepiej razem z wykresem reszt względem wartości dopasowanych. Tak robi się to w ANOVA krok po kroku i w regresji liniowej; w analizie wariancji możesz też obejrzeć wykres Q-Q osobno w każdej grupie.
Liczebność próby: kiedy wykresowi Q-Q można ufać?
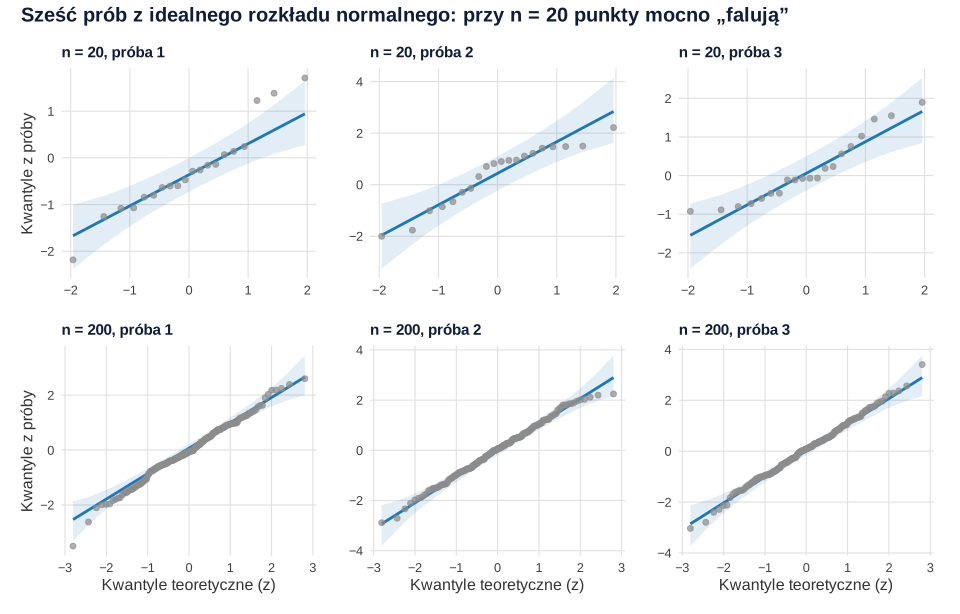
W małych próbach punkty „falują” nawet wtedy, gdy dane pochodzą z idealnego rozkładu normalnego. Kim (2012) zwraca uwagę, że ocena „na oko” ma sens raczej przy n > 50, bo w mniejszych próbach dane z populacji normalnej rzadko wyglądają normalnie. Rysunek 3 pokazuje sześć prób losowanych z rozkładu normalnego: przy 20 osobach pojedyncze punkty wychodzą nawet poza pas, a przy 200 osobach układają się na linii.
Kilka praktycznych wskazówek:
- przy małych próbach oceniaj tylko wyraźne, systematyczne wzorce (łuk, litera S), a nie pojedyncze punkty na końcach;
- pomaga pas ufności wokół linii (w R np.
car::qqPlot()) albo porównanie z wykresami prób symulowanych – Loy i in. (2016) pokazali, że taki protokół „lineup” wykrywa nienormalność skuteczniej niż klasyczne testy normalności; - wykres Q-Q z usuniętym trendem (ang. detrended) bywa czulszy od zwykłego, o ile osie mają jednakową skalę (Loy i in., 2016);
- w dużych próbach wykres jest czytelny, a test Shapiro-Wilka czy test Kołmogorowa-Smirnowa wykrywają nawet drobne odchylenia bez znaczenia praktycznego (Ghasemi i Zahediasl, 2012) – wtedy decyduj na podstawie wykresu.
Jak opisać wykres Q-Q w pracy (APA)
Wykresów diagnostycznych zwykle nie umieszcza się w tekście głównym – wystarczy zdanie o wyniku sprawdzenia, a sam wykres można dodać do aneksu. Przykład dla danych z rysunku 2:
Przykład w R
Kod liczy kwantyle teoretyczne dla dziesięciu wyników (tabela wyżej), porównuje test Shapiro-Wilka dla surowej zmiennej i dla reszt modelu ANOVA oraz rysuje wykres Q-Q reszt w ggplot2. W SPSS wykres Q-Q narysujesz w menu Analiza → Opis statystyczny → Wykresy Q-Q; pamiętaj, że SPSS umieszcza wartości obserwowane na osi poziomej, a oczekiwane na pionowej, więc wzorce z rysunku 1 są wtedy odbite względem przekątnej.
Kwantyle teoretyczne, test reszt i wykres Q-Q
R
library(ggplot2)
# 1. Wykres Q-Q „ręcznie”: 10 wyników w skali stresu PSS-10
set.seed(2610)
stres <- round(rnorm(10, 20, 6))
data.frame(wynik = sort(stres), p = round(ppoints(10), 3), z = round(qnorm(ppoints(10)), 2))

# 2. Zmienna zależna a reszty modelu ANOVA (3 warunki po 60 osób)
set.seed(3)
warunek <- factor(rep(c("bez powtórki", "jedna powtórka", "trzy powtórki"), each = 60))
pamiec  <- round(c(rnorm(60, 11, 3), rnorm(60, 20, 3), rnorm(60, 29, 3)))
reszty  <- residuals(aov(pamiec ~ warunek))
sw <- function(x) round(c(shapiro.test(x)$statistic, p = shapiro.test(x)$p.value), 4)
rbind(surowe = sw(pamiec), reszty = sw(reszty))

# 3. Wykres Q-Q reszt w ggplot2 (w podstawowym R: qqnorm(reszty); qqline(reszty))
ggplot(data.frame(reszty), aes(sample = reszty)) +
  stat_qq(colour = "grey45") +
  stat_qq_line(colour = "#1f78b4", linewidth = 1) +
  labs(x = "Kwantyle teoretyczne (z)", y = "Kwantyle z próby (reszty)") +
  theme_minimal(base_size = 13)
Wynik w R
   wynik     p     z
1     14 0.061 -1.55
2     17 0.159 -1.00
3     18 0.256 -0.66
4     18 0.354 -0.38
5     19 0.451 -0.12
6     20 0.549  0.12
7     20 0.646  0.38
8     23 0.744  0.66
9     23 0.841  1.00
10    26 0.939  1.55
            W      p
surowe 0.9675 0.0003
reszty 0.9934 0.6031
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork, a skośność i kurtozę policzono w pakiecie psych. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
Najczęstsze błędy
- Wykres Q-Q surowej zmiennej zależnej zamiast reszt – różnice między grupami mogą „zepsuć” wykres, choć założenie jest spełnione (rysunek 2).
- Nadinterpretacja końców wykresu w małej próbie – kilka punktów odchylonych od linii przy 20 osobach to zwykle przypadek (rysunek 3).
- Pomylenie osi – w R i SPSS osie są zamienione, więc ten sam rozkład daje lustrzane wzorce; zawsze sprawdź opisy osi.
- Traktowanie testu normalności jako rozstrzygającego – w dużej próbie istotny wynik testu przy prostym wykresie Q-Q zwykle nie ma znaczenia praktycznego.
- Brak opisu, czego dotyczył wykres – w pracy napisz, czy oceniano zmienną, czy reszty, i w jakim modelu.
Najczęstsze pytania
Jak czytać wykres Q-Q?
Sprawdź, czy punkty leżą wzdłuż linii odniesienia. Łuk wygięty w górę oznacza prawostronną skośność, w dół – lewostronną, kształt litery S z końcami odchodzącymi na zewnątrz – ciężkie ogony, a końce spłaszczone do środka – lekkie ogony. Drobne wahania na końcach, zwłaszcza w małych próbach, są normalne.
Co oznacza wykres Q-Q w kształcie litery S?
Jeśli lewy koniec leży pod linią, a prawy nad nią, rozkład ma ciężkie ogony – wyników skrajnych jest więcej niż w rozkładzie normalnym (dodatnia kurtoza). Odwrotny kształt, z końcami spłaszczonymi w stronę środka, oznacza lekkie ogony, np. gdy dane pochodzą z kilku wyraźnie różnych grup.
Czym różni się wykres Q-Q od wykresu P-P?
Wykres Q-Q porównuje wartości (kwantyle) z próby z kwantylami rozkładu teoretycznego, a wykres P-P – skumulowane prawdopodobieństwa. Oba opisali Wilk i Gnanadesikan (1968). Wykres Q-Q jest dziś najczęściej stosowaną graficzną metodą oceny rozkładu (Loy i in., 2016).
Wykres Q-Q zmiennej czy reszt?
W regresji, teście t i ANOVA założenie normalności dotyczy reszt modelu, więc oglądaj wykres Q-Q reszt. Wykres surowej zmiennej zależnej może odbiegać od linii tylko dlatego, że grupy mają różne średnie – mimo że reszty są normalne.
Jak zrobić wykres Q-Q w SPSS i R?
W SPSS: Analiza → Opis statystyczny → Wykresy Q-Q albo Eksploracja → Wykresy → Wykresy normalności z testami; SPSS kładzie wartości obserwowane na osi poziomej. W R: qqnorm(x); qqline(x) lub w ggplot2 stat_qq() i stat_qq_line(); reszty modelu pobierzesz funkcją residuals().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikCzym jest centralne twierdzenie graniczne?
Intuicja, warunki i interaktywna symulacja pokazująca, dlaczego rozkład średnich może zbliżać się do normalnego, choć surowe dane są skośne.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505 ● Otwarty dostęp
- Kim, H.-Y. (2012). Statistical notes for clinical researchers: Assessing normal distribution (1). Restorative Dentistry & Endodontics, 37(4), 245–248. https://doi.org/10.5395/rde.2012.37.4.245 ● Otwarty dostęp
- Loy, A., Follett, L., & Hofmann, H. (2016). Variations of Q–Q plots: The power of our eyes! The American Statistician, 70(2), 202–214. https://doi.org/10.1080/00031305.2015.1077728
- Wilk, M. B., & Gnanadesikan, R. (1968). Probability plotting methods for the analysis of data. Biometrika, 55(1), 1–17. https://doi.org/10.1093/biomet/55.1.1
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@article{ghasemi2012normality, author={Ghasemi, Asghar and Zahediasl, Saleh}, title={{Normality tests for statistical analysis: A guide for non-statisticians}}, journal={International Journal of Endocrinology and Metabolism}, year={2012}, volume={10}, number={2}, pages={486--489}, doi={10.5812/ijem.3505}}@article{kim2012assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (1)}}, journal={Restorative Dentistry \& Endodontics}, year={2012}, volume={37}, number={4}, pages={245--248}, doi={10.5395/rde.2012.37.4.245}}@article{loy2016variations, author={Loy, Adam and Follett, Lendie and Hofmann, Heike}, title={{Variations of Q–Q plots: The power of our eyes!}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={202--214}, doi={10.1080/00031305.2015.1077728}}@article{wilk1968probability, author={Wilk, M. B. and Gnanadesikan, R.}, title={{Probability plotting methods for the analysis of data}}, journal={Biometrika}, year={1968}, volume={55}, number={1}, pages={1--17}, doi={10.1093/biomet/55.1.1}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}