Co to jest wykres P-P?
Wykres P-P (ang. probability-probability plot, procent–procent) sprawdza, czy próba pasuje do rozkładu teoretycznego, najczęściej normalnego. Dla każdej obserwacji zestawia dwie liczby z przedziału od 0 do 1: odsetek próby, który ma wynik nie większy od niej (to dystrybuanta empiryczna), oraz prawdopodobieństwo takiego wyniku według modelu (wartość dystrybuanty teoretycznej). Wilk i Gnanadesikan (1968) opisali wykresy P-P razem z wykresami Q-Q jako dwie rodziny graficznych porównań rozkładów opartych na dystrybuancie empirycznej.
Gdy rozkład próby zgadza się z modelem, punkty leżą na przekątnej od (0, 0) do (1, 1). W SPSS ten wykres pojawia się jako „Normal P-P Plot” reszt w regresji – przykład jest we wpisie korelacja i regresja w SPSS.
Jak czytać wykres
- Punkty na przekątnej – rozkład zgodny z modelem.
- Łagodne S przecinające przekątną w środku – rozkład bardziej wysmukły lub bardziej spłaszczony niż normalny (inna kurtoza).
- Odchylenia niesymetryczne względem środka wykresu – skośność rozkładu.
- Rogi wykresu – tu lądują ogony rozkładu. Prawdopodobieństwa skrajnych wyników są bliskie 0 lub 1, więc nawet bardzo odległa obserwacja wygląda na zgodną z modelem.
Największa pionowa odległość punktów od przekątnej to w przybliżeniu statystyka D testu Kołmogorowa–Smirnowa. Michael (1983) pokazał, jak na tej podstawie dorysować do wykresów P-P i Q-Q obszar akceptacji, który ogranicza subiektywność odczytu.
Przykład
Wygenerowano 200 wyników testu z rozkładu t o 3 stopniach swobody, przesuniętego do średniej 50 (dane symulowane). Taki rozkład ma środek podobny do normalnego, ale znacznie cięższe ogony. Rozkład normalny dopasowano średnią i odchyleniem z próby (M = 50.71, SD = 9.02). Test Shapiro–Wilka wyraźnie odrzuca normalność, W = 0.848, p < .001. Parametry symulacji dobrano ręcznie (3 stopnie swobody, by ogony były wyraźnie cięższe); ziarna (735) nie zmieniano.
Na rysunku
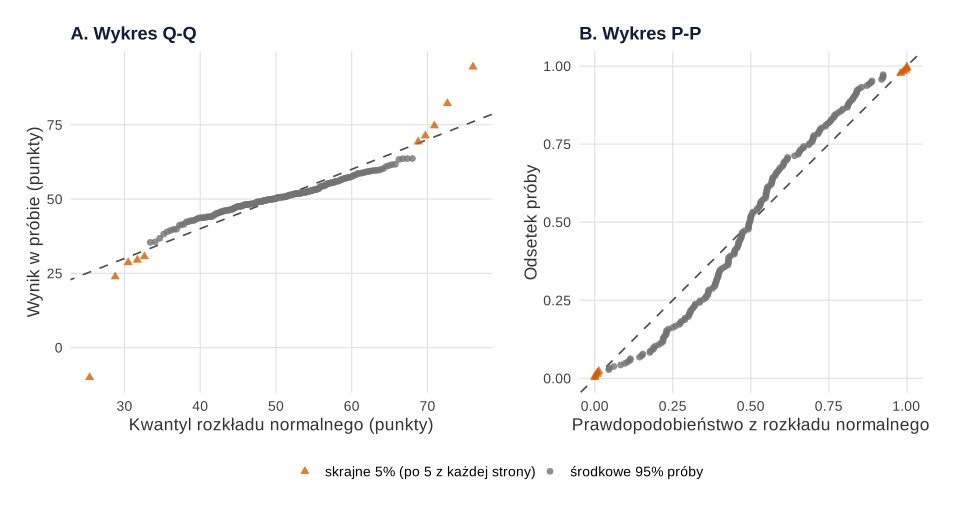
set.seed(735)).Co widać. Oba panele przedstawiają te same obserwacje, a mówią co innego. Na wykresie Q-Q (A) środek próby trzyma się linii (najwyżej 4.38 punktu od niej), a dziesięć skrajnych wyników odbiega aż o 35.44 punktu – widać ciężkie ogony. Na wykresie P-P (B) jest odwrotnie: środkowe punkty układają się w S i oddalają od przekątnej maksymalnie o 0.102 przy około 20% próby, a skrajne wyniki leżą w rogach niemal na przekątnej (odchylenie najwyżej 0.010). To nie dwa różne rozkłady, tylko dwa sposoby rysowania: P-P powiększa środek, Q-Q – ogony.
Na co uważać. Prosty wniosek „punkty blisko przekątnej, więc rozkład jest normalny” bywa na wykresie P-P mylący właśnie w ogonach. Jeśli liczą się skrajne wyniki, np. przy ocenie wartości odstających, sięgnij po wykres Q-Q. Wykres nie mówi też, czy odchylenie ma praktyczne znaczenie dla planowanej analizy.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Nie mylić z Q-Q. Na osiach P-P są prawdopodobieństwa (0–1), na osiach Q-Q – wartości w jednostkach zmiennej. W podpisie napisz, który wykres pokazujesz.
- Parametry z próby. Gdy średnią i odchylenie szacujesz z tych samych danych, punkty leżą bliżej przekątnej, niż gdyby parametry były znane – zwykłe wartości krytyczne K–S nie pasują.
- Wielkość próby. Przy kilkunastu obserwacjach punkty błądzą wokół przekątnej nawet przy normalnym rozkładzie; przy kilku tysiącach widać każde drobne odchylenie. Jak łączyć wykresy z testami, opisuje wpis jak sprawdzić normalność rozkładu.
Wykres P-P w R
Kod symuluje 200 wyników z rozkładu o ciężkich ogonach, liczy współrzędne wykresów P-P i Q-Q, największe odchylenia od przekątnej w środku i w ogonach, statystykę D oraz test Shapiro–Wilka, a na końcu buduje rysunek 1 w ggplot2. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
P-P i Q-Q tej samej próby
R
# Wykres P-P i Q-Q tej samej próby z ciężkimi ogonami (rozkład t o 3 stopniach swobody, dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(srodek = "grey45", ogon = "#D55E00")         # Okabe–Ito; skrajne 5% ma też inny kształt punktu
ksz <- c(srodek = 16, ogon = 17)
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(735)
n <- 200
x <- 50 + 5 * rt(n, df = 3)                          # wynik testu: środek jak w normalnym, ogony cięższe
m <- mean(x); s <- sd(x)                              # rozkład normalny dopasowany do próby
xs <- sort(x)
p_emp <- (seq_len(n) - 0.5) / n                       # odsetek próby do danej obserwacji
p_teor <- pnorm(xs, m, s)                             # P-P: dystrybuanta normalna w punkcie obserwacji
q_teor <- qnorm(p_emp, m, s)                          # Q-Q: kwantyl normalny dla odsetka próby
ogon <- p_emp < 0.025 | p_emp > 0.975                 # 10 najbardziej skrajnych obserwacji
round(c(M = m, SD = s), 2)
round(c(max_odchylenie_PP = max(abs(p_teor - p_emp)), przy_odsetku = p_emp[which.max(abs(p_teor - p_emp))],
        max_PP_w_ogonach = max(abs(p_teor - p_emp)[ogon])), 3)
round(c(max_odchylenie_QQ = max(abs(xs - q_teor)), max_QQ_w_srodku = max(abs(xs - q_teor)[!ogon])), 2)
ks.test(x, "pnorm", m, s)$statistic                  # D Kołmogorowa–Smirnowa (parametry z próby)
shapiro.test(x)

# Rysunek 1: Q-Q (A) i P-P (B) tych samych 200 obserwacji
d <- data.frame(xs, q_teor, p_emp, p_teor, czesc = ifelse(ogon, "ogon", "srodek"))
etyk <- c(srodek = "środkowe 95% próby", ogon = "skrajne 5% (po 5 z każdej strony)")
pA <- ggplot(d, aes(q_teor, xs, colour = czesc, shape = czesc)) +
  geom_abline(intercept = 0, slope = 1, linetype = "dashed", colour = "grey30") +
  geom_point(size = 2, alpha = 0.8) +
  labs(title = "A. Wykres Q-Q", x = "Kwantyl rozkładu normalnego (punkty)", y = "Wynik w próbie (punkty)")
pB <- ggplot(d, aes(p_teor, p_emp, colour = czesc, shape = czesc)) +
  geom_abline(intercept = 0, slope = 1, linetype = "dashed", colour = "grey30") +
  geom_point(size = 2, alpha = 0.8) + coord_equal() +
  labs(title = "B. Wykres P-P", x = "Prawdopodobieństwo z rozkładu normalnego", y = "Odsetek próby")
p1 <- (pA + pB) + plot_layout(guides = "collect") &
  scale_colour_manual(values = kol, labels = etyk, name = NULL) &
  scale_shape_manual(values = ksz, labels = etyk, name = NULL) & motyw
p1
Wynik w R
    M    SD
50.71  9.02
max_odchylenie_PP      przy_odsetku  max_PP_w_ogonach
            0.102             0.198             0.010
max_odchylenie_QQ   max_QQ_w_srodku
            35.44              4.38
        D
0.1045511

	Shapiro-Wilk normality test

data:  x
W = 0.84787, p-value = 3.393e-13
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pnorm(), qnorm(), ks.test() i shapiro.test() z pakietu stats; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wybrać wykres P-P zamiast wykresu Q-Q?
Gdy interesuje cię zgodność w środkowej części rozkładu, np. jego spłaszczenie lub wysmukłość. Do oceny ogonów i obserwacji skrajnych lepszy jest wykres Q-Q, bo P-P ściska je w rogach przy 0 i 1.
Dlaczego na wykresie P-P słabo widać obserwacje odstające?
Oś P-P to prawdopodobieństwa od 0 do 1. Wynik bardzo odległy od średniej i wynik tylko trochę skrajny dostają prawdopodobieństwa bliskie 0 lub 1, więc oba trafiają w ten sam róg wykresu, blisko przekątnej.
Jak narysować wykres P-P w R?
Posortuj dane, policz odsetki (i − 0.5)/n i wartości pnorm() w punktach obserwacji z parametrami z próby, a potem narysuj jedne względem drugich z przekątną, np. plot(pnorm(sort(x), mean(x), sd(x)), ppoints(length(x))); abline(0, 1).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikRozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikTest t przy rozkładzie nienormalnym
Kiedy skośność naprawdę szkodzi testowi t: symulacja w R, test Welcha, bootstrap, test Yuena i Mann–Whitney na jednym przykładzie oraz opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Michael, J. R. (1983). The stabilized probability plot. Biometrika, 70(1), 11–17. https://doi.org/10.1093/biomet/70.1.11
- Wilk, M. B., & Gnanadesikan, R. (1968). Probability plotting methods for the analysis of data. Biometrika, 55(1), 1–17. https://doi.org/10.1093/biomet/55.1.1
Cytowania BibTeX
@article{michael1983stabilized, author={Michael, John R.}, title={{The stabilized probability plot}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={11--17}, doi={10.1093/biomet/70.1.11}}@article{wilk1968probability, author={Wilk, M. B. and Gnanadesikan, R.}, title={{Probability plotting methods for the analysis of data}}, journal={Biometrika}, year={1968}, volume={55}, number={1}, pages={1--17}, doi={10.1093/biomet/55.1.1}}