Co naprawdę ma być normalne
Założenie normalności w teście t nie dotyczy surowych wyników w całej próbie. Dotyczy rozkładu w grupach, a w praktyce przede wszystkim tego, czy średnia z próby ma w przybliżeniu rozkład normalny. Przy kilkudziesięciu osobach w grupie zapewnia to zwykle centralne twierdzenie graniczne, nawet gdy same dane są skośne. Lumley i in. (2002) pokazują, że w dużych próbach test t i regresja liniowa są trafne dla dowolnego rozkładu, a ważniejsze jest pytanie, czy różnica średnich w ogóle odpowiada na pytanie badawcze. Jak sprawdzić rozkład krok po kroku, opisuje wpis jak sprawdzić normalność rozkładu.
Wybieraj od razu test Welcha, a nie klasyczny test Studenta. Nie zakłada równych wariancji i niewiele traci, gdy są równe (Delacre i in., 2017). Wszystkie wersje testu, z wielkością efektu i opisem APA, znajdziesz w poradniku test t Studenta krok po kroku.
Symulacja: kiedy skośność szkodzi
Sprawdziliśmy w R, jak często test t Welcha daje wynik p < .05, gdy obie grupy pochodzą z tej samej populacji, czyli każdy istotny wynik jest fałszywym alarmem. Każdy warunek powtórzono 10 000 razy.
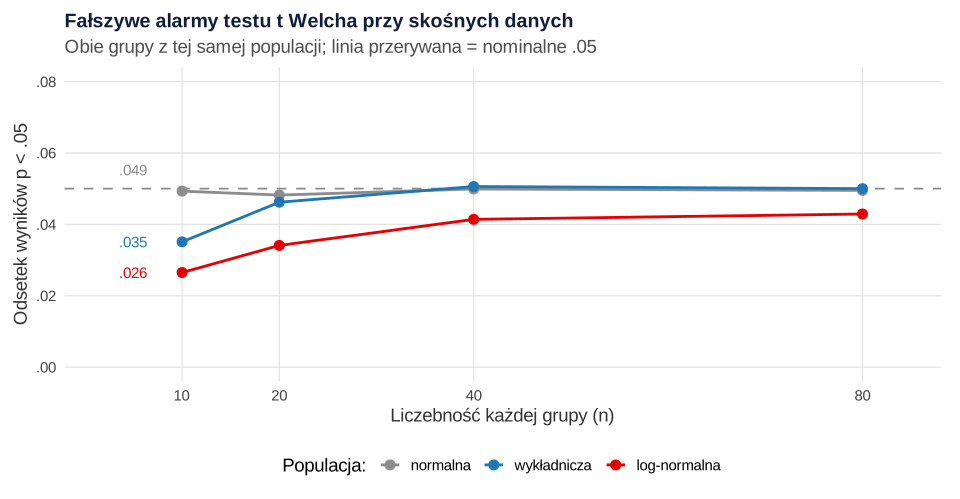
Gdy kształt rozkładu w obu grupach jest taki sam, skośność nie zwiększa liczby fałszywych alarmów. Przy rozkładzie log-normalnym i 10 osobach w grupie odsetek wyniósł .026, a przy 80 osobach .043. Test staje się wtedy ostrożny, czyli traci trochę mocy. Kłopot pojawia się, gdy rozkłady są skośne, a grupy różnią się jednocześnie liczebnością i rozproszeniem. W drugiej symulacji obie grupy miały tę samą średnią, ale 15 osób w grupie o dwa razy większym SD i 45 w drugiej. Test Welcha dał wtedy 12.1% fałszywych alarmów, a test Studenta 16.3%. Podobny wniosek dają szersze symulacje: modele zakładające normalne błędy są odporne w szerokim zakresie warunków, a głównym zagrożeniem są wpływowe obserwacje odstające (Knief i Forstmeier, 2021).
| Sytuacja | Co zrobić |
|---|---|
| Kilkadziesiąt osób w grupie, umiarkowana skośność, podobny kształt w grupach | test t Welcha bez zmian |
| Mała próba (kilkanaście osób) i silna skośność | Welch i dodatkowo bootstrapowy CI albo test Yuena |
| Skośność, nierówne grupy i różne rozproszenie | test Yuena lub bootstrap; porównaj wnioski |
| Kilka skrajnych wartości | sprawdź, skąd się wzięły; średnia ucinana zamiast usuwania |
| Zmienna porządkowa albo pytanie o „typową” osobę, a nie o średnią | test Manna–Whitneya |
Przykład: czas przed ekranem smartfona
Dwie grupy po 30 osób studiujących: po tygodniowym programie ograniczania korzystania ze smartfona i grupa kontrolna (dane symulowane). Wynik to dzienny czas używania telefonu w minutach, który jak większość czasów ma rozkład prawoskośny. W grupie kontrolnej M = 234.23, SD = 126.20, Me = 202.5, skośność 1.05, a w grupie programu M = 161.87, SD = 94.14, Me = 152.5, skośność 2.03. Test Shapiro-Wilka odrzuca normalność w obu grupach (p = .007 i p < .001), ale nie wybieraj testu na tej podstawie. Rochon i in. (2012) pokazali, że taka procedura dwuetapowa zmienia poziom błędu I rodzaju obu testów. Zamiast tego policz test główny i sprawdź, czy inne metody prowadzą do tego samego wniosku.
| Analiza | Co porównuje | Wynik |
|---|---|---|
| Test t Welcha | średnie | różnica 72.37 min, 95% CI [14.73, 130.01], t(53.64) = 2.52, p = .015 |
| Bootstrap percentylowy | średnie | 95% CI [16.33, 128.00] |
| Test Yuena | średnie ucinane 20% | różnica 63.94 min, 95% CI [12.78, 115.11], t(21.81) = 2.59, p = .017 |
| Test t na logarytmach | średnie geometryczne | stosunek 0.70, 95% CI [0.54, 0.92], p = .012 |
| Test Manna–Whitneya | rangi | U = 628, p = .009, rrb = .40 |
Wszystkie analizy wskazują ten sam kierunek i podobną siłę efektu, więc test t Welcha może zostać analizą główną (g = 0.64, 95% CI [0.12, 1.15]), a pozostałe opisz jako analizę wrażliwości. Test Yuena, zaproponowany do porównań średnich ucinanych przy nierównych wariancjach, dobrze się sprawdza przy długich ogonach i wartościach odstających (Yuen, 1974). Test Manna–Whitneya traktuj ostrożniej. Odpowiada na inne pytanie niż test t, a w dużych próbach może dawać bardzo małe p nawet przy równych średnich i medianach, gdy grupy różnią się rozproszeniem (Fagerland, 2012). Kiedy rzeczywiście jest właściwym wyborem, wyjaśnia wpis testy nieparametryczne krok po kroku.
Jak to opisać w pracy
Napisz, jak oceniono rozkład, który test był główny i co pokazała analiza wrażliwości. Nie tłumacz się z wyniku Shapiro-Wilka. Opisz, dlaczego wybrany test jest odpowiedni.
Jeżeli analizy prowadzą do różnych wniosków, opisz to wprost, zamiast wybierać wersję z mniejszym p. Wybór testu do innych układów danych ułatwia przewodnik po testach statystycznych. Jeśli chcesz, żeby ktoś sprawdził Twoją analizę przed oddaniem rozdziału, zobacz ofertę dla studentów.
Test t przy skośnych danych w R
Kod odtwarza wszystkie liczby z tekstu i rysunek. Test Yuena liczy funkcja yuen() z pakietu WRS2, a bootstrap – zwykła pętla replicate(). Przepisy są niezależne.
1. Pięć analiz tych samych danych
R
# B138, przepis 1: test t przy skośnych danych (dane symulowane, set.seed(1387)).
# Dzienny czas korzystania ze smartfona (minuty) u osób studiujących: grupa po tygodniowym
# programie „cyfrowego detoksu” (n = 30) i grupa kontrolna (n = 30). Rozkład czasu jest prawoskośny.
suppressPackageStartupMessages({ library(WRS2); library(effectsize); library(psych) })
set.seed(1387)
dane <- data.frame(grupa = factor(rep(c("kontrolna", "detoks"), each = 30), levels = c("kontrolna", "detoks")),
                   minuty = round(c(rlnorm(30, log(200), 0.55), rlnorm(30, log(150), 0.55))))
opis <- function(x) round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x),
                            IQR = IQR(x), skos = psych::skew(x)), 2)
print(rbind(kontrolna = opis(dane$minuty[dane$grupa == "kontrolna"]),
            detoks = opis(dane$minuty[dane$grupa == "detoks"])))
cat("\nShapiro–Wilk w grupach (tylko informacyjnie):\n")
print(sapply(split(dane$minuty, dane$grupa), function(x) round(shapiro.test(x)$p.value, 4)))

cat("\n1) Test t Welcha:\n"); print(t.test(minuty ~ grupa, data = dane))
print(hedges_g(minuty ~ grupa, data = dane, pooled_sd = FALSE))

cat("\n2) Bootstrapowy 95% CI dla różnicy średnich (percentylowy, 10 000 prób):\n")
set.seed(13872)
k <- dane$minuty[dane$grupa == "kontrolna"]; d <- dane$minuty[dane$grupa == "detoks"]
rozn <- replicate(10000, mean(sample(k, replace = TRUE)) - mean(sample(d, replace = TRUE)))
cat("różnica =", round(mean(k) - mean(d), 2), " 95% CI:", round(quantile(rozn, c(.025, .975)), 2), "\n")

cat("\n3) Test Yuena (średnie ucinane 20%):\n"); print(yuen(minuty ~ grupa, data = dane, tr = 0.2))
cat("Średnie ucinane 20%:", round(tapply(dane$minuty, dane$grupa, mean, trim = 0.2), 2), "\n")

cat("\n4) Test t Welcha na logarytmach (porównanie średnich geometrycznych):\n")
tl <- t.test(log(minuty) ~ grupa, data = dane); print(tl)
cat("Stosunek średnich geometrycznych (detoks / kontrolna):", round(exp(-diff(tl$estimate)) ^ -1, 3),
    " 95% CI:", round(rev(exp(-tl$conf.int)), 3), "\n")

cat("\n5) Test Manna–Whitneya:\n"); print(wilcox.test(minuty ~ grupa, data = dane, exact = FALSE))
print(rank_biserial(minuty ~ grupa, data = dane))
cat("\nPakiety: R", as.character(getRversion()), "WRS2", as.character(packageVersion("WRS2")),
    "effectsize", as.character(packageVersion("effectsize")), "psych", as.character(packageVersion("psych")), "\n")
Wynik w R
           n      M     SD    Me   IQR skos
kontrolna 30 234.23 126.20 202.5 168.0 1.05
detoks    30 161.87  94.14 152.5  56.5 2.03

Shapiro–Wilk w grupach (tylko informacyjnie):
kontrolna    detoks
   0.0072    0.0000

1) Test t Welcha:

	Welch Two Sample t-test

data:  minuty by grupa
t = 2.5175, df = 53.643, p-value = 0.01484
alternative hypothesis: true difference in means between group kontrolna and group detoks is not equal to 0
95 percent confidence interval:
  14.72571 130.00762
sample estimates:
mean in group kontrolna    mean in group detoks
               234.2333                161.8667

Hedges' g |       95% CI
------------------------
0.64      | [0.12, 1.15]

- Estimated using un-pooled SD.
2) Bootstrapowy 95% CI dla różnicy średnich (percentylowy, 10 000 prób):
różnica = 72.37  95% CI: 16.33 128

3) Test Yuena (średnie ucinane 20%):
Call:
yuen(formula = minuty ~ grupa, data = dane, tr = 0.2)

Test statistic: 2.5934 (df = 21.81), p-value = 0.01665

Trimmed mean difference:  63.94444
95 percent confidence interval:
12.7835     115.1053

Explanatory measure of effect size: 0.55

Średnie ucinane 20%: 208.5 144.56

4) Test t Welcha na logarytmach (porównanie średnich geometrycznych):

	Welch Two Sample t-test

data:  log(minuty) by grupa
t = 2.6027, df = 56.798, p-value = 0.01178
alternative hypothesis: true difference in means between group kontrolna and group detoks is not equal to 0
95 percent confidence interval:
 0.08124544 0.62354950
sample estimates:
mean in group kontrolna    mean in group detoks
               5.316449                4.964052

Stosunek średnich geometrycznych (detoks / kontrolna): 0.703  95% CI: 0.536 0.922

5) Test Manna–Whitneya:

	Wilcoxon rank sum test with continuity correction

data:  minuty by grupa
W = 628, p-value = 0.008676
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.40              | [0.12, 0.61]

Pakiety: R 4.5.3 WRS2 1.1.7 effectsize 1.0.2 psych 2.6.5
2. Symulacja fałszywych alarmów i rysunek
R
# B138, przepis 2: jak często test t Welcha daje fałszywy alarm przy skośnych danych?
# Obie grupy pochodzą z TEJ SAMEJ populacji (H0 prawdziwa), więc idealny odsetek wyników p < .05 to 5%.
# Populacje: normalna, wykładnicza (skośność 2) i logarytmiczno-normalna (sdlog = 1, skośność ok. 6.2).
# 10 000 powtórzeń na warunek, set.seed(1388).
library(ggplot2)
set.seed(1388)
R <- 10000
populacje <- list(normalna = function(n) rnorm(n), `wykładnicza` = function(n) rexp(n),
                  `log-normalna` = function(n) rlnorm(n, 0, 1))
wyniki <- expand.grid(n = c(10, 20, 40, 80), populacja = names(populacje), stringsAsFactors = FALSE)
wyniki$alfa_t <- mapply(function(n, pop) {
  f <- populacje[[pop]]
  mean(replicate(R, t.test(f(n), f(n))$p.value < .05))
}, wyniki$n, wyniki$populacja)
wyniki$se <- sqrt(.05 * .95 / R)
print(transform(wyniki, alfa_t = round(alfa_t, 3), se = round(se, 4)))

# Nierówne liczebności i różne wariancje przy tym samym kształcie: Welch a klasyczny test Studenta
set.seed(13882)
pr <- replicate(R, { a <- rlnorm(15, 0, 1) * 2; b <- rlnorm(45, 0, 1)
  a <- a - 2 * exp(0.5); b <- b - exp(0.5)          # obie populacje mają średnią 0
  c(welch = t.test(a, b)$p.value < .05, student = t.test(a, b, var.equal = TRUE)$p.value < .05) })
cat("\nRówne średnie, n = 15 i 45, mniejsza grupa ma 2 razy większe SD (log-normalna):\n")
print(round(rowMeans(pr), 3))

wyniki$populacja <- factor(wyniki$populacja, levels = names(populacje))
p <- ggplot(wyniki, aes(n, alfa_t, colour = populacja)) +
  geom_hline(yintercept = .05, linetype = "dashed", colour = KOLORY[["neutralny"]]) +
  geom_line(linewidth = 1) + geom_point(size = 3) +
  geom_text(data = subset(wyniki, n == 10), aes(y = alfa_t + ifelse(populacja == "normalna", .006, 0),
                label = sub("^0", "", sprintf("%.3f", alfa_t))), nudge_x = -5, size = 4, show.legend = FALSE) +
  scale_colour_manual(values = c(KOLORY[["dane"]], KOLORY[["drugi"]], KOLORY[["akcent"]]), name = "Populacja:") +
  scale_x_continuous(breaks = c(10, 20, 40, 80), limits = c(2, 84)) +
  scale_y_continuous(limits = c(0, .08), breaks = seq(0, .08, .02), labels = function(x) sub("^0", "", sprintf("%.2f", x))) +
  labs(title = "Fałszywe alarmy testu t Welcha przy skośnych danych",
       subtitle = "Obie grupy z tej samej populacji; linia przerywana = nominalne .05",
       x = "Liczebność każdej grupy (n)", y = "Odsetek wyników p < .05") +
  theme_minimal(base_size = 12)
ggsave("test-t-rozklad-nienormalny-symulacja.svg", p, width = 10, height = 5.2)
cat("Pakiety: R", as.character(getRversion()), "ggplot2", as.character(packageVersion("ggplot2")), "\n")
Wynik w R
    n    populacja alfa_t     se
1  10     normalna  0.049 0.0022
2  20     normalna  0.048 0.0022
3  40     normalna  0.050 0.0022
4  80     normalna  0.050 0.0022
5  10  wykładnicza  0.035 0.0022
6  20  wykładnicza  0.046 0.0022
7  40  wykładnicza  0.051 0.0022
8  80  wykładnicza  0.050 0.0022
9  10 log-normalna  0.026 0.0022
10 20 log-normalna  0.034 0.0022
11 40 log-normalna  0.041 0.0022
12 80 log-normalna  0.043 0.0022

Równe średnie, n = 15 i 45, mniejsza grupa ma 2 razy większe SD (log-normalna):
  welch student
  0.121   0.163
Zapisano ../test-t-rozklad-nienormalny-symulacja.svg: w HTML width="1000" height="520" (8 KB)
Pakiety: R 4.5.3 ggplot2 4.0.2
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test() i shapiro.test() z pakietu stats). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- WRS2 (wersja 1.1.7): Mair, P., & Wilcox, R. (2020). Robust statistical methods in R using the WRS2 package. Behavior Research Methods, 52(2), 464–488. https://doi.org/10.3758/s13428-019-01246-w
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Od ilu osób w grupie test t działa przy rozkładzie skośnym?
Nie ma jednej granicy. W symulacji z tego wpisu przy kilkudziesięciu osobach w grupie test t Welcha trzymał poziom fałszywych alarmów blisko .05 nawet przy silnej skośności, o ile obie grupy miały podobny kształt rozkładu. Przy kilkunastu osobach, silnej skośności lub nierównych grupach dodaj bootstrapowy CI albo test Yuena.
Czy brak normalności oznacza, że muszę użyć testu Manna–Whitneya?
Nie. Test Manna–Whitneya nie porównuje średnich, tylko rozkłady rang, więc odpowiada na inne pytanie. Wybierz go, gdy zmienna jest porządkowa albo interesuje Cię przesunięcie całego rozkładu, a nie dlatego, że test Shapiro-Wilka dał p < .05.
Co to jest test Yuena i kiedy go użyć?
To wersja testu t Welcha dla średnich ucinanych, np. po odrzuceniu 20% najniższych i 20% najwyższych wyników w każdej grupie. Sprawdza się przy długich ogonach i wartościach odstających (Yuen, 1974). W R liczy go funkcja yuen() z pakietu WRS2.
Jak uzasadnić w pracy użycie testu t mimo braku normalności?
Napisz, że rozkład oceniono wykresem i skośnością, podaj liczebność grup i odporność testu Welcha na umiarkowaną nienormalność, a następnie przytocz wynik analizy wrażliwości, np. bootstrapu. Jeśli obie analizy dają ten sam wniosek, to wystarczy.
Powiązane hasła
Przeczytaj też
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikTesty statystyczne – przewodnik po wyborze
Schemat wyboru testu i osiem etapów od hipotezy do zapisu APA: test t, ANOVA, testy nieparametryczne, chi-kwadrat, korelacje, regresja i poprawki.
Czytaj →Rozkład wyszedł nienormalny i nie wiesz, czy możesz zostać przy teście t?
Ocenimy rozkład w Twoich danych, policzymy test główny i analizę wrażliwości i wyjaśnimy wyniki tak, żebyś umiał(a) uzasadnić wybór testu na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies—a paradox of statistical practice? BMC Medical Research Methodology, 12(1), Article 78. https://doi.org/10.1186/1471-2288-12-78 ● Otwarty dostęp
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Rochon, J., Gondan, M., & Kieser, M. (2012). To test or not to test: Preliminary assessment of normality when comparing two independent samples. BMC Medical Research Methodology, 12(1), Article 81. https://doi.org/10.1186/1471-2288-12-81 ● Otwarty dostęp
- Yuen, K. K. (1974). The two-sample trimmed t for unequal population variances. Biometrika, 61(1), 165–170. https://doi.org/10.1093/biomet/61.1.165
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{fagerland2012ttests, author={Fagerland, Morten W.}, title={{t-tests, non-parametric tests, and large studies—a paradox of statistical practice?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={78}, doi={10.1186/1471-2288-12-78}}@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{rochon2012test, author={Rochon, Justine and Gondan, Matthias and Kieser, Meinhard}, title={{To test or not to test: Preliminary assessment of normality when comparing two independent samples}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={81}, doi={10.1186/1471-2288-12-81}}@article{yuen1974two, author={Yuen, Karen K.}, title={{The two-sample trimmed t for unequal population variances}}, journal={Biometrika}, year={1974}, volume={61}, number={1}, pages={165--170}, doi={10.1093/biomet/61.1.165}}