„Sprawdź normalność” – od czego zacząć?
Zebrane dane, gotowa hipoteza i uwaga promotora albo recenzenta: „a czy sprawdziła Pani normalność rozkładu?”. Najczęstsza reakcja to test Shapiro-Wilka dla każdej zmiennej i reguła „jeśli p < .05, to test nieparametryczny”. Ta procedura jest prosta, ale ma trzy wady: sprawdza często nie ten rozkład, który trzeba, w dużych próbach alarmuje bez potrzeby, a w małych – milczy wtedy, gdy problem jest prawdziwy.
Nie jesteś w tym sam. Hoekstra i in. (2012) poprosili 30 badaczy o analizę fikcyjnych danych „jak własnych”: założenia znanych technik sprawdzano rzadko, a jeśli już – zwykle samym testem statystycznym, a wywiady ujawniły ogólny brak wiedzy o tym, jak i czy je sprawdzać. W przeglądzie 12 czasopism psychologii klinicznej Ernst i Albers (2017) stwierdzili, że 92% artykułów stosujących regresję liniową nie raportowało jasno sprawdzania założeń, a w 4% za konieczne założenie uznawano normalność samych zmiennych zamiast reszt.
W tym poradniku przechodzimy przez całą procedurę na jednym przykładzie (dane symulowane): 100 studentów wypełniło skalę lęku uogólnionego GAD-7 (0–21 punktów); 45 osób deklaruje regularną aktywność fizyczną, a 55 – nie. Hipoteza brzmi: osoby niećwiczące mają wyższy średni poziom lęku. Wszystkie liczby, tabele i rysunki pochodzą z kodu z sekcji Przykład w R. Plan działania:
- Ustal, co właściwie ma mieć rozkład normalny.
- Obejrzyj histogram i wykres Q-Q – najlepiej reszt modelu.
- Policz skośność i kurtozę z błędami standardowymi.
- Wykonaj test normalności – ale traktuj go jako uzupełnienie.
- Oceń, czy nienormalność może zmienić wnioski, i wybierz strategię.
Krok 1. Ustal, co ma mieć rozkład normalny
Założenie normalności w teście t, ANOVA i regresji nie dotyczy surowych zmiennych, tylko rozkładu wyników wokół tego, co przewiduje model – czyli reszt. Williams i in. (2013) przypominają, że regresja metodą najmniejszych kwadratów wymaga – zwłaszcza w małych próbach – normalności błędów, a nie zmiennej zależnej czy predyktorów. Tabela pokazuje, co sprawdzić w typowych analizach:
| Analiza | Co ma mieć rozkład zbliżony do normalnego | Uwagi |
|---|---|---|
| Test t dla jednej próby | wyniki w próbie | w większych próbach wystarcza normalność rozkładu średniej |
| Test t dla prób niezależnych, ANOVA | wyniki w każdej grupie, czyli reszty (wynik − średnia grupy) | rozkład całej próby może być dwugarbny tylko dlatego, że grupy się różnią |
| Test t dla prób zależnych | różnice między pomiarami (po − przed) | rozkłady pomiarów osobno nie mają znaczenia |
| Regresja liniowa (także moderacja i mediacja w regresji) | reszty modelu | predyktory mogą mieć dowolny rozkład, np. zero-jedynkowy |
| Korelacja Pearsona | obie zmienne i ich związek | ważne dla testu i przedziału ufności w małych próbach; groźniejsze są obserwacje odstające |
| Testy chi-kwadrat, testy nieparametryczne | – | normalność nie jest założeniem |
Osobną sprawą jest rodzaj skali. Suma lub średnia z kilku–kilkunastu pozycji skali Likerta ma zwykle rozkład znacznie bliższy normalnemu niż odpowiedzi na pojedyncze pytanie, które przyjmują tylko kilka wartości. Rozkład zniekształcają też granice skali: gdy wiele osób uzyskuje wynik minimalny lub maksymalny, pojawia się efekt podłogi lub sufitu. Wtedy problemem nie jest „brak normalności”, tylko to, że pomiar przestaje różnicować osoby – i tego nie naprawi żaden test ani transformacja.
Dlaczego tak? Testy parametryczne wnioskują o średnich i współczynnikach, a nie o pojedynczych wynikach. Rozkład średnich z prób zbliża się do normalnego wraz z liczebnością, nawet gdy same wyniki są skośne – to centralne twierdzenie graniczne. Lumley i in. (2002) pokazują, że w dużych próbach test t i regresja liniowa są trafne przy dowolnym rozkładzie zmiennej wynikowej, a Knief i Forstmeier (2021) w obszernych symulacjach stwierdzili, że modele zakładające normalne błędy są odporne na nienormalność w szerokim zakresie warunków. Wyjątkiem w ich symulacjach były dane z wpływowymi obserwacjami odstającymi oceniane przy surowym poziomie alfa.
W naszym przykładzie porównujemy dwie grupy, więc sprawdzamy rozkład wyników w każdej grupie – a dokładniej reszty: wynik każdej osoby minus średnia jej grupy.
Gdy model ma kilka predyktorów – w regresji wielorakiej, ANCOVA, analizie moderacji czy ANOVA wieloczynnikowej – reszty pochodzą z pełnego modelu. Najpierw dopasuj model ze wszystkimi zmiennymi, a dopiero potem oceniaj jego reszty; sprawdzanie każdej zmiennej osobno niewiele wtedy mówi. W modelach równań strukturalnych szacowanych metodą największej wiarygodności znaczenie ma z kolei normalność wielowymiarowa, a przy jej braku stosuje się odporne estymatory, np. MLR.
Krok 2. Obejrzyj histogram i wykres Q-Q reszt
Zacznij od wykresów, bo tylko one pokazują, jak rozkład odbiega od normalnego. Histogram pokazuje kształt, a wykres kwantylowy Q-Q – zwłaszcza ogony. Rysunek 1 pokazuje oba dla naszych danych.
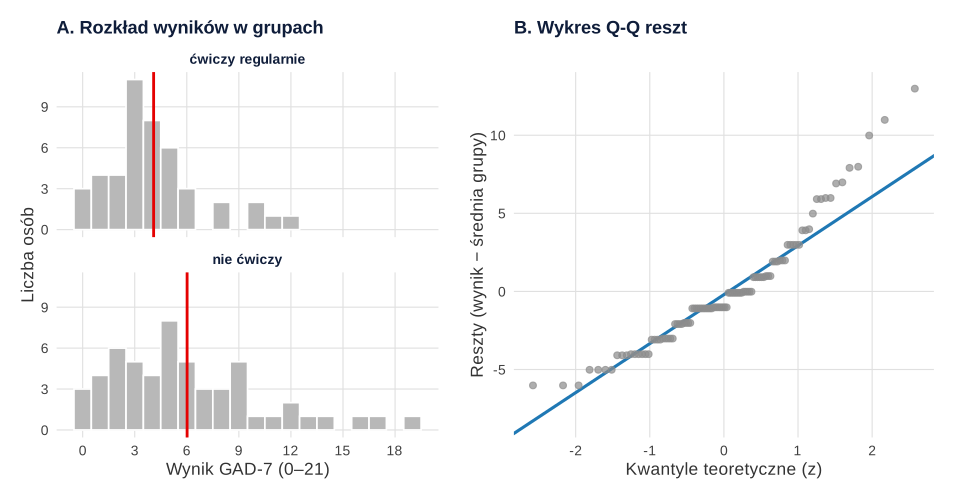
Oba histogramy są prawostronnie skośne: większość osób ma niskie wyniki, a nieliczne – wysokie. To typowy obraz skal objawów w próbach nieklinicznych, wzmocniony przez granicę skali (wynik nie może być niższy niż 0). Na wykresie Q-Q punkty tworzą łuk wygięty w górę, a prawy koniec wyraźnie odchodzi nad linię – to podpis prawostronnej skośności. Poziome „schodki” wynikają z tego, że wyniki są liczbami całkowitymi.
Na co patrzeć na wykresach:
- łuk (oba końce po tej samej stronie linii) – skośność;
- kształt litery S – ciężkie albo lekkie ogony, czyli nietypowa kurtoza;
- pojedyncze punkty daleko od linii – możliwe obserwacje odstające albo błędy w danych (zob. wartości odstające: jak je wykryć);
- dwa garby na histogramie – często mieszanina grup, które powinny być w modelu.
Ocena „na oko” ma swoje granice. Kim (2012) zwraca uwagę, że w małych próbach nawet dane z populacji normalnej rzadko wyglądają normalnie, więc ocena wzrokowa ma sens raczej przy n > 50. Przy kilkunastu osobach oceniaj tylko wyraźne, systematyczne wzorce.
Krok 3. Policz skośność i kurtozę – z błędem standardowym
Liczby uzupełniają wykres. Skośność opisuje asymetrię, a kurtoza nadmiarowa – ciężkość ogonów; dla rozkładu normalnego obie wynoszą 0. W naszych danych:
| Grupa | n | M | SD | Mediana | Min–Maks | Skośność | Kurtoza |
|---|---|---|---|---|---|---|---|
| Ćwiczy regularnie | 45 | 4.09 | 2.80 | 4 | 0–12 | 1.09 | 1.19 |
| Nie ćwiczy | 55 | 6.02 | 4.41 | 5 | 0–19 | 0.99 | 0.76 |
| Reszty modelu (obie grupy) | 100 | 0 | – | – | – | 1.05 | 1.35 |
Kim (2013) proponuje oceniać skośność i kurtozę razem z ich błędami standardowymi i dobierać kryterium do liczebności próby:
| Liczebność | Kryterium znacznego odejścia od normalności |
|---|---|
| n < 50 | |z| > 1.96, gdzie z = skośność / SE (tak samo dla kurtozy) |
| n od 50 do 300 | |z| > 3.29 |
| n > 300 | histogram i same wartości: |skośność| > 2 albo kurtoza (niepomniejszona o 3) > 7, czyli kurtoza nadmiarowa > 4 |
Dla reszt w naszym przykładzie (n = 100) skośność wynosi 1.05 przy SE = 0.24, więc z = 4.37 – powyżej progu 3.29. Kurtoza nadmiarowa to 1.35 przy SE = 0.48, czyli z = 2.82 – poniżej progu. Wniosek: rozkład jest wyraźnie prawostronnie skośny, ale ogony nie są niepokojąco ciężkie. Szczegóły obliczeń i różnice między estymatorami w programach znajdziesz w hasłach o skośności i kurtozie.
Nienormalność to w danych psychologicznych norma. Cain i in. (2017) przeanalizowali 1567 rozkładów jednowymiarowych z artykułów w Psychological Science i American Educational Research Journal: 74% odbiegało od normalności. Autorzy zalecają, by skośność i kurtozę raportować rutynowo – najlepiej w tabeli statystyk opisowych.
Krok 4. Test Shapiro-Wilka – tylko jako uzupełnienie
Test Shapiro-Wilka sprawdza hipotezę zerową, że dane pochodzą z populacji o rozkładzie normalnym. W naszym przykładzie dla reszt: W = .93, p < .001; osobno w grupach: p < .001 i p = .002. Test Kołmogorowa-Smirnowa z poprawką Lillieforsa daje ten sam wniosek: D = .15, p < .001. Rozkład istotnie odbiega od normalnego – ale to jeszcze nie znaczy, że trzeba zmieniać analizę.
Ghasemi i Zahediasl (2012) zalecają test Shapiro-Wilka jako mocniejszy od testu Kołmogorowa-Smirnowa (różnice między nimi pokazujemy w haśle test Kołmogorowa-Smirnowa), ale zwracają uwagę na podstawowy problem wszystkich testów normalności. W małych próbach mają one małą moc, więc dane zwykle je „przechodzą”, a w dużych wykrywają nawet drobne odstępstwa, które nie wpływają na wyniki testów parametrycznych. Kim (2012) dodaje, że formalne testy bywają zawodne w dużych próbach (n > 300). Rysunek 2 pokazuje, jak bardzo te dwa światy się rozjeżdżają.
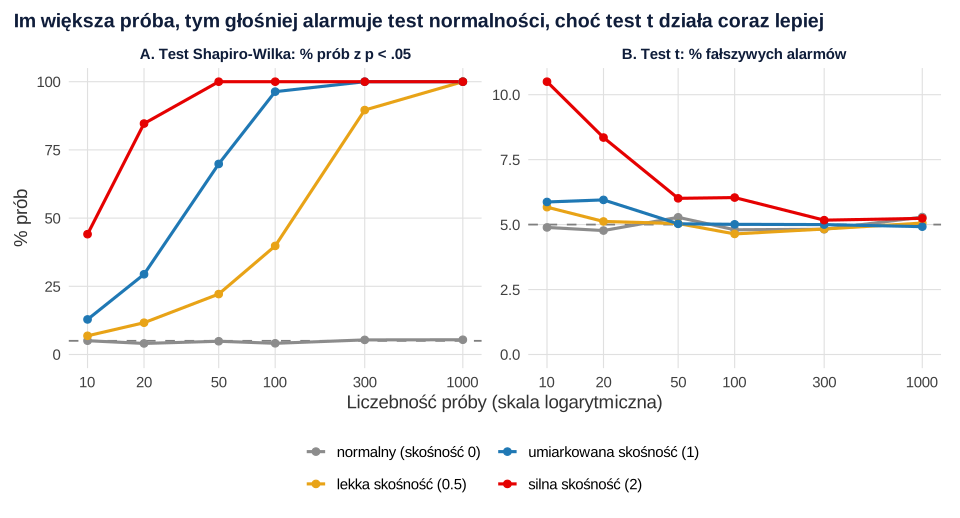
W panelu B użyliśmy testu t dla jednej próby, bo to on najbardziej „czuje” skośność – tak samo działa test t dla prób zależnych liczony na różnicach przed–po. Wnioski:
- Przy 10 osobach i silnej skośności (2) test Shapiro-Wilka wykrył problem tylko w 44.1% prób, choć test t dawał wtedy 10.5% fałszywych alarmów zamiast 5%. Test normalności milczy więc najczęściej tam, gdzie problem jest prawdziwy.
- Przy 1000 osobach i lekkiej skośności (0.5) test Shapiro-Wilka „alarmował” w 100% prób, a test t dawał 5.1% fałszywych alarmów – dokładnie tyle, ile powinien.
- Umiarkowana skośność (1) przy 100 osobach: test normalności odrzucał hipotezę w 96.4% prób, a test t miał 5.0% fałszywych alarmów.
Istotny wynik testu normalności mówi więc głównie o liczebności próby, a nie o tym, czy analiza jest zagrożona. Dlatego decyzję opieraj na wykresach, wielkości skośności i liczebności, a test podawaj jako informację dodatkową – wielu recenzentów i promotorów oczekuje jego wyniku, więc warto go zamieścić, ale z komentarzem, co z niego wynika (a co nie).
Krok 5. Oceń, czy nienormalność może zmienić wnioski
Klasyczne testy na średnich są na nienormalność zaskakująco odporne. Blanca i in. (2017) w symulacji Monte Carlo z trzema grupami i rozkładami typowymi dla nauk o zdrowiu i nauk społecznych pokazali, że test F zachował poprawny poziom błędu I rodzaju we wszystkich badanych warunkach – przy równych i nierównych liczebnościach. Ważniejsze od samego kształtu rozkładu bywają inne problemy:
| Sytuacja | Czy to groźne? | Co zrobić |
|---|---|---|
| Umiarkowana skośność, grupy po kilkadziesiąt osób | zwykle nie | test parametryczny (najlepiej Welcha), opis decyzji w pracy |
| Silna skośność przy małych grupach (kilkanaście osób) | tak – za dużo fałszywych alarmów i zbyt wąskie przedziały | metody odporne, bootstrap, test nieparametryczny |
| Pojedyncze skrajne wyniki | tak – mogą „robić” wynik | sprawdź dane; analiza z odstającymi i bez nich, metody odporne |
| Nierówne wariancje i nierówne grupy | tak – często bardziej niż nienormalność | test Welcha; zob. homogeniczność wariancji |
| Zmienna porządkowa (jedno pytanie, kilka kategorii) | to nie problem rozkładu, tylko skali | test rangowy albo regresja porządkowa |
| Liczby zdarzeń z wieloma zerami | tak – model liniowy źle opisuje takie dane | regresja Poissona lub ujemna dwumianowa |
W naszym przykładzie grupy liczą 45 i 55 osób, skośność reszt wynosi około 1, a skrajne wyniki (do 19 punktów na skali 0–21) są prawdopodobne w tej populacji, więc nie ma powodu ich usuwać. Analizą główną jest test t Welcha, który nie wymaga równych wariancji – tu ma to znaczenie, bo odchylenia standardowe grup wynoszą 2.80 i 4.41. Żeby pokazać, że wniosek nie zależy od wyboru metody, wykonujemy też analizę wrażliwości.
Mała próba: co zrobić, gdy masz kilkanaście osób?
To najtrudniejsza sytuacja, bo wszystkie narzędzia diagnostyczne tracą wtedy ostrość. Wykres Q-Q kilkunastu punktów „faluje” nawet przy danych idealnie normalnych, skośność i kurtoza mają duże błędy standardowe, a test Shapiro-Wilka – małą moc: w naszej symulacji przy 10 osobach wykrył silną skośność tylko w 44.1% prób. Jednocześnie właśnie przy małych grupach silna skośność naprawdę szkodzi testowi t (10.5% fałszywych alarmów zamiast 5%).
Co w takiej sytuacji robić?
- Korzystaj z wiedzy o zmiennej, a nie tylko z danych. Czasy reakcji, liczba objawów czy liczba zdarzeń są zwykle prawostronnie skośne, a sumy wielu pozycji skali – zbliżone do symetrycznych. Taką wiedzę (z literatury, z badania pilotażowego) wykorzystaj przy planowaniu analizy.
- Planuj analizę odporną na skośność, jeśli spodziewasz się asymetrii: test rangowy dla danych porządkowych, średnie przycięte przy ciężkich ogonach, model dla liczebności przy zliczeniach.
- Raportuj oszacowania z przedziałami ufności i pokazuj surowe dane na wykresie – przy kilkunastu osobach czytelnik powinien widzieć każdy punkt.
- Traktuj wynik ostrożnie. Mała próba to także mała moc i szerokie przedziały ufności, niezależnie od wybranego testu. Jeśli to możliwe, potraktuj badanie jak pilotażowe i zaplanuj liczebność kolejnego.
Co zrobić, gdy rozkład nie jest normalny? Sześć strategii
Pek i in. (2018) przejrzeli 61 podręczników statystyki i wyróżnili co najmniej osiem sposobów radzenia sobie z nienormalnością. Uporządkowali je według tego, czy podejście pozostaje w ramach modelu liniowego, czy zmienia dane, i czy traktuje nienormalność jako informację o zjawisku, czy jako zakłócenie. W pracy dyplomowej najczęściej przydadzą Ci się te strategie:
| Strategia | Kiedy | Na co uważać |
|---|---|---|
| 1. Zostań przy teście parametrycznym (najlepiej w wersji Welcha) | grupy po kilkadziesiąt osób, umiarkowana skośność, brak odstających | opisz ocenę założeń; zob. testy parametryczne |
| 2. Transformacja (logarytm, pierwiastek) | prawostronna skośność, rozrzut rośnie ze średnią (np. czasy reakcji) | zmienia pytanie (np. średnie geometryczne), wymaga stałej przy zerach, może „przekorygować” rozkład |
| 3. Metody odporne (średnie przycięte, test Yuena) | ciężkie ogony, obserwacje odstające | porównujesz średnie przycięte, a nie zwykłe – napisz to wprost |
| 4. Bootstrap | gdy chcesz zostać przy średnich, ale nie ufasz rozkładowi t | potrzebuje rozsądnej liczebności; nie naprawia zależności obserwacji |
| 5. Test nieparametryczny | dane porządkowe, małe grupy, pytanie „która grupa ma zwykle wyższe wyniki” | testuje co innego niż różnicę średnich – zob. testy nieparametryczne |
| 6. Model dopasowany do rozkładu | liczby zdarzeń, czasy, skale porządkowe | bardziej złożona interpretacja; skonsultuj wybór z teorią |
Kilka komentarzy:
- Metody odporne nie są egzotyką. Wilcox i Keselman (2003) pokazują, że porównania oparte na odpornych miarach położenia, np. średnich przyciętych, mogą znacząco zwiększyć moc i trafność w porównaniu z klasycznym testem t i ANOVA na średnich. Field i Wilcox (2017) przeglądają skutki naruszeń założeń modelu liniowego, pokazują, że dane psychologiczne częściej niż rzadziej je naruszają, i podają gotowe samouczki metod odpornych w R.
- Transformacja to nie „naprawa danych”, tylko zmiana pytania. Po logarytmowaniu porównujesz średnie geometryczne, a wynik trzeba przeliczyć z powrotem na skalę oryginalną. Knief i Forstmeier (2021) uznają transformację za często wskazaną, ale nasz przykład pokazuje, że nie zawsze pomaga. Przykłady transformacji czasu reakcji znajdziesz w haśle skośność.
- Test nieparametryczny nie jest „bezpieczniejszą wersją” testu t. Test Manna-Whitneya sprawdza, czy wyniki jednej grupy są zwykle wyższe, i może być istotny nawet przy równych medianach – przykład pokazujemy w haśle o testach nieparametrycznych.
Przykład: analiza wrażliwości na danych o lęku
Hipoteza dotyczy różnicy średnich, więc analizą główną jest test t Welcha. Jako analizy wrażliwości – najlepiej zaplanowane z góry, np. w prerejestracji – liczymy cztery inne warianty:
| Metoda | Co porównuje | Wynik |
|---|---|---|
| Test t Welcha (analiza główna) | średnie | różnica 1.93 pkt, 95% CI [0.49, 3.37], t(92.76) = 2.66, p = .009, d = 0.52, 95% CI [0.13, 0.91] |
| Bootstrap BCa (10 000 prób) | średnie | różnica 1.93 pkt, 95% CI [0.56, 3.36] |
| Test Yuena (średnie przycięte 20%) | średnie przycięte: 5.36 i 3.67 | różnica 1.70 pkt, 95% CI [0.32, 3.07], t(45.78) = 2.48, p = .017 |
| Test t Welcha na log(x + 1) | średnie geometryczne | iloraz 1.30, 95% CI [1.00, 1.69], t(97.90) = 1.99, p = .050 |
| Test U Manna-Whitneya | rozkłady rang | U = 1558, p = .026, r = .26, 95% CI [.04, .46] |
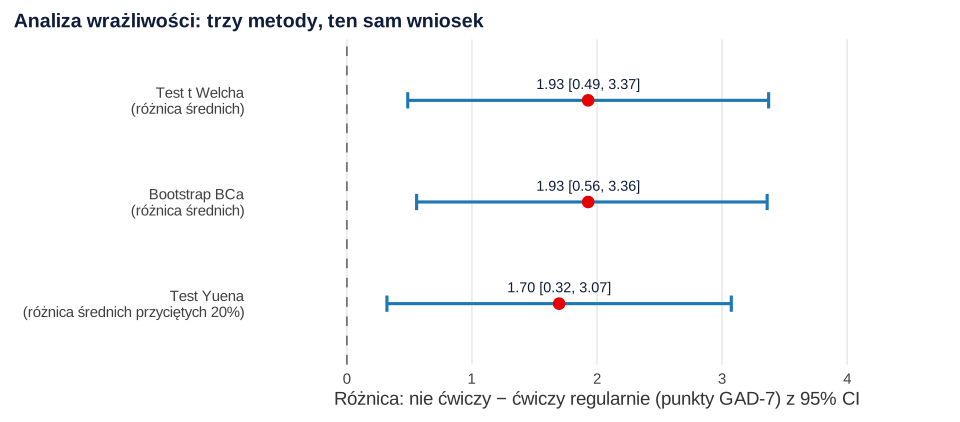
Trzy metody na skali oryginalnej dają spójny obraz: osoby niećwiczące mają wyniki GAD-7 wyższe o mniej więcej 1.7–1.9 punktu, a żaden przedział ufności nie obejmuje zera. Test Manna-Whitneya prowadzi do tego samego wniosku jakościowego. Wyróżnia się transformacja logarytmiczna: wynik jest na granicy istotności (p = .050), a reszty po transformacji nadal odbiegają od normalności – tym razem są lewostronnie skośne (skośność −0.64; test Shapiro-Wilka: W = .96, p = .004). Logarytm „przekorygował” rozkład: przy wielu niskich wynikach i dodanej stałej 1 ściska prawy ogon, ale rozciąga lewy. To dobra ilustracja, że transformacja nie jest automatycznym lekarstwem.
W pracy wystarczy podać wynik testu Welcha i jedno zdanie o analizie wrażliwości. Jeśli metody dają sprzeczne wnioski, opisz to uczciwie – sprzeczność też jest informacją o danych. Nie wybieraj natomiast po fakcie wariantu, który dał „najlepsze” p – to p-hacking.
Dlaczego nie wybierać testu na podstawie testu normalności?
Popularna procedura dwuetapowa brzmi: „najpierw test Shapiro-Wilka; jeśli nieistotny – test t, jeśli istotny – test Manna-Whitneya”. Rochon i in. (2012) sprawdzili ją w symulacji dla dwóch niezależnych grup. Wstępne testowanie normalności poważnie zmieniało warunkowe poziomy błędu I rodzaju zarówno testu t, jak i testu Manna-Whitneya. Całkowity poziom błędu i moc całej procedury pozostały wprawdzie w akceptowalnych granicach, ale autorzy uznali procedurę za formalnie niepoprawną.
Są też dwa argumenty praktyczne. Po pierwsze, jak pokazał rysunek 2, test normalności reaguje głównie na liczebność próby, a nie na rzeczywiste zagrożenie. Po drugie, zamiana testu t na test rangowy zmienia hipotezę – z pytania o średnie na pytanie o to, która grupa ma zwykle wyższe wyniki. Lepiej zaplanować analizę z góry, na podstawie pytania badawczego i spodziewanego charakteru danych, i ewentualnie dodać zaplanowaną analizę wrażliwości. Gdy nie wiesz, jaki test pasuje do hipotezy, zajrzyj do poradnika jak dobrać test statystyczny do hipotezy.
Jak sprawdzić normalność w SPSS? Procedura Eksploracja
- Wybierz Analiza → Opis statystyczny → Eksploracja (Analyze → Descriptive Statistics → Explore).
- Zmienną zależną (np. wynik GAD-7) przenieś do pola Zmienne zależne, a zmienną grupującą do pola Lista czynników – SPSS policzy wszystko osobno dla każdej grupy.
- W oknie Wykresy zaznacz Wykresy normalności z testami (Normality plots with tests) i histogram; w oknie Statystyki – statystyki opisowe.
- W wynikach odczytaj tabelę Statystyki opisowe (skośność i kurtoza z błędami standardowymi), tabelę Testy normalności (test Kołmogorowa-Smirnowa z poprawką Lillieforsa i test Shapiro-Wilka) oraz wykresy Q-Q.
- W regresji i ANOVA wieloczynnikowej sprawdź reszty: w oknie regresji liniowej (Zapisz) albo w Ogólnym modelu liniowym (Zapisz) zapisz reszty niestandaryzowane jako nową zmienną i wykonaj dla niej Eksplorację.
Ghasemi i Zahediasl (2012) pokazują tę samą ścieżkę z przykładowymi wynikami. Pamiętaj, że w procedurze Eksploracja test Kołmogorowa-Smirnowa ma już poprawkę Lillieforsa – nie trzeba jej dodawać. Krótkie wprowadzenie do programu znajdziesz w haśle IBM SPSS Statistics.
Lista kontrolna przed analizą
- Wiem, czego dotyczy założenie w mojej analizie: rozkładu w grupach, różnic między pomiarami czy reszt modelu.
- Obejrzałem histogram i wykres Q-Q reszt (lub wyników w każdej grupie) i opisałem kształt rozkładu słowami.
- Policzyłem skośność i kurtozę z błędami standardowymi i oceniłem je kryterium dopasowanym do liczebności.
- Sprawdziłem obserwacje odstające i błędy w danych, zanim cokolwiek usunąłem.
- Oceniłem, czy przy tej liczebności i tym kształcie rozkładu wybrana metoda jest odporna.
- Wybrałem analizę główną z góry, na podstawie pytania badawczego, a nie po obejrzeniu wartości p kilku testów.
- Zaplanowałem analizę wrażliwości i wiem, co zrobię, jeśli da inny wynik.
- Opisałem w pracy ocenę założeń i podjętą decyzję.
Jak opisać sprawdzenie normalności w pracy (APA)
W części o analizie danych albo na początku wyników napisz: czego dotyczyła ocena (zmiennej, rozkładu w grupach czy reszt), jakich metod użyto (wykres, skośność i kurtoza, test), co wyszło i jaka decyzja z tego wynikła. Opis dla naszego przykładu:
Gdy reszty mają rozkład zbliżony do normalnego, wystarczy jedno zdanie, np.: „Wykresy kwantylowe reszt nie wskazywały na istotne odstępstwa od normalności (skośność = …, kurtoza = …)”. Więcej gotowych sformułowań znajdziesz we wpisie jak opisać wyniki w stylu APA, a pełne przykłady diagnostyki modeli – w poradnikach ANOVA krok po kroku i regresja wieloraka krok po kroku.
Przykład w R
Kod odtwarza liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R – przepis 2 korzysta z obiektów utworzonych w przepisie 1. Rysunki i symulację z rysunku 2 przygotowano w osobnych skryptach na tych samych danych.
1. Dane, statystyki opisowe i ocena normalności reszt
R
library(psych)                                   # describeBy(), skew(), kurtosi()
# Dane symulowane: lęk (GAD-7, 0–21) u 45 osób ćwiczących regularnie i 55 niećwiczących
set.seed(1)
cwiczy    <- pmin(rnbinom(45, size = 2.5, mu = 5.0), 21)
nie_cwicz <- pmin(rnbinom(55, size = 2.5, mu = 7.2), 21)
lek   <- c(cwiczy, nie_cwicz)
grupa <- factor(rep(c("cwiczy", "nie_cwiczy"), c(45, 55)))
d <- describeBy(lek, grupa, type = 2, mat = TRUE)       # type = 2: skośność i kurtoza jak w SPSS
data.frame(grupa = d$group1, round(d[, c("n", "mean", "sd", "median", "skew", "kurtosis")], 2), row.names = NULL)

# Normalność dotyczy reszt modelu: wynik osoby minus średnia jej grupy
reszty <- lek - ave(lek, grupa)
qqnorm(reszty); qqline(reszty)                   # wykres Q-Q reszt
round(c(skosnosc = skew(reszty, type = 2), kurtoza = kurtosi(reszty, type = 2)), 2)
shapiro.test(reszty)
nortest::lillie.test(reszty)                     # K-S z poprawką Lillieforsa (jak w SPSS)
Wynik w R
       grupa  n mean   sd median skew kurtosis
1     cwiczy 45 4.09 2.80      4 1.09     1.19
2 nie_cwiczy 55 6.02 4.41      5 0.99     0.76
skosnosc  kurtoza
    1.05     1.35

	Shapiro-Wilk normality test

data:  reszty
W = 0.92829, p-value = 3.988e-05


	Lilliefors (Kolmogorov-Smirnov) normality test

data:  reszty
D = 0.15193, p-value = 5.958e-06
2. Analiza wrażliwości: pięć sposobów porównania grup
R
# Kontynuacja przepisu 1 (obiekty cwiczy, nie_cwicz, lek, grupa); bootstrap: pakiet boot
t.test(nie_cwicz, cwiczy)                                         # 1. test t Welcha
effectsize::cohens_d(nie_cwicz, cwiczy, pooled_sd = FALSE)

set.seed(2026)                                                    # 2. bootstrap BCa dla różnicy średnich
dane <- data.frame(lek, grupa)
roznica <- function(d, i) { d <- d[i, ]
  mean(d$lek[d$grupa == "nie_cwiczy"]) - mean(d$lek[d$grupa == "cwiczy"]) }
b <- boot::boot(dane, roznica, R = 10000, strata = dane$grupa)
boot::boot.ci(b, type = "bca")

t.test(log(nie_cwicz + 1), log(cwiczy + 1))                       # 3. transformacja log(x + 1)
WRS2::yuen(lek ~ grupa, tr = 0.2)                                 # 4. średnie przycięte 20%: cwiczy − nie_cwiczy
wilcox.test(nie_cwicz, cwiczy, exact = FALSE)                     # 5. test Manna-Whitneya
effectsize::rank_biserial(nie_cwicz, cwiczy)
Wynik w R
	Welch Two Sample t-test

data:  nie_cwicz and cwiczy
t = 2.6557, df = 92.761, p-value = 0.009316
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.486616 3.371970
sample estimates:
mean of x mean of y
 6.018182  4.088889

Cohen's d |       95% CI
------------------------
0.52      | [0.13, 0.91]

- Estimated using un-pooled SD.BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
Based on 10000 bootstrap replicates

CALL :
boot::boot.ci(boot.out = b, type = "bca")

Intervals :
Level       BCa
95%   ( 0.558,  3.360 )
Calculations and Intervals on Original Scale

	Welch Two Sample t-test

data:  log(nie_cwicz + 1) and log(cwiczy + 1)
t = 1.9873, df = 97.899, p-value = 0.04968
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.000376095 0.523465007
sample estimates:
mean of x mean of y
 1.731257  1.469337

Call:
WRS2::yuen(formula = lek ~ grupa, tr = 0.2)

Test statistic: 2.4815 (df = 45.78), p-value = 0.01682

Trimmed mean difference:  -1.69697
95 percent confidence interval:
-3.0737     -0.3203

Explanatory measure of effect size: 0.35


	Wilcoxon rank sum test with continuity correction

data:  nie_cwicz and cwiczy
W = 1558, p-value = 0.02578
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.26              | [0.04, 0.46]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- nortest (wersja 1.0.4): Gross, J., & Ligges, U. (2015). nortest: Tests for normality [R package]. https://doi.org/10.32614/CRAN.package.nortest
- boot (wersja 1.3.32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- WRS2 (wersja 1.1.7): Mair, P., & Wilcox, R. (2020). Robust statistical methods in R using the WRS2 package. Behavior Research Methods, 52(2), 464–488. https://doi.org/10.3758/s13428-019-01246-w
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy przy sprawdzaniu normalności
- Testowanie surowej zmiennej zamiast reszt. W teście t i ANOVA liczy się rozkład w grupach, a w regresji – rozkład reszt; połączona próba może wyglądać nienormalnie tylko dlatego, że grupy się różnią (Williams i in., 2013).
- Decyzja wyłącznie na podstawie p testu Shapiro-Wilka. W dużych próbach test alarmuje przy odstępstwach bez znaczenia, a w małych przeocza poważne (rysunek 2).
- „Rozkład jest normalny, bo p > .05”. Nieistotny wynik oznacza tylko brak podstaw do odrzucenia normalności – przy 10 osobach test nie wykrył silnej skośności w ponad połowie prób.
- Odruchowa zamiana na test nieparametryczny. Zmienia hipotezę (średnie → rozkłady rang), a przy dużych grupach zwykle niczego nie poprawia.
- Usuwanie „niewygodnych” wyników, żeby rozkład wyglądał lepiej. Długi ogon to często prawdziwa zmienność; reguły dla obserwacji odstających ustal przed analizą.
- Transformacja bez sprawdzenia skutków. W przykładzie logarytm zamienił skośność prawostronną na lewostronną i zmienił porównywany parametr.
- Brak opisu w pracy. Napisz, co i jak sprawdzono oraz jaka decyzja z tego wynikła – sama formuła „założenia zostały spełnione” nie wystarczy.
Najczęstsze pytania
Jak sprawdzić normalność przed testem t, ANOVA albo regresją?
Najpierw ustal, czego dotyczy założenie – w teście t i ANOVA rozkładu w grupach, w regresji reszt modelu. Potem obejrzyj histogram i wykres Q-Q, policz skośność i kurtozę z błędami standardowymi, a test Shapiro-Wilka podaj jako uzupełnienie. Decyzję opieraj na wielkości odstępstwa i liczebności próby, a nie na samym p.
Co zrobić, gdy test Shapiro-Wilka wskazuje brak normalności?
Przy grupach po kilkadziesiąt osób i umiarkowanej skośności zwykle nic – testy parametryczne (najlepiej w wersji Welcha) są wtedy odporne; warto dodać analizę wrażliwości. Przy małych grupach, silnej skośności lub obserwacjach odstających użyj metod odpornych (np. średnich przyciętych), bootstrapu, transformacji albo testu nieparametrycznego, pamiętając, że każda z tych metod odpowiada na nieco inne pytanie.
Czy test Shapiro-Wilka jest konieczny?
Nie. To uzupełnienie wykresów i wskaźników skośności i kurtozy. W symulacji na tej stronie przy 1000 osobach i lekkiej skośności test odrzucał normalność w 100% prób, choć test t działał bez zarzutu, a przy 10 osobach i silnej skośności wykrywał problem tylko w 44% prób. Wynik testu podawaj, ale nie traktuj go jako „bramki” wyboru analizy.
Czy przy dużej próbie trzeba sprawdzać normalność?
Warto obejrzeć wykres reszt, bo pokazuje też obserwacje odstające i nietypowe wzory, ale samo odstępstwo od normalności przy dużej próbie zwykle nie zagraża testom na średnich – rozkład średnich zbliża się wtedy do normalnego. Ważniejsze stają się niezależność obserwacji, nierówne wariancje i skrajne wyniki.
Jak sprawdzić normalność w SPSS?
Wybierz Analiza → Opis statystyczny → Eksploracja, zmienną zależną wpisz do Zmiennych zależnych, grupującą do Listy czynników, a w oknie Wykresy zaznacz Wykresy normalności z testami. Dostaniesz skośność i kurtozę z błędami standardowymi, tabelę z testami Kołmogorowa-Smirnowa (z poprawką Lillieforsa) i Shapiro-Wilka oraz wykresy Q-Q dla każdej grupy.
Czy normalność sprawdza się dla całej próby, czy w grupach?
W grupach – albo, równoważnie, dla reszt modelu (wynik minus średnia grupy). Rozkład połączonej próby może odbiegać od normalnego tylko dlatego, że grupy mają różne średnie, choć w każdej grupie rozkład jest normalny. W teście t dla prób zależnych sprawdza się rozkład różnic między pomiarami.
Powiązane hasła
Przeczytaj też
Czym jest centralne twierdzenie graniczne?
Intuicja, warunki i interaktywna symulacja pokazująca, dlaczego rozkład średnich może zbliżać się do normalnego, choć surowe dane są skośne.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2017). Non-normal data: Is ANOVA still a valid option? Psicothema, 29(4), 552–557. https://doi.org/10.7334/psicothema2016.383 ● Otwarty dostęp
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Field, A. P., & Wilcox, R. R. (2017). Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers. Behaviour Research and Therapy, 98, 19–38. https://doi.org/10.1016/j.brat.2017.05.013 ● Otwarty dostęp: pełny tekst
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505 ● Otwarty dostęp
- Hoekstra, R., Kiers, H. A. L., & Johnson, A. (2012). Are assumptions of well-known statistical techniques checked, and why (not)? Frontiers in Psychology, 3, Article 137. https://doi.org/10.3389/fpsyg.2012.00137 ● Otwarty dostęp
- Kim, H.-Y. (2012). Statistical notes for clinical researchers: Assessing normal distribution (1). Restorative Dentistry & Endodontics, 37(4), 245–248. https://doi.org/10.5395/rde.2012.37.4.245 ● Otwarty dostęp
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52 ● Otwarty dostęp
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Pek, J., Wong, O., & Wong, A. C. M. (2018). How to address non-normality: A taxonomy of approaches, reviewed, and illustrated. Frontiers in Psychology, 9, Article 2104. https://doi.org/10.3389/fpsyg.2018.02104 ● Otwarty dostęp
- Rochon, J., Gondan, M., & Kieser, M. (2012). To test or not to test: Preliminary assessment of normality when comparing two independent samples. BMC Medical Research Methodology, 12(1), Article 81. https://doi.org/10.1186/1471-2288-12-81 ● Otwarty dostęp
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{blanca2017nonnormal, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Non-normal data: Is ANOVA still a valid option?}}, journal={Psicothema}, year={2017}, volume={29}, number={4}, pages={552--557}, doi={10.7334/psicothema2016.383}}@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@article{field2017robust, author={Field, Andy P. and Wilcox, Rand R.}, title={{Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={19--38}, doi={10.1016/j.brat.2017.05.013}}@article{ghasemi2012normality, author={Ghasemi, Asghar and Zahediasl, Saleh}, title={{Normality tests for statistical analysis: A guide for non-statisticians}}, journal={International Journal of Endocrinology and Metabolism}, year={2012}, volume={10}, number={2}, pages={486--489}, doi={10.5812/ijem.3505}}@article{hoekstra2012assumptions, author={Hoekstra, Rink and Kiers, Henk A. L. and Johnson, Addie}, title={{Are assumptions of well-known statistical techniques checked, and why (not)?}}, journal={Frontiers in Psychology}, year={2012}, volume={3}, eid={137}, doi={10.3389/fpsyg.2012.00137}}@article{kim2012assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (1)}}, journal={Restorative Dentistry \& Endodontics}, year={2012}, volume={37}, number={4}, pages={245--248}, doi={10.5395/rde.2012.37.4.245}}@article{kim2013assessing, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis}}, journal={Restorative Dentistry \& Endodontics}, year={2013}, volume={38}, number={1}, pages={52--54}, doi={10.5395/rde.2013.38.1.52}}@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{pek2018address, author={Pek, Jolynn and Wong, Octavia and Wong, Augustine C. M.}, title={{How to address non-normality: A taxonomy of approaches, reviewed, and illustrated}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={2104}, doi={10.3389/fpsyg.2018.02104}}@article{rochon2012test, author={Rochon, Justine and Gondan, Matthias and Kieser, Meinhard}, title={{To test or not to test: Preliminary assessment of normality when comparing two independent samples}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={81}, doi={10.1186/1471-2288-12-81}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}