Kiedy w pracy potrzebna jest tabela statystyk opisowych?
Tabelę statystyk opisowych umieszcza się na początku rozdziału z wynikami, zanim przejdzie się do testowania hipotez. Pozwala czytelnikowi ocenić, jak rozkładały się wyniki, czy nie ma efektu sufitu lub podłogi i czy zastosowane testy były uzasadnione. Wymagają jej standardy raportowania APA (Appelbaum i in., 2018) i większość promotorów. Gdy zmiennych jest kilka, warto połączyć ją z korelacjami — zob. tabela korelacji w APA.
Wzór tabeli statystyk opisowych w APA
Tabelę przygotowano na danych z badania akceptacji samochodów autonomicznych (model TAM). Przyciskiem pod tabelą skopiujesz ją do Worda z zachowaniem formatowania.
Tabela 1
Statystyki opisowe zmiennych modelu akceptacji technologii
| Zmienna | Możliwy zakres | Min–Maks | M | SD | Mdn | Skośność | Kurtoza | α |
|---|---|---|---|---|---|---|---|---|
| Łatwość korzystania | 1–5 | 1.00–5.00 | 3.61 | 0.79 | 3.75 | −0.52 | 0.51 | .90 |
| Użyteczność | 1–5 | 1.00–5.00 | 3.24 | 0.89 | 3.25 | −0.32 | −0.05 | .87 |
| Intencja zakupu | 1–5 | 1.00–5.00 | 2.76 | 1.03 | 2.75 | 0.03 | −0.68 | .87 |
| Obawy | 1–4 | 1.00–4.00 | 2.79 | 0.71 | 2.80 | −0.31 | −0.57 | — |
| Cele | 1–4 | 1.00–4.00 | 2.15 | 0.74 | 2.00 | 0.45 | −0.21 | — |
| Wiek (lata) | — | 20–51 | 27.52 | 5.87 | 26.00 | 1.47 | 1.86 | — |
Uwaga. N = 303. Wyniki skal to średnie z odpowiedzi na pozycje; wyższe wartości oznaczają wyższy poziom zmiennej. Skośność i kurtozę (kurtoza nadwyżkowa) obliczono tak jak w SPSS; SE skośności = 0.14, SE kurtozy = 0.28. α = alfa Cronbacha; dla obaw i celów dostępne były wyłącznie wyniki ogólne, dlatego nie podano rzetelności.
Co jest w tabeli i jak ją czytać
- Możliwy zakres i min–maks — pokazują, czy badani wykorzystali całą skalę. Łatwość korzystania ma średnią 3.61 na skali 1–5, więc wyniki są przesunięte w stronę wysokich ocen.
- M, SD i Mdn — średnia, odchylenie standardowe i mediana. Przy rozkładach skośnych mediana bywa lepszą miarą tendencji centralnej.
- Skośność i kurtoza — skośność bliska zeru oznacza rozkład symetryczny; wartości do ±1 zwykle nie budzą zastrzeżeń. Kurtoza podana jest jako nadwyżkowa (rozkład normalny = 0).
- α — rzetelność skali; szczegóły można przenieść do osobnej tabeli rzetelności.
- Konwencja liczb — kropka dziesiętna i dwa miejsca po kropce. Bez zera wiodącego zapisuje się tylko wartości, które nie mogą przekroczyć 1 (α, r, p); średnie, SD, skośność i kurtoza mają zero wiodące.
Jak opisać tabelę w tekście pracy
W tekście nie powtarzaj wszystkich liczb z tabeli — przywołaj ją i opisz najważniejsze wyniki. Przykład dla danych z tej strony:
Rysunek rozkładów zamiast samych liczb
Tabela podaje liczby, ale nie pokazuje kształtu rozkładu. W psychologii (APA) wystarczy zwykle tabela; w innych dziedzinach — np. w naukach biomedycznych — coraz częściej oczekuje się rysunków pokazujących rozkład danych zamiast samych średnich (Weissgerber i in., 2015). Poniższy wykres grzbietowy (ang. ridgeline) wygenerowano w stylu rysunków aplikacji SZTOS.
Rysunek 1
Rozkłady wyników trzech skal modelu akceptacji technologii
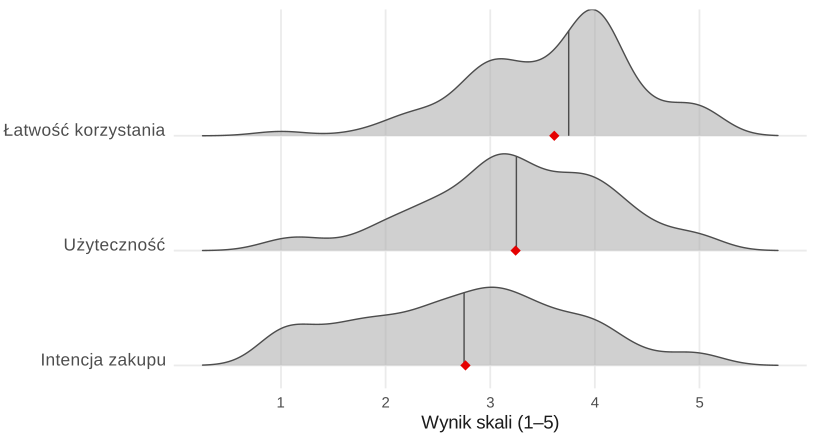
Uwaga. N = 303. Pionowa kreska oznacza medianę, czerwony romb — średnią. Rozkład intencji zakupu jest najbardziej spłaszczony.
Jak przygotować tabelę: SPSS, JASP, R i Word
SPSS: Analiza → Opis statystyczny → Statystyki opisowe (zaznacz średnią, odchylenie standardowe, minimum, maksimum, skośność i kurtozę), a medianę dodaj w Częstości → Statystyki. Alfę Cronbacha policzysz w Analiza → Skala → Analiza rzetelności. JASP: moduł Descriptives z opcjami Median, Skewness, Kurtosis; włącz Settings → Results → APA format.
R: funkcja psych::describe() z argumentem type = 2 daje skośność i kurtozę zgodne z SPSS (kod niżej).
Jak sformatować tabelę w Wordzie
- Wstaw tabelę, a następnie w Projekt tabeli → Obramowania wybierz Bez obramowania.
- Dodaj tylko trzy linie poziome: nad wierszem nagłówka, pod nagłówkiem i pod ostatnim wierszem (oraz krótkie linie pod nagłówkami grupującymi).
- Nazwy wierszy wyrównaj do lewej, liczby do środka (lub do kropki dziesiętnej); w całej kolumnie zachowaj tę samą liczbę miejsc po kropce.
- Nad tabelą wpisz numer (pogrubiony) i w nowym wierszu tytuł kursywą; pod tabelą notę zaczynającą się od Uwaga.
- Przy długiej tabeli zaznacz wiersz nagłówka i włącz Powtórz jako wiersz nagłówka, aby pojawiał się na każdej stronie.
Przykład w R
Kod liczy wszystkie wartości z tabeli. Plik danych nazwano tu dane_ankieta_tam.xlsx.
Statystyki opisowe i alfa Cronbacha
R
library(readxl); library(psych)
dane <- as.data.frame(read_excel("dane_ankieta_tam.xlsx"))
dane$LAT <- rowMeans(dane[, paste0("Łatwość_korzystania", 1:4)])   # łatwość korzystania
dane$UZY <- rowMeans(dane[, paste0("Użyteczność", 1:4)])           # użyteczność
dane$INT <- rowMeans(dane[, paste0("Intencja_kupna", 1:4)])        # intencja zakupu
zm <- dane[, c("LAT", "UZY", "INT", "Obawy", "Cele", "Wiek")]
opis <- describe(zm, type = 2)          # type = 2: skośność i kurtoza jak w SPSS
round(opis[, c("n", "mean", "sd", "median", "min", "max", "skew", "kurtosis")], 2)
alpha(dane[, paste0("Łatwość_korzystania", 1:4)])$total$raw_alpha
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://CRAN.R-project.org/package=readxl
Najczęstsze błędy
- Zrzut ekranu z SPSS zamiast tabeli przepisanej w formacie APA.
- Linie pionowe i kolorowe tło — tabela APA ma wyłącznie linie poziome.
- Różna liczba miejsc po przecinku w jednej kolumnie (3.6, 3.243, 2.76).
- Brak liczebności — podaj N w nocie albo kolumnę n, gdy różni się między zmiennymi.
- Niewyjaśnione skróty — każdy skrót spoza standardowych symboli APA wyjaśnij w nocie.
- Zakres skali bez informacji o kierunku — napisz, co oznaczają wyższe wyniki.
Najczęstsze pytania
Jakie statystyki opisowe podać w tabeli APA?
Minimum to M i SD dla zmiennych ilościowych oraz n i % dla jakościowych. W pracach z psychologii często dodaje się zakres, medianę, skośność, kurtozę i rzetelność skali (α lub ω).
Czy skośność i kurtozę trzeba podawać?
Nie zawsze, ale pomagają uzasadnić wybór testów parametrycznych. Jeśli je podajesz, zaznacz w nocie, jak je obliczono (np. jak w SPSS) i że kurtoza jest nadwyżkowa.
Gdzie umieścić tabelę statystyk opisowych?
Na początku rozdziału z wynikami, po opisie próby i narzędzi. Jeśli zmiennych jest bardzo wiele, pełną tabelę można przenieść do aneksu, a w tekście zostawić najważniejsze.
Ile miejsc po przecinku podawać?
Zwykle dwa. Ważne, by w całej kolumnie była ta sama liczba miejsc i by precyzja odpowiadała dokładności pomiaru.
Czy w polskiej pracy pisać kropkę czy przecinek dziesiętny?
Oryginalny styl APA używa kropki. Wiele polskich uczelni dopuszcza lub wymaga przecinka — sprawdź wytyczne wydziału i stosuj jedną konwencję w całej pracy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Tabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikWzór przedstawienia charakterystyki próby w badaniach naukowych
Gotowy układ tabeli i akapitu: przepływ uczestników, demografia, zmienne kliniczne, braki danych i informacje potrzebne do oceny możliwości uogólniania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (b.d.). Table setup. APA Style. Pobrano 8 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables ● Otwarty dostęp
- American Psychological Association. (b.d.). Sample tables. APA Style. Pobrano 9 października 2026 z https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020manual, author={{American Psychological Association}}, title={Publication Manual of the American Psychological Association}, edition={7}, publisher={American Psychological Association}, address={Washington, DC}, year={2020}, doi={10.1037/0000165-000}}@misc{apa_table_setup, author={{American Psychological Association}}, title={Table setup}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/tables}, note={Pobrano 8 października 2026}}@misc{apa_sample_tables, author={{American Psychological Association}}, title={Sample tables}, howpublished={APA Style}, url={https://apastyle.apa.org/style-grammar-guidelines/tables-figures/sample-tables}, note={Pobrano 9 października 2026}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={Beyond bar and line graphs: Time for a new data presentation paradigm}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}