Jak korzystać z tego przykładu
Rozdział „Wyniki badań własnych” to miejsce, w którym badanie zamienia się w liczby, a liczby – w decyzje o hipotezach. Rzadko sprawia kłopot pojedynczy test. Trudniej ułożyć z kilkunastu wyników jeden spójny tekst: w jakiej kolejności je podać, co pokazać w tabeli, a co opisać zdaniem, ile miejsca poświęcić założeniom i w którym momencie skończyć, żeby nie wejść w dyskusję. Dlatego poniżej znajdziesz cały rozdział wyników jednego badania, a między jego fragmentami – komentarz, dlaczego napisano go właśnie tak.
Przykładem jest badanie, które opisujemy w całej serii wpisów. Sto osiemdziesiąt osób studiujących losowo przydzielono do grupy kontrolnej, czterotygodniowego treningu relaksacji albo treningu uważności, a przed treningiem i po nim mierzono stres i jakość snu. Plan badania i hipotezy H1–H3 pochodzą z poradnika rozdział metodologiczny pracy magisterskiej, zdania do poszczególnych testów – z wpisu jak opisać wyniki w stylu APA, a interpretację tych samych liczb – z poradnika jak napisać dyskusję wyników. Razem tworzą kolejne rozdziały jednej pracy, dlatego numeracja podrozdziałów zaczyna się od 4.
Dane w przykładzie są symulowane. Liczby są realistyczne, ale nie opisują prawdziwych osób, a wszystkie pochodzą z kodu R zamieszczonego na końcu wpisu. Traktuj rozdział jako wzór struktury i zapisu, a nie tekst do skopiowania: Twoje analizy, liczby i wnioski muszą wynikać z Twoich danych, a opis – być Twój. Ramki z przyciskiem „Kopiuj opis” możesz wykorzystać jako szkielet: podmień liczby i nazwy zmiennych, a zdania dopasuj do swojego badania. Cały rozdział z tabelami i rysunkami pobierzesz też jako plik Word.
Układ rozdziału z wynikami
Rozdział z wynikami ma prowadzić czytelnika od danych do decyzji o każdej hipotezie. W przykładzie ma pięć podrozdziałów. Ich kolejność wynika z logiki badania, a nie z kolejności, w jakiej wykonywałeś analizy.
| Podrozdział | Co zawiera | Czego tu nie umieszczać |
|---|---|---|
| 4.1. Przygotowanie danych i analizy wstępne | Liczebność analizowanej próby, braki danych, wykluczenia, obserwacje odstające; statystyki opisowe i rzetelność; sprawdzenie założeń | Pełnej charakterystyki próby (jest w metodzie), wydruków z programu |
| 4.2. Weryfikacja hipotez H1 i H2 | Statystyki opisowe grup, wynik testu, wielkość efektu z przedziałem ufności, jedno zdanie o zgodności z hipotezą | Porównań z literaturą i wyjaśnień, dlaczego wynik jest taki |
| 4.3. Weryfikacja hipotezy H3 | Związek zmiennych i analiza mediacji z efektem pośrednim | Wniosków o mechanizmie przyczynowym |
| 4.4. Analizy dodatkowe i eksploracyjne | Analizy spoza planu, wyraźnie tak oznaczone: analiza wrażliwości, efekt płci, zmienna poboczna | Nowych „hipotez” dopisanych po zobaczeniu wyników |
| 4.5. Podsumowanie wyników | Tabela hipotez z decyzją „potwierdzona / niepotwierdzona” | Wniosków praktycznych i rekomendacji |
Trzy zasady porządkują cały rozdział. Po pierwsze, hipotezy opisujesz w tej samej kolejności i tymi samymi słowami co w rozdziale metodologicznym. Standardy JARS-Quant dzielą hipotezy, analizy i wnioski na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018), a Gernsbacher (2018) zaleca wyraźne oddzielanie analiz konfirmacyjnych od eksploracyjnych. Po drugie, każdy wynik zawiera te same elementy: statystyki opisowe, wynik testu z dokładnym p oraz wielkość efektu z przedziałem ufności. Lakens (2013) pokazuje, jak obliczać i raportować wielkości efektu, by mogły później posłużyć do analizy mocy i metaanalizy. Po trzecie, wyniki opisujesz w czasie przeszłym i bez interpretacji na tle literatury – to zadanie dyskusji. Zasady zapisu liczb i statystyk opisuje rozdział 6 podręcznika APA (American Psychological Association, 2020). Wzory tabel znajdziesz w poradniku tabele APA w pracy z psychologii.
Ten sam układ rozdziału sprawdza się na innych kierunkach – zmieniają się tylko typowe analizy. W pracach z nauk o zdrowiu często opracowuje się ankietę wiedzy, w fizjoterapii – pomiar przed i po terapii, w zarządzaniu i ekonomii – regresję i proste modele ekonometryczne, a w pedagogice – porównania grup i tabele krzyżowe.
4.1.1. Przygotowanie danych i opis próby
Pierwszy fragment odpowiada na pytanie, ile osób i jakie dane naprawdę przeanalizowałeś. W przykładzie nikogo nie wykluczono, ale zdanie o wykluczeniach i brakach i tak musi się pojawić – czytelnik nie może się ich domyślać.
Dlaczego tak. Rozdział zaczyna się od liczb, na których opierają się wszystkie dalsze analizy:
- Liczebność analizowanej próby – łącznie i w grupach. Jeśli różni się od liczby zebranych ankiet, podaj obie liczby i powód różnicy.
- Braki danych – ile ich było i co z nimi zrobiłeś. Usuwanie osób z brakami jest bezpieczne tylko przy pewnych mechanizmach braków (zob. braki danych MCAR, MAR i MNAR).
- Przekształcenia – rekodowanie pozycji odwróconych i sposób liczenia wyniku skali.
- Obserwacje odstające – kryterium i decyzja. Leys i in. (2013) odradzają popularną regułę „średnia ± 3 SD”, bo i średnia, i odchylenie standardowe same reagują na wartości skrajne, i proponują odporne medianowe odchylenie bezwzględne (MAD). Procedurę krok po kroku opisuje poradnik wartości odstające – jak je wykryć, a definicję hasło obserwacja odstająca.
Nie powtarzaj tu pełnej charakterystyki próby, jeśli podałeś ją w metodzie – wystarczy odesłanie (jak ją przedstawić, pokazujemy w poradniku jak opisać charakterystykę próby). W eksperymencie warto natomiast pokazać, czy grupy były podobne pod względem ważnych cech, np. płci, i jaki był ich wyjściowy poziom zmiennej zależnej (tu: Tabela 2). Gdy w Twoim badaniu część osób trzeba było wykluczyć, opisz to w tej kolejności:
4.1.2. Statystyki opisowe i rzetelność
Statystyki opisowe pokazują, z jakimi danymi pracujesz: gdzie leżą średnie, jak duże jest zróżnicowanie, czy rozkłady nie są skrajnie skośne i jak zmienne są ze sobą powiązane. Przy kilku zmiennych najczytelniejsza jest jedna tabela łącząca statystyki opisowe i korelacje.
Tabela 1
Statystyki opisowe i korelacje zmiennych
| Zmienna | M | SD | Zakres | Skośność | Kurtoza | 1 | 2 | 3 |
|---|---|---|---|---|---|---|---|---|
| 1. Stres przed treningiem | 3.14 | 0.82 | 1.33–5.00 | 0.00 | −0.81 | — | ||
| 2. Stres po czterech tygodniach | 2.74 | 0.92 | 1.00–5.00 | 0.14 | −0.60 | .85 | — | |
| 3. Wsparcie społeczne | 5.13 | 0.98 | 2.42–7.00 | −0.20 | −0.25 | −.38 | −.38 | — |
| 4. Samoskuteczność | 28.74 | 4.32 | 19.00–40.00 | −0.01 | −0.37 | −.53 | −.52 | .40 |
Uwaga. N = 180. Zakresy skal: stres 1–5, wsparcie społeczne 1–7, samoskuteczność 10–40. Zakres to najmniejszy i największy wynik w próbie. Rzetelność skali stresu w pierwszym pomiarze: α = .85, ω = .86. Wszystkie korelacje są istotne statystycznie, p < .001.
Dlaczego tak. Tekst nie przepisuje tabeli, tylko przywołuje ją i wskazuje najważniejsze liczby: poziom stresu w obu pomiarach, kształt rozkładów i kierunek związków potrzebnych do hipotezy H3. Pozostałe wartości czytelnik znajdzie w tabeli – wzory takich tabel omawiają hasło tabela statystyk opisowych w APA i poradnik o tabelach APA. Zwróć uwagę na zapis liczb: zero przed kropką pomija się przy wartościach, które nie mogą przekroczyć 1 (r, p, α), a wartości p mniejsze od .001 zapisuje się jako p < .001 (American Psychological Association, 2024).
Rzetelność skali podaj dla wyników z Twojej próby – w metodzie albo na początku wyników, ale tylko w jednym miejscu. Oprócz alfy Cronbacha warto podać omegę McDonalda; jak oceniać i raportować alfę, wyjaśniamy w poradniku alfa Cronbacha – rzetelność skali. W przykładzie pozycje skali stresu były dostępne tylko w pierwszym pomiarze, dlatego zdanie dotyczy rzetelności „w pierwszym pomiarze”. Jeśli masz pozycje z obu pomiarów, podaj rzetelność dla każdego.
4.1.3. Sprawdzenie założeń
Założenia sprawdzasz po to, by wiedzieć, czy wybrany w planie test jest odpowiedni, a nie po to, by pokazać wszystkie wydruki. Wystarczy kilka zdań z liczbami i decyzją.
Dlaczego tak. Fragment podaje tylko to, co wpływa na wybór i wiarygodność testów:
- Normalność ocenia się w resztach modelu, a nie w surowych zmiennych. Williams i in. (2013) przypominają, że regresja metodą najmniejszych kwadratów wymaga (zwłaszcza w małych próbach) normalności błędów, a nie zmiennej zależnej czy predyktorów. To samo dotyczy ANOVA, która jest szczególnym przypadkiem modelu liniowego. Jak łączyć wykresy, skośność, kurtozę i testy, pokazuje poradnik jak sprawdzić normalność rozkładu.
- Równość wariancji sprawdza test Levene’a. Delacre i in. (2019) zalecają w psychologii domyślnie stosować test F Welcha, który nie zakłada równych wariancji (zob. test Welcha). W przykładzie grupy są równoliczne, a wariancje podobne, więc oba testy dają ten sam wniosek – i warto to napisać.
- W regresji sprawdź dodatkowo stałość wariancji reszt, współliniowość (VIF) i obserwacje wpływowe (odległość Cooka).
- Gdy założenie nie jest spełnione, napisz, co zrobiłeś zamiast testu z planu (np. test Welcha, test nieparametryczny, bootstrap) i dlaczego. Taka decyzja jest częścią wyników, a nie powodem do wstydu.
4.2. Weryfikacja hipotez H1 i H2
Od tego miejsca każdy podrozdział odpowiada jednej hipotezie albo grupie hipotez sprawdzanych tą samą analizą. Hipotezy H1 i H2 porównują grupę uważności z dwiema pozostałymi, więc sprawdza je jedna jednoczynnikowa analiza wariancji z porównaniami post hoc.
Tabela 2
Stres przed treningiem i po czterech tygodniach w trzech warunkach
| Warunek | n | Przed treningiem | Po czterech tygodniach | ||
|---|---|---|---|---|---|
| M | SD | M | SD | ||
| Grupa kontrolna | 60 | 3.25 | 0.88 | 3.09a | 0.95 |
| Trening relaksacji | 60 | 3.04 | 0.72 | 2.76a | 0.81 |
| Trening uważności | 60 | 3.12 | 0.85 | 2.37b | 0.87 |
Uwaga. Skala stresu 1–5; wyższy wynik oznacza wyższy stres. Średnie po czterech tygodniach oznaczone różnymi literami różnią się istotnie (test Tukeya, p < .05).
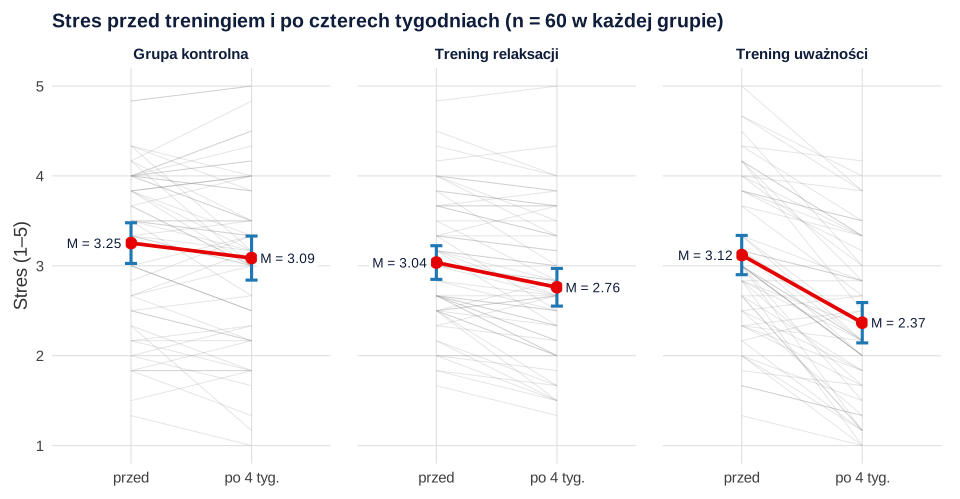
Dlaczego tak. Akapit ma stały porządek: przypomnienie, czego dotyczy hipoteza, odesłanie do tabeli i rysunku, wynik testu ogólnego z η² i przedziałem ufności, a potem porównania, które bezpośrednio odpowiadają na H1 i H2. Przy każdym porównaniu jest krótka informacja o zgodności z hipotezą – bez komentarza, dlaczego trening działa. Zwróć uwagę na kilka szczegółów:
- Wynik nieistotny jest opisany równie dokładnie. Różnica między relaksacją a grupą kontrolną nie była istotna, ale ma swoją średnią, przedział ufności i d. Nie piszemy, że grupy „są takie same” – co wolno wywnioskować z takiego wyniku, wyjaśnia wpis hipoteza się nie potwierdziła.
- Przedziały ufności dla różnic pochodzą z testu Tukeya, czyli są skorygowane na trzy porównania i zgodne z podanymi wartościami p. Wartości d Cohena podano bez przedziałów, bo zwykły przedział dla d nie uwzględnia wielu porównań i mógłby nie zgadzać się z testem Tukeya.
- Tabela 2 pokazuje też pomiar wyjściowy. Czytelnik widzi, że grupy zaczynały z podobnego poziomu stresu, a litery przy średnich streszczają wynik porównań post hoc bez powtarzania wszystkich liczb.
- Rysunek pokazuje dane, a nie tylko średnie. Weissgerber i in. (2015) zwracają uwagę, że wykresy słupkowe i liniowe mogą wyglądać identycznie przy bardzo różnych rozkładach danych. Linie poszczególnych osób pokazują, że w grupie uważności stres spadł u 55 z 60 osób (91.7%), a w grupie kontrolnej – u 33 (55.0%). Podpis mówi, co oznaczają słupki błędów.
Więcej przykładów opisu analizy wariancji, także dwuczynnikowej, znajdziesz w poradniku ANOVA krok po kroku.
4.3. Weryfikacja hipotezy H3
Hipoteza H3 ma dwie części: związek wsparcia społecznego ze stresem oraz pośredniczącą rolę samoskuteczności. Dlatego najpierw opisujemy prostszą część (korelację), a potem analizę mediacji.
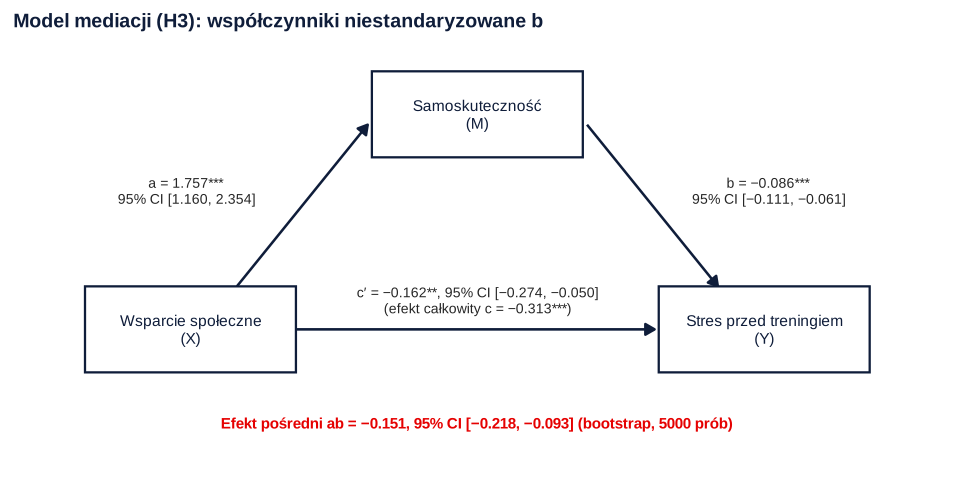
Dlaczego tak. W analizie mediacji najważniejszy jest efekt pośredni ab z przedziałem ufności z bootstrapu. Preacher i Hayes (2008) omawiają metody oceny efektów pośrednich, w tym bootstrap, a Rucker i in. (2011) przekonują, że ocenianie mediacji po tym, czy związek X–Y przestaje być istotny po dodaniu mediatora, jest nieuzasadnione. Dlatego w tekście nie ma słów „mediacja pełna” ani „częściowa”, a decyzję o hipotezie opiera się na przedziale dla ab.
Wyniki mediacji można pokazać na rysunku ścieżkowym (jak tutaj) albo w tabeli – wzór znajdziesz w haśle tabela mediacji w APA, a całą procedurę w poradniku analiza mediacji krok po kroku. Zwróć też uwagę na język. Wszystkie trzy zmienne zmierzono w jednym momencie, więc rozdział mówi o „efekcie pośrednim” i „związkach”, a nie o tym, że wsparcie „wpływa” na stres przez samoskuteczność. Co wolno napisać przy danym schemacie badania, omawiamy w części o języku przyczynowym poradnika o dyskusji wyników.
4.4. Analizy dodatkowe i eksploracyjne
Analizy, których nie było w planie, mają w rozdziale swoje miejsce, ale osobne i wyraźnie podpisane. W przykładzie są trzy: analiza wrażliwości dla H1 i H2 oraz dwie analizy eksploracyjne.
Dlaczego tak. Każdy akapit zaczyna się od nazwy rodzaju analizy, żeby czytelnik od razu wiedział, czy ma do czynienia z weryfikacją hipotezy, czy z poszukiwaniem.
- Analiza wrażliwości odpowiada na pytanie, czy wniosek zależy od wyboru metody. W badaniu z pomiarem przed i po naturalną kandydatką jest ANCOVA z pomiarem wyjściowym. Egbewale i in. (2014) pokazali w symulacji badań randomizowanych, że przy nierównowadze wyjściowej grup daje ona nieobciążone i bardziej precyzyjne oszacowania niż ANOVA wyników końcowych czy analiza wskaźników zmiany, a przy grupach wyrównanych jest co najmniej równie dobra. Jeśli dopiero planujesz badanie przed–po, rozważ ją jako analizę główną już w planie analiz.
- Interakcja z płcią wyszła istotna, ale w najmniejszej komórce było tylko 21 mężczyzn. Sommet i in. (2023) wykazali, że mediana mocy wykrycia interakcji typowej wielkości wynosiła w analizowanych badaniach zaledwie .18. Dlatego wynik opisano bez entuzjazmu, ze wskazaniem, że wymaga replikacji.
- Jakość snu mierzono jednym pytaniem, więc zastosowano test Kruskala–Wallisa i podano mediany z kwartylami zamiast średnich.
Nie przenoś wyniku eksploracyjnego do hipotez, nawet jeśli „ładnie wyszedł”. Przedstawianie hipotezy sformułowanej po poznaniu wyników tak, jakby powstała wcześniej, to HARKing. Pamiętaj też, że każda kolejna analiza zwiększa ryzyko przypadkowego wyniku istotnego. W dyskusji napisz, ile analiz eksploracyjnych wykonałeś.
4.5. Podsumowanie wyników
Ostatni podrozdział zbiera decyzje o hipotezach w jednym miejscu. Tabela z kolumną „potwierdzona / niepotwierdzona” pozwala ogarnąć wyniki jednym spojrzeniem i ułatwia pisanie dyskusji oraz przygotowanie do obrony.
Tabela 3
Podsumowanie weryfikacji hipotez
| Hipoteza | Analiza | Najważniejszy wynik | Decyzja |
|---|---|---|---|
| H1. Po czterech tygodniach stres w grupie treningu uważności będzie niższy niż w grupie kontrolnej | ANOVA, test Tukeya | różnica = −0.72, p < .001, d = 0.79 | Potwierdzona |
| H2. Po czterech tygodniach stres w grupie treningu uważności będzie niższy niż w grupie treningu relaksacji | ANOVA, test Tukeya | różnica = −0.39, p = .039, d = 0.47 | Potwierdzona |
| H3. Wyższe wsparcie społeczne będzie związane z niższym stresem, a samoskuteczność będzie pośredniczyć w tym związku | Korelacja Pearsona; mediacja z bootstrapem | r = −.38, p < .001; ab = −0.151, 95% CI [−0.218, −0.093] | Potwierdzona |
Uwaga. d – d Cohena (wartość bezwzględna); ab – efekt pośredni (95% CI percentylowy, 5000 prób bootstrapowych). Analiz dodatkowych i eksploracyjnych z podrozdziału 4.4 nie ujęto w tabeli, ponieważ nie weryfikowały hipotez.
Dlaczego tak. Podsumowanie nie wprowadza nowych liczb ani interpretacji. Powtarza tylko decyzje i najważniejszy wynik dla każdej hipotezy, a analizy eksploracyjne wymienia z zastrzeżeniem. Decyzję formułuj według wyniku testu, a nie według tego, co chciałbyś pokazać:
| Sformułowanie | Kiedy | Uwaga |
|---|---|---|
| „Hipoteza została potwierdzona” | Wynik istotny w przewidywanym kierunku | Podaj wielkość efektu – istotny nie znaczy duży |
| „Hipoteza nie została potwierdzona” | Wynik nieistotny albo istotny w przeciwnym kierunku | Przy kierunku przeciwnym napisz to wprost |
| „Hipoteza została potwierdzona częściowo” | Tylko hipoteza złożona z kilku przewidywań, z których część się sprawdziła | Wskaż, która część się potwierdziła, a która nie |
| „Hipoteza została udowodniona / obalona” | Nigdy | Jedno badanie nie dowodzi ani nie obala hipotezy |
W przykładzie wszystkie trzy hipotezy się potwierdziły, ale w Twojej pracy może być inaczej. Wynik niezgodny z hipotezą opisz według tego samego schematu:
Interpretację wszystkich tych wyników – zgodność z literaturą, alternatywne wyjaśnienia i ograniczenia – przenieś do dyskusji. Tam też omów różnicę między relaksacją a grupą kontrolną i wynik dotyczący płci.
Wzór rozdziału w Wordzie
Cały przykładowy rozdział – podrozdziały 4.1–4.5, Tabele 1–3 i Rysunki 1–2 – możesz pobrać jako dokument Word. Tabele mają format APA: numer pogrubiony, tytuł kursywą, tylko poziome linie i notę „Uwaga.”; tekst jest złożony czcionką Times New Roman 12 z interlinią 1,5. Na początku pliku umieściliśmy ramkę z informacją, że to przykład na danych symulowanych.
Jak korzystać z pliku:
- Porównaj układ i kolejność podrozdziałów ze swoim planem analiz. Twoje podrozdziały odpowiadają Twoim hipotezom.
- Usuń ramkę z informacją o przykładzie i wszystkie liczby z przykładu. Zostaw strukturę, styl tabel i sposób zapisu statystyk.
- Dostosuj formatowanie do wymagań uczelni: separator dziesiętny (wiele wydziałów wymaga przecinka), numerację rozdziałów, marginesy i interlinię.
- Tabele są edytowalne w Wordzie. Gotowe tabele APA z tej strony skopiujesz też przyciskiem „Kopiuj tabelę do Worda”.
Plik wygenerowaliśmy w R (pakiety officer i flextable) z tych samych obliczeń co liczby na tej stronie.
Najczęstsze błędy w rozdziale z wynikami
Poniższe usterki łatwo wyeliminować przed oddaniem rozdziału. Jak wprowadzać poprawki po takich uwagach, opisujemy osobno w poradniku poprawki promotora w rozdziale wyników.
| Źle | Dlaczego | Dobrze |
|---|---|---|
| Wklejone wydruki z programu (tabele SPSS z nazwami „Sig.”, „Std. Error”) | To surowy materiał, nie tabela do pracy | Tabela w stylu APA z wybranymi statystykami; jak czytać wydruk, wyjaśniamy we wpisie jak czytać wyniki z SPSS |
| „p = .000” | Program zaokrąglił bardzo małą wartość | „p < .001” |
| Wyniki w kolejności wykonywania analiz | Czytelnik nie wie, która analiza odpowiada na którą hipotezę | Kolejność i nazwy hipotez jak w rozdziale metodologicznym |
| „Wynik jest zgodny z badaniami [autor, rok], co wynika z…” | Interpretacja w wynikach | W wynikach: „Wynik jest zgodny z hipotezą H1”; porównanie z literaturą – w dyskusji |
| Samo p przy każdym teście | Wartość p nie mówi, jak duży jest efekt | Wielkość efektu z 95% CI (d, η², r, ab) |
| Analiza eksploracyjna opisana jak hipoteza, z decyzją „potwierdzona” | Hipoteza po fakcie wprowadza czytelnika w błąd | Osobny podrozdział „Analizy eksploracyjne”, bez decyzji o hipotezie |
| Te same liczby w tabeli i w tekście | Tekst staje się listą liczb | W tekście tylko liczby potrzebne do zrozumienia wyniku, reszta w tabeli |
| Pominięty wynik nieistotny | Czytelnik nie dowie się, co sprawdzono | Pełny opis: statystyki, p, efekt, przedział ufności |
| „Wsparcie wpływa na stres przez samoskuteczność” (dane z jednego pomiaru) | Schemat korelacyjny nie pozwala na wnioski przyczynowe | „Efekt pośredni wsparcia przez samoskuteczność był istotny” |
Kod R
Wszystkie liczby z rozdziału pochodzą z poniższego kodu. Dane i modele wczytuje pierwszy fragment: plik wyniki-apa.R to kod kroków 1–10 z wpisu jak opisać wyniki w stylu APA (dane symulowane, set.seed(443)). Fragmenty uruchamiaj po kolei – korzystają z obiektów utworzonych wcześniej. Wydruki są schowane: rozwiń „Wynik w R”, aby porównać liczby z rozdziałem.
1. Dane, braki i obserwacje odstające
R
# Dane i modele z wpisu „Jak opisać wyniki w stylu APA” (kod kroków 1–10 zapisany jako wyniki-apa.R)
invisible(capture.output(suppressMessages(source("wyniki-apa.R", encoding = "UTF-8"))))
options(contrasts = c("contr.treatment", "contr.poly"))   # przywrócenie domyślnych kontrastów R
library(psych)
nrow(dane)                                     # liczba osób w analizach
analizowane <- c("warunek", "plec", "wiek", paste0("s", 1:6), "stres_post",
                 "wsparcie", "samoskutecznosc", "sen_post")
sum(is.na(dane[, analizowane]))                # braki danych w zmiennych z analiz
table(dane$warunek, dane$plec)                 # płeć w trzech warunkach
round(prop.table(table(dane$warunek, dane$plec), 1) * 100, 1)   # odsetki w wierszach
# obserwacje odstające: odległość od mediany w jednostkach MAD (próg: 3)
odl_mad <- sapply(dane[, c("stres_pre", "stres_post", "wsparcie", "samoskutecznosc")],
                  function(x) abs(x - median(x)) / mad(x))
round(apply(odl_mad, 2, max), 2)               # największa odległość w każdej zmiennej
colSums(odl_mad > 3)                           # liczba wyników powyżej progu
Wynik w R
[1] 180
[1] 0

             kobieta mężczyzna
  kontrola        37        23
  relaksacja      35        25
  uważność        39        21

             kobieta mężczyzna
  kontrola      61.7      38.3
  relaksacja    58.3      41.7
  uważność      65.0      35.0
      stres_pre      stres_post        wsparcie samoskutecznosc
           1.85            2.36            2.70            2.47
      stres_pre      stres_post        wsparcie samoskutecznosc
              0               0               0               0
2. Statystyki opisowe, korelacje i rzetelność
R
zmienne <- c("stres_pre", "stres_post", "wsparcie", "samoskutecznosc")
round(describe(dane[, zmienne])[, c("n", "mean", "sd", "min", "max", "skew", "kurtosis")], 2)
round(cor(dane[, zmienne]), 2)
max(corr.test(dane[, zmienne])$p)              # największe p spośród sześciu korelacji
# stres przed i po treningu w trzech warunkach (tabela 2)
aggregate(cbind(stres_pre, stres_post) ~ warunek, data = dane,
          FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
# rzetelność skali stresu w pierwszym pomiarze (pozycje 4 i 5 przekodowane)
round(c(alfa = alpha(pozycje)$total$raw_alpha, omega = as.numeric(compRelSEM(fit_cfa)[[1]])), 2)
Wynik w R
                  n  mean   sd   min max  skew kurtosis
stres_pre       180  3.14 0.82  1.33   5  0.00    -0.81
stres_post      180  2.74 0.92  1.00   5  0.14    -0.60
wsparcie        180  5.13 0.98  2.42   7 -0.20    -0.25
samoskutecznosc 180 28.74 4.32 19.00  40 -0.01    -0.37
                stres_pre stres_post wsparcie samoskutecznosc
stres_pre            1.00       0.85    -0.38           -0.53
stres_post           0.85       1.00    -0.38           -0.52
wsparcie            -0.38      -0.38     1.00            0.40
samoskutecznosc     -0.53      -0.52     0.40            1.00
[1] 3.590594e-07
     warunek stres_pre.M stres_pre.SD stres_post.M stres_post.SD
1   kontrola        3.25         0.88         3.09          0.95
2 relaksacja        3.04         0.72         2.76          0.81
3   uważność        3.12         0.85         2.37          0.87
 alfa omega
 0.85  0.86
3. Sprawdzenie założeń
R
library(car)
# ANOVA dla H1 i H2: jednorodność wariancji i rozkład reszt
leveneTest(stres_post ~ warunek, data = dane, center = mean)
reszty <- residuals(anova1)
round(c(skosnosc = psych::skew(reszty), kurtoza = psych::kurtosi(reszty)), 2)
shapiro.test(reszty)
oneway.test(stres_post ~ warunek, data = dane)   # test F Welcha – sprawdzenie odporności wyniku
# regresje w analizie mediacji (H3): reszty, wariancja reszt, współliniowość, obserwacje wpływowe
round(c(skosnosc = psych::skew(residuals(m_b)), kurtoza = psych::kurtosi(residuals(m_b))), 2)
bp <- ncvTest(m_b)                               # test stałości wariancji reszt (Breuscha–Pagana)
round(c(chi2 = bp$ChiSquare, df = bp$Df, p = bp$p), 3)
round(vif(m_b), 2)
round(max(cooks.distance(m_b)), 3)               # największa odległość Cooka
Wynik w R
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   2  0.6423 0.5273
      177
skosnosc  kurtoza
    0.10    -0.61

	Shapiro-Wilk normality test

data:  reszty
W = 0.98839, p-value = 0.1476


	One-way analysis of means (not assuming equal variances)

data:  stres_post and warunek
F = 9.4456, num df = 2.00, denom df = 117.53, p-value = 0.000157

skosnosc  kurtoza
    0.07    -0.47
 chi2    df     p
0.095 1.000 0.758
samoskutecznosc        wsparcie
           1.19            1.19
[1] 0.051
4. Hipotezy H1 i H2
R
library(effectsize)
summary(anova1)
eta_squared(anova1, ci = 0.95, alternative = "two.sided", verbose = FALSE)
round(TukeyHSD(anova1)$warunek, 3)
# d Cohena dla par warunków (połączone SD obu porównywanych grup)
d_para <- function(g1, g2) round(cohens_d(dane$stres_post[dane$warunek == g1],
                                          dane$stres_post[dane$warunek == g2])$Cohens_d, 2)
c(H1_kontrola_uwaznosc   = d_para("kontrola", "uważność"),
  H2_relaksacja_uwaznosc = d_para("relaksacja", "uważność"),
  kontrola_relaksacja    = d_para("kontrola", "relaksacja"))
# odsetek osób, u których stres po czterech tygodniach był niższy niż przed treningiem (Rysunek 1)
spadek <- dane$stres_post < dane$stres_pre
rbind(liczba = tapply(spadek, dane$warunek, sum), procent = round(tapply(spadek, dane$warunek, mean) * 100, 1))
Wynik w R
             Df Sum Sq Mean Sq F value  Pr(>F)
warunek       2  15.58   7.788   10.09 7.1e-05 ***
Residuals   177 136.65   0.772
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA

Parameter | Eta2 |       95% CI
-------------------------------
warunek   | 0.10 | [0.03, 0.19]
                      diff    lwr    upr p adj
relaksacja-kontrola -0.325 -0.704  0.054 0.109
uważność-kontrola   -0.719 -1.099 -0.340 0.000
uważność-relaksacja -0.394 -0.774 -0.015 0.039
  H1_kontrola_uwaznosc H2_relaksacja_uwaznosc    kontrola_relaksacja
                  0.79                   0.47                   0.37
        kontrola relaksacja uważność
liczba        33       46.0     55.0
procent       55       76.7     91.7
5. Hipoteza H3
R
cor.test(dane$wsparcie, dane$stres_pre)          # pierwsza część H3
sciezki <- rbind(a      = c(coef(summary(m_a))["wsparcie", ], confint(m_a)["wsparcie", ]),
                 b      = c(coef(summary(m_b))["samoskutecznosc", ], confint(m_b)["samoskutecznosc", ]),
                 c_prim = c(coef(summary(m_b))["wsparcie", ], confint(m_b)["wsparcie", ]),
                 c      = c(coef(summary(m_c))["wsparcie", ], confint(m_c)["wsparcie", ]))
round(sciezki, 3)
round(c(R2_samoskutecznosc = summary(m_a)$r.squared, R2_stres = summary(m_b)$r.squared), 2)
round(bt$t0, 3)                                  # efekt pośredni a × b
round(boot.ci(bt, type = "perc")$percent[4:5], 3)   # 95% CI percentylowy, 5000 prób bootstrapowych
Wynik w R
	Pearson's product-moment correlation

data:  dane$wsparcie and dane$stres_pre
t = -5.4071, df = 178, p-value = 2.04e-07
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.4946897 -0.2426714
sample estimates:
       cor
-0.3756031

       Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
a         1.757      0.303   5.805    0.000  1.160  2.354
b        -0.086      0.013  -6.701    0.000 -0.111 -0.061
c_prim   -0.162      0.057  -2.862    0.005 -0.274 -0.050
c        -0.313      0.058  -5.407    0.000 -0.428 -0.199
R2_samoskutecznosc           R2_stres
              0.16               0.31
[1] -0.151
[1] -0.218 -0.093
6. Analizy dodatkowe i eksploracyjne
R
library(emmeans)
# (a) analiza wrażliwości: ANCOVA z pomiarem wyjściowym stresu
anova(lm(stres_post ~ stres_pre + warunek, data = dane),
      lm(stres_post ~ stres_pre * warunek, data = dane))   # jednakowe nachylenia w grupach?
ancova <- lm(stres_post ~ stres_pre + warunek, data = dane)
Anova(ancova, type = 2)
eta_squared(Anova(ancova, type = 2), partial = TRUE, ci = 0.95, alternative = "two.sided", verbose = FALSE)
emmeans(ancova, pairwise ~ warunek, adjust = "tukey")
# (b) analiza eksploracyjna: warunek × płeć (sumy kwadratów typu III)
aggregate(stres_post ~ warunek + plec, data = dane,
          FUN = function(x) round(c(M = mean(x), SD = sd(x), n = length(x)), 2))
options(contrasts = c("contr.sum", "contr.poly"))
model2 <- lm(stres_post ~ warunek * plec, data = dane)
Anova(model2, type = 3)
eta_squared(Anova(model2, type = 3), partial = TRUE, ci = NULL, verbose = FALSE)
joint_tests(model2, by = "plec")                 # efekt warunku osobno u kobiet i mężczyzn
options(contrasts = c("contr.treatment", "contr.poly"))
# (c) analiza eksploracyjna: jakość snu po treningu (jedno pytanie 1–5)
aggregate(sen_post ~ warunek, data = dane, FUN = function(x) quantile(x, c(.25, .5, .75)))
kruskal.test(sen_post ~ warunek, data = dane)
rank_epsilon_squared(sen_post ~ warunek, data = dane, ci = NULL)
rstatix::dunn_test(dane, sen_post ~ warunek, p.adjust.method = "holm")[, c("group1", "group2", "p.adj")]
Wynik w R
Analysis of Variance Table

Model 1: stres_post ~ stres_pre + warunek
Model 2: stres_post ~ stres_pre * warunek
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    176 31.502
2    174 30.909  2   0.59256 1.6679 0.1917
Anova Table (Type II tests)

Response: stres_post
           Sum Sq  Df F value    Pr(>F)
stres_pre 105.146   1 587.443 < 2.2e-16 ***
warunek    11.805   2  32.978 6.859e-13 ***
Residuals  31.502 176
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type II)

Parameter | Eta2 (partial) |       95% CI
-----------------------------------------
stres_pre |           0.77 | [0.72, 0.81]
warunek   |           0.27 | [0.17, 0.37]
$emmeans
 warunek    emmean     SE  df lower.CL upper.CL
 kontrola     2.98 0.0548 176     2.87     3.08
 relaksacja   2.86 0.0548 176     2.75     2.96
 uważność     2.38 0.0546 176     2.27     2.49

Confidence level used: 0.95

$contrasts
 contrast              estimate     SE  df t.ratio p.value
 kontrola - relaksacja    0.121 0.0777 176   1.557  0.2671
 kontrola - uważność      0.594 0.0774 176   7.672 <0.0001
 relaksacja - uważność    0.473 0.0773 176   6.117 <0.0001

P value adjustment: tukey method for comparing a family of 3 estimates

     warunek      plec stres_post.M stres_post.SD stres_post.n
1   kontrola   kobieta         3.19          0.90        37.00
2 relaksacja   kobieta         3.00          0.80        35.00
3   uważność   kobieta         2.26          0.90        39.00
4   kontrola mężczyzna         2.91          1.02        23.00
5 relaksacja mężczyzna         2.43          0.72        25.00
6   uważność mężczyzna         2.56          0.80        21.00
Anova Table (Type III tests)

Response: stres_post
              Sum Sq  Df   F value    Pr(>F)
(Intercept)  1260.42   1 1691.2541 < 2.2e-16 ***
warunek        11.47   2    7.6921 0.0006293 ***
plec            1.37   1    1.8410 0.1765935
warunek:plec    5.45   2    3.6556 0.0278521 *
Residuals     129.67 174
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type III)

Parameter    | Eta2 (partial)
-----------------------------
warunek      |           0.08
plec         |           0.01
warunek:plec |           0.04
plec = kobieta:
 model term df1 df2 F.ratio p.value
 warunek      2 174  12.352 <0.0001

plec = mężczyzna:
 model term df1 df2 F.ratio p.value
 warunek      2 174   1.947  0.1458

     warunek sen_post.25% sen_post.50% sen_post.75%
1   kontrola         2.00         3.00         4.25
2 relaksacja         2.00         3.00         4.00
3   uważność         3.00         4.00         5.00

	Kruskal-Wallis rank sum test

data:  sen_post by warunek
Kruskal-Wallis chi-squared = 11.14, df = 2, p-value = 0.00381

Epsilon2 (rank)
---------------
0.06
# A tibble: 3 × 3
  group1     group2       p.adj
  <chr>      <chr>        <dbl>
1 kontrola   relaksacja 0.732
2 kontrola   uważność   0.0137
3 relaksacja uważność   0.00694
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2, a plik Word – w pakietach officer i flextable. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.3) [Computer software]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents (R package version 0.7.4) [Computer software]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting (R package version 0.9.11) [Computer software]. https://doi.org/10.32614/CRAN.package.flextable
Lista kontrolna przed oddaniem rozdziału
- Na początku rozdziału jest liczebność analizowanej próby, informacja o brakach danych, wykluczeniach i obserwacjach odstających.
- Statystyki opisowe i korelacje są w tabeli, a tekst wskazuje tylko najważniejsze liczby.
- Rzetelność skal jest podana dla Twojej próby – w jednym miejscu pracy.
- Sprawdzenie założeń zajmuje kilka zdań z liczbami i decyzją, bez wydruków.
- Hipotezy są omówione w kolejności i brzmieniu z rozdziału metodologicznego.
- Przy każdym teście są statystyki opisowe, wynik testu z dokładnym p i wielkość efektu z 95% CI.
- Wyniki nieistotne opisano równie dokładnie jak istotne.
- Analizy spoza planu są w osobnym podrozdziale i oznaczone jako dodatkowe albo eksploracyjne.
- Tabele i rysunki są ponumerowane, przywołane w tekście i mają noty wyjaśniające skróty.
- Na końcu jest tabela hipotez z decyzją, a interpretacja na tle literatury czeka na dyskusję.
Przed obroną sprawdź, czy umiesz wyjaśnić każdą liczbę w rozdziale – typowe pytania komisji zebraliśmy we wpisie pytania na obronie z metodologii i statystyki. Jeśli chcesz, by ktoś wykonał lub sprawdził analizy i przygotował raport statystyczny z opisem metod, wyników i hipotez, który potem omówi z Tobą punkt po punkcie, zobacz analizy statystyczne dla studentów. Pamiętaj, że to Ty odpowiadasz za tekst pracy i musisz rozumieć każdą liczbę, a pomoc w analizie ujawnij zgodnie z zasadami swojej uczelni.
Najczęstsze pytania
Co powinien zawierać rozdział wyniki badań własnych?
Liczebność analizowanej próby z informacją o brakach danych i wykluczeniach, statystyki opisowe i rzetelność skal, krótkie sprawdzenie założeń, weryfikację każdej hipotezy (statystyki opisowe, wynik testu, dokładne p, wielkość efektu z 95% CI), osobno oznaczone analizy eksploracyjne i podsumowanie hipotez. Interpretacja na tle literatury należy do dyskusji.
Czy w rozdziale wyników pisze się, że hipoteza się potwierdziła?
Tak, ale jednym zdaniem i bez interpretacji, np. „Wynik jest zgodny z hipotezą H1” albo „Hipoteza H2 nie została potwierdzona”. Na końcu rozdziału warto zebrać decyzje w tabeli hipotez. Nie pisz, że hipoteza została udowodniona – jedno badanie niczego nie dowodzi.
Czy w rozdziale wyników trzeba powtarzać charakterystykę próby?
Nie, jeśli opisałeś ją w rozdziale metodologicznym – wystarczy odesłanie. W wynikach podaj natomiast liczebność próby, na której wykonano analizy, braki danych i wykluczenia, a w eksperymencie – czy porównywane grupy były podobne na starcie.
Gdzie opisać analizy, których nie było w hipotezach?
W osobnym podrozdziale, np. „Analizy dodatkowe i eksploracyjne”, na końcu rozdziału z wynikami. Każdą analizę oznacz jako nieplanowaną i nie formułuj do niej decyzji o hipotezie. Wynik eksploracyjny omów w dyskusji jako wstępny, wymagający sprawdzenia w kolejnym badaniu.
Ile stron powinien mieć rozdział wyników w pracy magisterskiej?
Nie ma jednej normy – długość zależy od liczby hipotez i analiz oraz od wymagań wydziału. Zwięzłość osiągniesz, umieszczając liczby w tabelach APA, a w tekście tylko najważniejsze wartości. Wydruki z programu i powtarzanie tych samych liczb wydłużają rozdział, nie podnosząc jego jakości.
Czy mogę skopiować przykładowy rozdział wyników do swojej pracy?
Nie. Przykład opiera się na danych symulowanych i służy do nauki struktury, kolejności i zapisu statystyk. Twój rozdział musi opisywać Twoje dane i analizy, a tekst ma być Twój. Wzór możesz wykorzystać jako szkielet: zachowaj układ, ale liczby, nazwy zmiennych i zdania dopasuj do własnego badania.
Powiązane hasła
Przeczytaj też
Rozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →Masz wyniki, ale nie wiesz, jak ułożyć z nich rozdział?
Wykonamy lub sprawdzimy Twoje analizy, przygotujemy raport statystyczny z opisem metod, wyników i hipotez i omówimy go z Tobą tak, byś umiał wyjaśnić każdą liczbę promotorowi i komisji.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Egbewale, B. E., Lewis, M., & Sim, J. (2014). Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study. BMC Medical Research Methodology, 14(1), Article 49. https://doi.org/10.1186/1471-2288-14-49 ● Otwarty dostęp
- Gernsbacher, M. A. (2018). Writing empirical articles: Transparency, reproducibility, clarity, and memorability. Advances in Methods and Practices in Psychological Science, 1(3), 403–414. https://doi.org/10.1177/2515245918754485 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Rucker, D. D., Preacher, K. J., Tormala, Z. L., & Petty, R. E. (2011). Mediation analysis in social psychology: Current practices and new recommendations. Social and Personality Psychology Compass, 5(6), 359–371. https://doi.org/10.1111/j.1751-9004.2011.00355.x
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{egbewale2014bias, author={Egbewale, Bolaji E. and Lewis, Martyn and Sim, Julius}, title={{Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={49}, doi={10.1186/1471-2288-14-49}}@article{gernsbacher2018writing, author={Gernsbacher, Morton Ann}, title={{Writing empirical articles: Transparency, reproducibility, clarity, and memorability}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={3}, pages={403--414}, doi={10.1177/2515245918754485}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}@article{rucker2011mediation, author={Rucker, Derek D. and Preacher, Kristopher J. and Tormala, Zakary L. and Petty, Richard E.}, title={{Mediation analysis in social psychology: Current practices and new recommendations}}, journal={Social and Personality Psychology Compass}, year={2011}, volume={5}, number={6}, pages={359--371}, doi={10.1111/j.1751-9004.2011.00355.x}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}