Co to jest współczynnik VIF?
VIF (ang. variance inflation factor, współczynnik inflacji wariancji) mówi, ile razy wariancja oszacowania współczynnika regresji danego predyktora jest większa, niż byłaby, gdyby ten predyktor nie był skorelowany z pozostałymi predyktorami modelu. To najczęściej raportowana miara współliniowości w regresji wielorakiej i stały element diagnostyki regresji liniowej: VIF = 1 oznacza brak związku z innymi predyktorami, a wartości wyższe – rosnącą część informacji wspólnej z nimi.
VIF liczy się osobno dla każdego predyktora i zawsze dla konkretnego zestawu predyktorów – dodanie lub usunięcie zmiennej zmienia VIF pozostałych. Sam współczynnik nie mówi, czy wynik jest „zły”. Mówi tylko, o ile szersze są przedziały ufności z powodu nakładania się predyktorów. Czym jest samo zjawisko, jakie ma skutki i co z nim robić, opisujemy w haśle o współliniowości; tutaj skupiamy się na wskaźniku: jak go policzyć, odczytać i zaraportować.
Wzór: VIF, tolerancja i pierwiastek z VIF
- R²j – współczynnik determinacji z regresji pomocniczej, w której predyktor j jest przewidywany przez wszystkie pozostałe predyktory modelu;
- tolerancja – część wariancji predyktora j, której nie wyjaśniają pozostałe predyktory (SPSS podaje ją obok VIF);
- √VIF – ile razy większy jest błąd standardowy współczynnika bj niż przy predyktorach nieskorelowanych. VIF = 4 oznacza dwa razy szerszy przedział ufności.
O’Brien (2007) pokazuje, skąd bierze się ta interpretacja. Oszacowana wariancja współczynnika to iloczyn czterech elementów: wariancji reszt, odwrotności liczebności próby, odwrotności wariancji predyktora i właśnie VIF. Współliniowość jest więc tylko jednym z czynników, od których zależy precyzja b – tę samą szerokość przedziału ufności może dać umiarkowany VIF w małej próbie albo wysoki VIF w dużej.
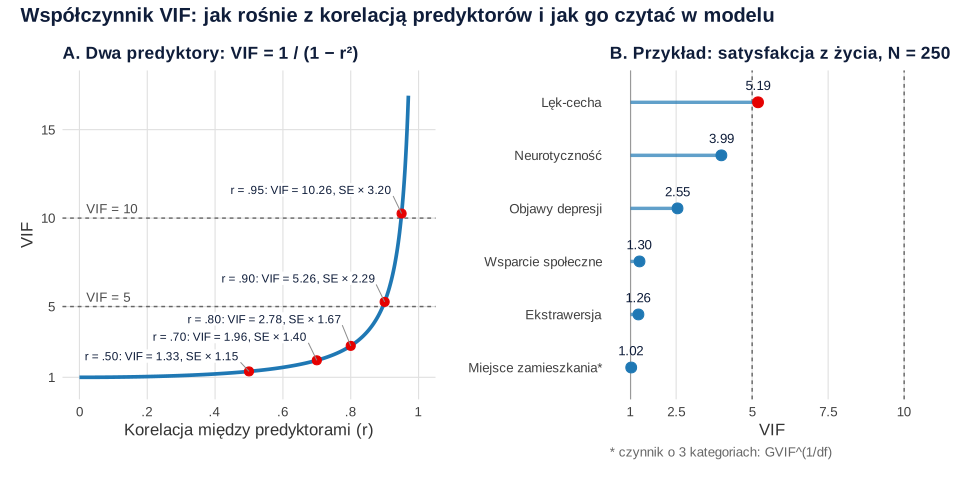
Przy dwóch predyktorach R²j jest po prostu kwadratem ich korelacji Pearsona, więc VIF = 1 / (1 − r²). Panel A rysunku 1 pokazuje, że VIF rośnie powoli do r ≈ .80 (VIF = 2.78), a potem gwałtownie: VIF = 5 odpowiada korelacji .89, a VIF = 10 – korelacji .95.
Progi 5 i 10 – konwencje, nie reguły
W podręcznikach i recenzjach często pojawia się reguła „VIF powyżej 10 (albo 5) oznacza poważną współliniowość”. Kim (2019) podsumowuje ją tak: o współliniowości mówi się zwykle, gdy VIF przekracza 5–10. O’Brien (2007) przestrzega jednak przed mechanicznym stosowaniem takich progów: wartości VIF 10, 20, 40, a nawet wyższe same w sobie nie przekreślają wyników regresji i nie wymagają usuwania predyktorów, łączenia ich w indeks ani regresji grzbietowej. Każdą wartość trzeba oceniać razem z liczebnością próby, R² modelu i zmiennością predyktora, bo to one decydują, czy przedział ufności dla b jest wystarczająco wąski.
| VIF | R²j | Błąd standardowy rośnie | Co zrobić |
|---|---|---|---|
| 1 | 0 | × 1.00 | Nic – predyktor niezależny od pozostałych |
| 2 | .50 | × 1.41 | Zwykle nic; typowe dla powiązanych cech |
| 5 | .80 | × 2.24 | Sprawdź korelacje i szerokość przedziałów ufności |
| 10 | .90 | × 3.16 | Zastanów się, czy predyktory nie mierzą tego samego konstruktu |
Drugie ograniczenie: VIF wskazuje, że predyktor jest współliniowy, ale nie mówi, z którym. Kim (2019) zwraca uwagę, że do tego służą udziały w dekompozycji wariancji (ang. variance decomposition proportions) przy wskaźnikach uwarunkowania powyżej 10–30; w praktyce zwykle wystarczy macierz korelacji predyktorów.
Przykład: VIF w modelu satysfakcji z życia
W badaniu 250 dorosłych (dane symulowane) satysfakcję z życia (skala 5–35) przewidywano neurotycznością, lękiem-cechą, objawami depresji, ekstrawersją, wsparciem społecznym i miejscem zamieszkania (wieś, małe miasto, duże miasto). Model wyjaśniał 57% wariancji, R² = .57, F(7, 242) = 46.01, p < .001. Lęk-cecha korelował z neurotycznością (r = .86) i objawami depresji (r = .76). Wartości VIF z funkcji car::vif() i z ręcznie policzonych regresji pomocniczych są identyczne:
| Predyktor | R²j | Tolerancja | VIF | √VIF |
|---|---|---|---|---|
| Lęk-cecha | .807 | .193 | 5.19 | 2.28 |
| Neurotyczność | .749 | .251 | 3.99 | 2.00 |
| Objawy depresji | .607 | .393 | 2.55 | 1.60 |
| Wsparcie społeczne | .228 | .772 | 1.30 | 1.14 |
| Ekstrawersja | .206 | .794 | 1.26 | 1.12 |
| Miejsce zamieszkania (GVIF, df = 2) | — | — | 1.04 | 1.01* |
Pozostałe predyktory wyjaśniają 81% wariancji lęku-cechy, więc jego błąd standardowy jest 2.28 raza większy niż przy braku współliniowości. Widać to w wyniku: choć lęk korelował z satysfakcją z życia na poziomie r = −.62, jego współczynnik w modelu był bliski zera i nieistotny, b = −0.05, SE = 0.06, p = .401. Neurotyczność (VIF = 3.99) „mieści się” w progu 5, a lęk (VIF = 5.19) go przekracza – ale różnica między tymi wartościami jest niewielka i nie zmienia jakościowo interpretacji. Próg 5 nie dzieli predyktorów na dobre i złe.
Gwiazdka w tabeli oznacza GVIF1/(2·df). Dla czynnika kodowanego kilkoma zmiennymi zero-jedynkowymi (dummy coding) zwykły VIF zależałby od wyboru kategorii odniesienia. Fox i Monette (1992) uogólnili VIF na zestawy kolumn – kategorie zmiennej jakościowej albo składniki wielomianu – i to uogólnienie (GVIF) wypisuje car::vif(). Zgodnie z dokumentacją pakietu car kolumnę GVIF1/(2·df) porównuje się z √VIF: dla miejsca zamieszkania wartość 1.01 oznacza praktyczny brak współliniowości.
VIF da się też odtworzyć z typowej tabeli wyników opublikowanego badania. Thompson i in. (2017) zauważają, że diagnostykę współliniowości rzadko się raportuje, i pokazują, jak policzyć VIF ze współczynnika standaryzowanego β i korelacji semicząstkowej sr: VIF = (β / sr)². Dla lęku β = −0.0807, a sr = −.0354, więc β / sr = 2.279 (to właśnie √VIF), a VIF = 2.279² = 5.19 – tyle samo co z regresji pomocniczej.
Jak opisać VIF w pracy (APA)
VIF podaje się zwykle w jednym zdaniu w części o założeniach albo jako dodatkową kolumnę w tabeli regresji. Zawsze napisz, jaki zakres przyjęły wartości i co z tego wynika dla interpretacji. Wzór dla przykładu:
Jak połączyć opis VIF z diagnostyką reszt i obserwacji wpływowych w jednym rozdziale wyników, pokazujemy w poradniku regresja wieloraka krok po kroku.
Przykład w R i SPSS
Kod tworzy dane z przykładu, szacuje model, liczy VIF funkcją car::vif() i odtwarza go ręcznie z regresji pomocniczych oraz ze współczynnika β i korelacji semicząstkowej. Liczby w tekście i panel B rysunku 1 pochodzą z tego kodu.
VIF, tolerancja i GVIF w modelu regresji wielorakiej
R
suppressPackageStartupMessages({
  library(car)    # vif()
  library(MASS)   # mvrnorm() – tylko do symulacji danych
})

# Dane symulowane: N = 250 dorosłych; satysfakcja z życia (SWLS, 5–35) i sześć predyktorów
set.seed(352)
n <- 250
R <- matrix(c( 1.00,  0.86,  0.66, -0.30, -0.20,
               0.86,  1.00,  0.72, -0.25, -0.25,
               0.66,  0.72,  1.00, -0.25, -0.35,
              -0.30, -0.25, -0.25,  1.00,  0.30,
              -0.20, -0.25, -0.35,  0.30,  1.00), 5, byrow = TRUE)
Z <- mvrnorm(n, mu = rep(0, 5), Sigma = R)
neurotycznosc <- round(pmin(pmax(3.0 + 0.7 * Z[, 1], 1), 5), 2)   # 1–5
lek           <- round(pmin(pmax(44 + 10 * Z[, 2], 20), 80))      # lęk-cecha, 20–80
depresja      <- round(pmin(pmax(8 + 5 * Z[, 3], 0), 27))         # objawy depresji, 0–27
ekstrawersja  <- round(pmin(pmax(3.3 + 0.7 * Z[, 4], 1), 5), 2)   # 1–5
wsparcie      <- round(pmin(pmax(5.4 + 1.0 * Z[, 5], 1), 7), 2)   # wsparcie społeczne, 1–7
miejsce <- factor(sample(c("wieś", "małe miasto", "duże miasto"), n, replace = TRUE, prob = c(.30, .35, .35)),
                  levels = c("wieś", "małe miasto", "duże miasto"))
swls <- round(pmin(pmax(22 - 1.2 * (neurotycznosc - 3) - 0.08 * (lek - 44) - 0.35 * (depresja - 8) +
                        1.0 * (ekstrawersja - 3.3) + 1.6 * (wsparcie - 5.4) + rnorm(n, sd = 4.2), 5), 35))
dane <- data.frame(swls, neurotycznosc, lek, depresja, ekstrawersja, wsparcie, miejsce)
round(cor(dane[, 1:6]), 2)

model <- lm(swls ~ neurotycznosc + lek + depresja + ekstrawersja + wsparcie + miejsce, data = dane)
summary(model)
vif(model)        # dla czynnika miejsce: GVIF i GVIF^(1/(2*Df))

# VIF „ręcznie”: regresja pomocnicza każdego predyktora ilościowego na pozostałe predyktory
pred <- c("neurotycznosc", "lek", "depresja", "ekstrawersja", "wsparcie")
tab <- t(sapply(pred, function(x) {
  r2 <- summary(lm(reformulate(setdiff(c(pred, "miejsce"), x), response = x), data = dane))$r.squared
  c(R2_j = r2, tolerancja = 1 - r2, VIF = 1 / (1 - r2), SE_razy = sqrt(1 / (1 - r2)))
}))
round(tab, 3)

# VIF z typowej tabeli wyników: (beta / korelacja semicząstkowa)^2
beta_lek <- coef(model)["lek"] * sd(dane$lek) / sd(dane$swls)
sr2_lek  <- summary(model)$r.squared - summary(update(model, . ~ . - lek))$r.squared
sr_lek   <- sign(beta_lek) * sqrt(sr2_lek)          # korelacja semicząstkowa (znak jak beta)
round(c(beta = unname(beta_lek), sr = unname(sr_lek), beta_do_sr = unname(beta_lek / sr_lek),
        VIF = unname((beta_lek / sr_lek)^2)), 4)
Wynik w R
               swls neurotycznosc   lek depresja ekstrawersja wsparcie
swls           1.00         -0.61 -0.62    -0.62         0.44     0.51
neurotycznosc -0.61          1.00  0.86     0.67        -0.34    -0.22
lek           -0.62          0.86  1.00     0.76        -0.36    -0.27
depresja      -0.62          0.67  0.76     1.00        -0.31    -0.38
ekstrawersja   0.44         -0.34 -0.36    -0.31         1.00     0.35
wsparcie       0.51         -0.22 -0.27    -0.38         0.35     1.00

Call:
lm(formula = swls ~ neurotycznosc + lek + depresja + ekstrawersja +
    wsparcie + miejsce, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-12.4304  -2.8990  -0.0553   3.2893  10.0294

Coefficients:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)        19.04260    2.68548   7.091 1.46e-11 ***
neurotycznosc      -2.41107    0.73598  -3.276  0.00121 **
lek                -0.05126    0.06097  -0.841  0.40131
depresja           -0.27550    0.08307  -3.316  0.00105 **
ekstrawersja        1.30258    0.41268   3.156  0.00180 **
wsparcie            1.89623    0.31489   6.022 6.36e-09 ***
miejscemałe miasto  0.45460    0.68357   0.665  0.50666
miejsceduże miasto -0.36444    0.69250  -0.526  0.59918
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 4.238 on 242 degrees of freedom
Multiple R-squared:  0.571,	Adjusted R-squared:  0.5586
F-statistic: 46.01 on 7 and 242 DF,  p-value: < 2.2e-16

                  GVIF Df GVIF^(1/(2*Df))
neurotycznosc 3.987725  1        1.996929
lek           5.193401  1        2.278903
depresja      2.545135  1        1.595348
ekstrawersja  1.259729  1        1.122377
wsparcie      1.295300  1        1.138113
miejsce       1.044680  2        1.010988
               R2_j tolerancja   VIF SE_razy
neurotycznosc 0.749      0.251 3.988   1.997
lek           0.807      0.193 5.193   2.279
depresja      0.607      0.393 2.545   1.595
ekstrawersja  0.206      0.794 1.260   1.122
wsparcie      0.228      0.772 1.295   1.138
      beta         sr beta_do_sr        VIF
   -0.0807    -0.0354     2.2789     5.1934
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Traktowanie progów 5 i 10 jak testu statystycznego. VIF = 4.9 i VIF = 5.1 opisują praktycznie tę samą sytuację; oceniaj szerokość przedziałów ufności (O’Brien, 2007).
- Usuwanie ważnego teoretycznie predyktora tylko z powodu wysokiego VIF. Zmienia to pytanie badawcze i może obciążyć pozostałe współczynniki – zob. współliniowość.
- Liczenie VIF dla pojedynczych zmiennych zero-jedynkowych jednego czynnika. Dla zmiennej kategorialnej o kilku poziomach używaj GVIF (Fox i Monette, 1992).
- Panika przy wysokim VIF w modelu z interakcją lub kwadratem predyktora. X i X² albo X i X·Z są skorelowane z definicji; wycentrowanie zmiennych obniża VIF składników niższego rzędu, ale nie zmienia testu składnika najwyższego rzędu – zob. regresja krzywoliniowa i moderacja.
- Raportowanie VIF bez modelu. VIF zależy od zestawu predyktorów; podawaj go dla modelu, który interpretujesz.
- Traktowanie niskiego VIF jak dowodu poprawności modelu. VIF nie mówi nic o nieliniowości, heteroskedastyczności ani obserwacjach wpływowych – te sprawdzasz na resztach, za pomocą odległości Cooka, a w danych zbieranych w czasie – testem Durbina-Watsona.
Najczęstsze pytania
Co to jest VIF w regresji?
VIF (variance inflation factor) mówi, ile razy wariancja współczynnika regresji danego predyktora jest większa, niż byłaby, gdyby predyktor nie był skorelowany z pozostałymi. VIF = 1 oznacza brak współliniowości, a VIF = 4 – dwukrotnie większy błąd standardowy współczynnika.
Jak obliczyć VIF?
Przeprowadź regresję pomocniczą: przewiduj dany predyktor wszystkimi pozostałymi predyktorami modelu i odczytaj R²j. VIF = 1/(1 − R²j). W przykładzie z tej strony R²j = .807, więc VIF = 1/(1 − .807) = 5.19. W R: car::vif(model).
Jaki VIF jest za wysoki?
Często przyjmuje się progi 5 albo 10, ale to konwencje. O’Brien (2007) pokazuje, że nawet bardzo wysokie VIF same w sobie nie przekreślają wyników – trzeba je oceniać razem z liczebnością próby, R² modelu i szerokością przedziałów ufności. VIF powyżej 5 to sygnał, by sprawdzić korelacje predyktorów i sens ich jednoczesnego użycia.
Czym różni się VIF od tolerancji?
To ta sama informacja w dwóch postaciach: tolerancja = 1 − R²j = 1/VIF. Tolerancja .20 odpowiada VIF = 5, a tolerancja .10 – VIF = 10. SPSS podaje obie wartości w tabeli współczynników.
Co to jest GVIF w pakiecie car?
GVIF to uogólniony VIF dla predyktorów opisanych kilkoma kolumnami, np. zmiennej kategorialnej zakodowanej zmiennymi zero-jedynkowymi albo wielomianu (Fox i Monette, 1992). Funkcja car::vif() wypisuje też GVIF1/(2·df), który porównuje się z √VIF.
Czy wysoki VIF przy interakcji jest problemem?
Zwykle nie. Iloczyn X·Z albo kwadrat X² są z definicji skorelowane ze swoimi składnikami, więc mają wysokie VIF. Wycentrowanie predyktorów obniża VIF składników niższego rzędu, ale nie zmienia testu interakcji ani składnika kwadratowego.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Diagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWysoki VIF – co zrobić ze współliniowością?
Kiedy wysoki VIF jest problemem, a kiedy nie, dlaczego nie usuwać predyktorów tylko z jego powodu i jak opisać współliniowość w pracy – z przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fox, J., & Monette, G. (1992). Generalized collinearity diagnostics. Journal of the American Statistical Association, 87(417), 178–183. https://doi.org/10.1080/01621459.1992.10475190
- Kim, J. H. (2019). Multicollinearity and misleading statistical results. Korean Journal of Anesthesiology, 72(6), 558–569. https://doi.org/10.4097/kja.19087 ● Otwarty dostęp
- O’Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Thompson, C. G., Kim, R. S., Aloe, A. M., & Becker, B. J. (2017). Extracting the variance inflation factor and other multicollinearity diagnostics from typical regression results. Basic and Applied Social Psychology, 39(2), 81–90. https://doi.org/10.1080/01973533.2016.1277529
Cytowania BibTeX
@article{fox1992generalized, author={Fox, John and Monette, Georges}, title={{Generalized collinearity diagnostics}}, journal={Journal of the American Statistical Association}, year={1992}, volume={87}, number={417}, pages={178--183}, doi={10.1080/01621459.1992.10475190}}@article{kim2019multicollinearity, author={Kim, Jong Hae}, title={{Multicollinearity and misleading statistical results}}, journal={Korean Journal of Anesthesiology}, year={2019}, volume={72}, number={6}, pages={558--569}, doi={10.4097/kja.19087}}@article{obrien2007caution, author={O’Brien, Robert M.}, title={{A caution regarding rules of thumb for variance inflation factors}}, journal={Quality \& Quantity}, year={2007}, volume={41}, number={5}, pages={673--690}, doi={10.1007/s11135-006-9018-6}}@article{thompson2017extracting, author={Thompson, Christopher Glen and Kim, Rae Seon and Aloe, Ariel M. and Becker, Betsy Jane}, title={{Extracting the variance inflation factor and other multicollinearity diagnostics from typical regression results}}, journal={Basic and Applied Social Psychology}, year={2017}, volume={39}, number={2}, pages={81--90}, doi={10.1080/01973533.2016.1277529}}