Co to jest dummy coding?
Dummy coding (kodowanie zero-jedynkowe, ang. dummy coding lub treatment coding) to sposób wprowadzenia do regresji predyktora jakościowego – zmiennej na skali nominalnej, np. grupy eksperymentalnej, kierunku studiów czy miejsca zamieszkania. Zmienną o k kategoriach zastępuje się k − 1 zmiennymi zero-jedynkowymi (ang. dummy variables). Każda z nich mówi, czy osoba należy do danej kategorii (1), czy nie (0). Kategoria, która ma zera we wszystkich zmiennych, to kategoria odniesienia.
Dzięki takiemu kodowaniu regresja wieloraka i analiza wariancji stają się jednym systemem. Cohen (1968) pokazywał psychologom, że regresja wieloraka i ANOVA z efektami stałymi są tożsame, a kluczem jest właśnie wyrażenie danych nominalnych jako predyktorów regresji. Program buduje z nich kolumny macierzy modelowej; R robi to automatycznie dla zmiennej typu factor.
Jak utworzyć zmienne zero-jedynkowe: k − 1, nie k
Dla trzech grup – listy oczekujących (kontrola), treningu uważności i terapii CBT online – potrzebne są dwie zmienne. Jeśli odniesieniem ma być kontrola, kodowanie wygląda tak:
| Grupa | duważność | dCBT | Przewidywana średnia |
|---|---|---|---|
| Lista oczekujących (odniesienie) | 0 | 0 | b0 |
| Trening uważności | 1 | 0 | b0 + b1 |
| CBT online | 0 | 1 | b0 + b2 |
Dlaczego nie trzy zmienne? Suits (1957) wyjaśnił, że przy zmiennych zero-jedynkowych trzeba nałożyć dodatkowe ograniczenie, by model dał się oszacować: usunąć stałą albo – co praktyczniejsze – pominąć jedną zmienną z każdego zestawu. Trzy zmienne razem ze stałą to współliniowość doskonała: suma trzech zmiennych zawsze wynosi 1, czyli dokładnie tyle co stała. W przykładzie R w takiej sytuacji po cichu usuwa ostatnią zmienną (współczynnik NA) i sam wybiera inną kategorię odniesienia.
Kategorię odniesienia wybierz świadomie: najlepiej taką, z którą porównania odpowiadają na pytanie badawcze (zwykle grupa kontrolna), i niezbyt małą. W modelu, w którym jedynym predyktorem jest grupa, każda osoba z małej kategorii ma wysoką dźwignię, więc pojedyncze wyniki mocno wpływają na oszacowania (zob. odległość Cooka). Gdy kategorie trzeba najpierw zamienić na liczby, pomoże hasło rekodowanie i poradnik o przygotowaniu danych z Google Forms i LimeSurvey do SPSS i R.
Przykład: trzy formy pomocy a objawy lęku
W badaniu z losowym przydziałem (dane symulowane) 91 osób z objawami lęku trafiło na listę oczekujących (n = 32), do treningu uważności (n = 29) albo na terapię CBT online (n = 30). Po ośmiu tygodniach średnie nasilenie objawów (GAD-7, 0–21) wynosiło 11.16, 8.93 i 7.43. Regresja z kodowaniem zero-jedynkowym odtwarza te średnie dokładnie:
Tabela 1
Regresja objawów lęku na grupę (kodowanie zero-jedynkowe; odniesienie: lista oczekujących)
| Predyktor | b | SE | 95% CI | t | p |
|---|---|---|---|---|---|
| Stała (lista oczekujących) | 11.16 | 0.62 | [9.92, 12.39] | 18.00 | < .001 |
| Trening uważności (vs lista) | −2.23 | 0.90 | [−4.01, −0.44] | −2.48 | .015 |
| CBT online (vs lista) | −3.72 | 0.89 | [−5.49, −1.95] | −4.18 | < .001 |
Uwaga. N = 91. R² = .17, F(2, 88) = 8.88, p < .001. Objawy lęku mierzono skalą GAD-7 (0–21) po 8 tygodniach. CI = przedział ufności. Dane symulowane.
- Stała (11.16) to średnia grupy odniesienia.
- Każdy współczynnik to różnica średnich między daną grupą a grupą odniesienia: 8.93 − 11.16 = −2.23 dla uważności i 7.43 − 11.16 = −3.72 dla CBT. Test t współczynnika jest więc testem tej różnicy.
- Test F całego modelu, F(2, 88) = 8.88, p < .001, jest identyczny z jednoczynnikową ANOVA, a R² = .17 to eta kwadrat.
- Przy dwóch grupach jedna zmienna zero-jedynkowa daje ten sam wynik co test t dla prób niezależnych w wersji z równymi wariancjami.
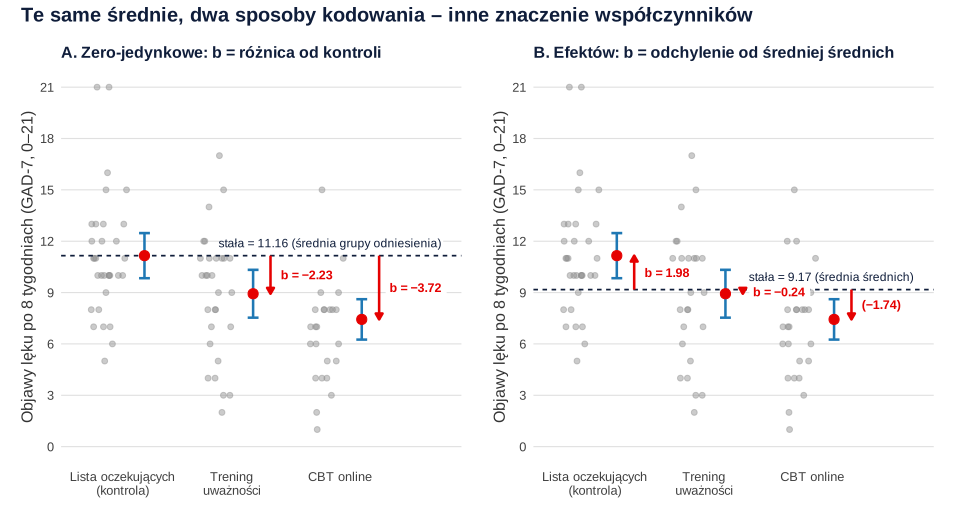
Model nie mówi natomiast nic wprost o różnicy między uważnością a CBT. Wystarczy zmienić kategorię odniesienia (w R: relevel()): CBT miało objawy niższe o 1.50 punktu niż trening uważności, ale różnica była nieistotna, p = .104. Przy wielu porównaniach parami zastosuj testy post hoc z korektą. Rysunek 1A pokazuje współczynniki jako strzałki od średniej grupy odniesienia.
Kodowanie efektów – inna stała, inne pytanie
W kodowaniu efektów (ang. effect coding, w R contr.sum) kategoria odniesienia dostaje we wszystkich zmiennych −1 zamiast 0. Alkharusi (2012) pokazuje, że oba sposoby dają identyczne R² i F, ale zmienia się znaczenie stałej i współczynników. Przy kodowaniu efektów stała to średnia ogólna, a współczynnik – odchylenie średniej danej grupy od niej. Przy nierównych liczebnościach grup stała jest nieważoną średnią średnich grupowych, a nie średnią wszystkich osób. W przykładzie stała wynosi 9.17, podczas gdy średnia całej próby to 9.22; lista oczekujących leży o 1.98 punktu powyżej średniej średnich, trening uważności o 0.24 poniżej, a CBT – o 1.74 poniżej (rysunek 1B).
| Cecha | Kodowanie zero-jedynkowe | Kodowanie efektów |
|---|---|---|
| Kod kategorii odniesienia | 0 we wszystkich zmiennych | −1 we wszystkich zmiennych |
| Stała | Średnia grupy odniesienia (11.16) | Nieważona średnia średnich (9.17) |
| Współczynnik | Różnica od grupy odniesienia | Odchylenie od średniej średnich |
| Kiedy stosować | Porównania z grupą kontrolną | Efekty główne w planach czynnikowych, porównanie z „przeciętną grupą” |
| R, SPSS | contr.treatment (domyślne w R); kontrast Prosty w GLM | contr.sum; kontrast Odchylenie w GLM |
Wybór kodowania ma największe znaczenie w modelach z interakcją: przy kodowaniu zero-jedynkowym „efekt główny” jednego czynnika to w istocie efekt prosty w kategorii odniesienia drugiego. Schad i in. (2020) w poradniku do R omawiają też inne kontrasty – powtarzane, wielomianowe i własne – które pozwalają testować wprost hipotezy zaplanowane przed zebraniem danych. Kontrasty wielomianowe przydają się dla kategorii uporządkowanych, np. trzech dawek interwencji, bo testują trend liniowy i kwadratowy (zob. regresja krzywoliniowa). Polskojęzyczne omówienie interakcji zmiennych kategorialnych z ciągłymi w regresji i ANOVA, z przykładami w SPSS, przygotował Sosnowski (2010).
Jak opisać wyniki w pracy (APA)
Zawsze podaj, jak zakodowano zmienną i która kategoria była odniesieniem – bez tego czytelnik nie zinterpretuje współczynników. Wzór dla przykładu:
Model z predyktorami zero-jedynkowymi sprawdzasz tak samo jak każdą regresję – na resztach i obserwacjach wpływowych; współliniowość zestawu zmiennych jednego czynnika oceniaj uogólnionym VIF (GVIF). Przykład modelu łączącego predyktory ilościowe i jakościowe znajdziesz w poradniku regresja wieloraka krok po kroku, a tę samą analizę w ujęciu ANOVA – w tekście ANOVA krok po kroku.
Przykład w R i SPSS
Kod tworzy dane z przykładu, pokazuje macierz kodowania, szacuje regresję z kodowaniem zero-jedynkowym, porównuje ją z ANOVA, zmienia kategorię odniesienia, liczy model z kodowaniem efektów i demonstruje pułapkę zmiennych zero-jedynkowych. Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu.
Kodowanie zero-jedynkowe i kodowanie efektów w lm()
R
# Dane symulowane: badanie z losowym przydziałem, objawy lęku (GAD-7, 0–21) po 8 tygodniach
# w trzech grupach: lista oczekujących (kontrola), trening uważności, terapia CBT online
set.seed(403)
nk <- c(32, 29, 30)
grupa <- factor(rep(c("kontrola", "uważność", "CBT"), nk), levels = c("kontrola", "uważność", "CBT"))
srednie_pop <- c(kontrola = 11.0, `uważność` = 9.0, CBT = 7.3)
lek <- round(pmin(pmax(srednie_pop[as.character(grupa)] + rnorm(sum(nk), sd = 3.6), 0), 21))
dane <- data.frame(grupa, lek)
round(tapply(dane$lek, dane$grupa, mean), 2)            # średnie w grupach

# 1. Kodowanie zero-jedynkowe (domyślne w R): k − 1 = 2 zmienne, kategoria odniesienia = kontrola
contrasts(dane$grupa)
unique(model.matrix(~ grupa, data = dane))               # jak wygląda macierz modelu dla każdej grupy
model <- lm(lek ~ grupa, data = dane)
summary(model)
round(confint(model), 2)

# Ten sam test F co w jednoczynnikowej ANOVA
anova(model)

# 2. Inna kategoria odniesienia: porównanie CBT z treningiem uważności
dane$grupa_u <- relevel(dane$grupa, ref = "uważność")
round(summary(lm(lek ~ grupa_u, data = dane))$coefficients, 3)

# 3. Kodowanie efektów (contr.sum): stała = średnia średnich grupowych, b = odchylenie grupy od niej
dane$grupa_e <- dane$grupa
contrasts(dane$grupa_e) <- contr.sum(3)
contrasts(dane$grupa_e)
round(coef(lm(lek ~ grupa_e, data = dane)), 3)
round(c(srednia_srednich = mean(tapply(dane$lek, dane$grupa, mean)), srednia_ogolna = mean(dane$lek)), 3)

# 4. Pułapka zmiennych zero-jedynkowych: k zmiennych + stała = współliniowość doskonała
dane$d_kontrola <- as.numeric(dane$grupa == "kontrola")
dane$d_uwaznosc <- as.numeric(dane$grupa == "uważność")
dane$d_cbt      <- as.numeric(dane$grupa == "CBT")
coef(lm(lek ~ d_kontrola + d_uwaznosc + d_cbt, data = dane))
Wynik w R
kontrola uważność      CBT
   11.16     8.93     7.43
         uważność CBT
kontrola        0   0
uważność        1   0
CBT             0   1
   (Intercept) grupauważność grupaCBT
1            1             0        0
33           1             1        0
62           1             0        1

Call:
lm(formula = lek ~ grupa, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-6.9310 -2.0436 -0.1563  2.0690  9.8438

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)    11.1562     0.6197  18.002  < 2e-16 ***
grupauważność  -2.2252     0.8988  -2.476   0.0152 *
grupaCBT       -3.7229     0.8909  -4.179 6.89e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 3.506 on 88 degrees of freedom
Multiple R-squared:  0.1679,	Adjusted R-squared:  0.149
F-statistic: 8.876 on 2 and 88 DF,  p-value: 0.000308

              2.5 % 97.5 %
(Intercept)    9.92  12.39
grupauważność -4.01  -0.44
grupaCBT      -5.49  -1.95
Analysis of Variance Table

Response: lek
          Df  Sum Sq Mean Sq F value   Pr(>F)
grupa      2  218.16 109.078   8.876 0.000308 ***
Residuals 88 1081.45  12.289
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                Estimate Std. Error t value Pr(>|t|)
(Intercept)        8.931      0.651  13.720    0.000
grupa_ukontrola    2.225      0.899   2.476    0.015
grupa_uCBT        -1.498      0.913  -1.641    0.104
         [,1] [,2]
kontrola    1    0
uważność    0    1
CBT        -1   -1
(Intercept)    grupa_e1    grupa_e2
      9.174       1.983      -0.243
srednia_srednich   srednia_ogolna
           9.174            9.220
(Intercept)  d_kontrola  d_uwaznosc       d_cbt
   7.433333    3.722917    1.497701          NA
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Kategorie zakodowane jako 1, 2, 3 i wprowadzone jako jedna zmienna liczbowa. Model zakłada wtedy, że grupy są uporządkowane i równo od siebie oddalone. Dla zmiennej nominalnej zawsze twórz k − 1 zmiennych zero-jedynkowych (w R:
factor()). - Wszystkie k zmiennych w modelu ze stałą. To współliniowość doskonała; program usunie jedną zmienną sam i zmieni kategorię odniesienia bez pytania.
- Brak informacji o kategorii odniesienia w tekście lub tabeli – współczynnik −2.23 nic nie znaczy bez „w porównaniu z czym”.
- Ocenianie czynnika po pojedynczych współczynnikach. Czy grupa ma znaczenie, mówi test łączny wszystkich zmiennych zero-jedynkowych (F), a nie istotność jednej z nich.
- Różne domyślne ustawienia programów. R przyjmuje jako odniesienie pierwszą kategorię (alfabetycznie, jeśli nie ustawisz poziomów), a tabela parametrów w GLM SPSS – ostatnią. Sprawdź to przed interpretacją.
- Kodowanie efektów przy nierównych grupach opisane jako „różnica od średniej ogólnej”. To odchylenie od nieważonej średniej średnich (Alkharusi, 2012).
- Kategoria „inne” albo bardzo mała grupa jako odniesienie. Porównania z niejasną lub nieliczną grupą są trudne do interpretacji i niestabilne.
Zmienne zero-jedynkowe przydają się także w danych zbieranych w czasie, np. do kodowania dni tygodnia w badaniu dzienniczkowym – wtedy oprócz kodowania sprawdź autokorelację reszt (test Durbina-Watsona).
Najczęstsze pytania
Co to jest dummy coding?
To zamiana zmiennej kategorialnej (np. grupy) na zestaw zmiennych 0/1, które można wprowadzić do regresji. Przy k kategoriach tworzy się k − 1 zmiennych; kategoria z samymi zerami jest kategorią odniesienia, z którą porównywane są pozostałe.
Dlaczego zmiennych zero-jedynkowych jest k − 1, a nie k?
Bo suma wszystkich k zmiennych zawsze wynosi 1, czyli dokładnie tyle co stała modelu. Taka współliniowość doskonała uniemożliwia oszacowanie modelu – program usunie wtedy jedną zmienną sam (w R pojawi się NA) i po cichu zmieni kategorię odniesienia.
Jak interpretować współczynniki zmiennych zero-jedynkowych?
Stała to średnia kategorii odniesienia, a każdy współczynnik to różnica między średnią danej kategorii a średnią kategorii odniesienia (w modelu z innymi predyktorami – różnica przy ich stałych wartościach). W przykładzie z tej strony b = −2.23 oznacza, że po treningu uważności objawy były średnio o 2.23 punktu niższe niż na liście oczekujących.
Którą kategorię wybrać jako odniesienie?
Tę, z którą porównania odpowiadają na pytanie badawcze – zwykle grupę kontrolną lub najbardziej typową. Unikaj kategorii bardzo małych i niejasnych (np. „inne”). Porównania pozostałych grup między sobą uzyskasz, zmieniając odniesienie (w R: relevel()) albo testami post hoc.
Czym różni się dummy coding od effect coding?
Przy kodowaniu efektów kategoria odniesienia ma −1 zamiast 0. Stała to wtedy średnia średnich grupowych (przy nierównych grupach – nieważona), a współczynniki to odchylenia grup od niej. R² i test F są w obu przypadkach identyczne (Alkharusi, 2012).
Jak zrobić zmienne zero-jedynkowe w SPSS?
Najprościej przez Przekształcenia → Rekoduj na inne zmienne: dla każdej kategorii poza odniesieniem utwórz zmienną z wartością 1 dla tej kategorii i 0 dla pozostałych. Alternatywnie użyj procedury Ogólny model liniowy z kontrastem Prosty – pamiętaj, że SPSS w tabeli parametrów traktuje ostatnią kategorię jako odniesienie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Alkharusi, H. (2012). Categorical variables in regression analysis: A comparison of dummy and effect coding. International Journal of Education, 4(2), 202–210. https://doi.org/10.5296/ije.v4i2.1962 ● Otwarty dostęp
- Cohen, J. (1968). Multiple regression as a general data-analytic system. Psychological Bulletin, 70(6, Pt.1), 426–443. https://doi.org/10.1037/h0026714
- Schad, D. J., Vasishth, S., Hohenstein, S., & Kliegl, R. (2020). How to capitalize on a priori contrasts in linear (mixed) models: A tutorial. Journal of Memory and Language, 110, Article 104038. https://doi.org/10.1016/j.jml.2019.104038 ● Otwarty dostęp
- Sosnowski, T. (2010). Analiza interakcji zmiennych kategorialnych i ciągłych. Psychologia Społeczna, 5(2–3), 162–190. https://www.ceeol.com/search/article-detail?id=229293 ● Otwarty dostęp
- Suits, D. B. (1957). Use of dummy variables in regression equations. Journal of the American Statistical Association, 52(280), 548–551. https://doi.org/10.1080/01621459.1957.10501412
Cytowania BibTeX
@article{alkharusi2012categorical, author={Alkharusi, Hussain}, title={{Categorical variables in regression analysis: A comparison of dummy and effect coding}}, journal={International Journal of Education}, year={2012}, volume={4}, number={2}, pages={202--210}, doi={10.5296/ije.v4i2.1962}}@article{cohen1968multiple, author={Cohen, Jacob}, title={{Multiple regression as a general data-analytic system}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={6, Pt.1}, pages={426--443}, doi={10.1037/h0026714}}@article{schad2020capitalize, author={Schad, Daniel J. and Vasishth, Shravan and Hohenstein, Sven and Kliegl, Reinhold}, title={{How to capitalize on a priori contrasts in linear (mixed) models: A tutorial}}, journal={Journal of Memory and Language}, year={2020}, volume={110}, eid={104038}, doi={10.1016/j.jml.2019.104038}}@article{sosnowski2010analiza, author={Sosnowski, Tytus}, title={{Analiza interakcji zmiennych kategorialnych i ciągłych}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={162--190}, url={https://www.ceeol.com/search/article-detail?id=229293}}@article{suits1957use, author={Suits, Daniel B.}, title={{Use of dummy variables in regression equations}}, journal={Journal of the American Statistical Association}, year={1957}, volume={52}, number={280}, pages={548--551}, doi={10.1080/01621459.1957.10501412}}