Co to jest data mining?
Data mining (eksploracja danych, drążenie danych, ang. data mining) to wyszukiwanie wzorców, zależności i reguł w dużych zbiorach danych. Używa się do tego algorytmów statystycznych i uczenia maszynowego, a celem jest zwykle przewidywanie albo opis struktury, a nie testowanie z góry postawionej hipotezy. Typowe zadania to przewidywanie wyniku (regresja, klasyfikacja), wyodrębnianie grup podobnych osób (analiza skupień), szukanie reguł współwystępowania i wykrywanie nietypowych przypadków.
W psychologii data mining pojawia się przy danych z aplikacji, platform e-learningowych, mediów społecznościowych, rejestrów medycznych czy dużych badań ankietowych. Yarkoni i Westfall (2017) przekonują, że skupienie psychologii na wyjaśnianiu przyczyn zachowania dało teorie o małej lub nieznanej zdolności przewidywania. Ich zdaniem narzędzia uczenia maszynowego mogą uczynić ją nauką bardziej predykcyjną.
Termin ma w metodologii dwa znaczenia i warto je rozróżniać:
- Data mining jako metoda – uprawniona, jawna eksploracja z walidacją na nowych danych.
- „Data dredging”, czyli łowienie wyników – przeszukiwanie danych, aż coś wyjdzie istotne, i przedstawianie tego jako potwierdzenia hipotezy. To odmiana p-hackingu i HARKingu.
Różnicy nie wyznacza technika, tylko uczciwość procedury: czy wynik sprawdzono na danych, których nie użyto do jego znalezienia.
Wyjaśnianie a przewidywanie
Shmueli (2010) wyjaśnia, że modelowanie wyjaśniające (przyczynowe) i predykcyjne to różne cele. Model, który dobrze wyjaśnia w sensie teoretycznym, nie musi dobrze przewidywać. Różnica ma konsekwencje na każdym etapie analizy:
| Element | Model wyjaśniający (typowa praca z psychologii) | Data mining / model predykcyjny |
|---|---|---|
| Pytanie | Czy X wpływa na Y i jak silnie? | Jak trafnie przewidzieć Y u nowych osób? |
| Dobór zmiennych | Z teorii, przed analizą | Z danych, ale z walidacją |
| Miara sukcesu | Nieobciążone współczynniki, poprawne p i CI | Błąd prognozy na danych testowych |
| Typowe metody | Regresja wieloraka, SEM | Lasso, drzewa i lasy losowe, sieci neuronowe |
| Główne zagrożenie | Zmienne zakłócające, błąd pomiaru | Przeuczenie (overfitting), wyciek informacji |
Przeuczenie i walidacja
Model dopasowany do konkretnej próby uczy się nie tylko prawdziwych zależności, ale też przypadkowego szumu. Babyak (2004) opisuje to zjawisko jako przeuczenie (overfitting). Przy danej liczbie obserwacji złożoność modelu ma górną granicę, a automatyczny dobór zmiennych i wstępne testowanie kandydatów prowadzą do wyników, które nie powtarzają się w nowych próbach. Dlatego w data mining podstawą jest walidacja:
- Podział na próbę uczącą i testową – model budujesz na jednej części, oceniasz na drugiej, której wcześniej nie widział.
- Walidacja krzyżowa (k-fold cross-validation) – dane dzieli się na k części; każda raz służy do testu, a pozostałe do uczenia. Służy m.in. do doboru siły kary w lasso czy głębokości drzewa.
- Regularyzacja – metody z karą za złożoność (lasso, regresja grzbietowa) „ściągają” współczynniki ku zeru i ograniczają przeuczenie.
Walidacja działa tylko wtedy, gdy obejmuje całą procedurę budowy modelu. Jeśli zmienne wybierasz na pełnym zbiorze, a dopiero potem dzielisz go na części, próba testowa „widziała” już dane i ocena jest zbyt optymistyczna. Dobór zmiennych, standaryzację i imputację braków wykonuj więc osobno w każdej części uczącej.
Przykład: przewidywanie zamiaru rezygnacji ze studiów
Uczelnia ma dane 300 studentów pierwszego roku (dane symulowane). Zebrano zamiar rezygnacji ze studiów (0–10) i 40 cech z ankiety oraz platformy e-learningowej, np. liczbę logowań, terminowość zadań, poczucie przynależności. W rzeczywistości działają tylko cztery cechy, a 36 to szum. Model budujemy na 200 osobach, a trafność sprawdzamy na pozostałych 100.
Łowienie korelacji. W próbie uczącej siedem z 40 cech korelowało istotnie (p < .05) z zamiarem rezygnacji: cztery prawdziwe i trzy przypadkowe. Gdyby ktoś opisał wszystkie siedem jako „czynniki ryzyka”, trzy byłyby fałszywymi odkryciami – to problem wielokrotnych porównań w czystej postaci.
Porównanie modeli. Rysunek 1 pokazuje R² w próbie uczącej i testowej:
- Regresja ze wszystkimi 40 cechami wyjaśniała 55.6% wariancji w próbie uczącej, ale tylko 18.0% w testowej.
- Lasso z karą dobraną 10-krotną walidacją krzyżową zostawiło dokładnie cztery prawdziwe cechy. W próbie uczącej wyjaśniało mniej (36.8%), za to w testowej najwięcej – 32.5%. Model prawdziwy, ze znanymi współczynnikami, osiągnąłby w próbie testowej 38.1%.
- Drzewo regresyjne bez przycinania dopasowało się do próby uczącej niemal idealnie (R² = .883). Na nowych danych przewidywało gorzej niż sama średnia: R² = −.421. Przycięcie drzewa walidacją krzyżową ograniczyło szkodę, ale nie pomogło (−.071), bo zależności w tych danych są liniowe, a drzewo przybliża je schodkami.
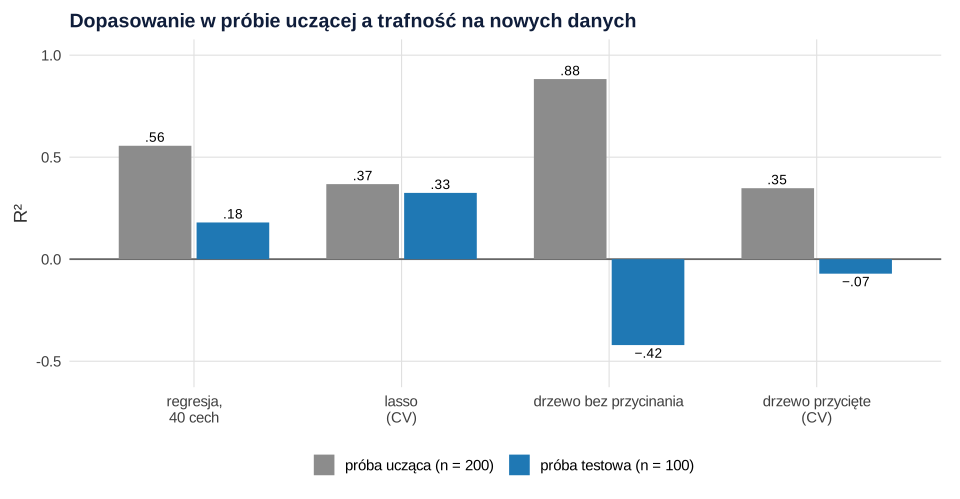
Lekcja z przykładu: dopasowanie w próbie, na której budowano model, nie mówi, jak model sprawdzi się u nowych osób. Wybór metody nie jest uniwersalny – lasso wygrało tu dlatego, że dane miały prostą, liniową strukturę. Przy zależnościach nieliniowych i interakcjach drzewa lub lasy losowe mogłyby wypaść lepiej. Rozstrzyga walidacja, a nie dopasowanie.
Data mining w pracy dyplomowej – dobre praktyki
- Nazwij cel. Napisz wprost, czy analiza jest eksploracyjna i predykcyjna, czy testujesz hipotezy. Część konfirmacyjną zaplanuj przed analizą (prerejestracja).
- Odłóż próbę testową na początku i nie zaglądaj do niej przy budowie modelu. Każda decyzja podjęta po obejrzeniu wyników testowych to wyciek informacji.
- Raportuj trafność na danych testowych (lub z walidacji krzyżowej), a nie tylko dopasowanie.
- Licz się z wielokrotnymi porównaniami. Przy przeszukiwaniu wielu zmiennych stosuj korektę albo traktuj wyniki jako hipotezy.
- Nie zamieniaj predyktorów na przyczyny. Zmienna, która dobrze przewiduje, nie musi wpływać na wynik.
Jak oddzielić analizy zaplanowane od eksploracyjnych w rozdziale metodologicznym, pokazuje poradnik plan analizy statystycznej i prerejestracja. O automatycznym doborze zmiennych w zwykłej regresji piszemy w hasłach o metodzie krokowej i selekcji postępującej.
Jak opisać analizę w pracy
Data mining w R: podział próby, lasso i drzewa
Kod tworzy dane, dzieli próbę, „łowi” korelacje i porównuje cztery modele w próbie uczącej i testowej.
Próba ucząca i testowa, lasso, drzewo regresyjne
R
suppressPackageStartupMessages({ library(glmnet); library(rpart) })
# Dane symulowane: 300 studentów pierwszego roku, zamiar rezygnacji ze studiów (skala 0–10)
# i 40 cech z ankiety oraz platformy e-learningowej (standaryzowane). Działają tylko 4 cechy.
set.seed(208)
n <- 300; k <- 40
X <- matrix(rnorm(n * k), n, k, dimnames = list(NULL, sprintf("x%02d", 1:k)))
y <- 5 + 0.9 * X[, 1] + 0.7 * X[, 2] - 0.6 * X[, 3] + 0.5 * X[, 4] + rnorm(n, sd = 1.8)
dane <- data.frame(y, X)

# Podział: 200 osób do uczenia (budowa modelu), 100 do testu (ocena na nowych danych)
ucz <- sample(n, 200)
r2 <- function(obs, prog) 1 - sum((obs - prog)^2) / sum((obs - mean(obs))^2)

# 1. „Łowienie” korelacji: ile z 40 cech koreluje istotnie z wynikiem w próbie uczącej?
p_kor <- sapply(1:k, function(j) cor.test(X[ucz, j], y[ucz])$p.value)
sum(p_kor < .05); which(p_kor < .05)

# 2. Regresja ze wszystkimi 40 cechami
m_lm <- lm(y ~ ., data = dane[ucz, ])
# 3. Lasso z parametrem kary dobranym 10-krotną walidacją krzyżową
cv <- cv.glmnet(X[ucz, ], y[ucz], alpha = 1, nfolds = 10)
wsp <- coef(cv, s = "lambda.1se")
rownames(wsp)[wsp[, 1] != 0][-1]                       # cechy wybrane przez lasso
# 4. Drzewo regresyjne bez przycinania i po przycięciu według walidacji krzyżowej
drzewo <- rpart(y ~ ., data = dane[ucz, ], control = rpart.control(cp = 0, minsplit = 10))
cp_opt <- drzewo$cptable[which.min(drzewo$cptable[, "xerror"]), "CP"]
drzewo_p <- prune(drzewo, cp = cp_opt)

wyniki <- data.frame(
  model = c("regresja, 40 cech", "lasso (CV)", "drzewo bez przycinania", "drzewo przycięte (CV)"),
  R2_uczaca = c(r2(y[ucz], fitted(m_lm)), r2(y[ucz], predict(cv, X[ucz, ], s = "lambda.1se")),
                r2(y[ucz], predict(drzewo)), r2(y[ucz], predict(drzewo_p))),
  R2_testowa = c(r2(y[-ucz], predict(m_lm, dane[-ucz, ])), r2(y[-ucz], predict(cv, X[-ucz, ], s = "lambda.1se")),
                 r2(y[-ucz], predict(drzewo, dane[-ucz, ])), r2(y[-ucz], predict(drzewo_p, dane[-ucz, ]))))
wyniki[, 2:3] <- round(wyniki[, 2:3], 3)
wyniki
round(r2(y[-ucz], 5 + 0.9 * X[-ucz, 1] + 0.7 * X[-ucz, 2] - 0.6 * X[-ucz, 3] + 0.5 * X[-ucz, 4]), 3)  # model prawdziwy
Wynik w R
[1] 7
[1]  1  2  3  4 10 13 24
[1] "x01" "x02" "x03" "x04"
                   model R2_uczaca R2_testowa
1      regresja, 40 cech     0.556      0.180
2             lasso (CV)     0.368      0.325
3 drzewo bez przycinania     0.883     -0.421
4  drzewo przycięte (CV)     0.348     -0.071
[1] 0.381
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 z pakietami glmnet i rpart; rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- glmnet (wersja 5.0): Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- rpart (wersja 4.1.24): Therneau, T., & Atkinson, B. (2025). rpart: Recursive partitioning and regression trees [R package]. https://doi.org/10.32614/CRAN.package.rpart
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raportowanie dopasowania z próby uczącej jako trafności modelu. W przykładzie drzewo miało R² = .883 na danych uczących i −.421 na testowych.
- Testowanie hipotez na tych samych danych, na których je znaleziono. Trzy z siedmiu „istotnych” korelacji w przykładzie były przypadkowe (Simmons i in., 2011, pokazują, jak elastyczność analizy mnoży wyniki fałszywie pozytywne).
- Wyciek informacji. Standaryzacja, imputacja braków czy wybór zmiennych na całej próbie przed podziałem sprawiają, że próba testowa przestaje być „nowa”.
- Za mała próba na złożony model. Kilkadziesiąt osób i kilkadziesiąt cech to przepis na przeuczenie (Babyak, 2004).
- Interpretowanie ważności zmiennych w modelu predykcyjnym jak efektów przyczynowych.
- Brak opisu procedury – liczby kandydatów, sposobu podziału, metody walidacji i parametrów modelu.
Najczęstsze pytania
Czym różni się data mining od zwykłej analizy statystycznej?
Klasyczna analiza w psychologii testuje zwykle hipotezę ustaloną przed zebraniem danych i interpretuje współczynniki przyczynowo. Data mining szuka wzorców w danych, często wśród wielu zmiennych, i ocenia model po trafności przewidywania na nowych danych. Narzędzia częściowo się pokrywają – regresja jest używana w obu.
Co to jest przeuczenie modelu (overfitting)?
To sytuacja, w której model dopasowuje się do przypadkowego szumu w próbie uczącej i przez to gorzej przewiduje nowe dane. W przykładzie na tej stronie drzewo regresyjne miało R² = .883 w próbie uczącej i −.421 w testowej. Chronią przed tym walidacja, prostsze modele i regularyzacja.
Czy data mining to to samo co p-hacking?
Nie, jeśli eksploracja jest jawna, a wyniki sprawdza się na nowych danych. Staje się p-hackingiem wtedy, gdy przeszukuje się dane aż do uzyskania istotnych wyników i przedstawia je jako potwierdzenie hipotezy postawionej z góry.
Co to jest walidacja krzyżowa?
To sposób oceny trafności modelu: dane dzieli się na k części, model buduje się k razy na k − 1 częściach i testuje na pozostałej, a wyniki uśrednia. Służy też do doboru parametrów, np. siły kary w regresji lasso.
Czy w pracy magisterskiej można zastosować data mining?
Tak, jeśli analiza jest jasno opisana jako eksploracyjna lub predykcyjna, próba jest wystarczająco duża, a trafność oceniasz na danych testowych lub walidacją krzyżową. Wyników nie przedstawiaj jako potwierdzenia hipotez – traktuj je jako hipotezy do dalszych badań.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikSegmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Babyak, M. A. (2004). What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models. Psychosomatic Medicine, 66(3), 411–421. https://doi.org/10.1097/01.psy.0000127692.23278.a9 ● Otwarty dostęp
- Shmueli, G. (2010). To explain or to predict? Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-sts330 ● Otwarty dostęp
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: Lessons from machine learning. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{babyak2004what, author={Babyak, Michael A.}, title={{What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models}}, journal={Psychosomatic Medicine}, year={2004}, volume={66}, number={3}, pages={411--421}, doi={10.1097/01.psy.0000127692.23278.a9}}@article{shmueli2010explain, author={Shmueli, Galit}, title={{To explain or to predict?}}, journal={Statistical Science}, year={2010}, volume={25}, number={3}, pages={289--310}, doi={10.1214/10-sts330}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{yarkoni2017choosing, author={Yarkoni, Tal and Westfall, Jacob}, title={{Choosing prediction over explanation in psychology: Lessons from machine learning}}, journal={Perspectives on Psychological Science}, year={2017}, volume={12}, number={6}, pages={1100--1122}, doi={10.1177/1745691617693393}}